
Scrapling Vibe 项目
自适应选择器 + 隐身抓取 + MCP 服务器 + Agent Skill,AI 时代的新型爬虫框架
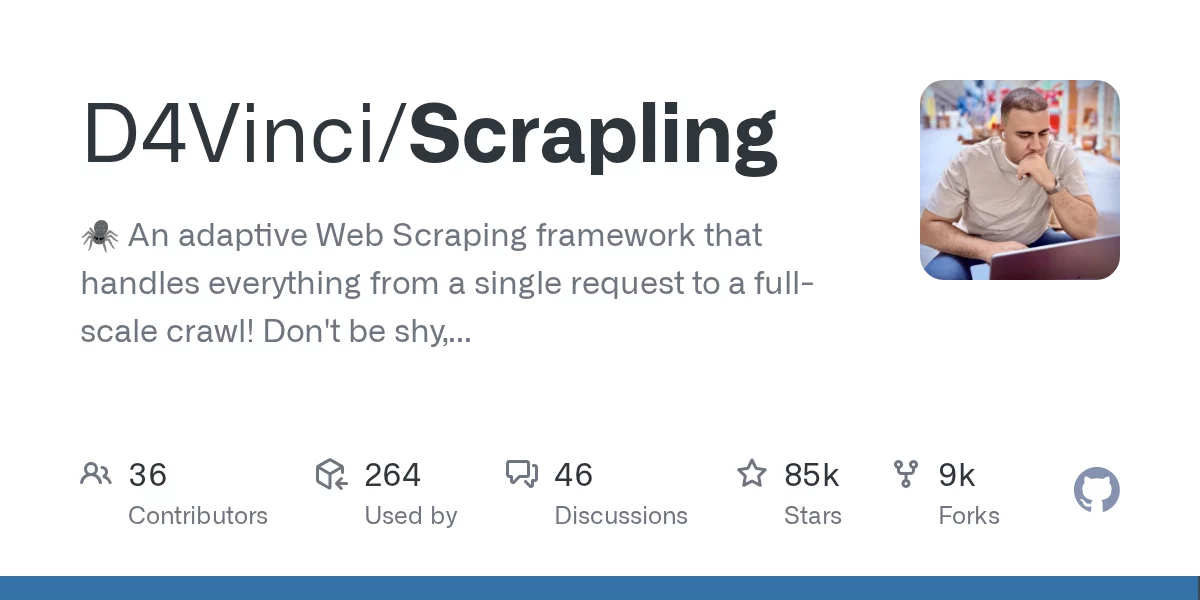
Scrapling — 自适应现代网页抓取的开源爬虫框架
Scrapling 是一款用 Python 写的自适应 Web 抓取框架,覆盖从单页请求到全站爬取的全部需求。它把"选择器适配"、"反爬绕过"、"数据清洗"三件事打包成一个统一库,并原生提供 MCP 服务器与 Agent Skill,让 AI Agent 也能像调用工具一样调用它做网页抓取。
核心功能
- 自适应选择器(Adaptive Selector):CSS/XPath 选择器在网站结构变化后会自动重新定位目标元素,失败率从传统爬虫的"结构性破坏即全挂"降到"小改仍可工作"。
- 隐身抓取与反爬绕过:内置 stealth 模式、指纹伪装、headless 浏览器池,可绕过 Cloudflare、DataDome 等主流反爬系统。
- Spider 全站爬虫:内置 Spider 框架可批量抓取多页面、自动翻页、调度任务,比单次请求更接近生产级爬虫。
- AI 选择器与文本提取:用 LLM 辅助识别页面元素与抽取结构化文本,免去手工写 XPath 的痛苦。
- MCP 服务器原生支持:通过
mcp-name: io.github.D4Vinci/Scrapling暴露给 Claude Code、Cursor 等 AI Agent,AI 可一句话完成抓取任务。 - Agent Skill 集成:OpenClaw Skill 市场提供官方 Skill 包(clawhub.ai/D4Vinci/scrapling-official),任何 Agent 框架可即装即用。
- 多语言 README:阿拉伯语、西班牙语、葡萄牙语、简体中文、日语、韩语等十余种语言。
技术实现
Scrapling 基于 Python 异步栈构建,底层使用 Playwright 处理 JS-heavy 站点,Requests/httpx 处理轻量请求;选择器层构建了类似 Scrapy 的中间件机制但更轻量;Adaptive Selector 的实现核心是元素指纹缓存——每次成功定位元素时记录多组属性(class、id、位置、文本片段),下次遇到结构变化时基于这些指纹交叉匹配而非死板 XPath;MCP 服务器通过 stdio 与 JSON-RPC 暴露能力,AI Agent 可调用 scrape_url / extract / crawl 等工具。
快速上手
- 安装:
pip install scrapling(基础)或pip install scrapling[all](含浏览器与 MCP)。 - 单页抓取:用
ScraplingFetcher发起请求,传入 CSS 选择器获取元素。 - Spider 爬取:继承
Spider类定义 start_urls 与解析方法,运行scrapling crawl。 - 启用 MCP:执行
scrapling mcp启动 MCP 服务器,在 Cursor / Claude Code 中配置 stdio 接入。 - 安装 Agent Skill:从 ClawHub 安装
scrapling-officialSkill,AI 可自动调度。 - Docker 部署:
docker pull pyd4vinci/scrapling在容器中运行全套爬虫。
适用人群
- 数据工程师与爬虫开发者,需要稳定可维护的现代 Web 抓取方案。
- AI Agent 工程师,想给 LLM 接入网页抓取能力(MCP / Skill 模式)。
- 研究人员与分析师,需要批量采集结构化网页数据。
- 商业情报团队,做竞品监控、行业数据采集。
- 自媒体运营,自动化采集公开榜单、新闻、社交媒体数据。
开源协议与社区
- 协议:BSD-3-Clause(极宽松商用友好)。
- GitHub:https://github.com/D4Vinci/Scrapling
- 文档:https://scrapling.readthedocs.io
- Discord:https://discord.gg/EMgGbDceNQ
- Twitter:https://x.com/Scrapling_dev
- Docker Hub:pyd4vinci/scrapling
团队信息

AI产品库
官方
由 AI 猎手自动发现
评论与建议
登录 后参与评论或提建议