
Llama 今日发布
本地运行开放模型的桌面 AI 助手
产品简介
Llama 是由 llama.cpp 团队与 Hugging Face 共同推出的桌面 AI 助手,把开放权重模型装进 Mac 菜单栏或 Windows 11 系统托盘,在自己的电脑上完成对话与推理。它同时提供网页聊天界面和一个本地 OpenAI 兼容 API,让编辑器、编程代理与脚本都能直接调用本地模型,无需任何 API Key,也不产生调用费用。
核心功能
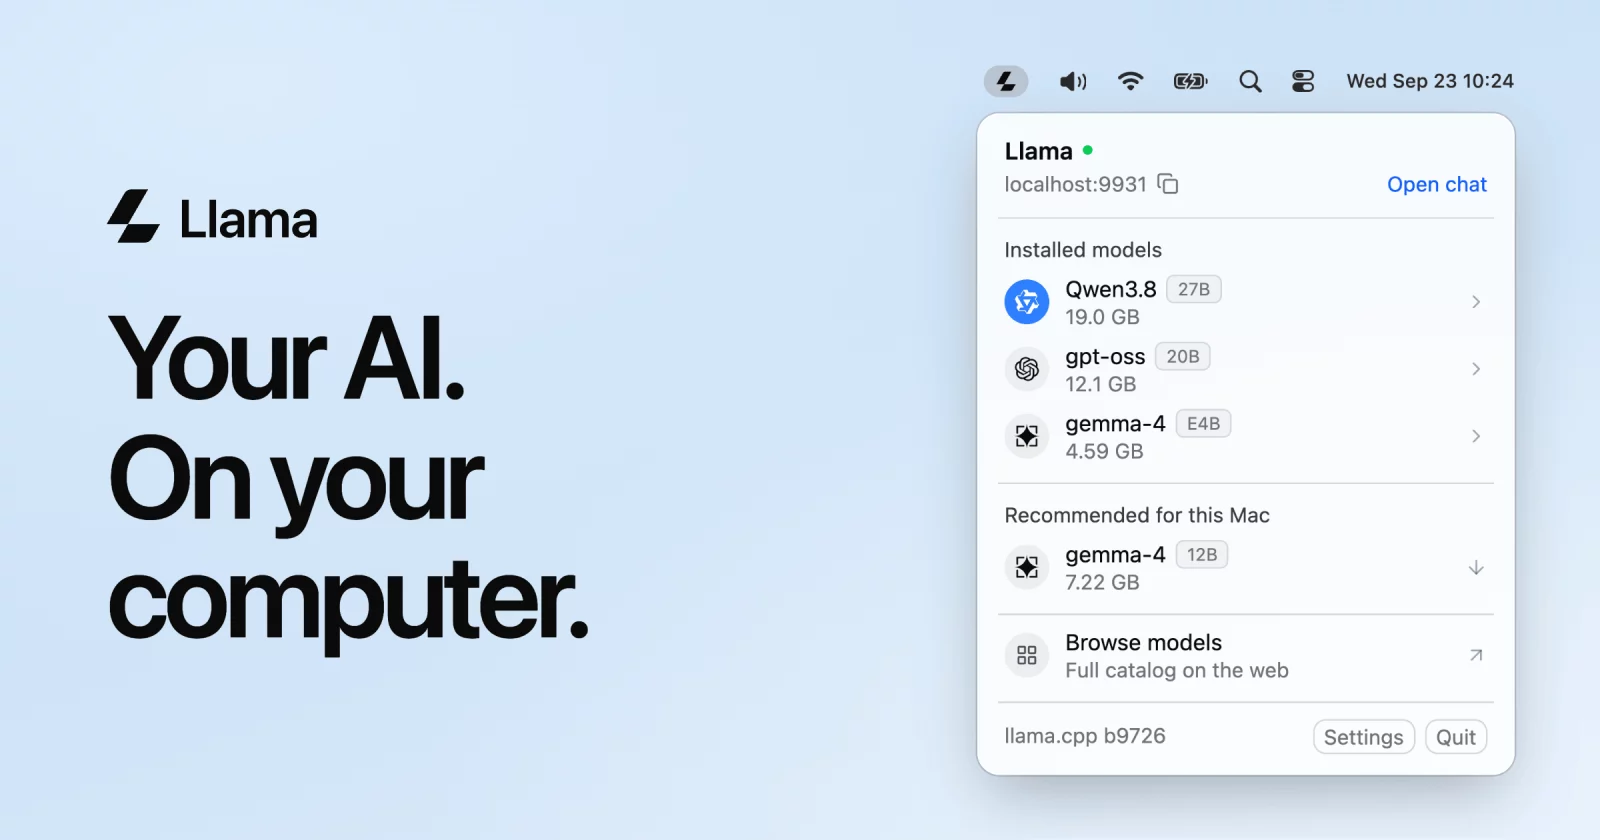
- 一键安装模型:打开即用,Llama 会读取机器内存给出推荐模型——16GB 内存推荐 Gemma 4,24GB 推荐 GPT-OSS,32GB 推荐 Qwen 3.8,也可自行浏览完整模型目录下载。官网示例中列出了 Qwen3.8 27B、gpt-oss 20B 与 gemma-4 E4B 等模型。
- 本地聊天:菜单栏点击「Open chat」即可像使用 ChatGPT 一样对话,可对本地文档做总结、要点提示等任务。
- OpenAI 兼容 API:请求指向 http://localhost:9931/v1 ,改一个 base URL 就能让现有 OpenAI SDK、编程代理、编辑器接入,支持流式输出、工具调用、结构化输出与图像输入。
- 参数自动调优:量化等级、上下文长度、图像输入、投机解码与批大小默认由 Llama 按硬件自动选择,同时保留一个纯文本配置文件供高级用户手动覆盖。
- 模型共享与自动回收:模型存放在 Hugging Face 缓存目录,与 llama.cpp 及其他工具共用同一份文件,不会在多个应用间重复占用磁盘;空闲 5 分钟后自动从内存卸载。
特色优势
体积与资源占用是本地 AI 工具最常见的劝退点,Llama 把安装包压到 1MB(安装后约 4MB),并强调「不打包模型」——应用通过 API 复用同一份模型文件,避免出现多个工具各存一份几十 GB 副本的情况。官方同时标注 Anthropic 兼容端点、Windows 与 macOS 双端支持,以及通过 Tailscale 从其他设备访问本地服务的能力。
应用场景
在完全离线的内网机器上做文档摘要与问答;把本地模型接给 Cursor、Claude Code 一类编程代理,避免代码与文档外传;用同一套本地模型同时服务聊天、脚本与自动化任务;团队内网共享推理节点,模型只下载一次。
适用人群
需要在本地跑大模型的开发者与算法工程师;关注代码与文档不外传的团队;希望有 ChatGPT 式界面但不愿承担 API 费用的个人用户;以及要在内网搭建推理服务的运维人员。
出品方与开源
由 llama.cpp 团队与 Hugging Face 联合打造,官网提供 macOS、Windows 11 图形版以及 Linux 命令行版。Windows 版是 WinUI 3 移植实现,仓库 ggml-org/Llama-Windows 采用 MIT 许可,README 明确写明不发送任何遥测数据,提示词与推理全部留在本机。
快速上手
macOS 可用 brew install --cask llama-app 或官方脚本 curl -LsSf https://llama.app/install.sh | sh 安装;Windows 使用 irm https://llama.app/install.ps1 | iex ,也可从 GitHub Releases 下载 .msixbundle 安装包。Windows 版还支持在任意软件中按 Alt+Space 呼出悬浮对话窗,并可在点击模型后选择上下文长度,界面会直接显示基于 GGUF 头解析出的内存占用预估。
官方链接
官网:https://llama.app ;Windows 客户端仓库:https://github.com/ggml-org/Llama-Windows
团队信息

评论与建议
登录 后参与评论或提建议