
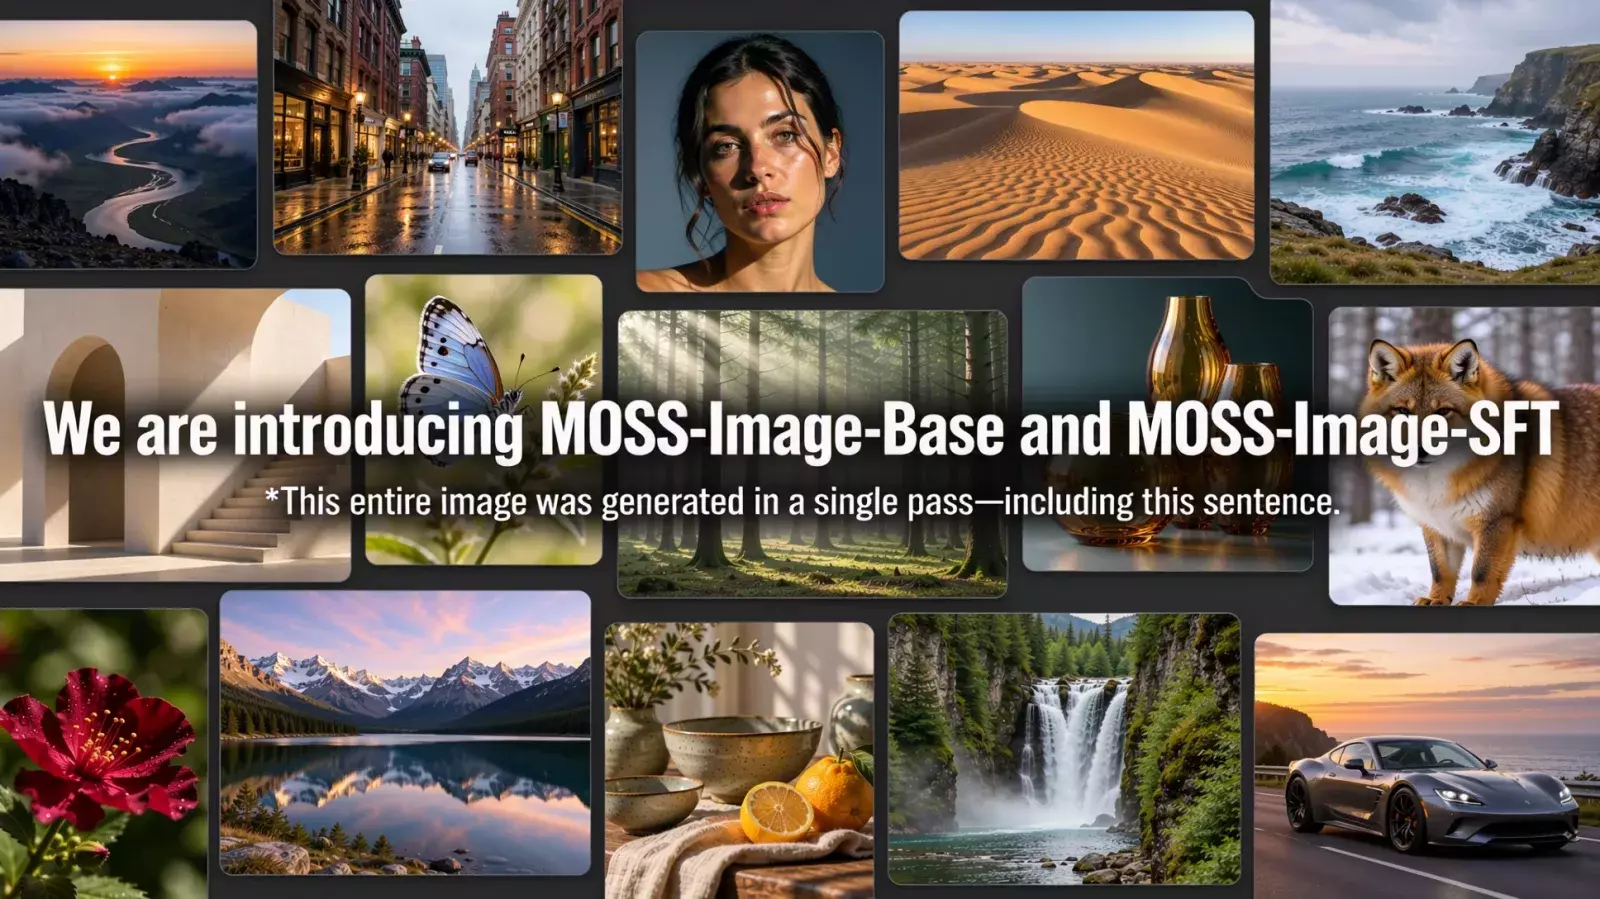
MOSS-Image 今日发布
5B 开源文生图模型
产品简介
MOSS-Image 是 OpenMOSS 团队开源的文生图模型家族,包含基础版 MOSS-Image-Base 与精选数据精调版 MOSS-Image-SFT,两款模型共用同一套 Diffusers 推理管线。除了自然语言描述,它还支持原生布局生成:可以用一份 JSON 提示词同时指定场景、物体、画面文字以及它们的空间位置。整个系列基于 5B 参数的紧凑骨干,最长可接受 4K token 的提示词,模型权重以 Apache-2.0 协议开放。
核心功能
- 文生图:自然语言直接出图,Base 版偏通用,SFT 版文字分组更清晰、白板类版式更规整
- 原生布局控制:用 JSON 描述 bounding box,画面里文字、图标、插画的位置与大小可控
- 强文字渲染:能在海报、便签、价签、包装上生成清晰准确的文字
- 4K token 长提示词:能容纳复杂场景描述、人物设定与镜头语言
- 多风格输出:二次元动漫与写实摄影两种主风格,也能做视觉设计类排版
- 一套接口两种用法:Python 与 Gradio 共用 Diffusers 管线,ComfyUI 已原生支持
- 在线试用与 API:官方提供 Live Demo、HuggingFace 与 ModelScope 权重、MOSI API 平台
- 官方提示词增强 Skill:把想法编译成 caption 或带坐标的 layout JSON
特色优势
文字渲染和版式控制是它最突出的能力,这在海报、商品图、分镜漫画这类图里必须写字的场景里非常关键。5B 的骨干体量让它在消费级显卡上也能跑,同时留出微调空间。10 月 16 日发布当天即接入 SGLang、vLLM-Omni 与 ComfyUI,10 月 19 日技术报告上 arXiv,10 月 20 日上线 MOSI API 平台,从开源到可调用只用了四天。
技术实现
它是一套扩散 Transformer 架构:文本编码器为 Qwen3.5-9B,变分部分使用 FLUX.2 的小型 VAE(官方训练框架的权重清单即 qwen3.5_9b 与 flux2-vae_small 两个文件)。官方推理示例里 DiT 跑 bfloat16、VAE 保持 float32,推荐 50 步采样、guidance scale 取 3.0,并对指定层做无条件跳过来提速。训练侧官方开源了 KohakuMossTrainer,支持全量微调与 LyCORIS 系列 LoRA,最小可落到 6GB 显存。
应用场景
电商主图与详情页带中文卖点文案、活动海报与社交媒体配图、带标题与插画排版的旅行海报、多格漫画与分镜草图、游戏界面 HUD 截图生成、信息结构图与白板、影视级写实照片复刻,以及用社区 LoRA 微调出专属画风。
适用人群
需要图里写字不出错的设计师与电商运营、做分镜和角色立绘的漫画作者、要把文生图接进产品的独立开发者与算法工程师,以及想在自己显卡上微调专属风格的创作者。
出品方与开源许可
OpenMOSS 团队出品,代码与模型权重以 Apache-2.0 协议发布,同时在 HuggingFace 与 ModelScope 同步,开源技术报告的 arXiv 编号为 2610.23374。
官网链接
项目主页 https://openmoss.ai/MOSS-Image/ ,代码与权重见 https://github.com/OpenMOSS/MOSS-Image 。
团队信息

评论与建议
登录 后参与评论或提建议