
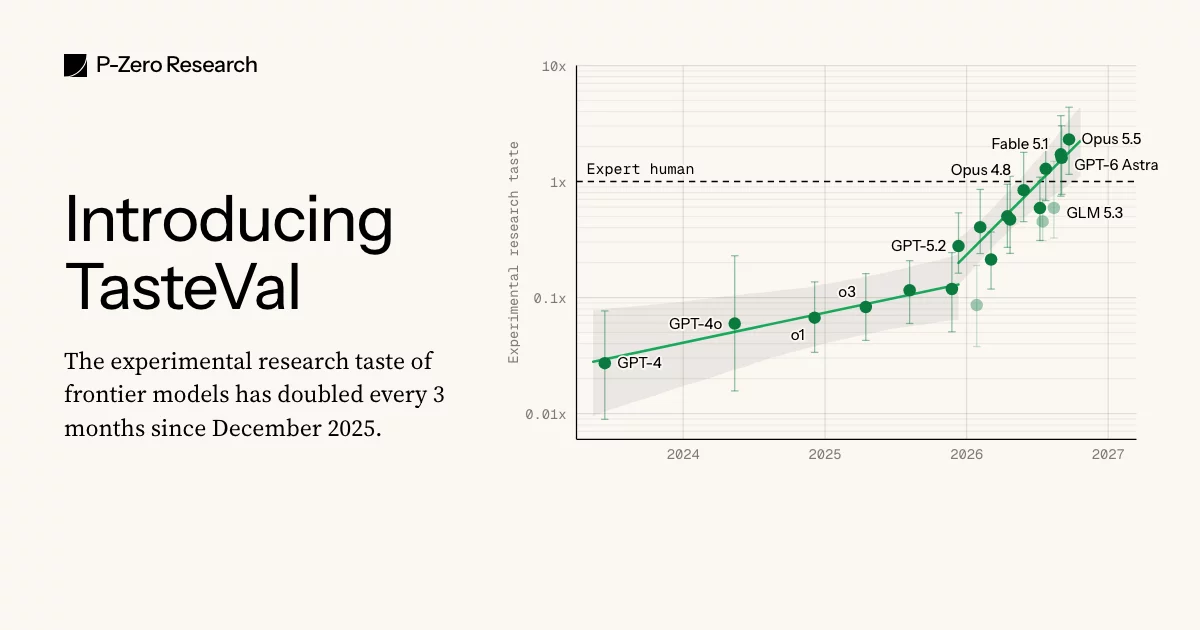
TasteVal 今日发布
8 项 AI 研发任务,测量模型的实验研究品味
3. TasteVal:量化 AI「研究品味」的实验基准,开源模型已 2.3 倍超过人类专家
产品简介
TasteVal 是 P-Zero Research 于 2026 年 10 月 6 日发布的评测基准,用来测量 AI 模型在真实 AI 研发任务上的「实验研究品味」——也就是设计实验并从结果中得出结论的能力。官方定义把研究品味拆成三种能力:判断哪些研究问题值得做、设计实验来回答它、正确解读实验结果;TasteVal 只测后两种,研究方向是预先给定的。论文《TasteVal: Measuring the Experimental Research Taste of AI Systems Against Human Experts》发表于 arXiv(编号 2610.06824),作者为 Ollie Jaffe 与 Dane Sherburn,官方页面在 pzeroresearch.com/work/tasteval/。它出现的背景是 Jack Clark 在 Import AI 第 476 期把「完整递归自我改进成为可能」的时间从 2028 年提前到 2027 年,而这个判断正是由 TasteVal 的实测趋势支撑的。
核心功能
- 八项前沿 AI 研发任务:覆盖预训练数据筛选、预训练与微调语言模型、人类偏好对齐训练、对抗性提示词防御等方向,全部取自前沿 AI 开发的真实环节。
- 计算效率式评分:官方把实验研究品味折算为 compute multiplier——达到专家分数所需的实验算力之比,用一半算力追平专家即视为两倍品味。
- 隔离编码能力:被测模型只负责设计实验与解读结果,实际编码与执行交给一个固定的 coding agent,单张 NVIDIA H100 上跑,避免用编码能力污染结果。
- 硬性算力上限:一次运行最多使用 40 GPU 小时,或 120 小时挂钟时间。
- 人类基线:24 名专家,每项任务至少两人,来自 OpenAI、Google DeepMind、NVIDIA 与微软研究院等机构,取该任务上最好的一次人类尝试作为基准。
- 固定问题、固定指标:每个任务设定固定的研究目标与一个可打分的指标,由模型自己决定下一个该跑哪个实验,并用结果决定下一步。
- AI Futures Model 外推:官方把实测到的品味增长速度代入 AI 未来模型,给出「品味奇点」概率与超级智能到来时间的推算。
- 开放评测申请:官方在页面底部公开邮箱,接受希望被评测的模型团队联系。
特色优势
它最聪明的地方是用「算力效率」而不是绝对分数来定义品味,从而把「一个更贵的模型跑出更高分」和「一个更会做实验的模型」区分开——官方原话是:模型的研究品味翻倍,效果等同于可用实验算力翻倍。它同时给出了两个方向的自检:任务便宜且易验证,可能高估了前沿实验室最容易爬坡的那部分;而人类基线没有包含顶尖研究者,可能严重低估世界最强研究者的水平,于是官方既声明可能高估、也声明可能低估。此外,团队公开了评测的双用途问题并单独撰文说明其发布准则,这在同类基准中相当少见。
应用场景
- 评测模型研发能力:想知道自家模型是「会写代码」还是「会做实验」,用 TasteVal 给出量化答案。
- 预测自我改进速度:把新模型接入基准,跟踪实验研究品味的增长曲线。
- 实验室内部选型:在多轮 SFT、RL 配方之间做取舍,以实验效率而非单点分数作为依据。
- 政策与安全研究:为「递归自我改进有多快」提供可复现的测量口径。
- 教学参考:八个任务本身就是高质量的 AI 研发任务清单,可直接当练手题目。
适用人群
前沿模型实验室的研究与评测团队;做自动化 AI 研发(AI R&D)方向的工程师;关注 AI 能力增长曲线的政策研究者与安全团队;希望对比不同模型「实验品味」的研究者。
出品方
P-Zero Research。官方介绍称这是一个小而低调、关心影响的团队,创始人曾在 OpenAI 的 Preparedness 与 Policy Research 团队工作,参与合著 MLE-bench、PaperBench 与 SWE-bench Verified,并构建过说服类评测、早期 sandbagging 研究工作。团队目前列出的成员包括联合创始人兼技术成员 Dane Sherburn、联合创始人兼技术成员 Ollie Jaffe,以及运营负责人 Edward Burrowes,办公地覆盖旧金山湾区与伦敦,并公开招聘研究人员与经济学家。
更新动态
官方页面标注最后更新于 2026 年 10 月 6 日,同日发布论文《TasteVal: Measuring the Experimental Research Taste of AI Systems Against Human Experts》(arXiv 2610.06824)。核心结论是:自 2025 年 12 月以来,前沿模型的实验研究品味每 3.0 个月翻倍(95% 置信区间 1.7–5.0 个月);最佳模型 Opus 5.5 的计算乘数为 2.30 倍(95% 置信区间 1.15–4.37 倍),而其单次尝试成本约为人类专家平均成本的 1/30。官方同时以「朴素外推而非预测」的口径给出:品味奇点概率从 51% 上升到 88%,超级智能的中位到达时间从 2030 年中提前到 2028 年末,2030 年前达成超级智能的概率从 46% 上升到 69%。10 月 5 日官方另发文章《Our thoughts on publishing dual-use evaluations》,说明其对双用途评测发布规范的态度。
官方链接
官方页面:https://pzeroresearch.com/work/tasteval/ 研究列表:https://pzeroresearch.com/work/ 论文:https://arxiv.org/abs/2610.06824
团队信息

评论与建议
登录 后参与评论或提建议