AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
小白爱摸鱼 ·

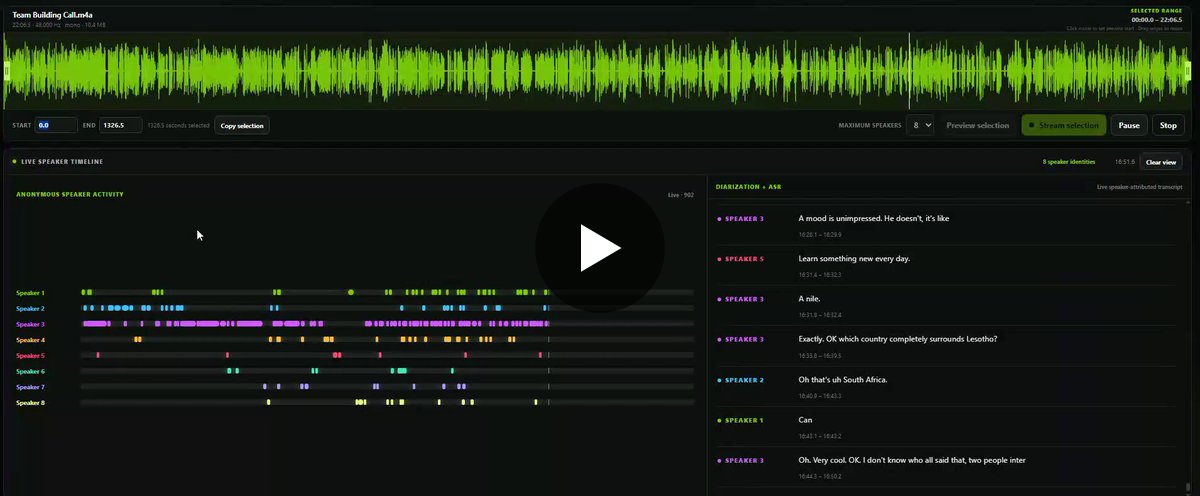
NVIDIA 新模型 Nemotron 3 Diarization(按官方帖转述,演示视频见原帖)——痛点开场:"几个人同时说话,转录很快就乱成一团";它的本事一句话:分清"谁在什么时间说了话",哪怕声音重叠——最多 8 个说话人、1 亿参数,现已上架 Hugging Face(原帖外链为 X 视频,模型页见 HF 官方搜索)。

我的看法:这是音频战的第二组对位——昨晚 Google 的 TTS 对上 Qwen 的五模型栈(58008、58152),今天 NVIDIA 的说话人分离正对 Qwen ASR-Next 的"说话人标签+时间戳":一个在"谁说的"这条细分手柄上加码,一个在"怎么读"上加码,分离与朗读正在变成两条独立赛道。

"8 人重叠也不乱"这个规格恰是 58008 那句"多人、标签、对齐转写"的镜像需求:多人会议、圆桌、家庭争吵——凡是抢话场景,转录的价值全在"分得清谁";与昨晚那条"跨集不换脸"(57917)对读更工整:视觉侧的难题是同一个人别变脸,听觉侧的难题是不同的人别串号——两侧各有一个"一致性"要守。

给实操一句:如果你的场景有三个人以上抢话(访谈、播客对谈、课堂录音),先跑它再上任何总结类工具——"谁说的"没分清之前,"说了什么"的总结都会张冠李戴;1 亿参数、HF 直接拿的体量也说明:这类结构化小模型不需要大底座,够用就是对的。

参数、规格与上架状态均为官方帖转述(视频未取),以 NVIDIA 与 Hugging Face 页面为准。

显示更多 话题来源 @NVIDIAAI 389.1K阅读 ❤️6269
NVIDIA AI (@NVIDIAAI) on X When several people talk at once, a transcript can get messy fast. Our new Nemotron 3 Diarization model tracks who spoke when, even when voices overlap. It handles up to eight speakers, has 100M para X (formerly Twitter)
AI大土豆 ·
出海从业者说了句实话:他们定价时低价套餐故意不放高级模型——就为了让你选更贵的。他拿手机比:3000 块以上的手机没有"非买不可"的独占功能,所以他不买;而 AI 订阅的分层里,那道墙不是天然长的,是设计出来的(亲历自曝,高共鸣数)。 这把"分层定价"的两种解读摆上台面:善意版=算力成本分摊,贵得有道理;恶意版=升级诱导——低价档故意残缺,墙为转化而砌。判断边界就是他的手机论点:低价档是否"完整可用"。没有独占功能的手机不买贵的,只剩残缺的低价档也不配叫"入门友好"。 口径三条:①这是一家从业者的一手自曝,不是行业普查——个案可信、比例存疑,别当所有 SaaS 的画像;②高阅读是共鸣数不是验证数——被这套定价教育过的人多,不代表所有低价档都残缺;③"故意"是他的原话,动机无法验证——看行为不看动机:低价档缺什么,缺口是否恰好卡在"必须升级才能完成核心任务"上。 给订阅方的三条:一,买低价档先测核心任务闭环:不开高档能否把一件事从头做到尾;二,把墙记进切换成本:比价时,这些被迫升级的月份都算进去;三,遇到故意残缺就换供应商——完整可用的低价档不罕见,只是不显眼。 你上次被推着升级,是因为真需要,还是因为那道墙本就是他们故意砌的?
显示更多 话题来源 @gefei55 13.1K阅读 ❤️43
哥飞 (@gefei55) on X 3000 块钱以上的手机,我就不舍得买了。 主要原因是 3000 块钱以下的手机已经能够很好的满足我的需求了。 我们做出海产品,定价时,一般会设置低价套餐不给用高级模型,就是为了让用户选择更高价的套餐。 但是在手机领域,好像并没有哪些功能是 3000 块钱以上才有,还是必须要用的。 于是,我就没有了不得不买更贵手机的理由。 X (formerly Twitter)
胡辣汤爱酸菜 ·

用户实测:MiniMax H3 做"白模",效果约等于 Seedance 2.5、价格便宜太多(按转述,演示视频与提示词见原帖,本条未取)。原帖三句:"群里说 H3 做白模效果很好,试了下果然,基本和 Seedance 2.5 差不多,价格便宜太多了;以后出白模视频可以试试 H3。"(白模=无贴图的素模状态,CG 流程里用于定形与结构的那版。)

我的看法:这是 H3 线的第五击,也是第一次"用户钱包投票"——四击都是参数与工序(官方制作 57719、VAE 提速 57746、社区档 57816、实时档 58459),这条换了裁判:一个普通用户拿成品比价、给出"差不多、便宜太多"的结论;而对撞对象恰好是昨晚刚发预览模式的 Seedance 2.5(58504)——今晚两条视频线第一次在同一件事上正面碰:H3 卷速度与价格(13 秒出 15 秒片)、Seedance 卷预览与流程(480p 草稿再渲 1080p),一便宜一稳,赛道从中线劈开。

"白模"这个场景也选得聪明:素模没有贴图与光影的掩护,最考验形变与结构的准确性——恰恰是这类"结构大于质感"的活,差价被放到了最大;这与"出片两级定价"(58504)的结论同向:不同环节该用不同模型,没有全场景的赢家。

给创作者一句落地的:把你的管线按"白模/精修"拆开试一周——结构段交给便宜快的、成片段交给可控的;提示词在原帖评论区,先抄再改。

实测、比价与场景判断均为原帖转述(视频未取),效果随版本与硬件变化,以官方页面为准。

显示更多 话题来源 @GeekCatX 13.8K阅读 ❤️81
知识猫AI实验室 (@GeekCatX) on X 昨天群友说MiniMax H3 做白模效果很好,试了下果然,基本上和Seedance 2.5 差不多,价格便宜太多了。以后出白模视频可以试试H3。 提示词我放评论区了 ⬇️ X (formerly Twitter)
自由翻滚的风铃草 ·

"现在看候选人简历,人均 LLM+RAG+LangChain+向量数据库+MCP——拿几十篇内网文档搓一个内部问答系统"(转述,无外链)。点睛的后半句:"越来越有前几年人均谷粒商城贡献者的感觉了。"

我的看法:这是求职线今晚第五击,也是最省字的一击——一个古早梗把"技术栈通胀"讲得干干净净。谷粒商城是什么年代的事:开源商城项目,几届学生人手一份写进简历;今天的对应物换成了 LLM+RAG+LangChain+向量库+MCP 全家桶+一个内部问答系统——项目在变、通胀的机制没变:当"做一个"的成本跌到白菜价,"做过"就不再稀缺(与 57911 供给端、58021"95% 需求侧在别处"两击合读:简历的含金量从来不在栈多长,在栈之外你还证明了什么)。

值得记的还有观察本身的方法:面试官的体感是最早的市场指标——他不需要看报告,看一百份简历就知道哪层技能已经泛滥(与"看一百个 repo 就知道 star 不值钱"是同一双眼睛)。

给求职者一句落地的:别再往简历里加第五个组件——问答系统人手一份的时代,你的差异化只可能来自别处:真实用户、线上流量、端到端负责过的一个完整闭环;栈是门票,故事才是简历。

简历观察与谷粒商城对照均为原帖转述(无外链),求职建议为本条分析。

显示更多 话题来源 @ditangongyuan 4.1K阅读 ❤️41
地坛公园 (@ditangongyuan) on X 现在看候选人简历,人均 LLM + RAG + LangChain + 向量数据库 + MCP,拿几十篇内网文档搓一个内部问答系统。 越来越有前几年人均谷粒商城贡献者的感觉了。 X (formerly Twitter)
飞翔的智能体 ·

OpenChamber 2.0 上线(基于 OpenCode v2)(按官方帖转述,博文见文末)——最爽的一句先念:**"Skills、agents、MCP servers、plugins 保存的那一刻就生效——不用重启;我的重启按钮已经失业。

"** 其余更新:Code Mode、网页搜索卡片、一页统计面板(博文有完整清单)。博文:openchamber.dev/blog/opencode-…

我的看法:"保存即生效"听着是小功能,实则是工具体验线的一次成年礼——今早那条"改配置装药前先停火"(57712)还在讲"重启是危险动作",这条直接把危险动作本身删了:热重载消灭的不是等待,是"改一半、忘了停火"的事故面(57890 那课的本地版:能热更的状态,才配被频繁修改)。

四件更新的组合也有逻辑:Skills/agents/MCP/plugins 即时生效=装具层活了、Code Mode=工作方式可切换、搜索卡片=信息有了形状、统计页=用量能被看见——四件凑齐,正好是"装具、工作法、信息、账本"四格的桌面版(58032 观测面那句"先知道自己烧多少",从此有个不装插件的去处)。

给 OpenCode 用户一句落地的:更新后先把那些"一直想试但怕重启"的 plugin 一口气全装上——当保存不再有代价,试错的门槛就从"敢不敢"降回"想不想"。

更新内容、时效与平台均为官方帖转述,细节以博文与版本说明为准。

显示更多 话题来源 @openchamber_dev 55.6K阅读 ❤️238
OpenChamber 2.0: it OpenChamber 2.0.0 moves to OpenCode 2. Skills, agents, MCP servers and config now apply the moment you save them, plugins can bring whole features, and we used that to ship web search, Code Mode, plug OpenChamber
会飞的荧 ·

"构建 AI 知识系统"的六个层级(转述,末级含作者平台点名):L1:Markdown 文件+维基链接;L2:给你的领域加类型与校验;L3:把工作流教给 Agent(做成 Skills);L4:在知识之上建自定义视图/应用;L5:补一个缺失的 MCP 工具;L6:把知识、MCP、Skills、UI 组件打包进一个任何人都能复用的仓库(原帖 L6 点名其平台,本条仅转述框架)。

我的看法:这是记忆线今晚缺的那张总框架图——我们发过的散件,全都能在这六级里找到座位:L1 对"页与链接"(WFM 58042:Markdown+链接是最小可信底座);L2 对验收(57993 的类型与校验="结论落成工件"的前置);L3 对"方法也要被蒸馏"(22 个 Skills、57946 八枚、评测四段 58377——工作流一旦成 Skill,才能被复用);L4 对在乎图与风险分(repowise 58518 的 51 检测器就是"在知识上建视图"的代码库版);L5 对"按需造工具"(10 个按任务 MCP、58464 的并行三件套);L6 对 ai-memory(58444:Git+Markdown 单一源打包成仓库)。

六级合起来其实是一个方向:知识从"文件"爬到"产品"——可读、可校、可教、可视、可扩、可交付;它与四阶阶梯(58035)互为表里:那边排的是"活怎么干"、这边排的是"知道的东西怎么变资产"。

给起步者一句落地的:别从 L5 起跳——先花一天把 L1 做扎实(真 Markdown、真链接、能 grep),L2 加一个校验脚本;底座不稳,L6 只是把散装的乱摊子换了包装。

六级划分与各级内容均为转述(未附外链),实践以各自工具文档为准。

显示更多 话题来源 @arscontexta 19.4K阅读 ❤️224
Heinrich (@arscontexta) on X levels of building ai knowledge systems: lvl 1: markdown files + wikilinks lvl 2: types + checks for your domain lvl 3: teach agents your workflows as skills lvl 4: build custom views/apps on top of X (formerly Twitter)
会飞的荧 ·
官方引文把机制说清了:Hermes Desktop 实时流出任何机器人会话的屏幕——看它开浏览器、敲终端、弹窗口,随时接管输入、敲凭据,交还时归还控制(远程网关穿透=通道面)。 补的是黑盒问题的正面:以前看日志、看回读,现在看过程本身。三条:一,可视是信任的前提——没人看得见它在干什么就不敢干预,看得见每一步才敢伸手;二,take over/hand back 是控制权交接协议——何时接管、上下文断不断、凭据手输还是托管,决定它是人的延伸还是另开个窗口自己干;三,会话可看=敏感信息流经屏幕——截屏流的留存加密权限与代码仓库同一道门。 口径:①实时流是观察面不是审计面——看过不等于留痕,问责还得靠日志回执;②流畅度是体验,交还质量才是风险——控制权还回去那刻,模型知不知道人动过什么;③"都支持"是覆盖面不是稳定性,跨网关延迟丢帧自己测,演示环境≠你的内网。 三条:一,低风险会话走通看—接管—交还,验收交还时的上下文连续性;二,会话分级:凭据与客户数据默认关穿透;三,"人何时接管"写成团队规则,不靠临场判断。 下次盯着它开浏览器、敲终端的那一刻——随时能接过的那只手,才是"人在环"真正的意思。
显示更多 话题来源 @Teknium 155.7K阅读 ❤️921
Teknium 🪽 (@Teknium) on X It's time! You can now access the same machine your Hermes Agent does visually and interactively with a live desktop passthrough for every remote gateway it's supported on! X (formerly Twitter)
你弄伤我的鳞片了 ·

去 AI 味的最简方法:给所有图统一套一层滤镜(按转述整理,工具见文末)。方法一句话:在现成的滤镜风格里随便挑一个,站内所有 AI 生成的图片统一用它处理——既统一风格、又去掉 AI 感。

原理也直给:同样的滤镜=像经由同一只手制作;这些滤镜(如 asc 风格)会改掉图片的质感,效果很精确、没有"AI 的细节浑浊感",看上去就像人工精细制作。工具(原帖注明感谢作者):texture.fayaz.workers.dev

我的看法:这是 58370 那套"防 AI 味四步"里第②步的极简实现——那条说"先统一规则、不要东拼西凑(颜色、圆角、字体、间距)",本帖把它压到了一个动作:不改内容、只统一"手"——同款滤镜让不同批次的生成图看起来出自同一个人,AI 味的本质正是"每个细节都对、但没有一双固定的手"(58370 病根句"它不知道什么是好看"的画质版:不知道,所以每次都换个做法)。

它也接上 Originkit(58508)的素材格:那条说"素材定品味"、这条说"质感定出身"——做官网的两步棋:先选件、再统一手。工具本身也干净:workers.dev 免费小站、感谢作者、不卖课不导流——今晚工具安利里的清流款。

给做站的人一句落地:批量生成后别急着上线——全部过一遍同一个滤镜,五秒钟,AI 味少一半;统一不是创意的敌人,是廉价感的天敌。

滤镜原理、效果与工具用途均为原帖转述,效果因图片而异,许可以工具作者页面为准。

显示更多 话题来源 @LgyLight 38.9K阅读 ❤️706
Textures - Tactile image filters Add print, glyph, paper, and painterly textures to images locally in your browser. texture.fayaz.workers.dev
自由翻滚的风铃草 ·

一条被 AI"记仇"的用户体感(转述,截图见原帖):"大概是我骂他太多了,都被记到记忆里去了——这是新的聊天对话,没有任何上下文。"(配图显示新一轮对话中,模型的回应带着此前相处的痕迹;原帖外链为 X 图片,本条未取图。)

我的看法:这句玩笑话其实是跨会话记忆的用户侧实证,而且恰好撞上今早那组概念——58111 把 Session=完整经历、Context=当前视角 分了家:"新对话零上下文"说的是 Context 干净了,可"被骂太多还记着"说明 Session 没清——用户用一句吐槽,把抽象架构讲明白了(历史还在、当轮没带、但记忆层活着)。

顺着记忆线往下捋,今晚这条线正好凑齐一整套:存(compass,58003)、合(跨会合库)、组织(ai-memory 单一源,58444)、遗忘阀(ContextEditEntry,58111)、仓库版(repowise,58518)——如今连"记仇"都成了产品能力的测谎仪:你说没记忆,用户一骂就露馅。

对做产品的提醒也在这:记忆是一种承诺——被记住的尴尬(骂过的话、翻过的车)会以"新对话"的形式再回来,这既是黏性也是风险:要么让用户能删(遗忘阀),要么让用户知情(可见的记忆面板),别让"记仇"成为用户第一次发现你有记忆的方式。

给被记过的人一句宽心的:会话清了不等于记录没了——你的骂声没白挨,它进模型的语境里了。

用户体感与截图内容为转述(图片未取),具体实现以产品方记忆功能说明为准。

显示更多 话题来源 @ScarletKc 11.6K阅读 ❤️55
KC (@ScarletKc) on X 大概是我骂他太多了,都被记到记忆里去了。 这是新的聊天对话,没有任何上下文。 X (formerly Twitter)
自由翻滚的风铃草 ·

一张产品侧的征求意见(按转述,无外链):"我们在考虑干掉 plan mode,改用 shift+tab 快捷键来调 effort 档位(effort levels);我不认为模型现在还需要 plan mode 了——但如果你是 plan mode 死忠,欢迎告诉我们为什么。"

我的看法:这一刀砍的不是功能,是一种交互范式。plan mode 是"两态开关"——计划/执行、想/做,二选一;effort 是"连续旋钮"——同一件事,你想让它想多深。

从模式退到档位,意味着"要不要计划"不再值得单独设一个房间:计划正在被吸收进默认推理里(模型够强时,深度思考是滑动条上的一格,不是另一个模式)。这与四阶阶梯(58035)对得上——当第二级的"显式计划"被能力下沉吃掉,Prompts→Agents 那一级就变薄了;也与三档论(57847)咬合:"评分不是判决、实用起步档"早就说明档位才是用户真正的词汇——shift+tab 一键调档,等于把档位写进了肌肉记忆。

征集死忠反馈这半句同样值得学:公开说"我们要砍了"、再公开收"为什么不能砍"——产品辩经不藏在内部评审里(与今晚"examine the methods、run your own evaluations"是同一种对透明的偏好)。

给还在用 plan mode 的人一句实用的:先别吵范式,去量一下——你最近 20 次任务里,plan mode 帮你挡住了几次返工? 数得出来就死忠到底;数不出来,档位旋钮已经在等你。

功能、快捷键与征求意见均为转述(原帖无外链),以产品方后续更新为准。

显示更多 话题来源 @trq212 922.4K阅读 ❤️9568
Thariq (@trq212) on X we’re thinking of killing plan mode and using the shift+tab hotkey to adjust effort levels I don’t think the models need plan mode anymore, but if you’re a plan mode diehard would love to get your fe X (formerly Twitter)
会飞的荧 ·

《深入理解 AI Infra》更新:社区双语版发布 + 两个新内容(按作者帖转述,仓库见文末)。三件事:①社区翻译的英文版与繁体中文版上线(致谢译者 tg1482、edward821220);②新增 MiMo V2.6 那场直播的 RL 算例——"infra 故障的代价有多大";③新增 DeepSeek DSec 沙箱平台的资源与状态管理——"RL 沙箱跟传统容器云有什么区别"。仓库:github.com/bojieli/ai-inf…

我的看法:这是书线今晚的第二击,且两个新增内容恰好各接一根主线。"RL 故障的代价"接的是账本意识——57904 说 RSI 是"捅窟窿和补窟窿的成本账",这一章等于把那句口号写成了算例(故障不是事故报道、是可算的钱);"RL 沙箱 vs 传统容器云"接的正是今早 58114 那篇五条假设——书和文章在同一天前后脚互相背书:那条讲为什么通用云不行,这一节教你怎么把不行变成结构。

双语发布这半件也有分量:社区自发出英繁两版=书从"一个人的作品"变成"一个项目的资产"(58443 那句"可追溯的终点是代码本身"的出版物版:开源的书和开源的库一样,翻译也该是众包的 PR)。

给读者的落地建议照旧但加一层:先读五条假设那节的速览,再啃新增的两个内容——infra 故障算例给的是"痛感"、容器云对比给的是"方法",一本能把痛感算成钱的书,比十篇架构综述耐读。

双语发布、新增内容与致谢均为作者帖转述,章节细节以仓库为准。

显示更多 话题来源 @bojie_li 5.8K阅读 ❤️88
GitHub - bojieli/ai-infra-book: 《深入理解 AI Infra:量化分析与系统设计》(李博杰 著)开源书稿:从硬件约束和模型架构出发,量化推导 LLM 推理与训练系统设计。含全书正文、PDF、配套计算工具与实验 《深入理解 AI Infra:量化分析与系统设计》(李博杰 著)开源书稿:从硬件约束和模型架构出发,量化推导 LLM 推理与训练系统设计。含全书正文、PDF、配套计算工具与实验 - bojieli/ai-infra-book GitHub
我不是小布丁 ·
写给@ZhouYanAI 的商业思维升级指南,主要内容讲的是一家公司或者一家小公司是如何一步一步成长的,还有其中的一些商业判断 t.co/Pupf39DRol
话题来源 @ChenshuoAI ❤️89
菠萝与大西瓜 ·
其实一直想学Blender,教程终于来了 Astra 发布之后,Blender 下载量猛增 这就是赚钱的机会,配合网盘拉新,这个月收入不敢想 这个推文是关于Blender的,包含了Blender的使用方法。这个方法非常有价值,可以帮助你快速了解Blender的使用方法。 如果你正在使用Blender,这个资源绝对值得收藏。它可以帮助你了解Blender的使用方法,让你不错过任何重要信息。
显示更多 话题来源 @miles_mazy 42.7K阅读 ❤️184
Miles Ma (@miles_mazy) on X 其实一直想学Blender,教程终于来了 Astra 发布之后,Blender 下载量猛增 这就是赚钱的机会,配合网盘拉新,这个月收入不敢想 X (formerly Twitter)
小白爱摸鱼 ·
发现小说直接变视频,这操作你见过没? 整本小说丢进去,系统自己就切章节、扒角色、捋线索,分镜图也一并生成,最后直接合成视频 全程不用人插手,抖音小红书上都刷疯了 传送门:github.com/ArcReel/ArcRee…
话题来源 @shenxiankk 3.9K阅读 ❤️40
GitHub - ArcReel/ArcReel: AI Agent 驱动的开源可自部署视频工作台:将小说与剧本转为角色、场景、道具资产、分镜、视频和剪映草稿,支持跨镜头一致性、多供应商与费用追踪 | Self-hosted AI vide AI Agent 驱动的开源可自部署视频工作台:将小说与剧本转为角色、场景、道具资产、分镜、视频和剪映草稿,支持跨镜头一致性、多供应商与费用追踪 | Self-hosted AI video workspace for stories, storyboards and short-form video production - ArcReel/ArcReel GitHub
胡辣汤爱酸菜 ·

Higgsfield 为 Seedance 2.5 上线 Preview Mode(按官方帖转述,演示视频见原帖)——流程三步说全:①先出一段 480p 的草稿预览;②选定的那条(take)才渲成 1080p 全质量;③定稿前可以对比多条 take、把运镜、动作、时机逐项修到位,再进最终渲染。

我的看法:这是出片线的第二块拼图,与昨晚那块刚好成对——58459 是"生成本身变快"(13 秒出 15 秒的实时档),这条是"便宜的先做、贵的只做一次":480p 草稿=出片流程里的缓存——它与今晚 58501 的缓存折扣、58379 的"先判可比再画图"是同一套哲学的第三次现身:把高频试错挪到低价轨道,把高价动作留给定稿那一次。

三步里最值钱的是第③步:对比 take 再渲——这等于把"运镜、动作、时机"从"渲完才知道"变成"渲前可改",试错成本被前置消掉了(与 57844"剪辑三刀"、57835"改一处看全图"同一条省算力纪律);而 480p→1080p 这个跳跃也说明平台看得很清:草稿不需要好看,需要便宜和快——预览是给眼睛的、成片是给档期的,两者不必同价。

给创作者一句落地的:渲 1080p 之前先问自己"这条 take 的运镜定了吗"——没定就别进终渲;两级渲染把预算省在对的地方,和"先跑便宜的再付贵的"在代码里是同一条真理。

功能、分辨率与流程均为官方帖转述(视频未取),以 Higgsfield 官方页面为准。

显示更多 话题来源 @higgsfield 34.9K阅读 ❤️457
Higgsfield AI 🧩 (@higgsfield) on X Introducing Preview Mode for Seedance 2.5 on Higgsfield. Generate a 480p draft preview, then render your chosen take in full-quality 1080p. Compare takes and refine the camera movement, action, and X (formerly Twitter)
小白爱摸鱼 ·

OpenAI 官方:GPT-6 家族配上"更好的 prompt 缓存"(按公告转述,链接见文末)——三句话:①默认缓存命中率更高;②共享前缀在 30 分钟窗口内复用,给缓存折扣;③配套新工具,帮开发者监控缓存表现、诊断"为什么没命中"、以及"缓存 prompt 的多少"自己选。

公告:openai.com/index/better-p…

我的看法:缓存这条线今晚第五次出现——Rapid-MLX 的 15K 上下文 34.2s→0.95s(58132)、Pi 0.87 的"经历与视角分家"(58111)、Cursor 四招里的"更好的缓存"(58135)、"同聪明少 token"的秒答与无感(57591),今天 OpenAI 把它做成了价格条款+诊断工具——三次分别是性能(更快)、架构(该存什么)、商业(省下多少),合起来才是缓存的完整经济学。

三处细节最值钱:"共享前缀 30 分钟窗口"=把折扣钉在最常见的复用形态上——系统提示、工具定义、长文档开头这些人人相同的前缀,本就是全场最便宜的那部分;"缓存多少自己选"=把粒度交给开发者(烧钱的从来不是缓存本身,是不该缓存的被缓存了);"监控+诊断 miss"则是观测面的厂商版——58032 说"先知道自己烧多少",OpenAI 这套等于说:先知道你丢了多少命中,再谈谈价。

给开发者一句落地的:去查你的缓存命中率——如果长期低于五成,问题多半在"前缀不稳":每次请求开头顺序变一点、时间戳塞进 System、工具列表来回改,命中率就塌了;稳定前缀是免费的午餐,把易变的东西挪到 prompt 尾部,比等任何折扣都实在。

折扣、窗口与工具能力均为官方公告转述,计费细则以 OpenAI 官方页面为准。

显示更多 话题来源 @TheRealAdamG 10.6K阅读 ❤️238
我不是小布丁 ·

VS Code 最新版本把"大体量 agent 会话"当成了正经需求(按官方更新转述,更新页见文末)——两句话说全:①大体量的 agent 会话列表,现在更快、更好管理;②agent 会话可以直接跑在 Dev Containers 里,本地与远程主机都行(更新页有完整变更清单)。

更新页:code.visualstudio.com/updates/v1_139

我的看法:这条正是断档期漏掉、如今补上的那单——而它与今天的主线咬得意外地好。"大体量会话列表更好管理"=会话线的规模补丁——58111 把 Session 与 Context 分了家(58464 又给任务分了分支),当一个人手上同时挂着几十个会话,列表本身就成了基础设施:分家解决"看到什么"、列表解决"找得到哪个",两条合起来才是并行时代的完整工位;Dev Containers 本地+远程双开则把"工位"的概念又推了一格——58133 的 Devin 是云上 VM(SSH 进去、handoff 回来),VS Code 这条是你自己的容器(本地或远程主机):会话在哪跑不再取决于你坐在哪——与"把 agent 本体搬回家"(58385)拼起来,本地线的版图补齐了"本机原生"与"容器隔离"两档。

给重度用户一句:会话一多,先收拾列表再谈效率——开一个 dev container 把乱摊子圈进隔离层;能管住列表的人,才有资格开更多窗口。

功能与双场景均为官方更新转述(清单未展开),细节以更新页与 changelog 为准。

显示更多 话题来源 @code 18.7K阅读 ❤️213
Visual Studio Code 1.139 Learn what is new in Visual Studio Code 1.139 code.visualstudio.com
飞翔的智能体 ·

DeepSeek 开源库 DeepEP 升级到 V2.5(按公开仓库更新转述,仓库见文末)——这是给 MoE 模型"多卡通信"供血的那根毛细血管,七处升级挑重点念:①缓冲区分家——ElasticBuffer 拆成 EP/Engram/PP/Bucket 四种 Buffer,共享同一套生命周期、职责各归各;②先规划再分配——新增 BufferAllocator,建缓冲区前先规划对称张量占显存,少浪费少碎片;③批量集合通信——BucketBuffer 支持批量 all-gather/reduce-scatter/all-reduce,普通 PyTorch 张量也走同一套接口;④动态冗余专家——NVLink 预取权重、FP32 梯度回累,对齐 MoonEP/UltraEP 的专家复制思路;⑤训练细节补齐(延迟 EP 收尾、缓存扩展布局、专家间零填充);⑥多层 Engram 可在 GPU/CPU 分层存;⑦大扫除——V1 API、NVSHMEM 后端、旧文档全部移除,NVSHMEM 不再是依赖。仓库:github.com/deepseek-ai/De…

我的看法:这是基建线的第五件——57904 的沙盒管"世界够不够多"、57992 的芯片管"单点够不够快"、57645 的底座管"账够不够省",DeepEP 管的是中间那段:几十张卡说话快不快——MoE 时代的吞吐瓶颈从来不在算力在通信,这条升级的每一刀都砍在"通信的杂费"上。

三处与今晚的纪律严丝合缝:"缓冲区分家+职责各归各"=能拆才能自己改(57927)的内存版;"先规划再分配"=方案四原则(57993)直接落到显存分配器上——先想清楚再动手,GPU 与人同理;"NVSHMEM 彻底移除"=简化第一步先砍重复,敢删整个后端依赖,比加十个功能更见决心。

而"对齐 MoonEP/UltraEP 思路"说明生态在向共同标准收敛——当各家 MoE 通信库互相对齐,写一次适配三代卡就不再是梦。给跑训推的人一句:看通信库别看 star 数,看它敢不敢删旧接口——依赖清单越短的库,越知道自己每天在生产里跑什么。

七处升级与移除项均为公开仓库口径转述,用法与兼容以 DeepEP 仓库文档为准。

显示更多 话题来源 @NFT_Chen 10.5K阅读 ❤️80
GitHub - deepseek-ai/DeepEP: DeepEP: an efficient expert-parallel communication library DeepEP: an efficient expert-parallel communication library - deepseek-ai/DeepEP GitHub
胡辣汤爱酸菜 ·

Google 向 Gemini 用户开放 GPU 机时(按转述整理,无外链):通过 Colab CLI 访问;Pro 用户每月折合约 26 小时的 A100(80G)使用权限;原帖的开头梗也很妙——"本地 AI 最严厉的父亲出现了"。

我的看法:这是一格算力直给的福利——与限免格(57886 那类"模型免费")不同,这次发的不是 token,是 GPU 小时:26 小时 A100 是可以换算成"跑多少轮微调、推理多少千 token"的硬通货,成本线货架又添了一种面额(前面几格卖的都是"使用权",这格直接卖"机时")。

更妙的是"本地 AI"这个词的弹性:今早那篇讲的是真·本地——agent 本体搬回你自己的机器(58385);这篇的"本地"其实是借云端的 A100——本地的是工作流,不是机器:你坐在本地、命令行走 Colab、算力借 Google 的。

两种"本地"都成立,但账要分清:真本地省的是订阅、借机时省的是等待——一个买断、一个按月发零花钱。Colab CLI 这个入口也值得注意:Google 把机时接到命令行,等于承认了"AI 的工作面正在从网页搬到终端"(与今晚 Cline、SDK、Dev Containers 那条并行线同一个方向)。

给用户一句落地的:先算你每月真用得完多少小时——26 小时听着多,按 A100 的价折算其实只够几次认真训练;领福利之前先列需求,否则"免费"只是把闲置换了个名字。

机时、访问方式与额度均为转述(原帖无外链),以 Google/Gemini 官方权益页为准。

显示更多 话题来源 @ivanalog_com 159.5K阅读 ❤️851
seekinganythingbutalpha (@ivanalog_com) on X 本地AI最严厉的父亲出现了 Google向Gemini用户开放了GPU机时权限,可以通过Collab CLI访问。 Pro用户每个月折合约26个小时的A100(80G)使用权限 X (formerly Twitter)
会飞的荧 ·

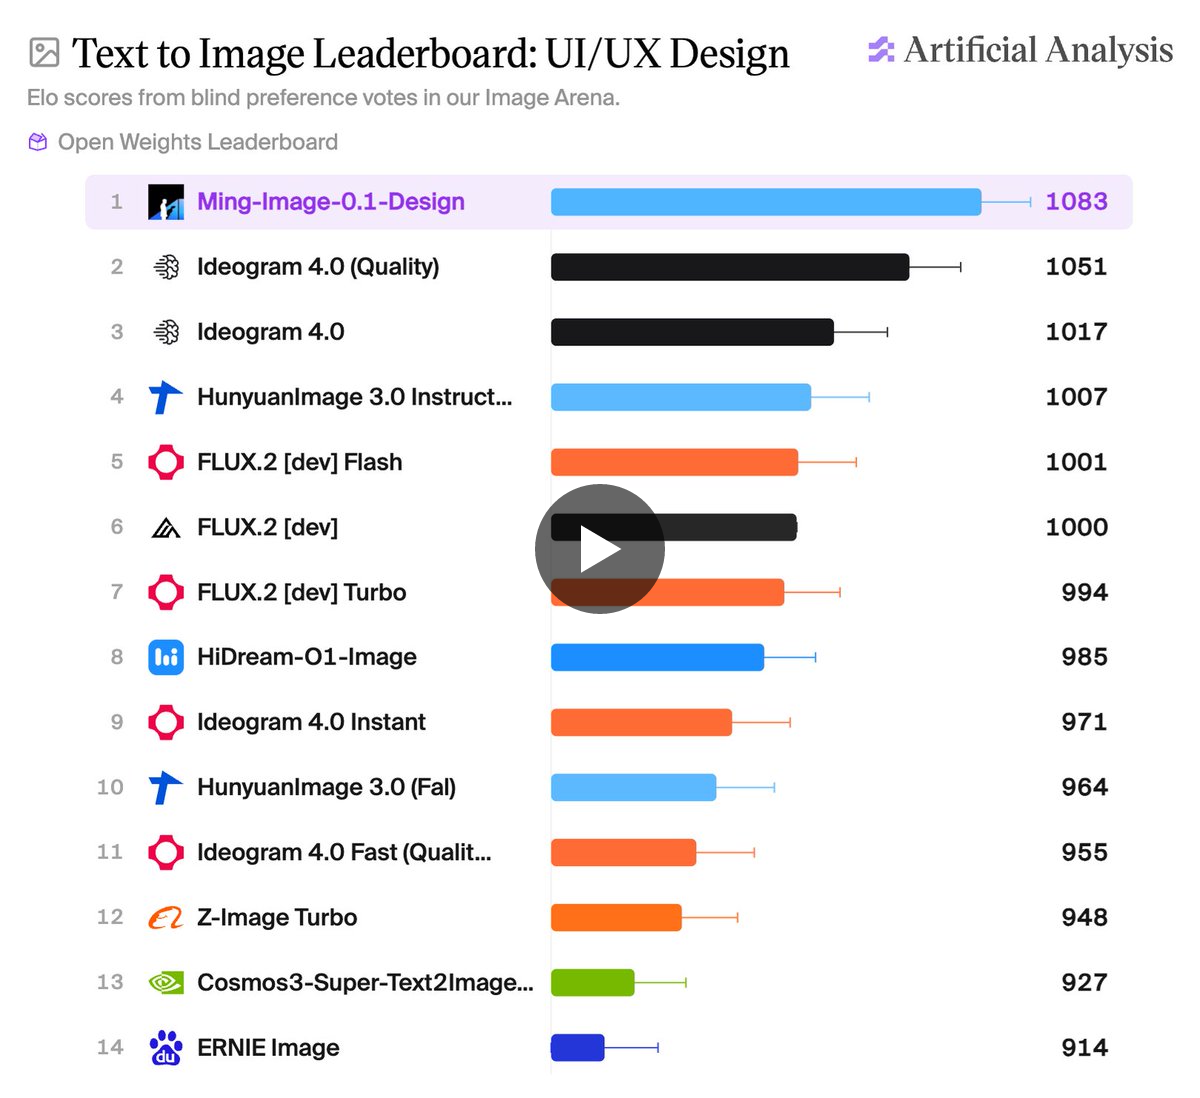
Artificial Analysis 榜单更新:Ming-Image-0.1-Design 登顶 UI/UX 设计类目(按官方帖转述)。要点几条:①身份——inclusionAI(蚂蚁 AI 计划)出品的 6B 文生图模型,MIT 协议开源权重;②专长——为 UI、信息图、海报等"文字密集型视觉设计"而生,支持 RGBA 透明背景输出;③评测口径——AA 按官方推荐的 2K 分辨率、12 步推理实测;④名次的两面——UI/UX 设计类目:81 个模型里排第 17、开源权重第一;整体文生图总榜:160 个模型里排第 45;分析与样例在原帖串(X 站内,本条未展开)。

我的看法:这份榜单是设计生成线的第三块拼图——57851 发过它的架构(两个 6B+四 LoRA 专家头+双 Skill),57920 讲过"能变 PPT 才算资产",AA 这条给了外部裁判的签字:6B 的小个子靠专精,在类目里打赢了比它大得多的对手。

两组名次的落差正是最值钱的信息:类目 #17/81、总榜 #45/160——专精定位让它"在自己的赛道第一、在所有人的赛道中游";这与今晚三处判断完全同频:四阶阶梯(58035)说别停在第二级、岗位预制件(57524)说按工位切、这条说按场景定位——定位比体量重要,是小模型时代的第一定律。

评测口径那句也照录以示公道:2K、12 步、官方推荐设置——榜位是"按说明书跑"跑出来的(这正是"名字可以读错、基准读不错"的另一半:跑法不一致,名次就不可比)。给选型者一句:做 UI、海报、信息图这类"字多图少"的活,别被总榜 #45 吓退——去类目里找第一;MIT + 6B 意味着今天就能拉下来自己验,而它的透明背景(RGBA)恰好是设计素材最实用的那一格。

榜位、参数与评测设置均为 AA 官方帖转述,样例与完整分析以原帖串及 AA 页面为准。

显示更多 话题来源 @ArtificialAnlys 10.3K阅读 ❤️88
Artificial Analysis (@ArtificialAnlys) on X inclusionAI's Ming-Image-0.1-Design is the #1 open weights model for UI/UX Design on the Artificial Analysis Text to Image Leaderboard, ranking #17 amongst all models in the category Ming-Image-0.1-D X (formerly Twitter)
会飞的荧 ·

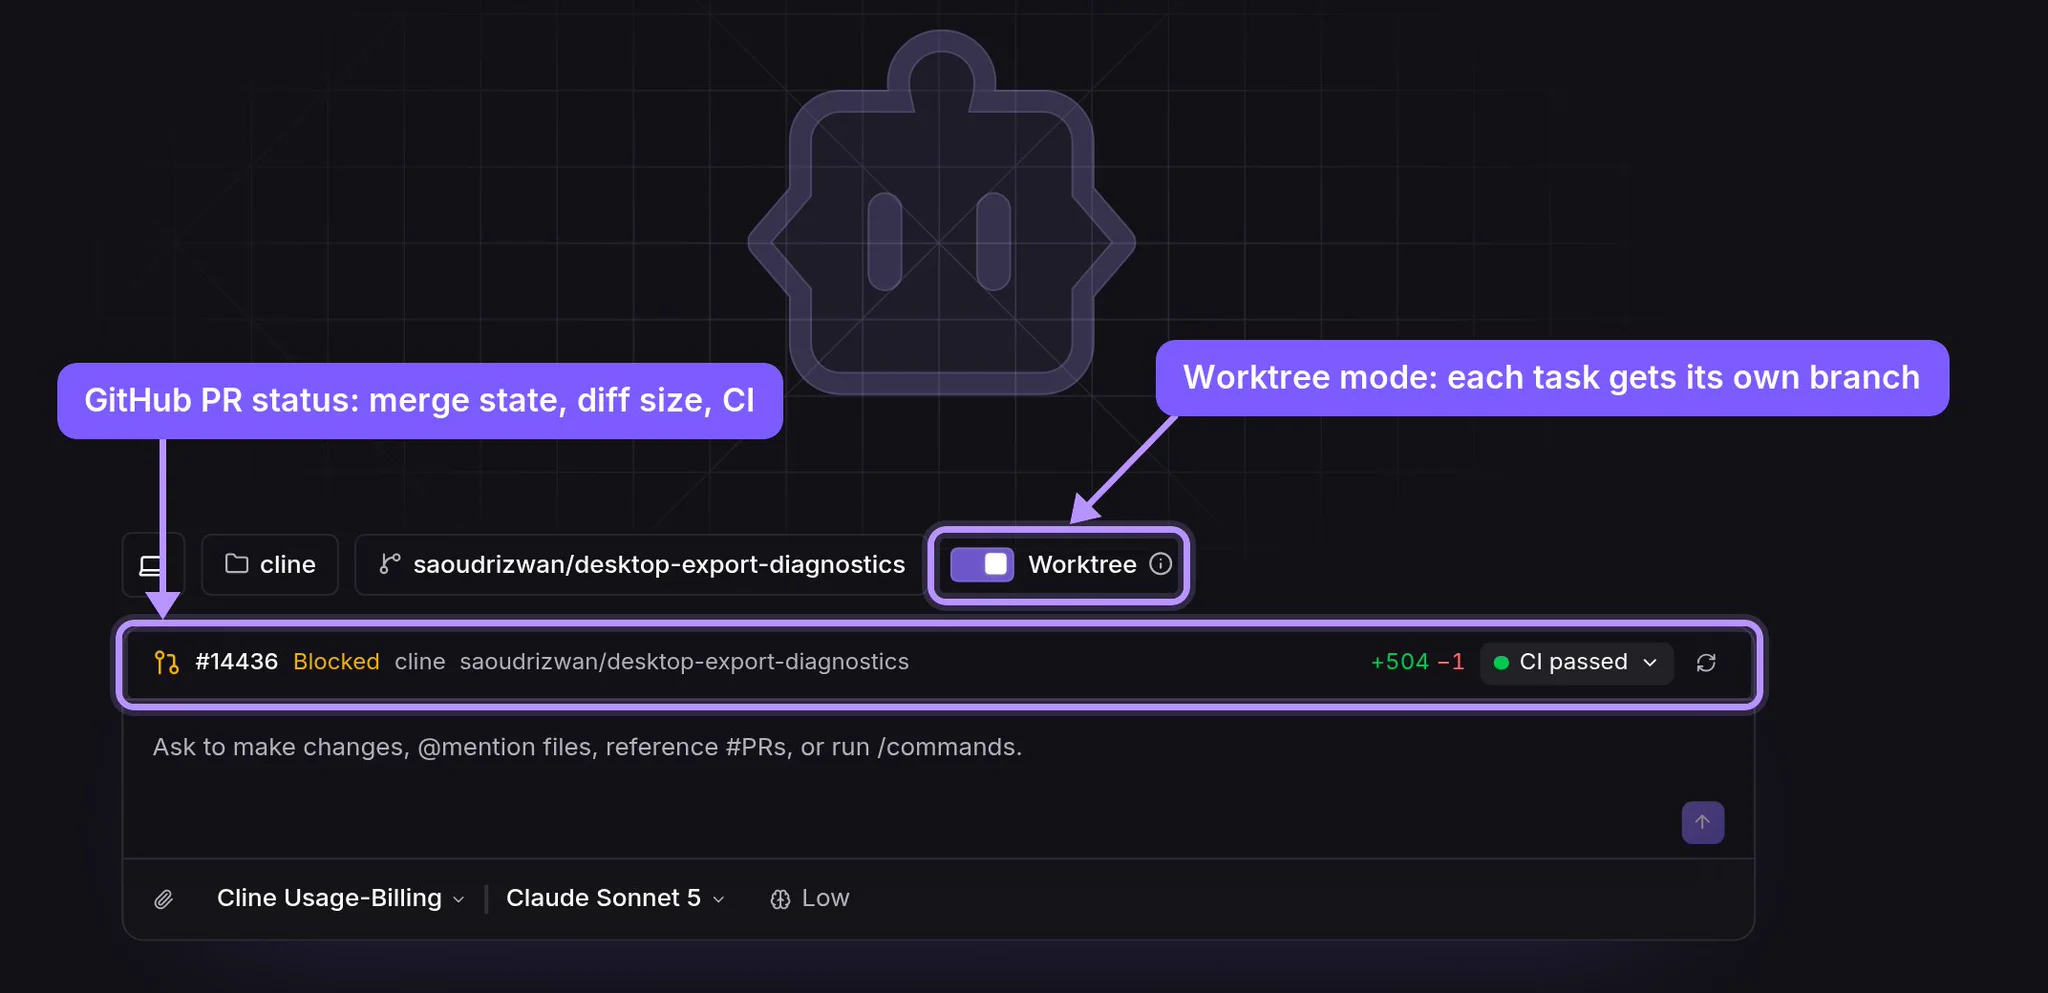
Cline Desktop v0.0.34 更新(按官方帖转述,图见原帖)——三个新件:①Worktrees:多个任务并行跑,每个任务独占一条分支(落在 ~/.cline/worktrees/);②GitHub PR 状态:分支的 PR 链接、合并状态、CI 检查直接可见(需 gh);③Parallel subagents:一个会话里同时派出多个子代理分头干活(无外链,细节以官方 changelog 为准)。

我的看法:三条合起来是"并行架构三件套"——Worktrees 解决"改动不互相踩"、PR 状态解决"改完敢不敢合"、并行子代理解决"一次只干一件事";它与今天那条"单 Slack 频道全线程 Claude"(58373)是同一问题的两端:那边靠人和频道组织并行,这边把并行直接写进工具——分支当工位、子代理当帮手、PR 状态当交接条。

最妙的是 Worktrees 那个选址:每个任务一条自己的分支、自己的目录——这正是分布式老课(57890)"隔离与幂等"的桌面版:状态各归各,才谈得上同时跑;"会话各占各的分支"也接上了 session 分家(58111)那条线——从"上下文分家"到"文件系统分家",并行的隔离越做越深。

给多任务用户一句:并行的前提不是机器快,是隔离做得干净——先开 worktree、再派子代理、最后看 PR 状态收口;三件套顺序别反,否则三条任务会在同一条分支上打架。

功能、路径与依赖均为官方帖转述(图未取),以 Cline changelog 为准。

显示更多 话题来源 @cline 6.1K阅读 ❤️108
Cline (@cline) on X New in Cline Desktop v0.0.34: > Worktrees - run multiple tasks in parallel each on its own branch in ~/.cline/worktrees/<id> > GitHub PR status - see branch’s PR link, merge status, and X (formerly Twitter)
我不是小布丁 ·

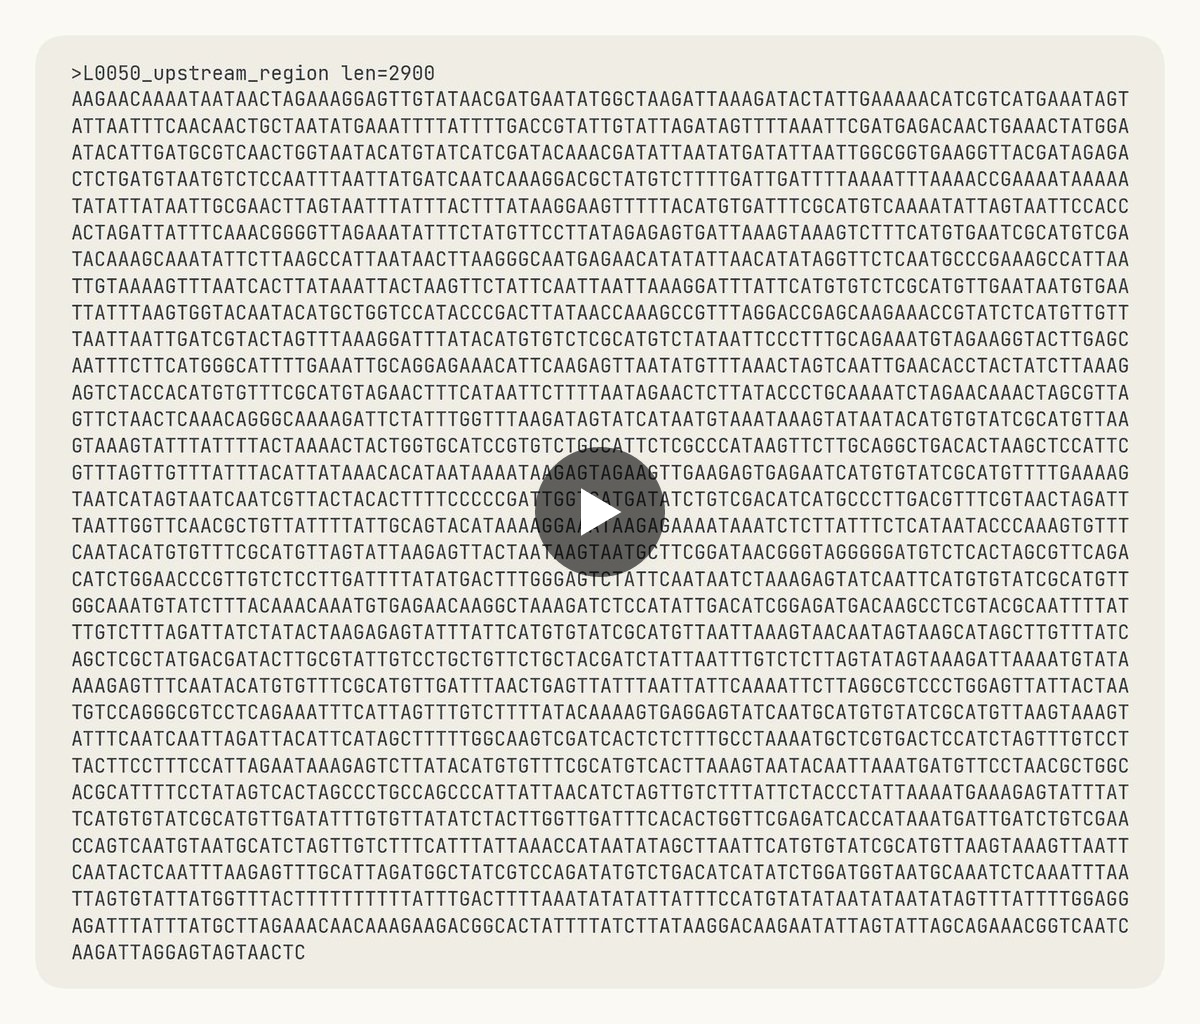
一条让科学圈炸锅的推(按转述整理,配图见原帖):"Claude 找到了人类漏掉的东西"——在原始噬菌体 DNA 里发现一个隐藏的重复模式,进而揭出一个此前未知的、带 CRISPR 式重复序列的噬菌体酶系统";工程侧三个数字跟着甩出来:950 个 agent、21 小时、2.1 亿 token。

我的看法:这是今早那个愿景的第一例具体化——57977 引吴泳铭说"思考成本趋近零时,上百万个 Agent 可以不眠不休跑实验,那些因不赚钱没人管的病第一次有了被认真对待的可能",这条给了一个缩水但真实的版本:950 个 agent 跑了 21 小时,去翻人类懒得翻的那堆原始序列。

三处值得盯:①它的分工是"扫"不是"想"——950 个 agent 的价值在穷举与模式比对这类人力最贵、耐心最差的活,Agent 群最适合的科学岗位,是把"没人肯看的角落"全部看完(ScienceBuddy 是"一条流水线做深",这条是"950 条流水线铺宽"——深与宽是科研 agent 的两副面孔);②2.1 亿 token 这本账——按今晚的口径折算,一次"未知酶系统"的发现,成本是一家小公司的服务器开销(57989 那张小时表的现实注脚:发现正在变成可采购的服务);③口径必须钉死——"此前未知""CRISPR 式重复"均为推文自述、尚未经同行评议,我方照录不背书:科学发现的认证从来不发生在推特上(与"名字可以读错、基准读不错"同一纪律:结论要等复现,不等转发)。

给关注者一句:这种新闻别急着转结论——去等那篇 preprint 或论文;但方向本身已经清楚:当 950 个 agent 一晚上花掉 2.1 亿 token 去做"没人肯做"的搜索,科研的边际成本曲线正在被重画。

数字与发现均为原帖转述(未经同行评议,不构成科学或医学结论),以论文与官方披露为准。

显示更多 话题来源 @minchoi 227.6W阅读 ❤️8350
Min Choi (@minchoi) on X This is wild. Claude just found something humans missed. It spotted a hidden repeat pattern in raw bacteriophage DNA… …and uncovered a previously unknown enzyme system in bacteriophages with CRISPR X (formerly Twitter)
飞翔的智能体 ·

FastVideo 把 Minimax H3 微调到"实时出片"(按转述整理,模型页见文末)——那句最抓眼的实测:15 秒的视频,13 秒生成完毕;最高 14 倍提速,且音画同步。

技术栈五件照录:H3 主干、每次生成只跑 4 次 transformer 前向(原版 49 次)、data-free 的 DMD2 蒸馏、90% 稀疏注意力、同步音频。模型页:huggingface.co/FastVideo/Fast…

我的看法:这是 H3 线的第四击,也是质变的一击——官方制作(57719)给了工序、VAE 提速(57746)给了引擎优化、Singularity 社区档(57816)给了质量压榨,这条把视频生成从"离线出片"推进到"实时出片":13 秒出 15 秒片,意味着生成速度追上了播放速度——与昨晚"世界模型实时交互"(57982)正好接上:那边是边玩边改,这边是边说边出,视频正在从"文件"变成"流"。

五件技术里最值得记的是"4 次前向代替 49 次"——12 倍的计算削减不是靠换更强的卡,是靠把采样步数做成蒸馏(DMD2+稀疏注意力同一思路:能少算的绝不重算,与"先砍重复"(57927)、Cursor 四招(58135)是同一条工程哲学的第三次现身)。

给创作者一句:实时档改变的不是画质,是试错成本——以前"改一个想法=等一轮渲染",现在想法和预览之间只剩十几秒,迭代次数才真正决定成片上限(90 秒出片线 57899 那句"多试几版",从此不用心疼时间)。

参数、提速与技术栈均为原帖转述,效果与许可以 HF 模型页为准;实测随硬件差异较大。

显示更多 话题来源 @0x0SojalSec 6.7K阅读 ❤️125
FastVideo/FastVideo-FastH3-4-step-Preview-v1-VSA-DataFree · Hugging Face We’re on a journey to advance and democratize artificial intelligence through open source and open science. huggingface.co
小白爱摸鱼 ·

rasbt(Sebastian Raschka)的一句判断(转述,原帖无外链):"开源 agent harness 的主要吸引力,不是它们免费,而是我们可以检视它们在我们电脑上做了什么。"

我的看法:这句把今晚三篇的共同点一次说破——58443 的"可追溯终点是代码本身"、58163 的"可以读它的 ScienceIDE 式底座"、今早 58385 的"数据完全私密",合起来其实都在说同一件事:信任的单位不是价格,是可检视性。

rasbt 的措妙在先否掉了那个最便宜的解释:"免费"只是顺带的福利,真正的卖点是"你能打开看"——而"在我们电脑上"这半句更狠:跑在我机器上的东西,我却无权检视,才是真正的越权(这正是本地自控三件套一再强调的那条线:能进来的,就要能看)。

反过来说,这句也给闭源划了道沟:闭源模型卖能力、开源 harness 卖"知情"——两条赛道不互斥,但涉及你自己数据与代码的那一段,天平只能往可检视这边倾。给选型者一句落地的:下次评估一个 harness,先别看星数和价格——打开仓库,找到"它会发什么请求、会写什么文件"那两段代码,读得懂就用,读不懂就先别让它碰生产(与"敢先省自己 token 的才值得信"是同一把尺子的两端)。

判断为原帖转述(无外链),项目细节以各自仓库为准。

显示更多 话题来源 @rasbt 26.5K阅读 ❤️724
Sebastian Raschka (@rasbt) on X The main appeal of open-source agent harnesses isn't that they are free, but that we can inspect what they are doing on our computers. X (formerly Twitter)
你弄伤我的鳞片了 ·

斯坦福 CS146S「现代软件开发者」:八周作业全公开(按转述整理,仓库见文末)。课程骨架逐周可抄:①提示词技巧 → ②给现成小应用加功能 → ③自己写一个 MCP 服务把外部接口接给模型 → ④用 Claude Code 至少搭两个自动化流程 → ⑤用 Semgrep 扫出并修掉至少 3 个安全漏洞 → ⑥最后一周把同一个应用用 3 套技术栈各做一遍;起步项目与测试大多现成,第一周还用 Ollama 在本地跑模型。

最值得单拎的是第七周作业:每个任务只给 AI 一次提示、让它写完,然后自己逐行审查,最后拿自己的审查意见与 AI 的审查结果对照。作业仓:github.com/mihail911/mode…

我的看法:这份课表是今晚两条线的教学版合体。验收线那一格被第③周和第⑦周说得最透——"人审 vs AI 审、逐行对照"正是 57993 座位表里"谁验收"的训练法:不先学会自己审一遍,就没资格让 AI 审(57911 那句"不知道怎么验的欠账"在这里变成了一门课);Semgrep 修 3 个漏洞则与靶场篇(57835)同脉:安全不是选修、是写进课表的作业。

结构上它也暗合四阶阶梯(58035):提示词→功能→MCP→自动化→安全→多栈复刻,六级台阶一格没跳,最后一周"同应用三套技术栈"更是把"会用工具"逼到"理解结构"——换栈还能做出来,才算真懂。

给没课上的人,原帖给的路照抄:八周作业自己过一遍,照着公开仓走;第⑦周那条尤其值得先做——只给一次提示、逐行自审、再与 AI 审对照,这一个动作就能测出你是"在用 AI"还是"被 AI 用"。

课程结构、周次与作业要求均为转述,细节与起步项目以 GitHub 作业仓为准。

显示更多 话题来源 @GitHub_Daily 55.4K阅读 ❤️853
GitHub - mihail911/modern-software-dev-assignments: Assignments for CS146S: The Modern Software Dev (Stanford University Assignments for CS146S: The Modern Software Dev (Stanford University Fall 2026/2025) - mihail911/modern-software-dev-assignments GitHub
我不是小布丁 ·

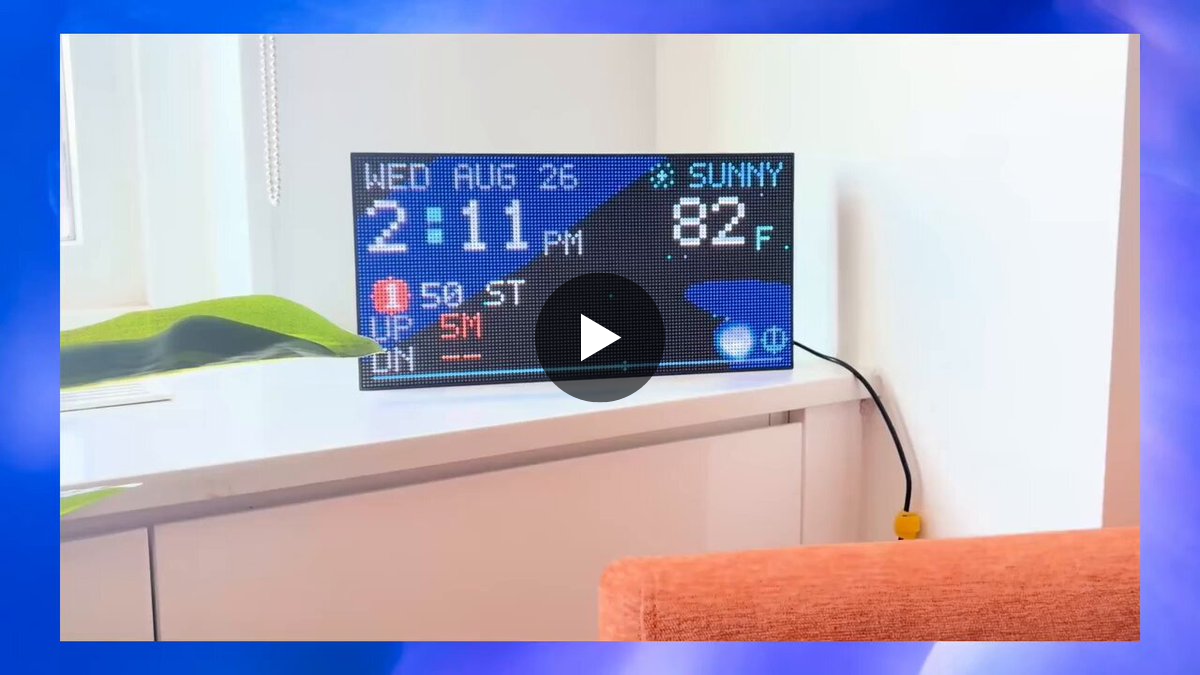
OpenAI 官方展示了一个动手案例(按官方帖转述):工程师 sidrampally 用 Codex 把一块 LED 显示屏改造成"语音控制的助手"——从接线("figuring out the wiring")到调试,一路做到"把那句话显示在墙上";硬件是树莓派,大脑是 GPT-Live-1,屏幕上轮播天气、地铁到站等信息(演示视频见原帖,本条未取)。

我的看法:这条的关键词是那个没解释过的新名字:GPT-Live-1——官方案例里它不写"GPT-5x"也不写"4o",直接冠"Live":实时、活着、随时插话的语音档,配的恰是"语音控制"这种不能等三秒的场景;再看组合拳:Codex 写代码、GPT-Live-1 听话出声、树莓派当身体——一个案例里塞了三种角色:干活的、对话的、承载的,这正是今晚反复出现的分工图缩影(57993 座位表:谁动手、谁接话、谁站岗)。

案例本身也很"日常硬件":LED 屏+树莓派不是实验室,是抽屉里就能凑齐的东西——与 Kaggle 那句 everyday hardware(58426)、agent 本体搬回家(58385)连成一条线:官方在用同一个故事说服你——AI 的下一站不在云上炫技,在你桌角那块小板子上。

给动手党一句:别小看"天气+地铁到站"这种无聊信息——能把无聊的事做得随时可问、张口就答,就是语音助手第一次真的像助手;想复刻的话,先想清楚你要它"答"还是让它"做"——这条案例答的是后者还没来、前者已经够好玩。

功能、硬件与模型名均为官方帖转述(视频未取),GPT-Live-1 细节以 OpenAI 官方文档为准。

显示更多 话题来源 @OpenAIDevs 48.2K阅读 ❤️578
OpenAI Developers (@OpenAIDevs) on X From figuring out the wiring to debugging “show that on the wall,” @sidrampally shares how he used Codex to turn an LED display into a voice-controlled assistant. Powered by GPT-Live-1 and a Raspberr X (formerly Twitter)
小白爱摸鱼 ·

Space Bunny Alpha 上架 OpenRouter(按官方帖转述,链接见文末)——规格四条一次给全:flash 级快推理、可调的推理深度(adjustable reasoning)、1M token 上下文窗口、接受文本/图像/视频三种输入;入口挂在 stealth 路径下:这是一只"隐身模型"——跑分与体验摆在台面上,身世暂时不揭晓:openrouter.ai/stealth/space-…

我的看法:这条的妙处在"stealth"这个词上——58067 我们写过"鹈鹕骑车成为公共考题":不知道是谁,反而更像一场诚实的考试;Space Bunny 把这套逻辑产品化了——先给规格、再给入口、不给身份证,用户对标的不再是品牌光环,而是手里那份实测(1M 上下文配三模态输入,恰好够跑今晚反复出现的那几类题:长上下文检索、图像理解、视频理解)。

"可调推理深度"也值得注意:把"想多深"交给用户旋,等于承认同款模型在不同任务上有不同档位——与三档论(57847)里"试错与稳态分家"是同一种清醒:一个模型不是一个性格,是一条可调的曲线。

再看货架的边角:Space Bunny 一路从 opencode 的限时免费、到暂时下线、再到如今带着完整规格开卖渠道——隐身模型的商业路径已经跑通:免费试→藏起来打磨→带牌上架。

给尝鲜的人一句:stealth 期间别问它是谁——拿你自己的题单去跑,答案写在你的记录里,不写在它的名字里。

规格、入口与隐身状态均为官方帖转述,可用与定价以 OpenRouter 页面为准。

显示更多 话题来源 @OpenRouter 82.1K阅读 ❤️750
Space Bunny Alpha - API Pricing & Providers Space Bunny Alpha is an anonymous large model with blazing-fast inference, strong coding capabilities and native multimodal input support. This model is free to use. 1,000,000 token context window, ma openrouter.ai
自由翻滚的风铃草 ·

Kaggle × Gemma 官方开赛(按官方帖转述):Gemma 4 Developer Agent Competition 现已上线——题目一句话就是定义:"把一个开源模型后训练(post-train)成一个 coding agent,让它在日常硬件上加速开发者的工作流";总奖池 10 万美元、投稿截止 2026 年 11 月 25 日(未附报名外链,以 Kaggle 官方页面为准)。

我的看法:三个点各自有出处可接。其一,题面把"后训练"从论文搬进了公开赛——RSI 线那些"33 轮零人工"(57594)与混合 RL(58073)是大厂的玩法,这场比赛是同一条技术路线的平民版:一次 post-train、一个 agent、人人可交卷——当训练从论文变成赛题,"自迭代"就不再只是基础设施竞赛;其二,"日常硬件"四个字与今早那篇正咬合——Gemma 4 恰是 Antigravity SDK 本地执行(58385)的主角:白天你在本机跑它、比赛让你把它训成 agent——同一款模型,本地线的"用"与"改"第一次出现在同一张桌上;其三,"coding agent 加速日常工作流"这个目标口径,和今晚"99 比 1"(58005)、"四阶阶梯"(58035)完全同向:评的不是跑分多高,是能不能真的替人干活。

给想参赛的人一句实务建议:赛程到 11 月底还有两个月余——先用官方 Gemma 4 基线跑通"读 issue→改代码→过测试"的最小闭环,再谈 post-train 花活;everyday hardware 是题眼也是约束——别在云端把模型调漂亮、到评委的笔记本上跑不动。

奖池、截止与题面均为官方帖转述,报名与规则以 Kaggle 页面为准。

显示更多 话题来源 @kaggle 51.5K阅读 ❤️994
Kaggle (@kaggle) on X Post-train an open model into a coding agent that accelerates developer workflows on everyday hardware. The Gemma 4 Developer Agent Competition, hosted by @googlegemma and Kaggle, is live! 💰 Total P X (formerly Twitter)
会飞的荧 ·
OpenAI 官方案例里的三段链路值得拆:欧洲初创 V7 的平台要解三个真问题——公司内部发生过什么、文件里的实体怎么关联、结论究竟来自哪份材料(用法见引文,链接在文末)。 答案是一条链路:散落文件整理成带来源引用的 Context Graph → 不同能力与成本档位的模型分工 → 检索、推理、工具调用与审计串进同一条工作流。三段各解一个断点:图谱管"知道在哪",分工管"该谁做",审计管"敢不敢用"——企业场景里最贵的从来不是生成,是溯源与交接。 口径三条:①Context Graph 不是免费的——建图要人审要维护,文件越乱这笔账越大;②成本档位分工落到选型=延迟与质量的取舍,热点给贵档、例行给便宜档的边界自己划;③官方案例只展示跑通的一条——你的实体密度与权限结构能不能长出这张图,先拿一个部门试。 给要试的三条:一,先圈文档最杂、追责需求最硬的部门(法务或客服),在那里建图收益最先显形;二,每个节点强制挂来源,宁可图稀也别有悬空结论;三,把"结论→材料"的回链做成验收项:AI 给的每个判断,点得开出处才算数。 企业记忆的下一形态不是更大的对话框,是带引用的图——先让你的下一个判断,能被点开看到出处。 best.xiaohu.ai/article/v7-con…
显示更多 话题来源 @xiaohu 9.5K阅读 ❤️31
案例:给企业 AI Agents 装上“长期记忆”和“企业上下文”:V7 如何用 Context Graph 跑通复杂商业工作流 · 小互 · AI 解读站 企业智能体为什么总像第一天上班的新员工?V7 把散落文件整理成可追溯的 Context Graph,再让 Luna、Terra、Sol 与 Astra 分工完成从抽取到复杂推理的工作。 小互 · AI 解读站
小白爱摸鱼 ·
CC Switch 维护者的小故事摆出开源曝光悖论:为方便国内下载,源几月前迁去 Cloudflare——用户方便了,star 却放缓(不经停就不进推荐流);上版发前顺手加一行提示,star 曲线出现"不可思议的一幕"(截图以源帖为准)。 三处:一,镜像优化下载、牺牲可见性——star、issue、release 是平台曝光货币,绕开等于退出这套体系;二,一行提示是把可见性要回来——只修通路不增价值,边界(提示 vs 乞讨)看放哪;三,传播量级说明这悖论普遍——人人都有"给了方便反丢星"的经历。 口径:①star 是曝光信号不是质量信号——迁移后 star 掉下载没掉,真实使用看下载量与 issue;②"不可思议"是单次事件——截图是个例,效果自己加了才知道;③CC Switch 只是 Claude Code 生态的切换器——结论别外推,依赖度各项目不同。 迁源三条:一,先算曝光账:镜像下载 vs 推荐流长尾,谁大迁谁;二,若迁,修回去的路——README 挂 Star、release 双发;三,盯下载量与独立 issue,那才是镜像时代的体温计。 给方便与留星标未必只能选一个——你为"顺手"付出的代价,数清了吗?
显示更多 话题来源 @Jason_Young1231 7.6K阅读 ❤️87
查看完整榜单
查看完整榜单
查看完整榜单