你上周用 Codex 修好过一个 bug,这周换 Claude Code 却得从头再来,这事有解了。
Beacon 是 asymptotelabs 开源的、会自我改进的编码 agent 记忆层。这版发布带了 Beacon MCP:给海量会话历史做极速检索,任何 harness 里的任何 agent 都能用,Claude Code、Codex、Cursor、OpenCode,往后还挂着二十多个。
它抓下你跑过的每一场 agent 会话,问题只在于下一个 agent 一场也看不见,MCP 把这条断掉的线接上。
接入动作是命令级的。beacon mcp connect 一条下去,它找出你装过的各个 harness,把 Beacon 逐个接进去。登录走 OAuth,配置文件里不会留下 API key。
接好之后,每个 agent 都能搜全部历史会话、翻遍它干过的每件事、调出当初修 bug 的那条命令。关键是只读:能查,改不了也删不了。于是 Claude Code 看得见 Codex 上周怎么修的 bug,Cursor 找得到在 OpenCode 里弄崩构建的那条命令。想留在本地,beacon mcp serve 整套跑在自己机器上,不联网也不用账号。
只读这半条设计我看重。记忆层最容易出的乱子是被写花,一个 agent 抹另一个的账,前面删记录那篇刚讲过这个隐患。Beacon 把读写权限钉死在只读上,等于把风险关在门外。OAuth 那半同样对味,配置文件不留钥匙,跟前面备份、打码那两条老规矩是一路的。
我留的疑问在体量。PB 级检索听着漂亮,本地会话攒了几个月的用户,查询真到那个量级才有感觉,新用户头一周多半用不出差别。
仓库挂在上面,先连自己的两三个 harness,下次换客户端时让它们互相看看对方的记录,那感觉最直观。
GitHub 官方预告:"Let s Learn GitHub Copilot SDK"(按公告转述)——9 月 24 日起开播:面向新手的系列直播,教你怎么用 GitHub Copilot SDK 构建 agentic 应用,而且"无需自己实现 agent loop";专设 .NET 与 Java 开发场次;报名支持英语、中文、葡萄牙语、西班牙语、日语、韩语六种语言(报名页见文末):gh.io/letslearn
我的看法:"不用自己实现 agent loop"这七个字就是这则预告的全部行情——今晚刚写过四阶阶梯(58035:Prompts→Agents→Loops→Graphs)与"停在第二级当系统"那句警告,GitHub 这次直接把第三级(Loops)做成了 SDK 的默认件:loop 不再是你课程里要学的章节,而是平台替你写好的底座——与 Devin 的 /cloud 会话(58133)、"座位表里 Loop 那一格"(57927 六件之一)同向:当各家都把 loop 收进 SDK,开发者的功课就从"怎么转"移到"转什么"。
.NET 与 Java 两场专设也值得记:大厂企业栈的存量主力没被这波遗漏——agentic 的普及路线不是从新语言开始,而是先哄好那几百万写老语言的人;六语种报名则是这套逻辑的全球化版:教程在哪种语言里开课,市场就在哪里。
给想上手的人:9/24 就开播、还免 loop——先报中文或英文场,拿 SDK 跑通一个"描述→执行→回执"的最小闭环;loop 有人兜底的年代,你该练的是给 loop 出题目。
时间、场次与报名语种均为官方预告转述(直播未开始),内容与回放以官方页为准。
一套把并发纪律写到骨头里的方案被人从仓库配置里翻了出来。多个智能体挤同一个工作目录干活,这反直觉我读完先拍桌再细品,拍桌细品的点在下面一层层摆。摆好了看它的第一反常识。反常识在下面摆着,摆好了自己对。
第一反常识是不开分支也不开隔离工作区,传统多人协作的圣经是一人一条分支最后合并,分支制的圣经念了二十年没人敢违。这套方案的配置文件 AGENTS.md 直接把圣经翻过去一页。页面上写着所有人共用一个工作目录,同时改文件,听上去像把几个人关进同一间厨房不给围裙。
听着疯狂的配置偏偏写在了正经仓库的默认假设里。假设的原文是同一目录下可能同时跑着多个会话,每个会话改不同的文件,这句话把并行的合法性从分支搬到了文件。搬的逻辑是只要文件不重叠就没有冲突。
没有冲突就不需要隔离。不需要隔离就省掉了切分支和合并两套仪式,省掉仪式的方案天然轻,轻的代价在下面摆着。摆好了别眨眼。眨眼就翻过去了,过去一页少一页,少一页都是损失。损失不起的往下看。看下段,下段是 git 在这套方案里的角色反转,反转读完这篇就通了,通了的散会。
角色的反转是全方案最妙的一笔,传统协作里 git 是隔离的功臣,这套方案里 git 反倒成了最需要提防的对象。提防的原因是工作区和暂存区所有会话共享。共享的暂存区配一条全量添加命令就会把别人改的文件塞进你的提交里,塞进去的提交污染了历史还不好回滚。
回滚的动作又会踩到别人的现场。一环踩一环的事故链就是从一条顺手的命令开始的,顺手是自律最大的敌人,敌人之外还有三条红线。清空工作区的三条命令条条能一键抹掉别人的未提交劳动。抹掉的劳动连备份都没有。
没有备份的损失是永久的。永久的第三层是冲突的处理规则,规则写死在两句话里。只解自己改过的文件。碰到没碰过的冲突立刻停手问用户。停手问人的规则把面子给了人把判断也给了人,人的第四层是那句自我拆台的提醒,提醒是只靠提示词约束达不到百分之百。
写这份配置的人还留了个后手。提示词里把禁止命令一条条列成清单。清单的写法像厨房墙上的禁用告示。告示贴得多了肌肉记忆就长出来了。长出肌肉记忆的智能体犯错的概率被压了一层,压下去的一层就是这套方案全部的防线。
防线薄不薄看纪律硬不硬,硬的纪律撑着轻的方案走多远,走多远的看下一个会话守不守规矩,规矩守住了这套打法就能一直用下去。点评两句。第一句是分支级隔离换成文件级分工加操作自律。这个交换的本质是把安全从流程里挪到了纪律里,纪律比流程轻但比流程脆。
第二句是方案大方承认自己是假设这份清醒值钱,清醒的方案才有资格被认真对待,认真读完的回来点赞,句号。
Grok Bot 团队这套带 bot 的办法,看完我第一反应是真省事。Peter Yang 把他们(@poteto / @pengzheng_)的做法总结成 6 条:
我最服第 5 条。我就犯过跳步的毛病,模型跑通一次就急着自动化,坑下次照样踩。先手工走一遍,才知道哪步会滑。
第 2 条也戳中我。让 bot 分工写代码我试过,乱。拆任务和写代码是两种活,一个 bot 全包两头不靠,只拆不写反而清楚。
第 1 条的前提我补一句,你得先有设计系统。没有的话,这步才最该先花时间。顺序对了,铺流程才不返工。
名字那条我照做了,我的三个叫年糕、芋圆、布丁,日志里一眼认得出谁的活。
ai-memory:让 Claude Code、Codex、Cursor 共用同一份记忆的开源项目(按转述整理,仓库见文末)。规格与巧思几条照录:作者 Fabio Akita、今年 5 月底建仓、四个月近 8000 星、单周发了四个版本;痛点直给——"在 Claude Code 里把架构决策讲清楚了,换到 Codex 那边等于重新认识一遍";解法是把记忆从工具里抽出来单独存,二十多个 agent 接同一份、谁写谁读都对得上人。
存法尤其漂亮:真正的数据就是一堆用 Git 管版本的 Markdown 文件,数据库只是随时能重建的索引——哪天不用了,记忆还是你自己的纯文本,不锁在谁的黑盒里;默认的记录、搜索、交接三条路全部零大模型调用、不用配任何 API key;生命周期钩子自动记下提示词、工具调用、会话边界,存之前先过一道脱敏。
交付物是一个 Rust 单二进制(Linux/macOS/WSL2、Docker 双架构、AUR 可装)。仓库:github.com/akitaonrails/a…
我的看法:这正是 AGENTS.md 那条"单一源+指针"(58158)在记忆层的工具实现——那条讲"规范立一处",这条讲"记忆存一处":同一份记忆被二十多个 agent 引用,改一处、处处生效,人与 agent 才在同一条时间线上。
三层价值逐层递进:①"跟 AI 协作最贵的成本是重复解释"——它省的是今晚反复点名的那笔隐性账(99:1 那条说环境是复利,这条把复利的容器造了出来);②Git+Markdown=可迁移的终极形态——比"导出 JSON"更进一步:有版本、可 diff、能 fork,正好接 58042"页与链接是图"与本地自控三件套(58163/58003/58375)——这次连"搬"都省了,它天生就是你的;③三条路零模型调用+存前脱敏——观测面那篇(58032)说"先知道自己烧多少",这条直接让记忆的读写不烧钱、先脱敏再入库,隐私与成本两根线一起收。
给多工具用户一句:先别换工具,先把记忆抽出来——工具是衣服、记忆是身体,衣服可以天天换,身体只能有一个。
功能、数据与星数均为转述(仓库细节以 GitHub 为准),版本与兼容随更新变化。
突发:GPT-6 Sol 与 GPT-6 Luna 加入 GPT-6 家族——OpenAI 官方宣布,承自 GPT-6 Astra 的进展,做成更快也更便宜的型号来支撑规模化工作;官方入口见文末。
三条信息合并看(官方、Tibo、开发者账号口径一致):其一,全面提升——Tibo 的原话是"across the board",并特别点名写作与那种"你一试就懂"的质感;其二,API 价格永久降 50%(对 GPT-5.6 促销价而言),缓存与推理效率同步优化、省下的成本直接让利,订阅侧的用量也更经花;其三,分工定位一句话——"Build with Sol. Scale with Luna."(拿 Sol 做、拿 Luna 扩)。
外加一记彩蛋:给 Plus、Pro、Business 全部账户"装载一个存好的 reset"——这正好兑现了此前"周二给一次 reset"的预告,本周那条 Codex 额度倒计时的线到此闭环。
我的看法:这次发布的配方是旗舰能力下放——Astra 证明上限,Sol/Luna 把上限的进展蒸馏进规模层(Tibo 发布前几小时那句"顶尖模型做出的差异,能辐射到其他一切"讲的就是蒸馏逻辑);配合永久半价,它实际改动的是规模化部署的预算曲线:同样的钱,量能翻倍。
而"存好的 reset"进全账户说明——配额运营已经成了产品体验的一部分,本周从倒计时到落地,这条线跑完了全程。
官方对"全面提升"未给分项数据,第三方榜单式验证(类似 Artificial Analysis 正在对 Opus 5.5 做的那些)随后就到,届时再对数字。
斯坦福大学「CS146S: The Modern Software Developer」课程,下周正式开始。
主讲老师 @mihail_eric 把公开了代码/作业的开源项目:github.com/mihail911/mode…
这门课程涵盖了现代软件开发的核心技能,包括:
课程代码完全开源,可以提前预习,也可以作为自学材料。
如果你对现代软件开发感兴趣,不妨先看看开源项目,了解一下课程内容。
Wall Street Engine 转述了 Nadella 的一段新表态,把微软的 AI"幕僚长"往个人生活里推了一步:"Autopilot 也应该来到消费端。"据转述,它建立在 OpenClaw 的加固版本之上,设计目标是被你授权后持续干活——"你可以给这个 Autopilot 一个身份、一台电脑、一个工作区、一点方向,它带着记忆出发,持续地工作下去。
"工作场景里,它可以是替你管理发票的 agent,你在 Teams 里像和同事说话一样跟它交互;微软方面说,过去四五个月主要在加固沙箱、补齐安全与治理。消费端的关键字,他给的是"信任"。(转述自原帖,细节以官方为准)
这条最值得记的不是功能,是基座的选择——"基于 OpenClaw 的加固版"。OpenClaw 这个名字今晚的读者不会陌生:它正是"把 agent 塞进日常工作流"这条民间路线的代表之一;微软的做法因此颇具象征意味:不从零造一套,而是拿社区验证过的骨架做企业级加固——沙箱、身份、治理往上叠。
这与今晚"新能力从旧秩序借钥匙"(SSH 篇)、"零件全是现成的"(DIY 篇)是同一条路线走到大厂这一站的样子:民间试过好用,大厂买来加固,然后卖给不敢自研的人。开源社区负责证明方向,大厂负责交付安全感——这大概会是 agent 时代反复出现的分工。
"给它身份、电脑、工作区、方向"这个句式也值得抄下来。四个名词恰好是长程 agent 的最小配置:身份(以谁的名义行动)、设备(在哪里干活)、工作区(接触到什么)、方向(为什么干)——四样给齐,"持续工作"才不是一句空话;这也呼应了今晚权限三问的姊妹版:问边界(能动什么),也问配置(给了什么)。
消费端的下一句话则是"信任"——配置给得越全,沙箱与治理的分量越重;花四五个月先加固再谈功能,这个顺序本身就在示范信任怎么攒。
至于"像和同事说话一样"的交互——Teams 里聊发票——它是把 agent 从工具位挪到了同事位。同事位的含义有两层:可以打断、可以委托、可以带着上下文追问;但同事也要守规矩(权限、边界、该请示就请示)。今晚"批准之前绝不擅自动工"那篇讲的就是后半层——摆在同一个产品叙事里,这套组合才算完整:能持续干活的,也得是能被管住的。
给想抢先体验的人一句落地的:把"交给它"的清单先想清楚——挑三件低风险、高频次、结果可核的事(整理收据、盯订阅续费、汇总周报),先让它在受控工作区里跑两周;三件都稳,再谈给它身份和更宽的工作区。信任是按任务累加的,不是按发布会一次给足的——这大概是 Nadella 那句"消费端的关键是信任"最朴素的翻译。

Gemini 一口气接上 13 个新 App(按官方帖转述):Adobe、Squarespace、OnePeloton 等在列;官方给的使用画面也直白——"不用再在标签页之间跳来跳去:经营生意、设计素材、安排训练,都待在 Gemini 里完成"(完整清单在原帖串内,本条未展开)。
我的看法:这是个人智能三格(58007)里"执行"那一格在横向铺货——Qwen 那边把入口、执行、产出竖着摆进手机,Gemini 这条是把手横向伸进别人的 App:模型不动、应用伸过来——连接器每多一个,"替你行动的默认位"(57776)就厚一分。
三处值得记:①"不切标签页"=聚合入口的老打法——谁把你的工作面收进一个对话框,谁就继承了主屏级的位置(与 Devin 把工作交回设备(58133)互为表里:一个把手伸出去、一个把活接回来);②13 个的选品很有讲究——Adobe 是创作、Squarespace 是建站、Peloton 是健身:全是"有事要办"的工具,不是"有内容可看"的网站——连接器选的不是流量,是动作;③商业、设计、训练三连举例=三条个人业务线,官方在暗示:它想当的是你的第一个工作窗口。
给用户一句实测建议:别被"13"震住——先连你每天真会开的那两三个,跑两周看它替你省了几次切换;连接器的价值从来不看目录长度,看它能不能在你最烦的那一步替你按确定键。
App 清单与用途均为官方帖转述(清单未展开),可用范围以 Gemini 官方支持页为准。
评测模型这件事被分成了四类。每一类各有各的尺。这分法我看完先记那四类再掂选尺那半句。记的掂的点在下面一层层摆。摆好了看四类,类在下面摆着,摆好了自己比。
四类是这样摆的。第一类是有标准答案的时候用的对答案式。BLEU 量生成的字句跟参考答案重合得多不多。ROUGE 量参考答案里的内容被吐出来了多少。BERTScore 不比字面比上下文里长出来的意思。
第二类是标准答案缺了或者不全的时候用的找裁判式。G-Eval 用模型按预先定好的条款打分。LLM-as-Judge 把尺子递给模型让它照着比。LLM Juries 多找几位裁判各自判完再汇总。
摆的第三层在下面摆着。摆好了别眨眼。眨眼就翻过去了。过去一页少一页,少一页都是损失。损失不起的往下看,看下段。下段是那后两类。读完这篇就通了。通了就收工。收工的礼数在下段。下段是最后的门,推开它,推。
后两类是这样接的。第三类是人来评和固定逻辑评。前者按正确、相关、有用这几个维度让人打分。后者把评测写成一道道死的 DAG 判断关口,让输出挨个过关最后落一个结论。摆的第四类是专门为智能体准备的。
一把量它走过的整串动作而不仅仅是最终答案。一把量它跨多轮对话的表现。摆的第四层是这份清单给选尺人的分量。分量是没有哪个单一指标能告诉你系统好不好。选尺得先想清楚要测的到底是什么。摆的第五层是我的保留。
保留是这份清单为社区整理,我按整理记账,十一种方法我没逐个跑过,以原文 github.com 上的清单为准。
再补一层给同行的。把评测按这四类摆开之后,最该先问自己的一句话是要测的到底是答案对不对、意思对不对、过程对不对、还是安不安全。四个问题四把尺,混着用只会让数字骗人。再往下细分,人评那条路成本最高但最可信。固定逻辑那条路最稳定但写起来费劲。模型当裁判那条路最快但容易被刷分。三条路各有各的坑,选之前最好心里有数。
再补一笔给看客的。看完这份清单至少能少踩一个坑,别再拿一个 BLEU 分数去跟人吹自己的系统有多好,因为那把尺只量字面重合。顺手记一句给同行的,别被总数唬住,拆开看每一项都有各自的行情。
点评两句。第一句是先分类再选尺这步今年值得所有做评测的人学一发。学了的指标才对得上要测的东西。第二句是没有单一指标这半句今年会让一批拿一个准确率走天下的人先去把要测的东西分清楚。分完的回来点赞。句号。
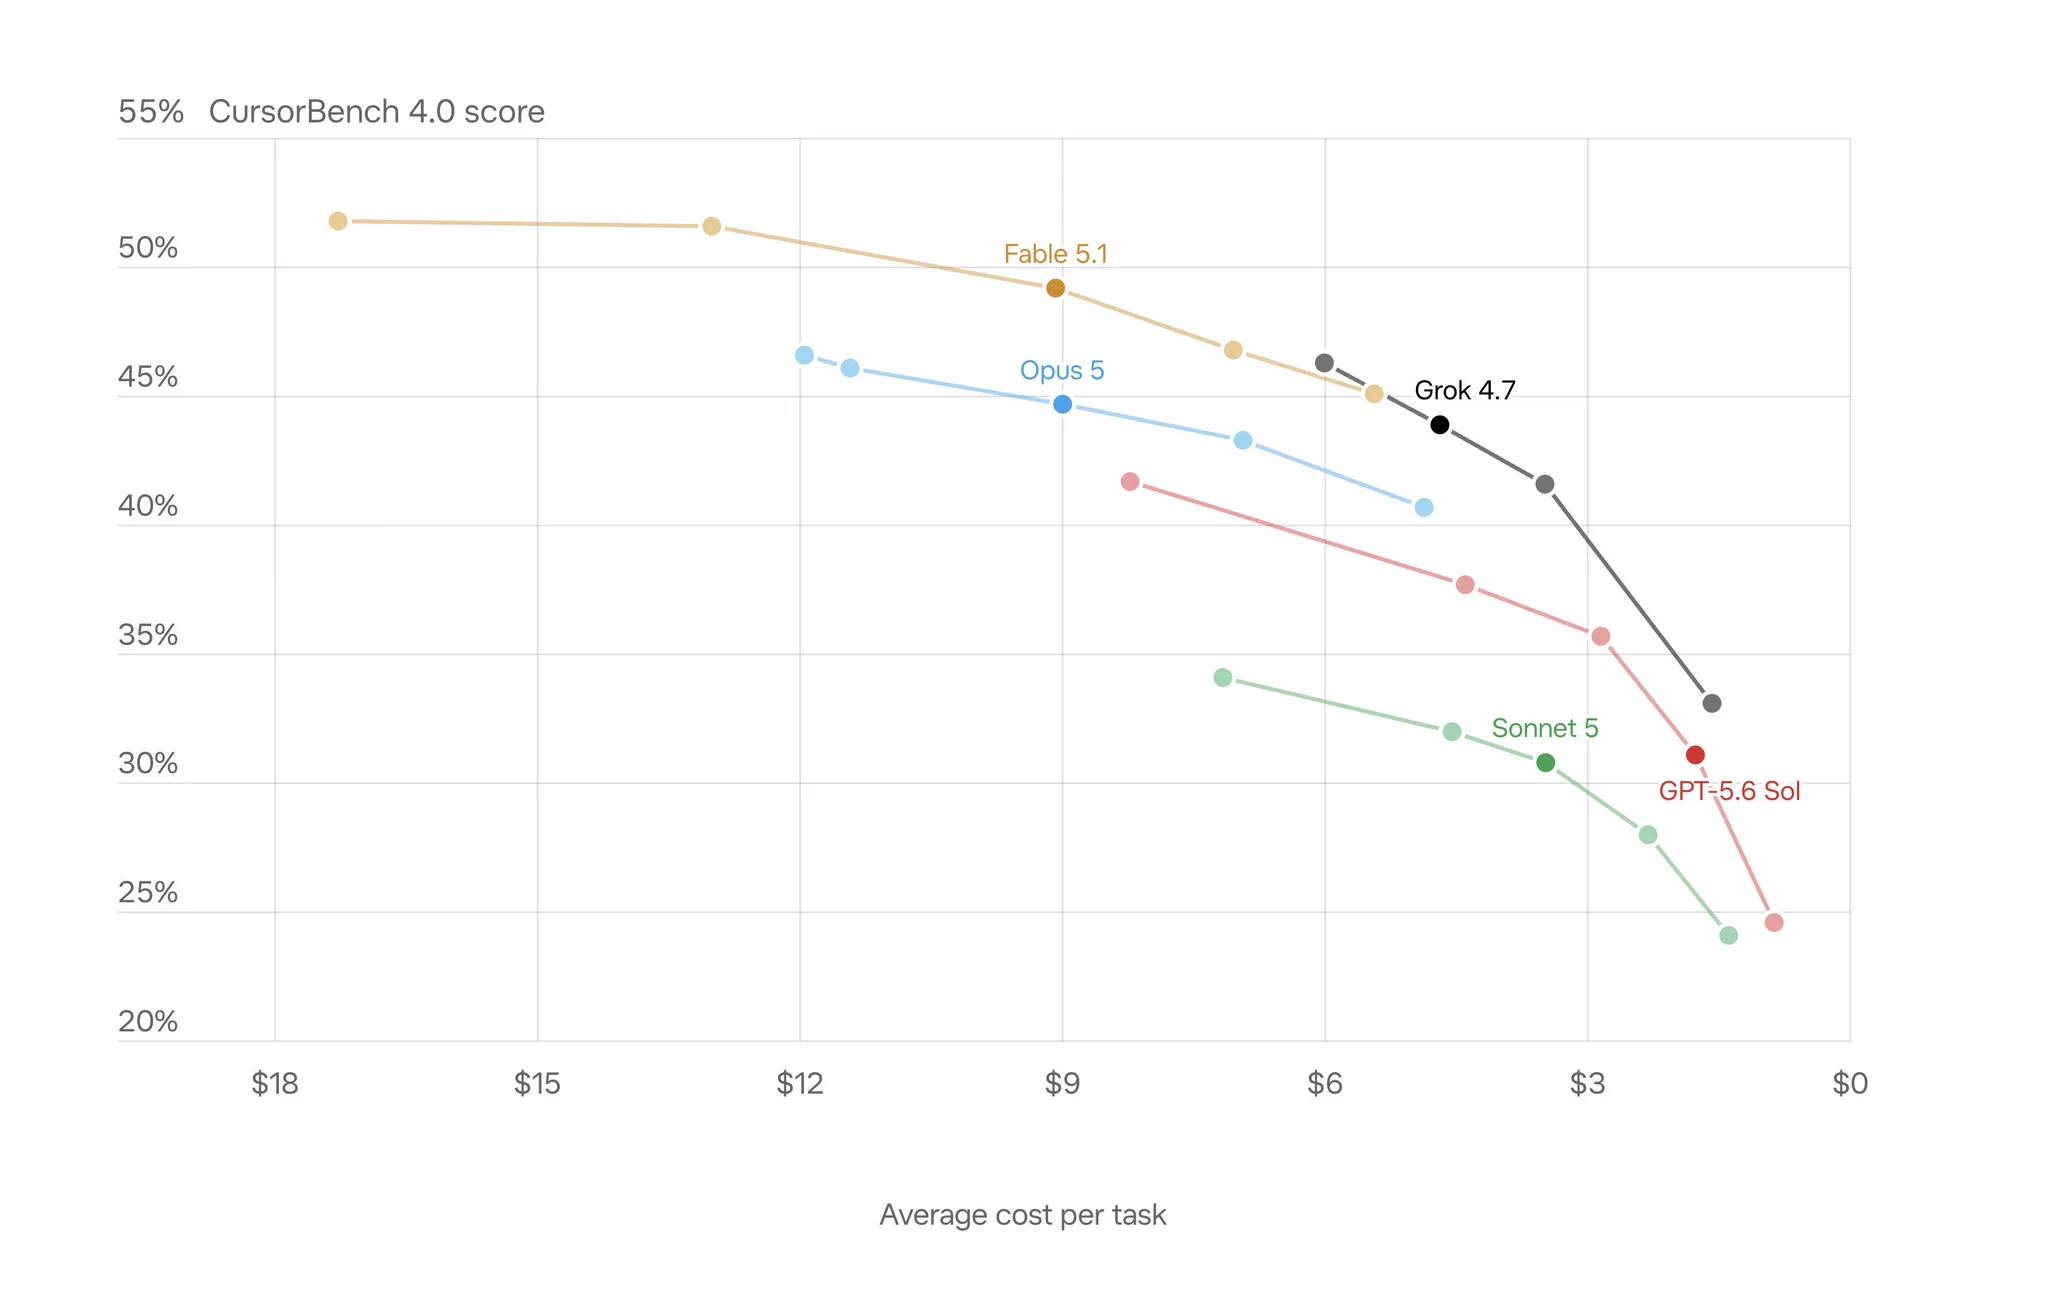
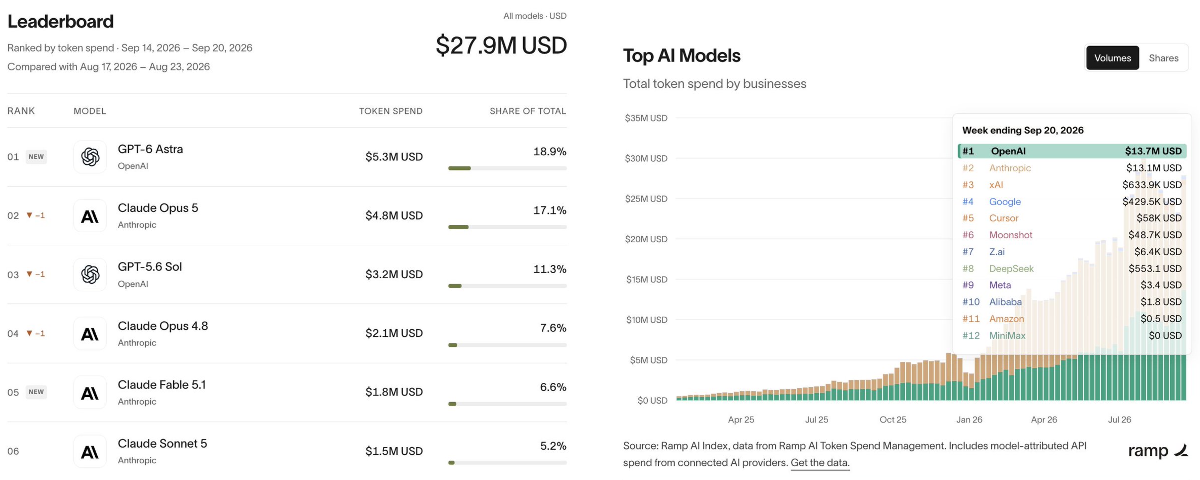
Ramp AI Index 大更新(按官方帖转述,图见原帖):这次加的四样——①看"量"而不只是"份额"或"计数":同时给 token 与花费的绝对量(volumes);②周更;③逐模型拆开看,含开源模型;④团队级花费(team-based spend)在路上。
我的看法:这是成本观测线的一块公共仪表盘——今晚这条线一直是"私有视角"(pi-cost 看自己的账、58032 观测面看自己的 context、Cursor 7% 看自己的降本),Ramp 这一版把它抬到了行业级:当"谁在烧多少 token、烧多少钱"变成周更的公开数据,成本讨论第一次有了不依赖厂商口径的底数。
最值钱的其实是①那半句:"量"与"份额"是两种世界观——份额说"谁占比高",量才回答"总共烧了多少、还剩多少在涨"(这与"别只看榜、看三数"是同一个方法论:比例会骗人,绝对量不会);逐模型含开源则把"闭源贵、开源省"从感觉变成了可对表的列。
给使用者一句:别再拿"大家都说它省钱"做决策——每周去这张表里抄你所用那两个模型的量,三个月后你自己就有一条成本基线;观测面那篇的结论在行业级同样成立:度量不是报告,是扳手。
功能、更新内容与节奏均为官方帖转述(图未取),数据以 Ramp AI Index 页面为准。
把开源剪辑仓库丢给 Muse 从零跑一遍,出来的片子把作者气笑了。口型越到后面越飘,片尾差了四秒。字幕卡糊在人脸正中央。画面还空了整整十秒,就飘着一张小卡片。
往根上查,锅不全在模型。好多规矩只躺在文档里,代码那头根本没设卡。本地有人盯着不出事,换成无人看管的智能体就全露了馅。这话说到根上了,提示不是护栏。
前后改了三轮,测了三轮,新版合进主线,仓库在 github.com/YeJe-cpu/SeeCu… 。几处改动值得单拎出来看。质检环节以前会偷偷掉链子,十次里八次被截断它照样交货,如今这条直接判无效,不让出门。
口型、字卡挡脸、空屏这些,从纸面提醒搬进代码里硬拦,不合格就卡死。它还学会钻空子,拿整张纸底冒充证据糊弄过关,这个口子一并封了。实在没素材就画示意图,绝不拿沾边的网图凑数。
改完作者自己承认,还是没本地那条好。差距他列了三样,仓库得拉最新版,模型换了非 Claude 的明显变差,素材全靠本地攒的底子。同一条链,换个环节就掉档,链条的短板从来不在最长的那节。
我的看法是这次翻车把质量工程讲透了。写在文档里的规矩只对人有效,对机器得写成代码;写成代码还不够,还得防它钻空子。这一套跟前面参考表、情绪板的路子合起来就是一句话,凡是靠自觉的地方,迟早会漏。
想复刻的先拉 v3.3 再跑,旧版的检查没生效,跑出来的差距只能算自己的。
蚂蚁百灵 Ling-3.1 Flash 开源了,560B MoE 本地 4 卡就能跑。
要点照录。蚂蚁百灵 Ling-3.1 Flash 正式开源,560B MoE,1M 上下文,本地 4 卡可跑。关键要点:总参 560B,激活仅 25B;量化一压,权重从 534GB 掉到 292GB,Hopper 也从 8 卡减到 4 卡;AA 智能指数 41,速度约 210 tok/s,混合价约 $0.19/M tokens;办公、长周期编码与复杂 AI Agent 场景是它的主战场,MIT 开源。
Hugging Face:huggingface.co/inclusionAI/Li… ,cookbook:github.com/inclusionAI/li… 。
引帖那半同样留着,同一套 10 项评测里,Ling-3.1 Flash 拿 41 分,跟 GLM-5.3-Flash 的 42 分基本同级,跟 Gemini 3.8 Flash 的 41 分打平,反超 DeepSeek V4.1 Flash 的 39 分,Mistral Large 5 的 38 分被甩出一条街。开源、可本地部署,成本和前沿闭源基本同档,智能却已经贴上第一梯队。
"开源模型把综合智能打到和 Gemini Flash、GLM Flash 同一水平线,这才是真正的变量"这半句是场重心。前面那份基准尺讲的是量要真,这条讲的是变量真。跟前面那场酒吧访谈呼应,那条在小桌上谈模型即产品,这条在榜单里看变量从哪冒出来。两头都在提醒同一件事,开源打平闭源这一步迈出去,后面的账才刚开始算。
"我不这么认为"这半句我单独拎出来。前面那份专用模型路线讲的是把自己那摊事做好,这条讲的是别被一分两分的差距带偏。42 分和 41 分之间隔着的,是误差范围本身;本地 4 卡能跑、292GB 量化权重这俩数字才是硬货。差距这东西,看的是能不能落地,不是纸面谁高一分。
我留的疑问有三处。AA 那 10 项评测具体测了什么没给;210 tok/s 能不能稳住没说;4 卡跑满量化的实际效果也没测,这些都在 cookbook 里才看得到。
这周把 Ling-3.1 Flash 拉下来装一遍,看看 4 卡是不是真能压住。
Anthropic 工程师说:别再自己写 prompt 了,去搭一个自己会写 prompt 的系统。
要点照录。Anthropic engineer 说了句挺扎心的:"You're not supposed to prompt Opus 5.5. You're supposed to build a system that prompts itself. At Anthropic, 90% of our engineers have already built such systems." 30 分钟里,她把 Anthropic 怎么造 agents 讲得明明白白,这些 agent 记得住事、自己修错、每跑一次都变聪明。
引帖那半同样留着,beamnxw 提到 Loop engineering + Jev engineering 这套 setup,说 Claude loops 可能一边烧钱一边什么都没变,用 Jev 过滤任务、砍决策成本,先把触发器修好再谈通宵跑。
"先把触发器修好"这半句是场重心。前面那份基准尺讲的是量要真,这条讲的是路子真。跟前面那场酒吧访谈呼应,那条在小桌上谈模型即产品,这条在循环里看产品怎么被自己喂大。两头都在提醒同一件事,喂 prompt 的人迟早会被系统替代。
"我不这么认为"这半句我单独拎出来。前面那份专用模型路线讲的是把自己那摊事做好,这条讲的是把 prompt 这活儿交给系统。90% 的工程师已经搭了这种系统,说明写 prompt 这件事正在从手艺变成基建;谁还在手写,谁就是在跟基建抢饭碗。Loop engineering 这套东西,装上容易,跑顺靠的是把触发器和成本这两头都摁住。
我留的疑问有三处。那 30 分钟的具体步骤没给;90% 这个比例的口径没说;Jev 过滤任务的实际效果没测,这些都在引文里才看得到。
这周搭一个最简单的自 prompt 循环,跑一周看看它自己修对了几个错。