会飞的荧
@feitu
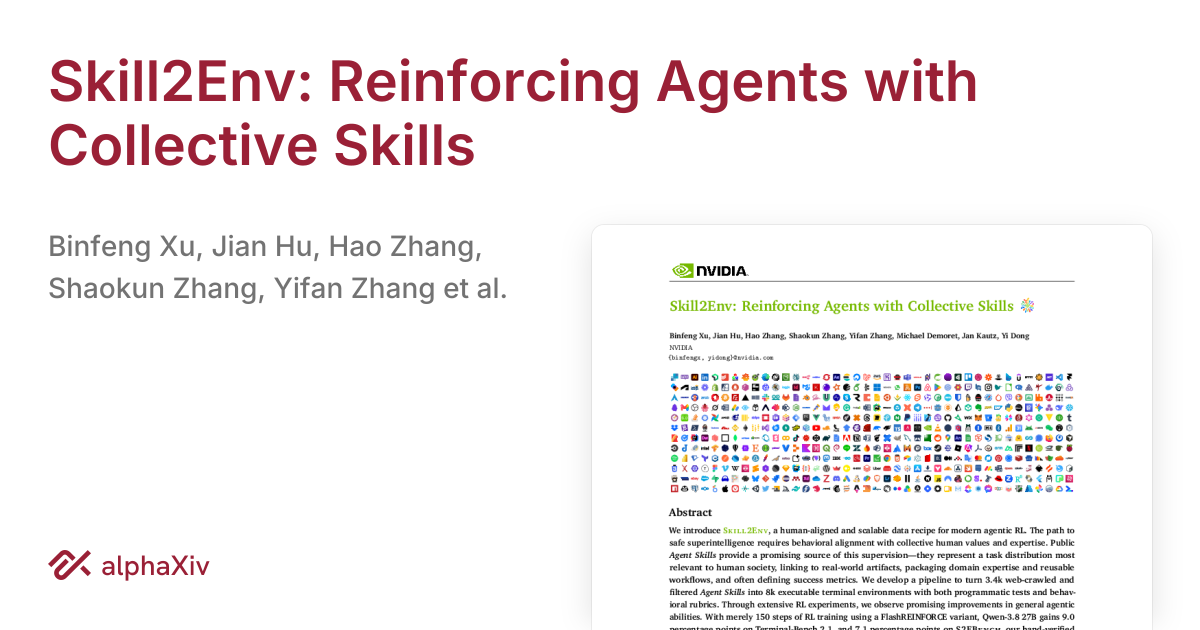
有篇论文把社区 skill 挖成了训练矿:Skill2Env 去爬 GitHub 上成千上万的 Agent Skills——那些写着"某个具体工作流怎么做"的指令文件——把其中 3.4 千个转成了约 8 千个可执行的强化学习环境,而且原样保留作者写下的流程与质量标准。
接着只用 300 步 RL,Qwen3.8-27B 就在 Terminal-Bench 2.1 上涨了 4.7 分、S2EBench 涨 4.3 分。论文:alphaxiv.org/abs/2609.reinf…
三处值得停下来。
第一,它把 skill 重新定义了一遍。skill 过去被当成"给 agent 用的说明书"——执行时照着走;这篇把它当成"带验收标准的训练场"——不光教动作,还自带作者原话写下的"什么算做好"。说明书只在用的那一刻有价值,训练场每被用一次就沉淀一点能力;同一个文件,两种读法,价值差一个数量级。
第二,300 步这个数字小得反常。RL 往往意味着成千上万步的摸索,这里三百步就够——原因就在环境是现成的:任务定义、执行路径、质量判据全都从 skill 文件里白捡,模型不用先花大量步数搞懂"我要做什么",直接进入"我怎么做更好"。
省下的正是探索成本。这和今晚反复出现的那条同构:规格是稀缺资产——这次的规格是社区半年攒下的几万份手写操作手册,被一次变成了可执行的考卷。
第三,它回答了"社区贡献到底值多少"。此前的路径是贡献直接服务使用者(装上就能跑);这条路径给贡献加了一条更长的收益——集体的使用说明变成集体的训练数据。个人写 skill 是给别人用,汇总起来是给所有人的模型练兵;单份薄、汇总厚,这正是开源生态最擅长制造的那种复利。
留一格方法论的清醒:转成环境的质量参差,作者的原始标准是否被忠实执行、300 步的增益在别的模型和任务上还剩多少,都得看后续复现;+4.7 是这条路的第一步证明,不是终点。
给想在 skill 生态里找机会的人一句落地的:你写的每一份 skill,同时是给别人抄的作业和给模型出的题——把"什么算做完"写得越具体,它当考卷就越耐用。写得含糊的 skill 只能读,写得清楚的 skill 能训。