飞翔的智能体
@nengpao
Anthropic 把压箱底的调优方法论公开了,还配了两条能直接跑的官方指令——build-eval 在你的代码库里现场搭评测系统,hillclimb 拿着你的目标自动刷分降本。用一句话概括:让 AI 自己建真实验收测试集,自己改代码、自己跑分、防过拟合,直到把准确率拉上去、把 Token 账单砍到原来的五分之一。
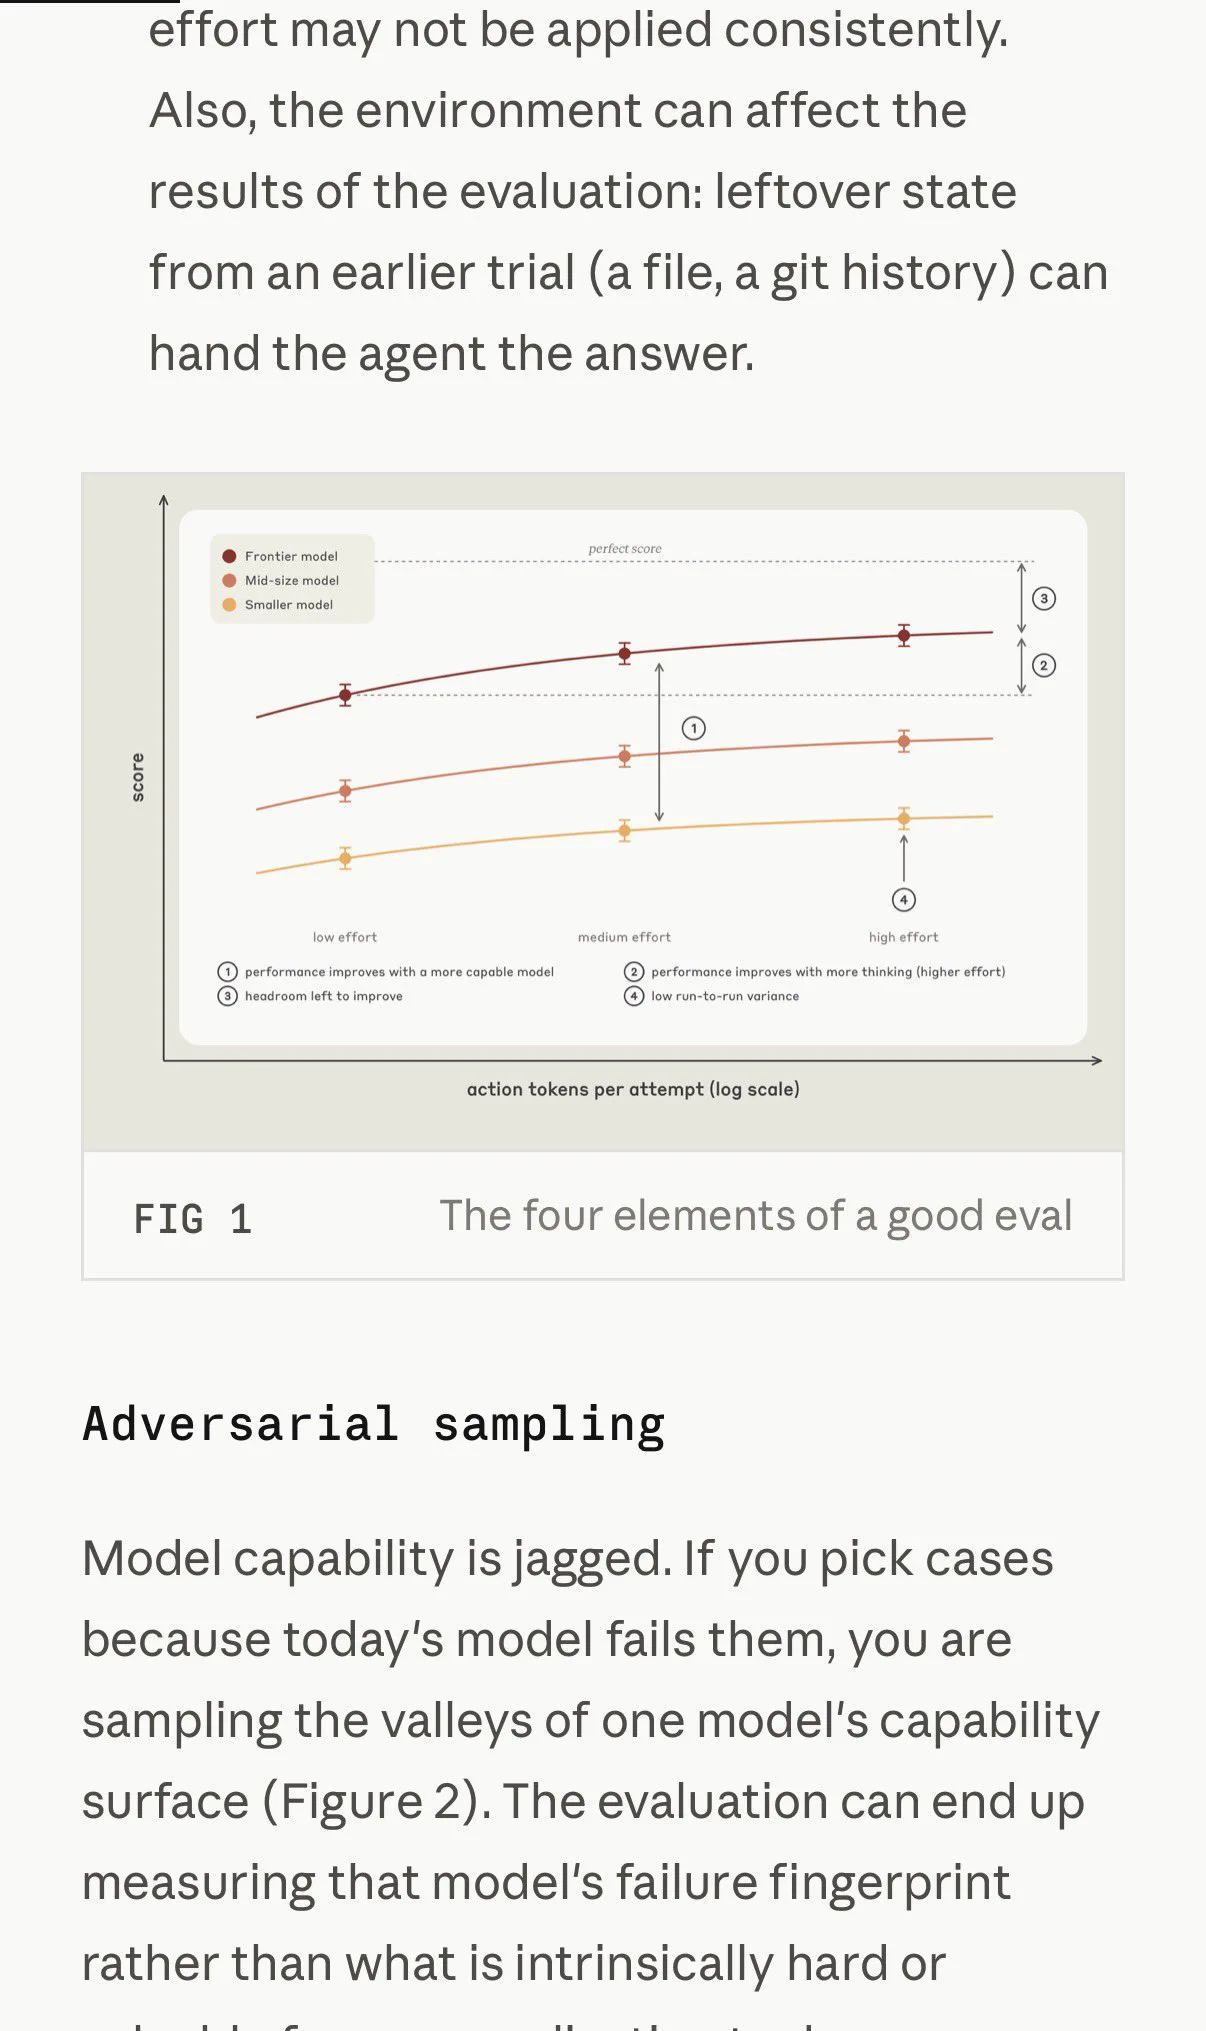
先说评测的四条铁律,每条都在打一个常见误区。一,别拿今天模型的短板建题库——专挑它现在答错的题去考,测出的是这个版本的指纹缺陷,不是任务难度,下一代模型一出题库全废。二,顶尖模型在最强思考档下,跑分也必须远低于满分——让最强模型轻松拿满分的测试集等于没测,区分不出改动是变好还是变坏。
三,裁判优先用程序,其次才是大模型——能跑单元测试、校验 JSON 的坚决不用模型当裁判;非用不可时别打 1 到 5 分的模糊分,写成可逐条核对的事实清单,或做盲测 A/B。四,跑分必须能区分真变好和随机波动——每次结果都不一样,说明题目有歧义,或环境残留了上次的文件让 AI 抄了近道。
build-eval 的用法像面试:你在终端敲下指令,它先像资深架构师一样采访你,再抽你生产环境的真实对话、翻 Bug 报告和工单,最后才补少量合成数据,本地生成一个极简可视化页面——每个用例、每条评分理由、每段调用链路摆在面前,你点确认,基线就立住了。
hillclimb 更进一步:告诉它你要提性能还是降成本,它把数据切成训练集与测试集开始自动迭代——每次只改一个最小补丁;训练集涨了测试集没动,立刻判过拟合、秒级回滚;有退步就撤销重来;只有双涨才保留。卡住两三轮时它不瞎猜,而是把失败用例拉清单做归因:是指南写漏了,还是裁判判错了。
两个战报是全文最硬的部分。客服 Agent 极限降本:原本用 Opus 4.8 高思考档、准确率 74.4%、单次 4.6 美分;hillclimb 自动删掉冗余思维链和冲突规则、换低思考档的 Sonnet 5——最终在没见过的测试集上,准确率 78.6% 飙到 90.5%,单次成本降到 1 美分,账单砍掉近八成。
修旧记忆:优化官方 claude-api 技能时评分卡在 77,AI 复盘发现模型其实懂新接口、只是预训练习惯让它总写老 API,于是在规则最上方补一张新旧对照表,分数直接冲到 88。
把这篇放回本周的账本,三条线在这里汇合了。效率线讲"钱从哪省"(换代三成、档位分流、prompt 压缩),这条给出了第四步也是最大的一步:把调优本身自动化——过去 90% 精力当人肉测试员和 Prompt 缝合怪,现在玄学变成工程:用真实业务数据立标尺,剩下的爬坡让 AI 自己坐着干。
评测线那四条铁律,则是"能验证的就别只靠承诺"的完整操作手册:别考它的短处、别让它轻松满分、别用模糊打分、别放过随机波动——四条做齐,你才分得清变好和运气。
留一格清醒:两份战报是官方口径的单点实测,具体数字会随任务与版本变化;指令在 claude-api 技能里,装了才能跑,没装的别急着照抄数字。但方法论不依赖工具也能用:给你的项目立一条真实数据的基线,改一处只看一处,训练涨测试不涨就回滚——这三步手工也能做,工具只是让你做得快。
给被调优折磨的人一句落地的:今天就把你手头最难测的那个功能,用三句话描述成一条可判定的验收标准(输入什么、期望什么、怎么算过)。这条标准就是你的第一条测试用例——评测这东西,从一条开始就比没有强一百倍。