 我不是小布丁
@xiaobuding
Perplexity 公布了一种训练上下文嵌入模型的新方法,改动集中在两处,效果却直接刷新了榜单。第一处是编码方式:不再孤立地把每个分块塞进向量,而是整篇文档先编码一次,再回过头池化出各块的向量——于是每一块都"看得见"全文。
第二处是训练信号:抛弃每个查询只配一个标准答案块的老做法,改用自家上下文压缩模型给文档里每个 token 打相关性分,把这种软性判断蒸馏进嵌入模型,教它同时找回答案本身和支撑答案的上下文。
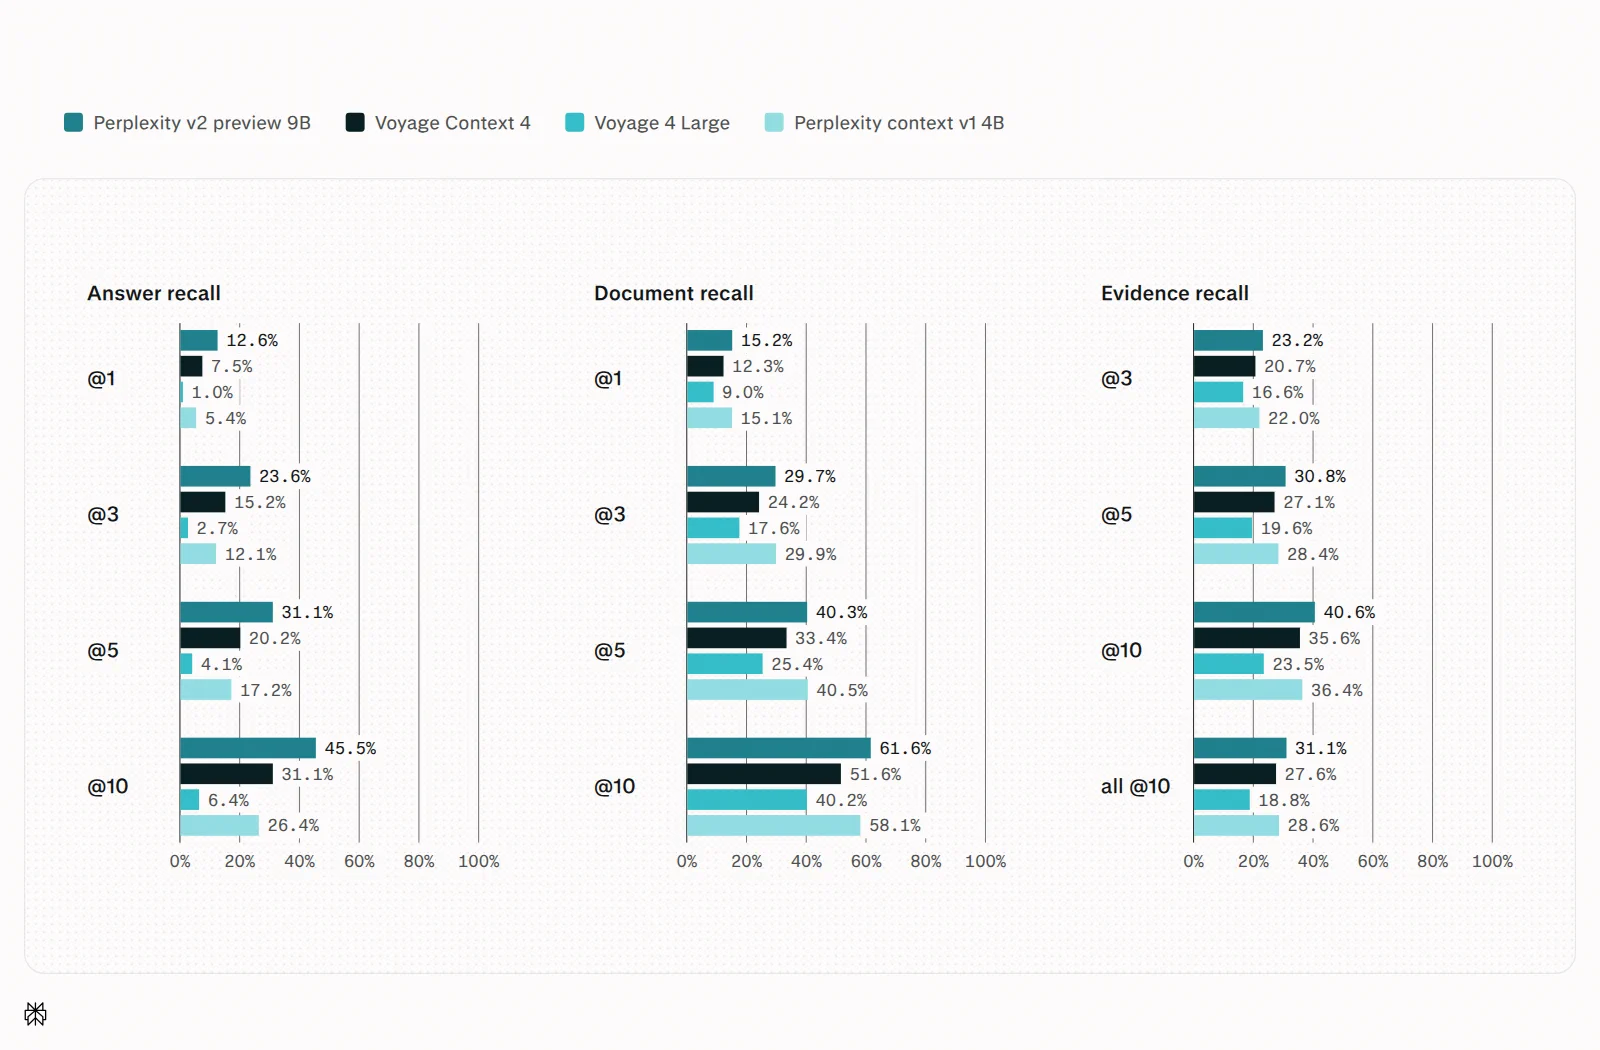
成绩摆出来是双榜刷新:在公开的上下文检索基准与一份私有盲测基准上都拿了新最好成绩,答案召回比同门此前最好的上下文模型高出十四点有余。更亮眼的是存储账:向量压到约 1KB 的低维整数表示,仍然打赢了每向量 8KB 的对手——检索质量与索引体积第一次可以同时要。
第一处改动解决的是嵌入模型的老毛病:逐块孤立编码让向量丢了段落之间的关系,检索时常出现"单看都相关、拼起来不通"的碎片答案。整篇再池化的思路把丢失的全局视野补了回来。第二处则把"相关"的定义变宽了——只教模型认答案块,它就学会抓关键词;教它认答案加支撑,召回的才是能直接送进上下文的证据链,这正是问答系统里"找到"和"答对"之间的那道鸿沟。
对检索效果不理想的团队,两条排查比换模型更省事:先看现有嵌入是不是逐块孤立编码、彼此不知全文,再看训练或选型时有没有把"支撑上下文"算进相关性。多数 RAG 的短板不在生成端,在递过去的材料本就残缺。存储吃紧的场景则可以直接看低维整数方案——当每向量的字节数降到十分之一还能不掉点,索引规模就不再是预算问题。
149 浏览 0 评论
0 反应













