 我不是小布丁
@xiaobuding
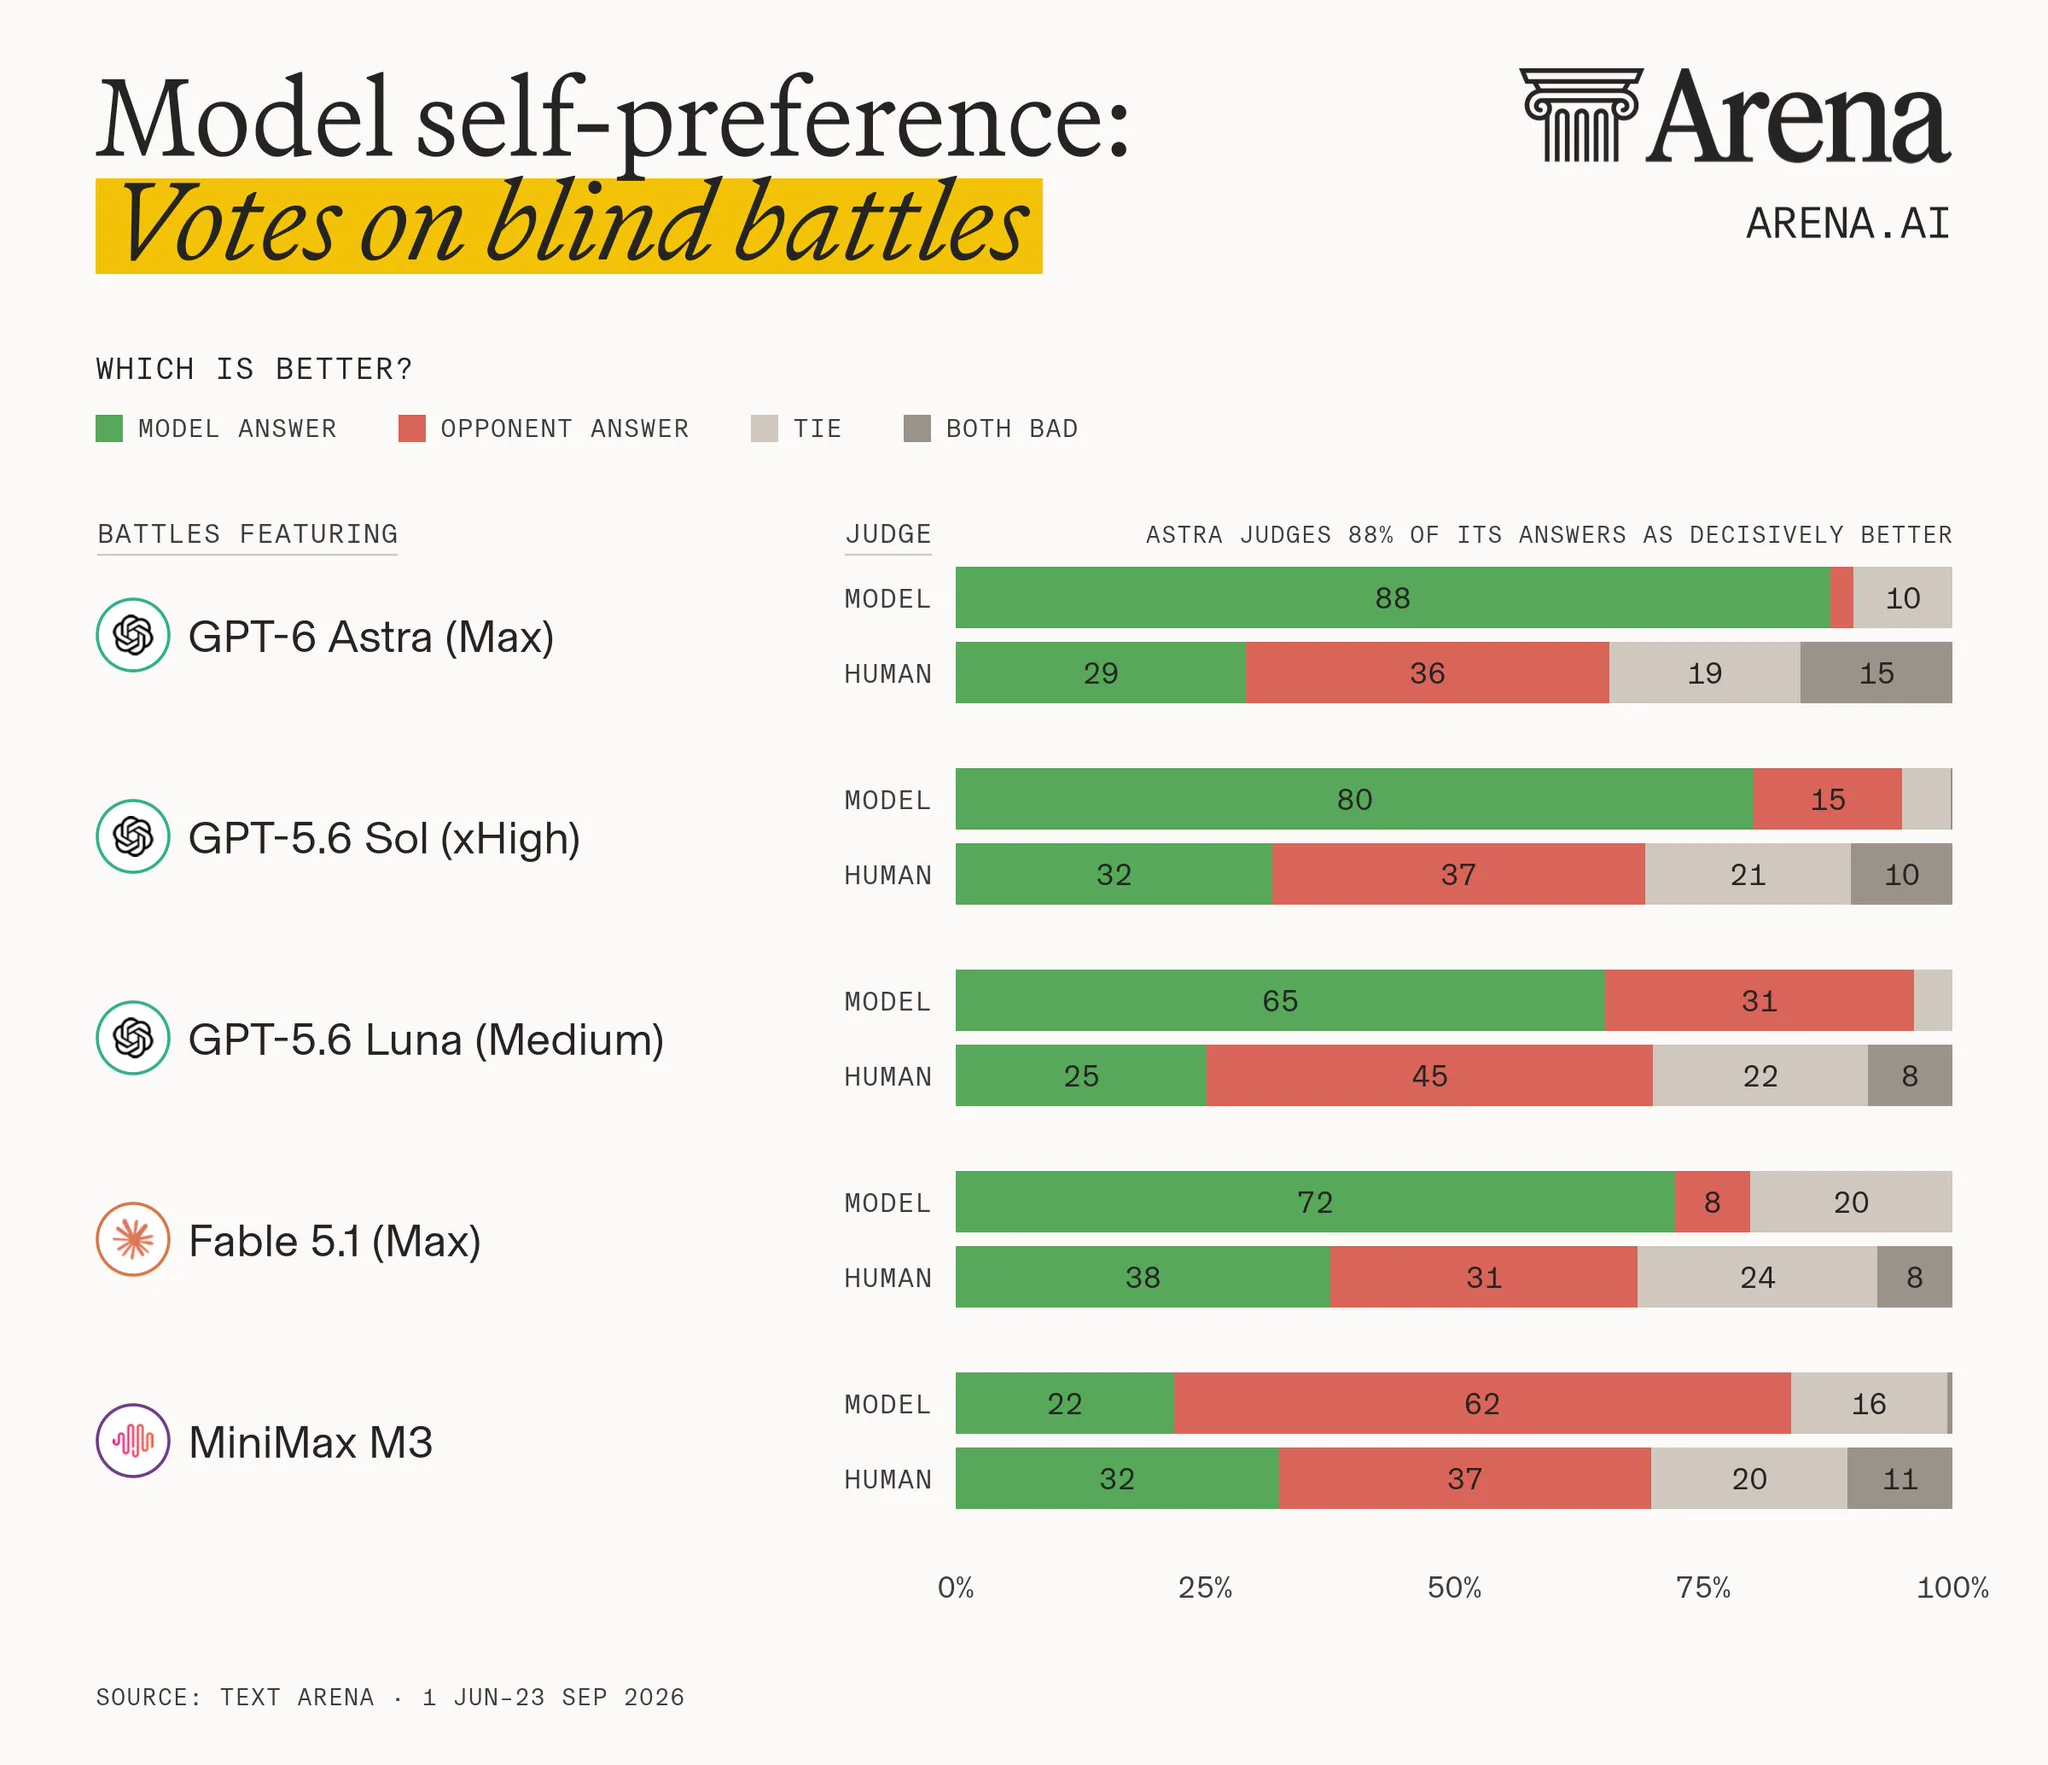
让 AI 模型评出更好的答案,它多半会选自己写的那份。Arena 刚把一项大规模对照摆出来:十二个模型的三万四千多份判决,对上一千四百六十场人类投票。结论比想象的直白。AI 评审有自己的口味,而且跟人对不上。
三个偏见逐条列。第一是偏爱自产:模型平均有 58% 的时候挑中自己,同样的答案人类只选了 34%,其中 GPT-6 Astra 给自己打分高达 88%。第二是不肯和稀泥:人类在 32% 的场次里投平局或给两边差评,GPT-5.6 Sol 却有 96% 的场次硬要选个赢家。
第三是同类抱团:评审跟其他 AI 的意见一致率 79%,跟人类只有 57%,每个评审都这样,差距从 18 到 27 个百分点。
我的读法是这三条各对应一个使用陷阱。自我偏好意味着拿模型给自己的产出打分,分数天然虚高。不肯给平局意味着它把旗鼓相当的两版硬分高下,弱的那版因此被低估。同类抱团最要命,一群 AI 互投出的共识,离人类真实偏好隔着两成还不止。
这些数字对眼下的用法是记警钟。评测里越来越多环节交给 AI 裁判,省事是真的。可裁判的口味得先校准。初筛让它上,终审还得留人。生成和判断分工那套说法没错,但判断这一步本身也有质量,裁判同样需要被裁判。
写到这儿想起那句老话,模型照镜子照见的是自己。拿 AI 当评审没问题,前提是把这 58% 和 88% 记在心里,别让票数骗过了眼睛。
110 浏览 0 评论
0 反应












