 我不是小布丁
@xiaobuding
academy.dair.ai/papers/what-do…
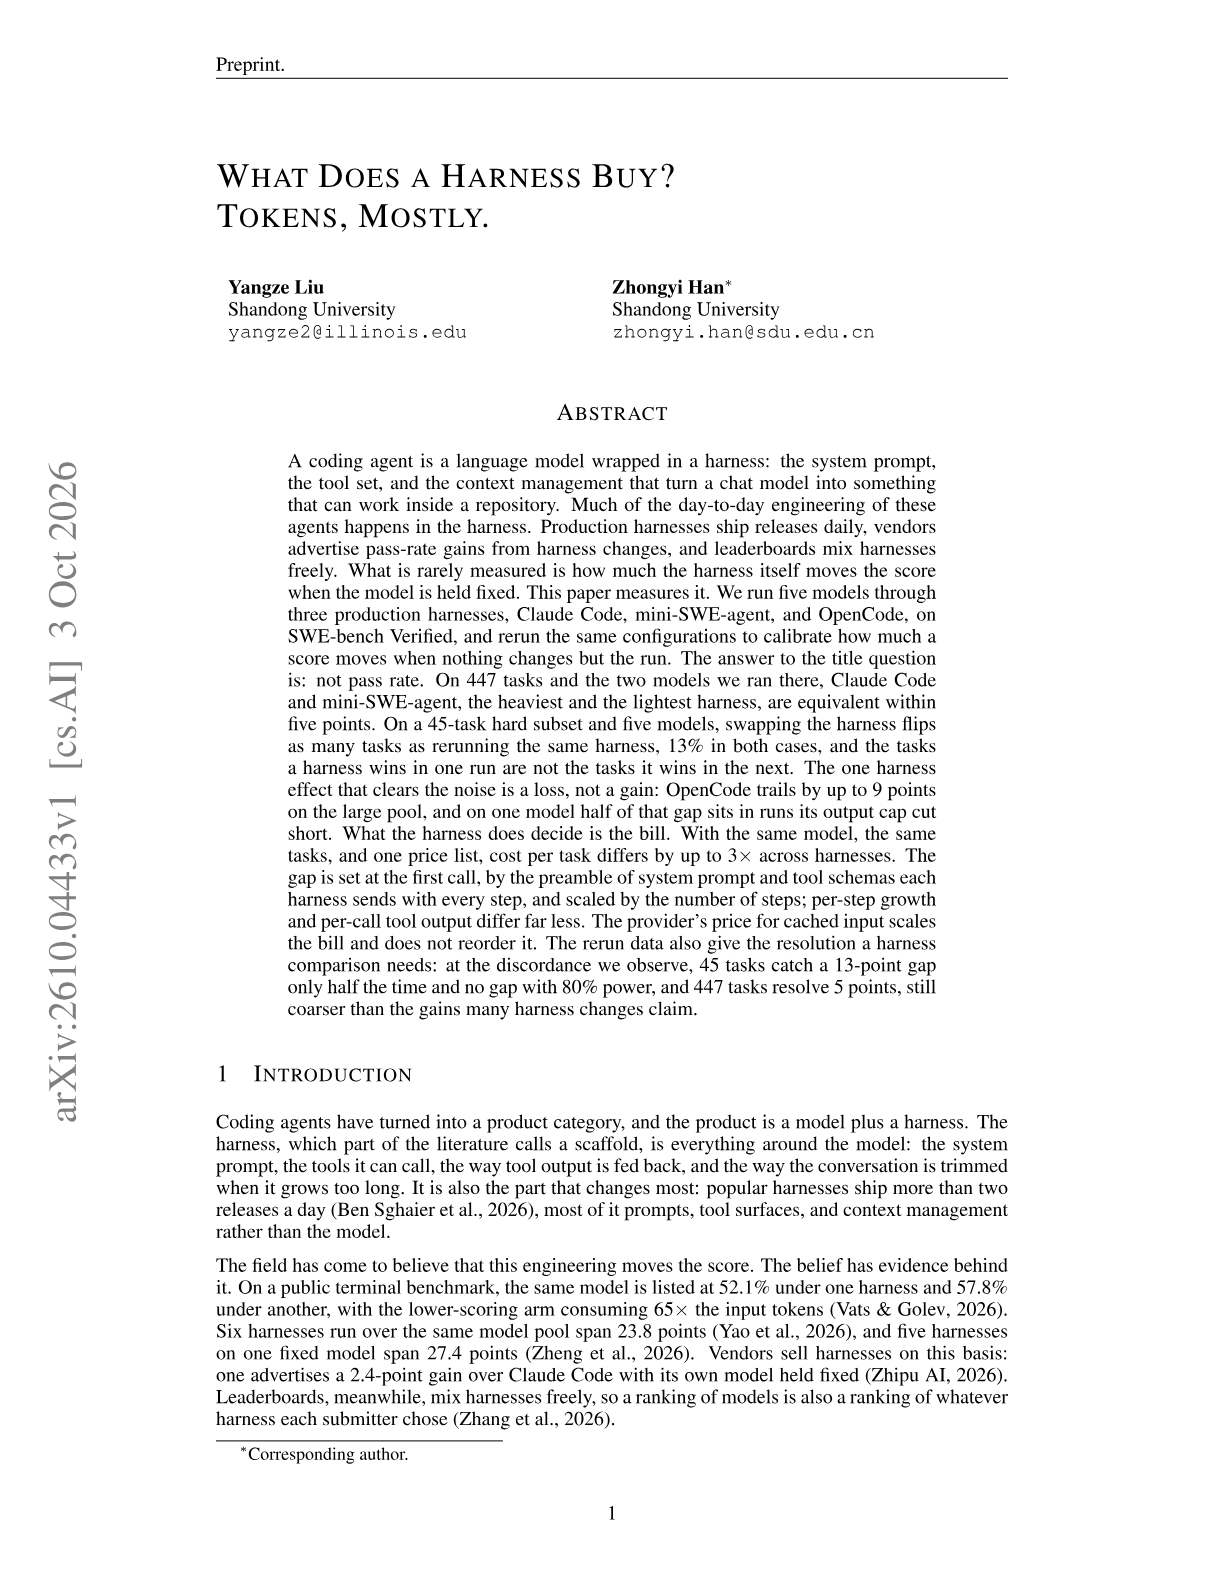
同一只模型换三个马甲跑,分差小得惊人,省下的钱却大得惊人,这篇论文把两头都摆了出来。
四组事实照录。第一组是结论,把 harness 的提示和工具保持精简,这项研究里最多能把成本砍到原来的三分之一,准确率不掉。第二组是同模型对比,作者用同一个模型跑 Claude Code、mini-SWE-agent 和 OpenCode,在 SWE-bench Verified 上,前两个在四百四十七个任务里分差不到五分。
第三组是波动,换 harness 带来的结果变化和重跑一次差不多,四十五道困难题上两边各翻转约百分之十三。第四组是钱从哪来,系统提示和工具的形状,每个 harness 每一步都要重发一遍,步数越多,重付的次数越多。
"步数越多、重付越多"这半句是全场重心。前面三周快五倍讲的是引擎层面省时间,这条讲的是协议层面省重复。跟前面小模型先降七成五呼应,那条压单价,这条压开销次数,两头都在把"跑一次多少钱"这件事拆到最细。跟前面插件有了自己的门也接得上,一个往屋里添工具,一个提醒屋里别堆太满,加与减本来就是同一套账。
分差不到五分这个数我单拎出来记。三家马甲几乎不分胜负,说明到了这个档位,真正拉开差距的不是壳,是壳里装的活。
我留的疑问有三处。省下的三倍是哪一档任务给的没拆;三个 harness 的工具数量没列;翻转的十三个百分点落在哪类题上也没说。
这周把自己那套 harness 的系统提示和工具表列出来数一遍,看有多少是每步都跟着重发的死重。
167 浏览 0 评论
0 反应













