一、GLM-5.3-FlashX是什么?产品定位与关键信息
GLM-5.3-FlashX定位:智能、价格、速度三位一体的高速推理层 智谱2026年9月18日宣布GLM-5.3-FlashX上线,API同步开放,Model Key为“GLM-5.3-FlashX”。它面向企业、开发者、SaaS、客服系统、代码助手和Agent平台,解决“基础Flash很聪明但不够快、旗舰很准但太贵”的折中问题。
GLM-5.3-FlashX 是智谱/BigModel 在 2026-09-18 新上的高速推理API,定位“智能+价格+速度”三位一体,最高 200 tokens/s、相较 GLM-5.3-Flash 提速约5倍、定价约2.5倍;基础版 GLM-5.3-Flash 的公开数据可用来做参照(AA智能指数约57、320B/18B MoE、1M上下文、原生多模态等)。
GLM-5.3-FlashX核心功能快览
GLM-5.3-FlashX是智谱BigModel推出的提速版对话模型,Model Key为GLM-5.3-FlashX,最高200 tokens/s,较GLM-5.3-Flash快约5倍;延续该系列长上下文、原生多模态与MoE能力,适用于客服、代码、文档、Agent等高并发场景,支持API按量调用。
产品关键信息列表
- 出品方:智谱AI / BigModel(Z.ai生态)
- 模型标识:GLM-5.3-FlashX
- 最高输出速度:200 tokens/s(官方口径)
- 相对提速:相较GLM-5.3-Flash约5倍
- 定价策略:相较GLM-5.3-Flash约2.5倍,具体以BigModel账单为准
- 能力继承(参照同系列Flash):原生多模态、长上下文、MoE架构、代码/Agent/文档处理
- 交付形态:BigModel API、Z.ai API/文档、可接入ZCode/AutoClaw等智谱工具链
- 算力背景:智谱披露由国产芯片推理集群承接,前期GLM-5.3-Flash anonymously“牛来/Ox-Alpha”在OpenRouter、OpenCode测试,十万张国产卡集群满负荷
量化参照(用同系列GLM-5.3-Flash公开数据做代理评估)
- 参数结构:320B总参数、18B激活的MoE(基础Flash公开信息)
- 上下文:官方基础Flash材料强调1M超长上下文、IndexPool降低注意力计算、KV Cache压缩
- 智能指数:Artificial Analysis Intelligence约57分,媒体/行业汇总将其与Claude Opus 4.8持平、高于DeepSeek V4 Flash约52分、Qwen3.8-Flash约56分(不同榜单口径以AA官网为准)
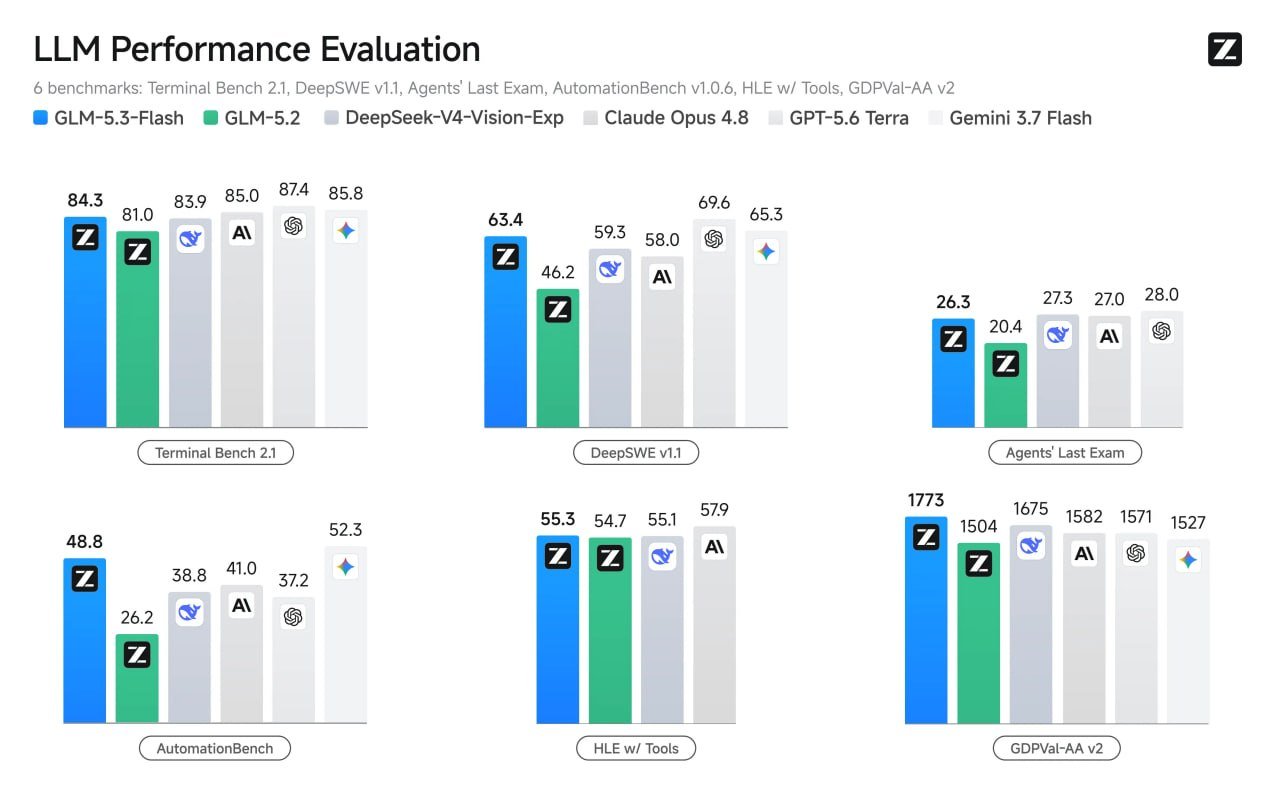
- 第三方实测:腾讯新闻转载实测称GLM-5.3-Flash在14项benchmark对DeepSeek-V4赢11项,视觉6项全赢,AutomationBench、GDPval等Agent/办公任务领先
专家观点:摩根士丹利在国产Flash调价报道中指出,“高价旗舰+低价快速”的Pro/Flash双轨正成为大模型厂商标准打法,Flash层竞争核心从单纯低价转向速度、吞吐与生态。
二、GLM-5.3-FlashX主要功能和特点(详细)
- 高速生成:最高200 tokens/s 适合打字机式对话、实时客服、流式Agent、批量摘要。对“用户等首句”的场景,速度比绝对智能分更影响体验。
- 低延迟高并发:面向生产调用 官方将其定义为承接高并发商用需求;若你的系统QPS高、单次回答中长,用FlashX可比基础Flash减少排队和流式等待。
- 多模态与长文档(参照Flash系列能力) 基础GLM-5.3-Flash为GLM-5系列首个原生多模态模型,可处理图片、文档、视频字幕、设计稿等;FlashX作为提速版,适合做“看图改PPT、读PDF出报告、视频转纪要”等流水线。 案例:上传产品图+竞品表,让模型输出电商详情文案和配图建议;上传90页研报,让其按章节抽取观点并生成投资要点。
- 代码与ZCode生态 智谱把GLM-5.3-Flash/FashX接入ZCode、GLM Coding Plan;可做代码生成、Bug定位、单测、前端页面原型。官方Coding Plan曾做夜间免费活动(2026年9月3—20日23:00—次日9:00,ZCode走GLM-5.3-Flash额度0消耗),FlashX更适合白天高优、低延迟编码。
- Agent与工具调用 支持对话补全API,可接函数调用/工具路由。社区对基础Flash的工具调用稳定性有不同反馈,生产Agent建议做超时、重试、工具schema校验。
- 成本可预期、按量弹性 基础Flash行业报道口径为非缓存输入0.4元/百万tok、输出1.4元/百万tok;FlashX官方仅确认约2.5倍,按此估算输入约1.0元、输出约3.5元/百万tok,但是以BigModel控制台最终单价为准。高速度换高单价,适合“人力时间成本>模型token成本”的任务。
三、如何使用GLM-5.3-FlashX?(详细操作指南)
- 选入口
- API开发者:BigModel开放平台 → 控制台建Key → 调对话补全,Model填GLM-5.3-FlashX
- 智谱/Z.ai生态:Z.ai API文档、Z.ai Chat试用模型列表;企业可走BigModel商务套餐
- 编程场景:ZCode、GLM Coding Plan;办公自动化:AutoClaw
- 普通体验:若网页版未单独放FlashX,先用Z.ai Chat或智谱清言试用同系列能力,再用API做压测
- 注册与建Key(BigModel示例) 1)打开BigModel官网并注册/登录 2)进入“API Keys/密钥管理”,新建Key 3)在“模型列表”确认GLM-5.3-FlashX可用、查看单价与配额 4)保存Key到环境变量,勿硬编码到前端
- 最小API调用示例(伪代码/通用) POST 对话补全地址(以BigModel文档为准:https://docs.bigmodel.cn/api-reference/模型-api/对话补全 ) Header:Authorization: Bearer 你的KEY,Content-Type: application/json Body示例: { “model”:”GLM-5.3-FlashX”, “messages”:[ {“role”:”system”,”content”:”你是高效客服助手,回答简练可引用工单。”}, {“role”:”user”,”content”:”用户说订单未发货,给出处理话术与查询步骤。”} ], “stream”:true, “temperature”:0.3, “max_tokens”:2048 } 返回按SSE流式解析,前端按tokens/s做进度展示。
- Python快速起步
- 安装requests/httpx
- 封装函数:传入api_key、model=”GLM-5.3-FlashX”、messages、stream=True
- 生产建议:加限流(RPM/TPM)、失败退避、日志埋点统计实际tok/s与首字延迟
- Agent场景:把模型输出改为“思考+工具调用JSON”,中间层执行搜索/查库/写表,再回传结果。
- 评估上线前必做
- 用真实业务100条样本测准确率、拒答率、幻觉率
- 记录P50/P95首字延迟、整体tok/s、单条成本
- 与基础Flash、DeepSeek、Qwen同跑,选“速度×成本×质量”最优档
四、官方地址与网页版/客户端获取方式
- 官方与文档
- BigModel对话补全API文档:https://docs.bigmodel.cn/api-reference/模型-api/对话补全
- BigModel模型指南(GLM-5.3-Flash参照):https://docs.bigmodel.cn/cn/guide/models/vlm/glm-5.3-flash
- Z.ai API/指南:https://docs.z.ai/guides/vlm/glm-5.3-flash
- 智谱/GLM博客:https://z.ai/blog/glm-5.3-flash
- 开源权重(基础Flash):https://huggingface.co/zai-org/GLM-5.3-Flash
- 在线体验
- Z.ai Chat网页版:https://chat.z.ai
- 智谱清言/智言App与网页:https://chatglm.cn
- GLM Coding Plan:https://bigmodel.cn/glm-coding
- ZCode代码助手:https://zcode.z.ai/cn
- AutoClaw办公自动化:https://autoclaw.zhipuai.cn
- 桌面/插件/App说明 目前检索到的主入口是网页对话、API和智谱工具(ZCode/AutoClaw);未确认GLM-5.3-FlashX有独立Windows/Mac安装包或浏览器插件。开发者用API可接入任意系统;移动端可走智谱清言App体验同生态模型,FlashX以控制台模型列表为准。
五、GLM-5.3-FlashX vs 同类型竞品对比
说明:FlashX于2026-09-18刚发布,独立第三方完整基准可能滞后;下表智能分用同系列GLM-5.3-Flash作代理,速度用官方/AA公开值,定价混合官方确认与行业报道估算,仅作选型参考。
| 模型 | 上下文/多模态 | 智能指数参考 | 速度参考 | 输入/输出定价参考(元/百万tok) | 适合场景 | 备注 |
|---|---|---|---|---|---|---|
| GLM-5.3-FlashX | 长文本、多模态(继承Flash系列) | 参考Flash约57(AA) | 最高200 tok/s(官方,较Flash约5倍) | 官方确认为基础Flash2.5倍;基础Flash 0.4/1.4,估算约1.0/3.5 | 高并发客服、实时Agent、代码助手、流式摘要 | 速度优先、接受单价上浮 |
| GLM-5.3-Flash(基础) | 1M、原生多模态、MoE 320B/18B | AA约57 | AA约47 tok/s、官方提速前较慢 | 0.4/1.4(行业报道) | 重质量、批处理、夜间任务、成本敏感 | 智能强但速度一般 |
| DeepSeek-V4-Flash | 长上下文、代码强 | AA约52(行业汇总) | 约140 tok/s(AA)、社区称150 | 调价后非缓存输入1.5、输出6 | 高吞吐、代码、中文办公、价格敏感大批量 | 速度快但智能分略低、幻觉投诉有案例 |
| Qwen3.8-Flash/Flash-Next | 多模态、1M(Omni版) | 约56(Flash-Next汇总) | 约82 tok/s(AA汇总) | 输入1、输出3(行业报道) | 电商、多模态、音视频摘要 | 均衡但不极端 |
| 豆包/Volcano Flash类 | 中文对话、轻量任务 | 公开对标数据不足 | 视套餐而定 | 视火山/豆包官网 | C端聊天、客服机器人 | 本文未取最新官方FlashX对标,需另测 |
| Claude/GPT高速档 | 强推理、工具生态 | 高端旗舰更高 | 依套餐差异大 | 美元计价偏贵 | 跨国企业、复杂知识工作 | 与FlashX不在同一定价带,仅作能力上限参照 |
横向结论:要“最便宜”选基础GLM-5.3-Flash或Qwen;要“最跟手”选DeepSeek V4 Flash;要“质量+速度兼顾、愿多付些钱”选GLM-5.3-FlashX;要“多模态长文档批处理”FlashX比基础Flash更适合生产流式。
六、典型应用场景与实际体验
- 客服/呼叫中心(运营、售后岗位) 问题:高峰期问答卡顿、人工复制话术慢。 方案:FlashX流式生成退款/物流/工单话术,接订单API自动查状态。 优势:200 tok/s让首句更快;多模态可读用户截图自动判问题。 体验例:用户发“物流停留3天”截图,模型5秒内返回“核实运单→补偿券→升级工单”三步话术。
- 程序员/研发团队(代码助手) 问题:基础Flash质量好但慢,旗舰贵。 方案:ZCode接FlashX,做函数生成、单测、Code Review。 优势:低延迟让IDE补全更跟手;对大型仓库做流式总结。 注意:工具调用先小流量验证;关键安全代码人工review。
- 金融/研报分析(分析师、投研岗位) 问题:PDF/Excel多、摘要慢、要可追溯。 方案:用FlashX读研报、抽财务假设、生成投资要点,接表格校验。基础Flash材料提到金融研究可追溯参考。 优势:长上下文+速度,适合晨会前批量出简报。
- 内容/电商运营(文案、美工协同) 问题:一天几百条商品文、配图建议费人。 方案:图片+卖点表进模型,出标题、详情、SEO词、配图结构。 优势:多模态原生;高速版可撑大促并发。
- 企业Agent/工作流(IT、流程自动化) 问题:多步工具调用、并发高、延迟敏感。 方案:FlashX做规划与调度,子 agent 调搜索/数据库/CRM。 优势:速度降低端到端时长;按业务分模型——重推理走旗舰、轻任务走FlashX。
用户评价摘取:第三方实测文章称GLM-5.3-Flash“14项benchmark对DeepSeek-V4赢11项,视觉6项全赢”;另有社区反馈基础Flash“质量能打但慢、思考模式关不掉、工具调用需多测”,因此FlashX对这类痛点最直接。
七、GLM-5.3-FlashX能为用户带来的价值
- 时间价值:首字和整体生成更快,客服/Agent少等待。
- 成本结构价值:相比旗舰省、相比基础Flash快;用“速度换单价”匹配高人力成本业务。
- 工程价值:API标准化、可接ZCode/AutoClaw/自有系统,方便做流式、限流、观测。
- 国产算力合规价值:智谱披露国产卡集群承接,对数据本地化、供应链自主有要求的政企更友好。
- 生态价值:Chat、Coding、办公、开源权重一条链,从试用到生产平滑迁移。
八、最近3—6个月重大更新与品牌动态
- 2026-08-26:智谱开源GLM-5.3-Flash(320B-A18B MoE,原生多模态,1M上下文),匿名“Ox-Alpha/牛来”在OpenRouter、OpenCode测试,曾冲到平台使用量前列;AA智能指数约57,定价为旗舰约1/10。
- 2026-08下旬:Z.ai文档、HuggingFace权重、ZCode、GLM Coding Plan陆续放量的;星图等第三方平台接入GLM-5.3-Flash做文档/代码/金融调用。
- 2026-09-03至09-20:GLM Coding Plan“Flash×ZCode”夜间23:00—9:00免费,其他Agent额度翻倍,促进错峰开发。
- 2026-09-18:GLM-5.3-FlashX正式上线,API全开,Model Key GLM-5.3-FlashX;最高200 tok/s、较基础Flash约5倍速度,定价约2.5倍;智谱披露国产芯片集群扩容承接高并发。
- 行业侧:2026-09 DeepSeek V4 Flash调价、Qwen3.8-Flash/Omni上线,国产Flash进入“速度+生态”竞争阶段。
九、常见问题FAQ
Q1:GLM-5.3-FlashX免费吗?
A:不是全免费。API按量计费;官方确认比基础Flash贵约2.5倍,具体单价以BigModel控制台为准。智谱偶发做Coding夜间免费等活动,但那通常针对GLM-5.3-Flash等指定模型。
Q2:网页版能直接用FlashX吗?
A:先在Z.ai Chat、智谱清言看是否可选GLM-5.3-FlashX;若未显示,用BigModel/Z.ai API按Model Key调用最稳。
Q3:和基础GLM-5.3-Flash怎么选?
A:批量离线、成本敏感用基础Flash;实时对话、高并发、Agent跟手用FlashX。基础Flash智能强但约47 tok/s,FlashX最高200 tok/s。
Q4:支持多模态和1M上下文吗?
A:同系列基础Flash公开支持原生多模态与1M上下文;FlashX作为提速版通常继承系列能力,但最终以官方模型卡/文档为准。
Q5:和DeepSeek V4 Flash比谁好?
A:要绝对速度、低价大批量可选DeepSeek(约140 tok/s、调价后输出6元/百万tok);要更高质量/多模态/智能分参考更高,选FlashX(参考Flash AA57、最高200 tok/s但单价更高)。
Q6:企业私有化部署有吗?
A:基础Flash已开源权重;FlashX若需私有化/专有机型,联系智谱商务或BigModel企业控制台,公开资料未给个人独立安装包。
Q7:工具调用稳吗?
A:基础Flash社区有“工具调用需多测”的反馈;FlashX生产化建议做schema校验、重试、人工兜底,尤其多步Agent。
十、总结
如果你在做客服、代码助手、实时Agent、大促文案这类“既要质量又要快”的业务,GLM-5.3-FlashX很值得试:它用最高200 tokens/s和约5倍提速解决基础Flash的慢痛点,用同系列57分级智能指数和原生多模态保住质量,代价是单价约为基础Flash的2.5倍。 若是纯离线批处理、成本极度敏感,继续用GLM-5.3-Flash或Qwen/DeepSeek更划算;若是高并发生产、用户等待成本高于token成本,FlashX的ROI更明显。建议先拿100条真实业务样本做“准确率+首字延迟+单条成本”三指标对照,再决定全量切换。
本文最新更新日期:2026年9月18日
参考文章或数据来源
- 智谱推出GLM-5.3-FlashX,上海证券报·中国证券网,2026-09-18:https://www.cnstock.com/commonDetail/792226
- 智谱发布GLM-5.3-FlashX 扩算力、提速度、提定价,证券时报网,2026-09-18:https://www.stcn.com/article/detail/4190490.html
- “神秘模型”迭代,智谱提价上线GLM-5.3-FlashX,21世纪经济报道/网易,2026-09-18:https://www.163.com/dy/article/L748RFAP05199NPP.html
- 智谱GLM-5.3-FlashX模型上线,更快、更流畅,IT之家/网易,2026-09-18:https://www.163.com/dy/article/L741VQ2A0511B8LM.html
- 智谱GLM-5.3-FlashX模型上线,凤凰网/IT之家,2026-09-18:https://tech.ifeng.com/c/8wWCGvz2u33
- AI日报:智谱发布GLM-5.3-FlashX等,腾讯新闻/AIbase,2026-09-18:https://news.qq.com/rain/a/20260918A07KSJ00
- 实测智谱GLM-5.3-Flash,腾讯新闻,2026-08-27:https://new.qq.com/rain/a/20260827A0AHEX00
- 港股AI大模型双雄、智谱认领“牛来”与GLM-5.3-Flash数据,中宏网,2026-08-27:http://gp.zhonghongwang.com/show-6-79008-1.html
- 刚刚,神秘“牛来”模型揭晓:智谱GLM-5.3-Flash(含官网/ZCode/HF入口),网易,2026-08-27:https://www.163.com/dy/article/L5A2T1FV0531E3NX.html
- 智谱GLM-5.3-Flash夜间免费用,凤凰网/IT之家,2026-09-04:https://tech.ifeng.com/c/8w8bcTvWyOl
- DeepSeek降价与GLM/Qwen Flash定价对比,新浪财经,2026-09-09:https://finance.sina.com.cn/roll/2026-09-09/doc-inirfytn5596738.shtml
- 国产大模型竞争逻辑从拼价格转向拼生态,中国经济网/中国经济新闻网,2026-09-15:https://www.ce.cn/cysc/newmain/yc/jsxw/202609/t20260915_3213228.shtml、https://www.cet.com.cn/wzsy/cjcj/10557981.shtml
- 星图上线GLM-5.3-Flash及API示例,新浪财经,2026-08-28:https://finance.sina.com.cn/roll/2026-08-28/doc-inipvvzx5699182.shtml
引用总结:本文引用了证券时报网、上海证券报/中国证券网、中国经济网、中宏网、21世纪经济报道、IT之家/网易、腾讯新闻、凤凰网、新浪财经等平台内容;产品参数与入口以智谱BigModel、Z.ai官方文档/博客为主,智能指数与速度对照参考Artificial Analysis及行业媒体汇总,定价对照参考BigModel/DeepSeek/Qwen公开报道与智谱官方通告,用以证明文章在专业性和时效上的可靠性。
数据统计
更多AI产品信息
GLM-5.3-FlashX
已有 15 次访问体验
GLM-5.3-FlashX的官网地址是?
GLM-5.3-FlashX的官网及网页版入口是:https://docs.bigmodel.cn/cn/guide/models/vlm/glm-5.3-flash 官网入口👈
网站流量数据说明
网站数据仅供参考。评估因素包括访问速度、搜索引擎收录、用户体验等。 如需获取详细数据(如IP、PV、跳出率等),请联系站长获取。
AI产品库AIProductHub是一个专注于AI产品收录与分享的网站平台,平台收录了1000余款AI产品,覆盖创作、办公、编程、视频生成、电商、设计、写作、图像生成等多个领域和行业,平台旨在帮助更多的用户发现更好用的AI产品。本站【AI产品库官网 – AIProductHub】提供的【GLM-5.3-FlashX】信息来源于网络,由AI搜集汇总并整理成文。 对于该外部链接的指向,不由【AI产品库官网 – AIProductHub】实际控制。【GLM-5.3-FlashX】在【2026-09-18 21:17】收录时, 该指向跳转网页链接内容属于合规合法,后期如出现违规内容,可直接联系网站管理员删除,【AI产品库官网 – AIProductHub】不承担任何责任。
本文地址:https://aiproducthub.cn/sites/glm-5-3-flashx.html 转载请注明来源
相关导航


OiiOii

紫东太初大模型

摄图AI

Midjourney V8.1 Alpha

橙篇AI

快马InsCode