奇觅
奇觅是美图旗下的游戏广告AI平台,通过自动化制作与投放大幅降低游戏营销成本。
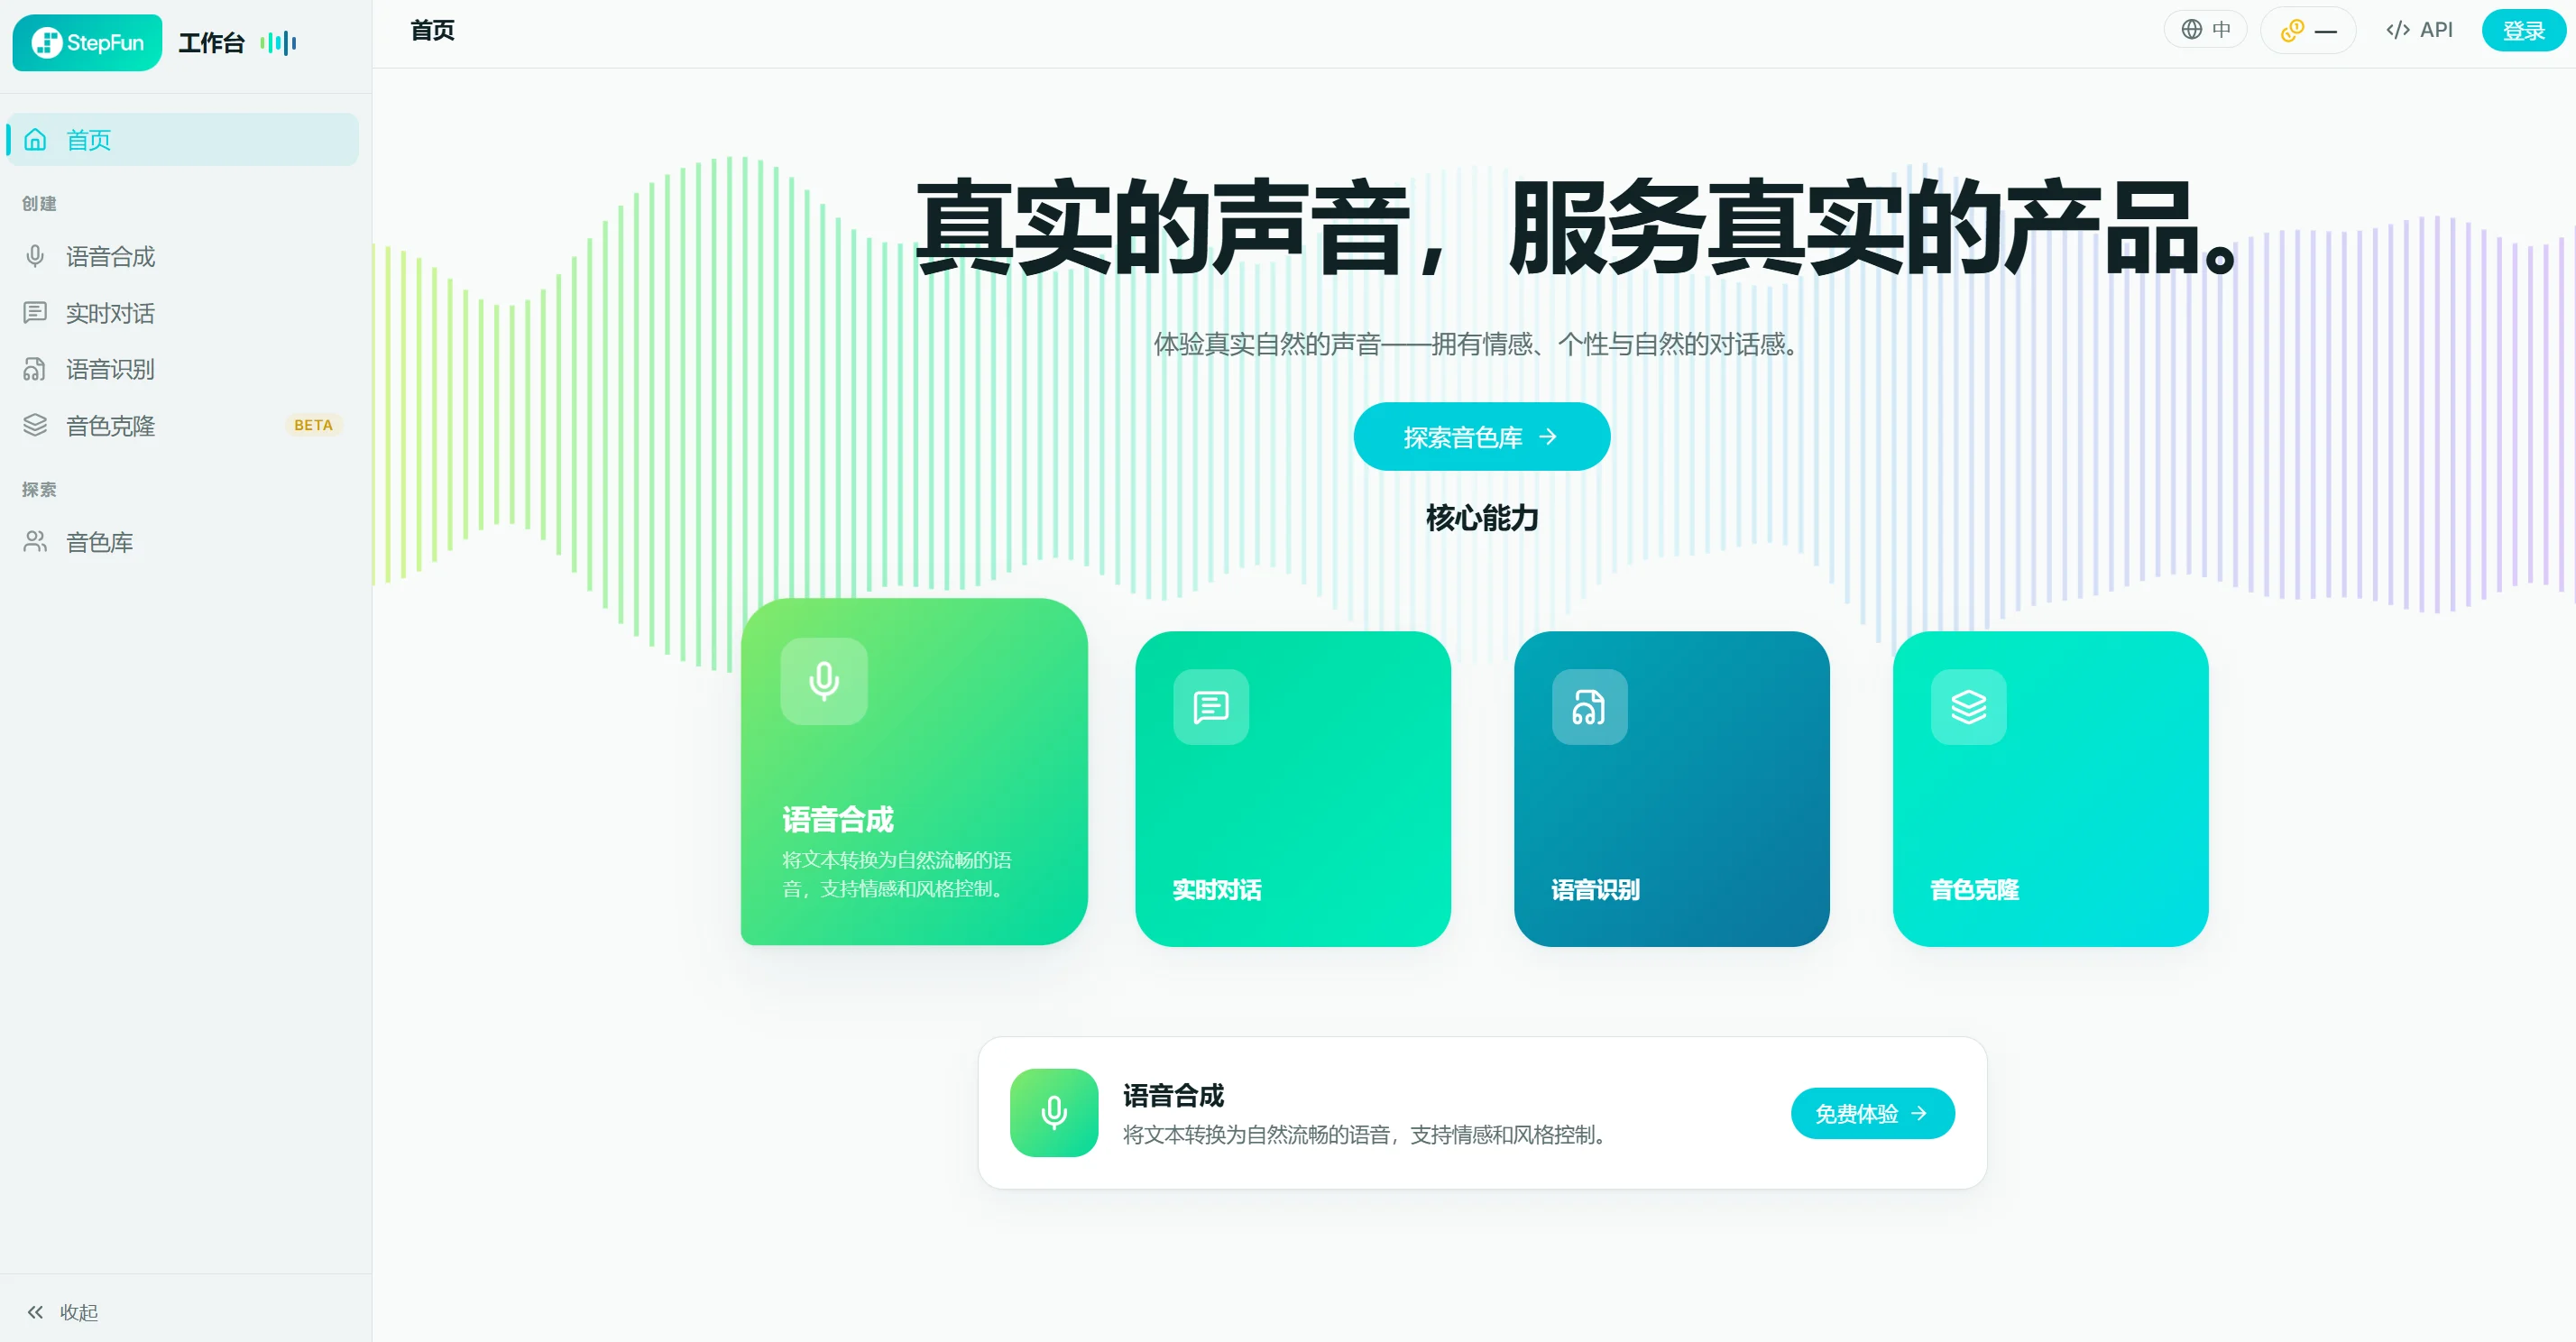
StepAudio 3是阶跃星辰语音大模型系列,覆盖实时对话、识别、合成、音频与音乐生成,支持全双工与语音推理。
 StepAudio 3 语音大模型
StepAudio 3是阶跃星辰2026年9月发布的语音音频矩阵,含Realtime、ASR、TTS、Gen、Music,覆盖实时对话、转写、真人配音、全景音频与音乐创作,定位是“听、说、理解、推理、创作”全栈语音基础设施。
Realtime做全双工语音推理与工具调用,ASR中英文方言转写WER 1.7%,TTS流式拟人配音,Gen统一生成人声音效配乐,Music支持歌词清唱多轮编曲,均上线阶跃开放平台。
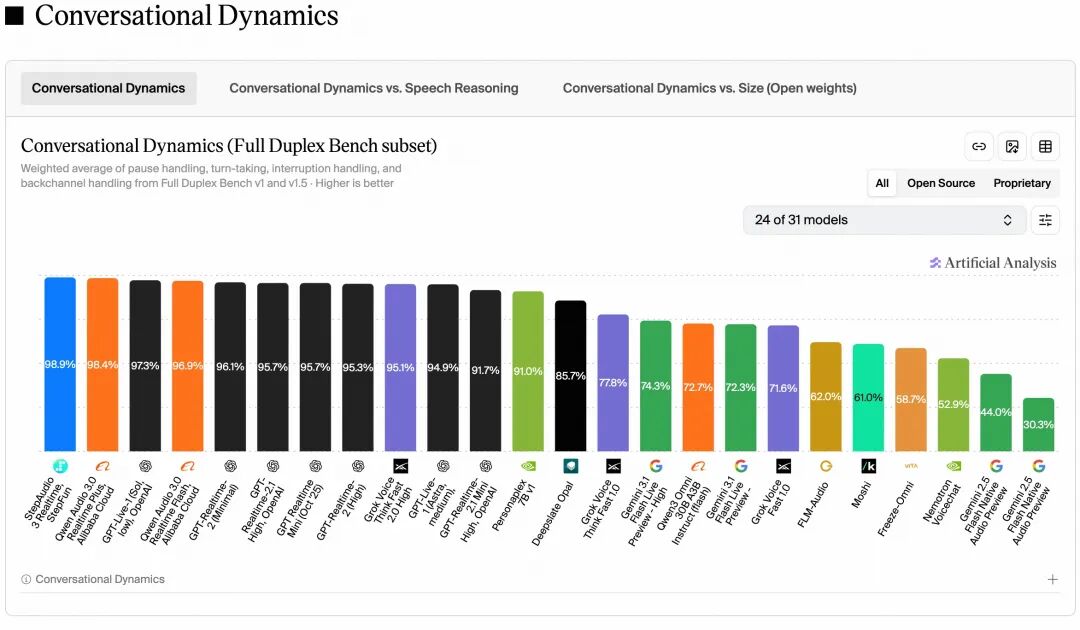
根据新民晚报/上海市先导产业促进中心转发信息,五款模型均已上线阶跃星辰开放平台,覆盖实时交互、识别、合成、音频生成与音乐创作。
我用表格汇总公开材料里最硬的几点,全部来自Artificial Analysis相关榜单与阶跃发布稿:
| 模型 | 核心指标 | 公开数值 | 说明 |
|---|---|---|---|
| StepAudio 3 Realtime | Conversational Dynamics综合得分 | 98.9% | 全双工对话节奏、打断、等待评估,阶跃称全球第一 |
| StepAudio 3 Realtime | Speech Reasoning语音推理准确率 | 99.7% | 直接听音频做复杂推理,非先转文字再推理 |
| StepAudio 3 ASR | 非流式语音识别WER词错误率 | 1.7% | WER越低越好,阶跃称并列全球第一 |
| StepAudio 3 TTS | 流式生成、副语言还原 | 未给单一分数 | 支持笑声、迟疑、重复、改口、停顿情绪控制 |
| StepAudio 3 Gen | 人声/音效/环境/配乐联合生成 | 未给单一分数 | 按角色、场景、时间序列编排 |
| StepAudio 3 Music | 歌词/清唱/参考/ABC多轮 | 未给单一分数 | 面向歌曲创作、翻唱、配乐迭代 |
专家观点引用:网易智能在发布解读中将其概括为“从单项识别/合成走向实时理解、推理、执行与创作的一体矩阵”,认为全栈能力会替代单点模型成为语音AI竞争主线。
用户关心点:开发者最关心“能不能低延迟接入API”、内容团队最关心“TTS像不像人、Gen能不能省外包”、企业最关心“ASR专业术语准不准、数据怎么计费”。
我体验式总结它的四个差异化:
案例:客服场景用户中途插入“等等,先别查退款,先改地址”,Realtime可保留原任务上下文并切换子目标。
主要信息列表:
案例:一场两小时医学学术会,发言人混用中英文药名和缩略语,ASR可输出带术语标准化的文字稿,后续再进TTS做通俗版摘要音频。
特点:
案例:做儿童故事配音,同一角色在紧张段落加速、在搞笑段落加“呃…哈哈”,比传统朗读型TTS更自然。
输入示例:“男主30岁低沉、女主25岁清亮,雨夜咖啡馆,先环境雨声,再男主犹豫独白,中间手机震动音效,结尾轻爵士。”
输出可含:人声对白+雨声环境+震动音效+背景乐,并按时间线混排。
适用:短剧、广播剧、游戏过场、广告小片、有声书场景音。
支持:
案例:短视频团队给618促销做15秒洗脑曲,先写歌词→Music出demo→用参考曲定风格→ABC微调旋律小节→导出配口播。
公开稿只明确“五款模型已上线阶跃星辰开放平台”,未给全量网页体验/SDK细节;下面按通用大模型平台路径写,实际以控制台为准。
ASR调用思路:
POST /v1/audio/transcriptions
Header: Authorization: Bearer <STEP_API_KEY>
Body: {model:"step-audio-3-asr", file:audio.wav, language:"auto", domain:"medical"}
返回: {text, words, timestamps, terms}
TTS思路:
POST /v1/audio/speech
{model:"step-audio-3-tts", voice:"female-warm", emotion:"happy", stream:true, text:"..."}
返回: audio stream
Realtime思路:用WebSocket建立语音通道,客户端传PCM/OPUS,服务端回合成语音;在session里挂function/tool定义,例如query_order、create_ticket。
访问建议:搜索引擎搜“阶跃星辰开放平台 StepAudio 3”,进入官方后看模型文档;若只搜到新闻不进控制台,说明需申请权限。
做横向时我只放公开可验证或行业公认能力,不把未披露数据硬填。
| 维度 | StepAudio 3(阶跃) | GPT-4o/音频类实时 | Gemini Live/音频 | Qwen-Audio 3.0 TTS(阿里) | MiniMax音频/语音 | 传统ASR+TTS拼接 |
|---|---|---|---|---|---|---|
| 实时全双工 | Realtime支持,98.9%对话动态、99.7%语音推理 | 强,生态成熟 | 强,多模态live | 实时Flash版首包300ms级(TTS向) | 实时语音/配音较成熟 | 通常半双工、需自研打断 |
| 语音识别 | ASR WER 1.7%非流式 | 强,多语种 | 强,长上下文 | 侧重TTS,ASR另看通义系 | 中等偏强 | 专业术语弱 |
| 拟人TTS | 流式+副语言笑声/迟疑 | 自然 | 自然 | Plus语音合成Arena第一、48kHz、3分钟、20方言 | 音色库丰富、情感强 | 机械感明显 |
| 全景音频Gen | Gen人声+音效+环境+配乐统一 | 多靠第三方 | 多靠第三方 | 以TTS为主,Gen未强调 | 有音效音乐能力 | 无 |
| 音乐创作 | Music多轮、清唱/ABC/翻唱 | 弱/需插件 | 中等 | 弱/需第三方 | 有生成音乐 | 无 |
| 工具调用/异步任务 | Realtime支持Tool Call、长任务异步 | 支持函数调用 | 支持扩展 | TTS为主不强调agent | 看方案 | 无 |
| 中文/方言专业场景 | 医疗法律金融等,方言中英混说 | 强但术语需调 | 强 | 20方言TTS、行业可微调 | 中文强 | 弱 |
| 接入门槛 | 开放平台API,价格未公开 | API成熟、计费透明 | 云生态计费 | 阿里云百炼 | 国内API成熟 | 低但维护高 |
选购建议:
痛点:转写错专业词、机器人不会打断、查单卡对话。
StepAudio方案:ASR把来电转高精度文本→Realtime理解情绪与意图→Tool Call查订单/改地址/建工单→TTS用拟人口吻回复。
优势:中断不重来、长任务后台跑、术语少错。
痛点:两小时会,人名药名案号错一片。
方案:ASR长音频+领域词典,输出带时间戳文稿;Realtime可做实时字幕。
实际体验预期:低声/快语速仍转写,但极端噪音建议先降噪再传ASR。
痛点:配音贵、情绪单一、音效配乐分开采买。
方案:TTS出主角旁白,Gen补环境和对白音效,Music出片头曲。
案例:10分钟科普稿,TTS分男女角色,Gen加“实验室仪器声”,比起外包省2-3天。
痛点:原型音轨沟通成本高。
方案:Gen用自然语言出第一版“角色+场景+音效+配乐”,导演改提示词迭代,再进Pro Tools精修。
痛点:等作曲老师排期。
方案:Music输入品牌调性+歌词+参考曲,出3版15秒/30秒/60秒;人工挑旋律。注意版权和平台审核要提前确认。
Q1:StepAudio 3是免费还是收费?
A:2026年9月发布稿未公开单价。通常开放平台会有免费试用额度或按调用量计费,具体以阶跃星辰开放平台价格/配额页为准。
Q2:有没有网页版直接体验?
A:公开信息称五款模型已上线阶跃星辰开放平台;若控制台提供Playground,可网页试用ASR/TTS/Realtime等。未看到独立网页产品URL时,不要从第三方不明站点下载。
Q3:支持哪些语言和方言?
A:ASR/TTS侧支持中文、英文、方言、中英混说;具体方言种类和音色调优以平台音色库文档为准。
Q4:和StepAudio 2.5比升级在哪?
A:2.5侧重实时对话、副语言、人设;3代扩展到ASR更专业、TTS更流式拟人、Gen全景音频、Music多轮创作,且Realtime加入更强语音推理与异步工具调用。
Q5:能做离线端侧吗?
A:本次公开稿主要讲开放平台云端五款模型;若需车载/穿戴离线,需等阶跃后续Lite/端侧版本或私有化部署公告,当前材料不足以确认。
Q6:音乐生成版权归谁?
A:官方发布稿未细化Music版权规则。企业商用建议看平台协议,并对生成旋律做查重/登记,避免参考曲侵权。
Q7:开发者接入难吗?
A:若平台提供REST/WebSocket/SDK,ASR/TTS当天可跑通;Realtime全双工+Tool Call需要设计会话状态与函数 schema,建议先小样再上生产。
我整体评价:StepAudio 3是2026年国内少见的“全栈语音矩阵”而不是单点TTS/ASR。它的强项在三点——Realtime把全双工、语音推理、工具调用连起来,ASR用1.7% WER打专业转写,Gen+Music把内容生产从“分别找配音、音效、配乐”合并成提示词工作流。对客服、会议、有声书、短剧、音乐营销团队,价值很明显:省人力、省迭代轮次、中文专业场景更稳。短板是公开材料未给价格、桌面端/插件、独立APP和离线条款,企业POC前要先在阶跃开放平台确认配额、合规、并发和私有化能力。若你做中文语音agent或音频内容工厂,它值得列入首选评测;若主要做纯英文全球客服,再和GPT/Gemini做一轮同语料对比更稳妥。
本文最新更新日期:2026年9月18日。
参考文章或数据来源
1、《阶跃发布StepAudio 3系列语音大模型,多款模型登顶全球第一》,腾讯新闻/凤凰网科技,2026-09-15,https://news.qq.com/rain/a/20260915A0968L00
2、《阶跃发布 StepAudio 3 系列语音大模型,拿下多个全球第一》,IT之家/腾讯新闻,2026-09-15,https://news.qq.com/rain/a/20260915A090TZ00
3、《刚刚,中国语音AI连拿多项全球第一!》,网易,2026-09-15,https://www.163.com/dy/article/L6T6UF3G0511ABV6.html
4、《通过主流榜单,看看Gemini 3.8 Live把语音Agent推到了哪一步?》,网易,2026-09-17,https://www.163.com/dy/article/L72AU6C90511DTVV.html
5、《StepAudio 3系列来了!从实时对话到音乐创作,多款模型获全球第一》,上海市先导产业促进中心/新民晚报转,2026-09-17,http://mp.weixin.qq.com/s?__biz=MzkwNzc1ODUwMQ==&mid=2247506665&idx=4&sn=08fe7549248a2e4b0a57ba5b0e2d5c2a
6、《阶跃全新发布 StepAudio 3:语音大模型进入“听说想做”阶段》,大洋网/广州日报,2026-09-15,https://news.dayoo.com/finance/202609/15/171077_55003957.htm
7、《不止会听会说!阶跃星辰发布StepAudio 3系列》,国际金融报,2026-09-15,https://www.ifnews.com/news.html?aid=870072
8、《阿里甩出“配音”神器:能调整情绪,还会说方言》(Qwen-Audio 3.0 TTS对照),凤凰网/智东西,2026-07-20,https://tech.ifeng.com/c/8uvCbeka51I
9、《阶跃星辰发布全新语音大模型StepAudio 3》,人民财讯/证券时报网,2026-09-15,https://stcn.com/article/kx-tag-detail.html?tag=7kPHzNtlXWyU
10、《阶跃星辰开放平台》相关模型与Step系列信息,百度百科(含2026年5月StepAudio 2.5、9月StepAudio 3上线开放平台),https://baike.baidu.com/item/%E9%98%B6%E8%B7%83%E6%98%9F%E8%BE%B0%E5%BC%80%E6%94%BE%E5%B9%B3%E5%8F%B0/67635400
引用总结:本文引用了腾讯新闻、网易、大洋网、国际金融报、证券时报、上海市先导产业促进中心/新民晚报等平台内容,核心评测数据来自阶跃星辰发布稿与Artificial Analysis第三方榜单(经上述媒体交叉引用);产品动态同时对照阿里Qwen-Audio 3.0 TTS、Gemini实时语音等公开报道,用以证明StepAudio 3在实时推理、ASR词错误率、TTS/Gen/Music全栈能力上的专业性与可靠性。因官方价格、独立客户端、离线端侧信息未在近3个月权威稿中完整披露,相关接入与收费以阶跃星辰开放平台控制台最新文档为准。
已有 7 次访问体验
StepAudio 3 语音大模型的官网及网页版入口是:https://audio.stepfun.ai/ 官网入口👈
网站数据仅供参考。评估因素包括访问速度、搜索引擎收录、用户体验等。 如需获取详细数据(如IP、PV、跳出率等),请联系站长获取。
AI产品库AIProductHub是一个专注于AI产品收录与分享的网站平台,平台收录了1000余款AI产品,覆盖创作、办公、编程、视频生成、电商、设计、写作、图像生成等多个领域和行业,平台旨在帮助更多的用户发现更好用的AI产品。本站【AI产品库官网 – AIProductHub】提供的【StepAudio 3 语音大模型】信息来源于网络,由AI搜集汇总并整理成文。 对于该外部链接的指向,不由【AI产品库官网 – AIProductHub】实际控制。【StepAudio 3 语音大模型】在【2026-09-18 22:08】收录时, 该指向跳转网页链接内容属于合规合法,后期如出现违规内容,可直接联系网站管理员删除,【AI产品库官网 – AIProductHub】不承担任何责任。
本文地址:https://aiproducthub.cn/sites/stepaudio3.html 转载请注明来源