自由翻滚的风铃草
@nanting
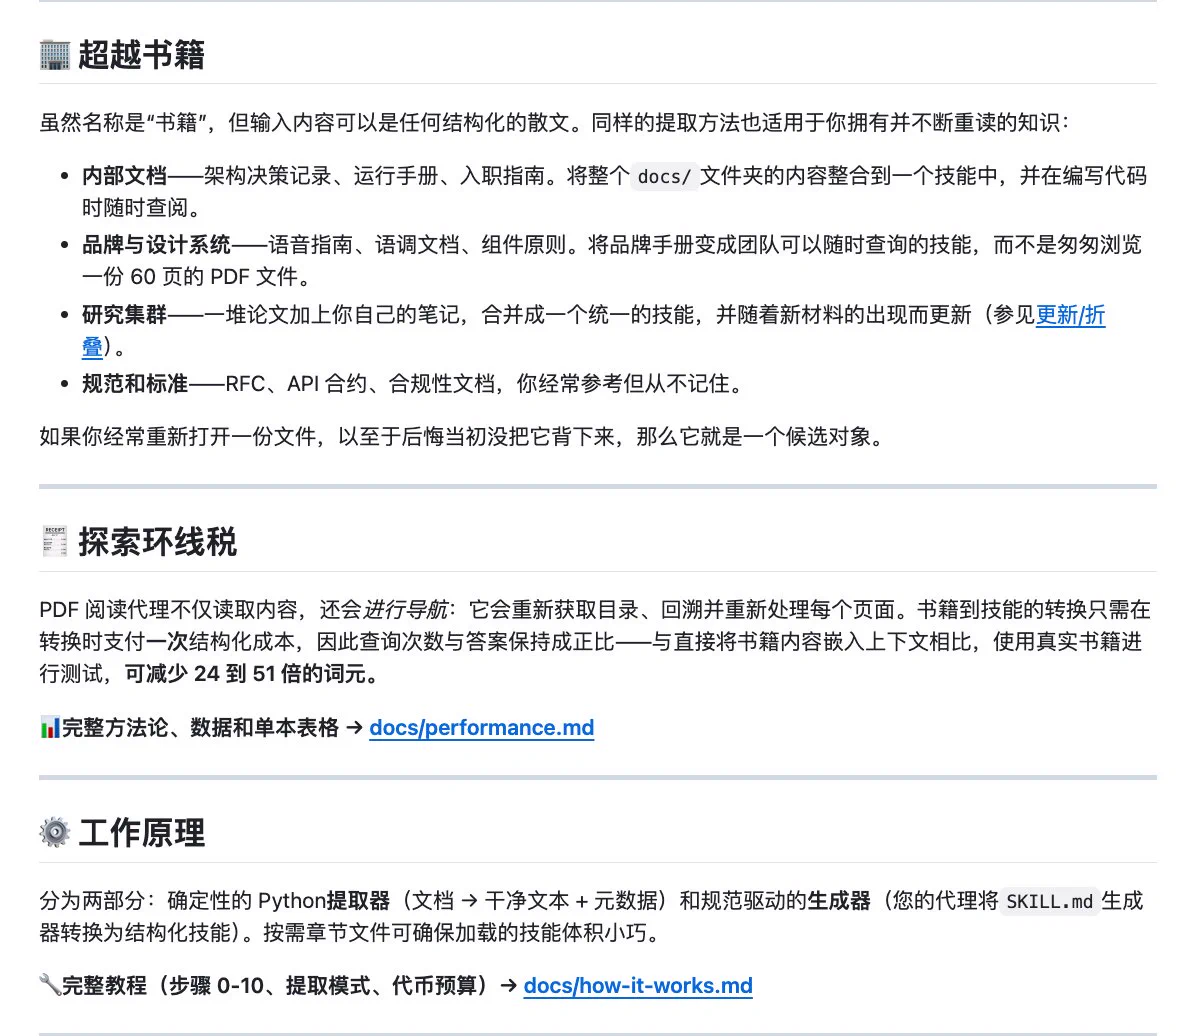
还整本丢书进对话框?那不是读书——模型烧 token 猜。book-to-skill 换打法:书不进上下文,炼成能调用的技能——PDF 扔进去,问「replication 怎么保证」它翻对应那章、不瞎编;答一个问题,token 少 24~51 倍。2.8 万 Star,Claude Code、Codex 通用。
三层拆:一,把"读"改成"按需翻"——与文档渐进披露、工作流按需编排同构:加载从"提前全读"挪到"用时取章",token 账改写;二,"不瞎编"的支点是章节可回溯——答绑具体页、错了指得出,与逐帧可查同一直觉;三,一条 npx 装、一行命令跑,接入不构成选型负担(用法以仓库为准、未执行)。
口径三条:①24~51 倍是其口径——降幅随任务与书目变,跑一轮为准;②2.8 万 Star 是时点数字,涨落不改判断;③"能用"指链路通,不代表切分——切错章,答案照样歪。
给要试的三条:一,拿最熟的书炼一次:已知答案问十个,看翻对几章;二,把"引用章节"当验收:答不出出处的题记下来;三,留对照:同组问题整本 vs skill 化各花多少 token、答对几题。
读完一本书,不是多一段笔记——是给模型永久多一项会翻页的技能。
话题来源 @shenxiankk
1.7K阅读 ❤️21 x.com/…↗ 已改写,非原文转载
221 浏览 0 评论
0 反应