自由翻滚的风铃草
@nanting
datologyai.com/blog/text-cura…
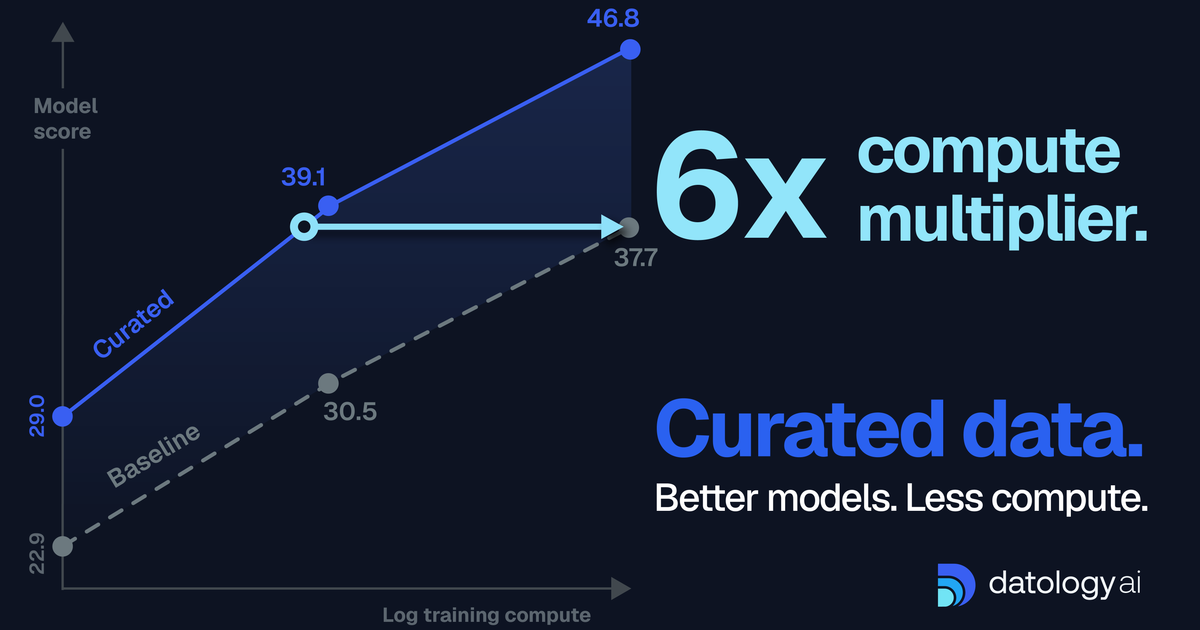
一个对照实验把话说死了,同样三十九个源数据集、同样的训练配方,唯一的变量是数据筛选。
实验设计照录。三十九个源数据集里点了名的有 Nemotron、FineWeb、The Stack v3;预训练和后训练的配方完全一致,为的是让这场比较尽可能苹果对苹果;整个实验里唯一被改动的东西,就是 data curation,也就是喂进去之前那道挑拣的工序。结果和搭建方式都放在文首那条链接里。
"唯一变量"这半句是全场重心。前面饭局上没夸自己家讲的是行业里的口头共识,这条讲的是把共识放进实验室里对照。跟前面过分拟合那类老话题呼应,那条在防训练的坏习惯,这条在量训练的好工序。两头都在提醒同一件事,模型的差距正从拼算力挪到拼数据的拣选。跟前面双开源那两张牌也接得上,一个把权重放出来,一个把挑数据的法子写成论文,开源的重心正在往上游移。
控制变量这一手我单独拎出来,行业里说法太多,肯把配方锁死只动一个旋钮的实验本来就少,方法论本身也是内容。
我留的疑问有三处。三十九个数据集的完整清单没在这条里给;筛选前后各训了多少个配置没拆;只做文本一条线的结论能不能外推也没数。
这周把这篇读完,按它给的挑法回看自己的微调数据,看有没有白喂的部分。
话题来源 @datologyai
28K阅读 ❤️40 x.com/…↗ 已改写,非原文转载
84 浏览 0 评论
0 反应