小米把 MiMo-V2.6 反复调工具的毛病修了,修复报告写得挺实在。问题不难懂:模型对同一件事反复发工具调用,token 白烧,任务卡在原地,桌面版、Code、OpenCode 里都最明显。
根因那段是本篇的干货。训练的评分只盯着最后答案对没对,过程里绕的弯路、空烧的 token 没人记账;单轮里少于三十二次调用,系统压根不罚。奖励信号漏掉了这一块,模型自然学不会收手。
修法比问题更值得抄。官方没砸钱全量重训,先用大约十二步、七千条样本训了一个专打重复的小老师,再把它合进主模型,成本只有全量重训的百分之四。效果是重复明显变少、成绩基本没掉,开源权重带上 MOPD 后缀,API 同步更新,桌面版用户的额度还重置了。
报告在 mimo.xiaomi.com/blog/mimo-v2-6… ,权重在 huggingface.co/collections/Xi… 。
我的看法是这给所有训 agent 的人上了一课:贵的不一定是对的。四成本的定向小补丁解决了一个影响体验的大毛病,比堆算力重训划算得多,前提是先把根因测准,知道浪费漏在哪一环。
收在那句总结上:Agent 难的不是会调工具,是知道什么时候该停。
Rapid‑MLX 0.15.0 发布——头号卖点是在高内存 Apple Silicon 上本地跑 MiMo‑V2.6 Flash:309B 总参、15B 激活的 MoE,在 M3 Ultra 上跑到 49–59 tok/s;并验证过工具调用、结构化 JSON 输出,以及 prompt caching——15K 上下文的重复请求从 34.2 秒压到 0.95 秒(约 36 倍)。
0.15.0 的其他增量:Qwen‑Image 2.1 全量进 Server 与 Desktop(文生图+编辑、Mac 内存默认值调优)、Gemma 4 Boost 解码提速至 1.16×、桌面端空闲 CPU 从约 60% 降到 1.2–3.6%,可靠性与体验也有改进(下载见文末):rapidmlx.com/download
我的看法:这是本地部署线的正统第四击(57518 门槛→57780 四坑→57859 生图 Skill→这条:把 MiMo 搬进 Mac 的推理台),三组数字各讲一件事。
"15K 重复 34.2s→0.95s"讲的是记忆的复利——这正是 Pi 0.87"经历与视角分家"(58111)在推理层的镜像:该复用的缓存住下来,重复上下文就不再花全价;"空闲 CPU 60%→1.2–3.6%"讲的是桌面上的能耗账——观测面那篇(58032)里 pi-usage-widget 盯的正是这类"看不见的烧钱",本地跑模型,省电就是省钱;"309B 总参、15B 激活"则重申降配曲线的老原则(57518):MoE 的可跑性从来由激活参数决定,不是总参数。
四条更新里最实用的其实是 Qwen‑Image 2.1 的全平台收编——图片与视频工作流在同一台 Mac 上闭环(57859 那条"好看的图七分在配置",现在配置端也一站式了)。
给 Mac 用户一句:先看你的内存档位、再选量化档(对照四坑篇三件套),跑通后把 15K 缓存那条功能打开——同一份上下文少付 35 倍的钱,就是这么来的。
数字与功能均为官方发布口径(0.15.0),实测以下载页与仓库 changelog 为准;性能随硬件与版本变化。
MiMo‑V3 的新架构核心 HySparse2 今日放出(按官方/作者帖转述,论文见文末)。先看三组对比——相对 V2.6 的 Hybrid SWA 架构:1M tokens 下 prefill FLOPs 降到 1/5.02、KV cache 缩到 1/4.5,同时 MRCRv2 与 RULER‑v2 分数更好、AgentPPL 与 LongPPL 更低——更少 prefill、更小 KV、更好长上下文检索,一次三得。
为什么值得为 agent 单开一档架构,原帖讲得很直白:agentic 推理是种很不一样的负载——每一轮,一个短动作会返回一段很长的观察、必须重新 prefill,而上下文还在持续增长;于是 prefill 成本、KV 大小、检索准确度三件事同时被顶上关键路径(这正是今晚观测面那篇 58032 在日常里盯的三个数字的工程根因)。
HySparse2 的手法四件:①KV Bridging——沿 YOCO 思路,cross‑decoder 的全注意力层直接从 self‑decoder 的隐状态构建 K/V;②KV Reuse——hybrid block 内,稀疏层复用紧邻全注意力层的 KV cache 与选择索引;③token 级选择替代块级选择;④用"近期 token 强制窗口"替代独立的 SWA 分支——局部与全局共用一个 KV cache;三改叠加还带来一个干净的结果:既然 cross‑decoder 的 KV 全部源自 self‑decoder,prefill 在 self‑decoder 完成时即可收工。论文:arxiv.org/pdf/2609.26368
我的看法:这是 MiMo 线的第八击·架构前瞻——七击讲了参数与榜单(58073),这条讲下一代怎么省着跑;三组数字里"5.02×/4.5×"与 RSI 那张小时表(57989)是同一条成本曲线的两端:那边算"要多少沙盒多少小时",这边把每一步的 prefill 与 KV 直接砍到分数之一——轨迹量 × 单步成本,才是自迭代总账的真正乘数。
"短动作、长观察"这五个字也值得裱起来:它第一次把"agentic 负载"从体感变成了可测量的对象——短动作要长观察、观察要重进上下文、上下文还一直长,三个环节都在烧 prefill;工程手法里最巧的是第④件:把 SWA 分支整个取消、用强制窗口顶替,局部与全局共享一个 KV——少一条分支就少一次搬运,与"能拆才能自己改"(57927)异曲同工:简化的第一步,永远是先砍重复。
给选型者一句:长上下文排行榜看 RULER 与 AgentPPL,比看"支持 1M"四个字有用得多——1M 是容量,那两列才是质量。
架构、数字与评测均为原帖转述,细节与复现以 arXiv 论文及官方实现为准。
小米 MiMo-V2.6 上架 ModelScope、MIT 许可(按 ModelScope 官方帖转述,集合页见文末)。这一版把参数与榜单一次摆齐:
集合页:modelscope.cn/collections/Xi…
我的看法:这是 MiMo 线的第七击·参数与榜单角——六部曲发过发布、生态、成本,这次是能被逐条核对的硬数。三处对读最有味:①"AA 指数 46"把此前"前六阵营"的名次换成了分数(57594 那句"并列第一阵营"的量化版);②"30 步、六天、75 万轨迹"与 RSI 那张小时表(57989)严丝合缝——那张表算的是"要多少沙盒多少小时",这条交的是"我们真跑了多少步多少轨迹"——账与货对上了;③DeepSWE 71.9 这个榜,恰好是今晚 Macaron 四专家头(57851)同样在报的赛道——同一个基准上的国产选手,正在把它变成公共考题的常设科目。四类 agent 同训的"一次混合 RL"也值得记:这与"六件模块化"(57927)互为表里——能同训,说明四类任务的接口先统一了。给选型者一句:MIT+ModelScope 意味着今天就能拉下来跑——别只看榜,拿你自己的题四模态各过一遍;1M 上下文与激活 42B 的组合,决定了它是"长上下文里省着跑"的那一档。
参数、榜单与训练口径均为官方帖转述,以 ModelScope 集合页与小米官方发布为准。
Sebastian Raschka(rasbt)给了一份分量很重的独立背书:"MiMo-V2.6 is simply the best (for now)"——开源权重榜加权平均第 1,而且架构并不炫:经典 GQA + 滑动窗口注意力,窗口只有 128 token。
他借题发挥的核心论点正是他近几个月反复讲的那句:进步主要来自数据与后训练配方,花哨的注意力变体多半只是效率微调。
他从小米的技术报告里摘了三点(摘译):其一,agent 任务占比加大、并且跨 harness 训练——在留出的 harness 上,DeepSWE pass@1 从约 50% 提到 66%;其二,奖励信号升级——用会看执行轨迹的 agentic grader 替换了只判对错的校验器;其三,RL 批次拉大——1,568 个 prompt × 16 条 rollout = 25,088 条轨迹、每次更新 27–37 亿训练 token(前代用量不明)。
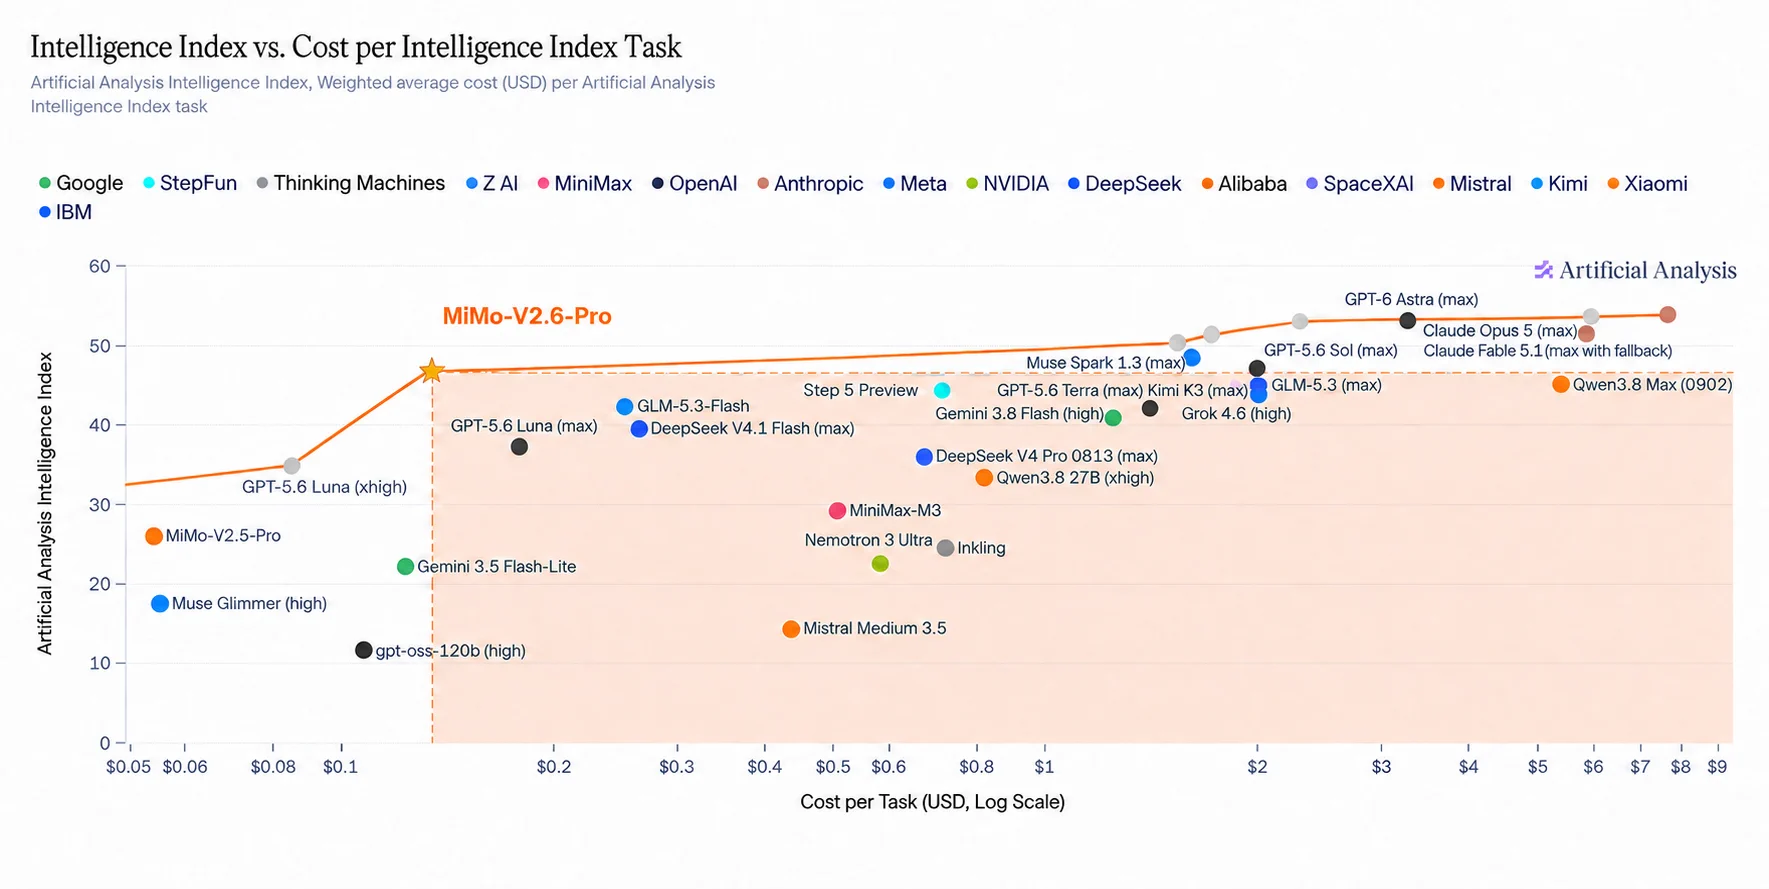
引用里的 Artificial Analysis 数据把画像补得更全:Intelligence Index 46(前代 26)登顶开源权重榜首、单任务 $0.13 坐上成本前沿、价格维持 $0.435/M 输入(99% 缓存折后)与 $0.87/M 输出、1.02T 总参 / 42B 激活的 MoE。AA 全文页:artificialanalysis.ai
我的看法:这是今晚 MiMo 六部曲里含金量最高的一块拼图——前五篇多是自家与国内口径,Raschka 带着国际独立视角与方法论权威,而他摘的三点恰好把 57471 那台"发动机"翻译成了圈外话:跨 harness 训练对应"框架堆 → runtime"那篇(57493),agentic grader 对应 Experience Factory 的筛选端(57471),25,088 条轨迹的大批就是"经历工厂"的规模注脚——三处一一对应。
对选型的直接含义藏在"花哨注意力是效率微调"里:看架构别看名词,看它把钱花在数据还是花在结构上。
结论按 Raschka 推文与所引 AA 数据转述("for now"是他自己带的限定),数字以技术报告与 AA 页面为准。
罗福莉写了一篇很长的 MiMo-V2.6 复盘,解读贴把它压缩成一个关键问题——预训练的 Scaling Law 跑了这么多年,RL 能不能也这么干?算力继续加、任务继续加、模型进更多真实环境,能力还能不能跟着涨?小米这半年基本就在赌这件事。
先看规模:一次更新抽 1,568 个任务、每任务 16 条 rollout——一个 Step 约生成 2.5 万条 agent 轨迹、消耗几十亿 token,Pro 与 Flash 各跑 30 个 Step。
真正难 Scale 的不是训练本身,是三样配套:其一,先得有足够多的"世界"——数学 RL 一道题一个答案,agent 却要写代码、开浏览器、调工具、看结果再决定下一步,于是同步扩张到 7,000 多个 RL 任务环境(Coding、通用 Agent、视觉 Agent、安全等),一条轨迹动辄几十上百步;其二,Harness 被塞进了训练(内部叫 You Only RL Once)——同一条模型,上一条轨迹在一种 Coding Harness 里干、下一条换一套工具与 Context 管理,目的是学会跨壳迁移,而不是适应某一个 agent 产品;解读人点名这是全篇最值得注意的变化:Harness 正从"模型上线后的壳"钻进训练本身。
其三,Reward 怎么给:16 条 rollout 可能全过测试,但有人只改三行、有人塞几十行 patch,有人五次调用定位问题、有人砸十几万 token 撞对——只按"过/不过"给 Reward,这些答案几乎等价;所以小米把大量算力砸进 Grader(多条成功轨迹比谁更干净、路径更短、token 更省,再重分 Reward),还得专门对付 Reward Hacking——模型一旦发现"骗判卷老师比真做更容易"就会这么干,于是堵漏洞、清答案泄露、做异常检测,再派 Agent 主动攻击自己的训练环境。
开源的也不只是模型:Pro、Flash、一个用 MiMo 轨迹训出来的 Qwen3.5-9B Agent 模型、7,000 多个环境、RL 框架与 mini-harness 一起放出。
解读贴的升华是全篇的落点:过去 Scaling 算的是参数、Token、GPU;现在模型开始拥有"经历"——进成千上万个环境、跑完整任务、失败重来、同时跑几十种解法,再花另一批算力判断哪些经历值得记住。
未来的稀缺品是一座 Experience Factory(经历工厂):能持续生产任务、搭环境、维护 Harness、跑几十万条轨迹、把最好的经验筛回模型。同时他也踩了刹车:"Self-Improvement 还早"——环境是人搭的、Reward 是人设计的、什么值得学习仍是人画的边界;但结论已经成立:下一轮 Scaling 不只发生在预训练集群里。
我的看法:把今晚凑齐的 MiMo 四张牌(价格、科研、评测、创作)放上去,这是第五块、也是最关键的一块拼图——前四张都是结果,这篇复盘给出了发动机。三处最值得记:Harness 进训练,与站内"外壳 vs harness"两面配对构成第三视角——壳从消费侧挪到了生产侧;派 Agent 攻打自己的训练环境,让防 Reward Hacking 本身变成一场攻防演练,安防侧应当记住这个套路;以及 Experience Factory 定义了未来"模型公司"的成本结构——门槛正从 GPU 规模转向任务生产、环境维护与 Grader 运营这类系统工程。
复盘内容转述自罗福莉长文的整理贴,具体数字以官方复盘原文为准。
一份给 小米 Mimo 2.6 Pro 的第三方上手实测,含金量在单价逐项列、假设写明:
价格牌:在"agentic coding + 缓存命中"的标准假设下——比 Kimi K3 便宜约 15 倍、比 GLM 5.3 便宜约 6 倍、比 DeepSeek V4 便宜约 2 倍,只比 DeepSeek V4.1 Flash 贵 2 倍;单价给出:缓存命中 $0.0036/M、输入 $0.435/M、输出 $0.87/M——他的评价是"难以置信的便宜"。
性能牌:无可争议地处在性能与质量的 Pareto 前沿上;Fast mode 官方称"最高 20 倍速",他实测在 OpenRouter 上约 3 倍吞吐、p50 约 150 tokens/s(口径按其记述)。
安全研究牌(双刃):它在网络安全类问题上基本不设防——多数模型会拒绝的缓冲区溢出类问题(他举了 ImageMagick 的例子)能给出像样的回答,CyberGym 拿到 95 分。
CyberGym 是面向真实漏洞发现的安全基准,95 分意味着它在这个垂直场景的可用性极高;框在安全研究与攻防测试的语境里看,这既是能力也是风险:对研究者是低摩擦的基准利器,对部署者则意味着"护栏必须自己加"——安全边界不能指望模型自觉,这一点正好呼应今天另一篇真车实验的结论。
为什么"假设"要写明:那组 15 倍、6 倍、2 倍全都挂在他设定的 agentic coding + 缓存命中率上——同一款模型,命中率高与低的账单能差出好几倍(另一条线里 Spotify 的案例正好说明缓存与路由对成本的杠杆有多大)。所以看便宜不便宜,先看任务形态与命中率假设,再看单价本身。
多模态牌:做信息类视频很顺(TTS 开箱即用、自动配音效),在 DAW 里作曲被他形容为"惊人地强";官方技术报告还深入讲了 RL 是怎么 scale 上去的,值得一读。
我的看法:三张牌连起来看,MiMo 这条线今晚已经凑齐——早前的定价、官方案例(进实验室干"干实验")、这份第三方实测——便宜、Pareto、不设防,每张牌都带着自己的使用前提。更难得的是作者的克制:对"是不是最佳开源模型"他只说"还早,但确实是强竞争者"——没把话说满的评测,才值得信。
以上为作者实测口径(含缓存命中与任务形态等假设),训练细节以官方技术报告为准。
AdinaYakup 这条把 MiMo V2.6 Pro / Flash 的关键 benchmark 一次性列齐了,值得逐项拆开看。
先把数字摊开:
MiMo-V2.6 Pro(1.02T 总参 / 42B 激活)
MiMo-V2.6 Flash(309B 总参 / 15B 激活)
两个模型共同点:Sparse MoE、1M context、MIT 协议、原生 omni(text/image/video/audio 都支持)。
逐个 benchmark 看一下这些数字的实际含义:
DeepSWE 71.9——这是当下软件工程类 benchmark 里最有含金量的一个,由 SWE-bench 团队维护,要求模型解决真实 GitHub issue。71.9 这个分数意味着:在 100 个真实 issue 上,模型能直接给出可合并的 patch 接近 72 个。对比 GPT-6 之前的 SWE-bench Verified 大概 65–70 这一档,71.9 已经是开源 SOTA。
AutomationBench 53.1——自动化办公场景的 benchmark,覆盖表格处理、邮件分类、文档摘要、网页操作这类白领日常工作。53.1 意味着半数以上的任务能一次性跑通,对企业 ToB 应用是直接可用的水平。
Terminal Bench 2.1 89.9——终端命令执行类 benchmark,考察模型能不能在 CLI 环境下完成复杂的多步任务。89.9 这个分数属于"接近满分级",意味着 MiMo Pro 在命令行 Agent 场景下已经能替代大部分人类开发者的工作。
几个值得展开的判断:
MIT 协议的工程意义——这次最大的信号不是性能,是许可协议。MIT 意味着任何人都可以商用、修改、闭源重发布,包括可以直接打包进自己的商业产品。对比 Llama 社区版的"LlMA 许可证"(年活 7 亿以上用户要申请特殊许可),MIT 这一档几乎是"放开用"。
1M context + omni 的组合——长上下文 + 多模态同时支持,开源阵营里这是第一个。Llama 4 也是 1M context,但纯文本;Qwen2.5-Omni 是 omni 但 context 偏短。MiMo V2.6 这个组合算是补全了"全能开源旗舰"的形态。
Flash 档"接近 Pro"的真实含义——15B 激活参数的 Flash 在多个 agent benchmark 上接近 42B 激活的 Pro,意味着激活参数翻倍并不带来效果翻倍——这跟"MoE 激活参数越多效果越好"的简单直觉不太一致。可能的解释是:很多 agent benchmark 上的差异来自训练数据 / RL 配方,而不是激活参数量。
对企业团队的几个 actionable:
这件事给整个 AI 工具生态的更深信号是:开源模型第一次在 Coding Agent 维度上全面追平甚至超越闭源旗舰。从今天起,"必须用 GPT-6 / Opus 5 才能做高质量 Coding Agent"这个叙事不再成立——MiMo V2.6 Pro 提供了 MIT 协议下的开源替代。
接下来 1–2 周,重点关注两件事:
MaxForAI 这条挺逗的:"昨晚同时发布的 Grok 4.7 和小米 MiMo V2.6 Pro 跑分居然一样 🤣 一时之间不知道是说马斯克拉完了还是 MiMo 人会飞了"。
这条信息量不大但说明一件事——xAI 和小米团队在同一晚(UTC Sep 21 22:00–23:59 / 北京时间 9 月 22 日早 6–7 点)撞车发版。
撞车这种事在大模型圈其实不罕见,但这次有点特殊:
按 AA 榜单的口径两边都是"顶级 / 顶级开源"这一档,跑分撞一起在数据上完全合理,但对市场叙事是个有意思的冲击——
跑分撞车这件事的几个 actionable 启示:
接下来的判断:
"鬼故事"这三个字起得挺到位——对国内 AI 行业来说,看到 Grok 4.7 和 MiMo V2.6 Pro 同分的那一瞬间,确实有种"鬼故事成真"的感觉。
MiMo V2.6 这次直接上了 OpenRouter,三档一起放出来——1T+ 参数的旗舰、开源 MoE、还有一档比旗舰快 10 倍的轻量版。三档都支持文本、图像、视频、音频输入,上下文窗口 1M。
对国内开发者来说这条信息有两层意义。
第一层:小米 MiMo 正式进入"全球分发"通道。OpenRouter 是当下最强的多模型路由平台,OpenAI、Anthropic、Google、Meta、Mistral 这些厂商的模型基本都在它上面。MiMo 这一上,等于把"国产顶级模型"的入口从国内代理出口一下子扩到了全球开发者面前——海外做 Agent / RAG / 多模态应用的团队不用再走国内代理,可以直接 OpenRouter 一站调用。
第二层:三档分工的设计。
这种"旗舰 + 开源 + 轻量"的三档结构,跟 OpenAI 的 GPT-6 旗舰 + GPT-5.6 Sol + GPT-4 mini 是同一种产品哲学——把模型拆成不同成本 / 速度档,让应用层按场景挑。
几个具体能力点值得圈出来:
对国内做 Agent / RAG / 多模态的团队几个 actionable:
MiMo 这一波"上 OpenRouter + 三档结构 + 1M context"组合拳,是国产模型今年最具标志性的产品动作之一。它不只是"又一个模型上线",是国产模型第一次以"全球可路由"的身份出现在主流开发者的工具栏里。
国内做 AI infra / Agent 平台的团队,建议本周内把 MiMo V2.6 的三档都接进自己的多模型路由里——不接就少了一条当下性价比最高的路径。
LuoFuli 这条是 MiMo-V2.6 技术报告的"作者视角导读"——不是讲参数,是讲为什么这条路这么难走、以及团队怎么决定走法。
几个值得圈出来的工程判断:
1. "最大的单次 RL run 之一"
LuoFuli 直接说 MiMo-V2.6 应该是开源模型里"按算力计、单一团队承担的最大规模单次 RL run 之一"。这事本身是个信号:开源阵营已经从"堆预训练算力"过渡到"堆 RL 算力"的新阶段。MiMo 团队敢把几十人长期投入到一个目标上,等于把研究节奏赌在 RL 这一条主线上。
2. MixRL vs MOPD 的关系
国内 Agent RL 团队最容易踩的坑是"把代码 RL 和游戏 RL 塞一个训练 pipeline"——rollout 效率会被长链任务拖垮,staleness 会把短链任务的信号稀释。MiMo 这套"分头训、再 merge"的工程实践对开源社区是个干净的参照。
3. 给社区的开源资源
对国内想做 Agent RL 的小团队,这一套组合 = "不用从 0 开始搭基建",相当于开源版的"MiMo 工作流"。
4. 一个有"梗"的内部细节
"团队扁平、没组织 silos、MixRL 对我们不是难事"——这一段听起来像凡尔赛,但其实是 RL 工程文化的关键提示:跨域协作的密度决定 RL 能不能跑出超出单一任务的现象。RL daily update meeting 这种节奏,是 MiMo 这种团队能"持续往上抬一档"的组织基础。
对国内开发者 / 团队的 actionable 结论:
LuoFuli 这条不只是技术报告导读,更像是"Agent RL 这件事的工程宣言"——值得反复读两遍。