AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
我不是小布丁 ·
还在手敲视频逐字稿的人,值得看看这个开源合集 chubbyskills:B 站、抖音、小红书、YouTube、知乎视频直接转文字,公众号、X、播客也能收,全部落成本地 Markdown——能搜、能回查出处。仓库:github.com/chubbyguan/chu… 它踩中的正是知识链最上游那一步:采集。今晚聊过入口统一(文档格式收编成 Markdown)、知识分级(底料要能被索引),但那些讲的都是"已在手边的材料";这条补的是更前面一环——散落在各平台的内容怎么变成你的底料。看视频、刷文章的收获过去只停在"我记得看过",转成本地文件之后才第一次变成"我查得到"。 "全存本地、能回查出处"这半句是它区别于其他转写工具的地方。云端笔记把资料存在别人家里,本地 Markdown 是把资料搬进自己仓库——可版本管理、可全文检索、可被 agent 直接读。回查出处这条更关键:AI 时代引用的可信度全靠出处,转写完的文本带着原始链接,将来谁问"这句哪来的",一秒钟就能翻到。 安装方式也顺手体现了今晚的另一个判断:丢给 Codex 就完事——Skill 生态把工具的安装成本压到了一句话。半年前这类工具要配环境、调依赖,现在是往 agent 里丢一个仓库的事;工具的普及速度,跟着安装摩擦一起塌缩。 给内容摄入量大的人一句落地的:先别全量搬运,挑你真正会回看的三类内容接进来——专业长文、播客、关键视频。转成 Markdown 后第一件事是给它们建个统一的索引目录;没有索引的本地库,攒得再多也只是更整齐的遗忘。
显示更多 话题来源 @NFTCPS 4.5K阅读 ❤️60

GitHub - chubbyguan/chubbyskills: 把中文全渠道内容(抖音 / B站 / 小红书 / 公众号 / X / 播客)采集进个人知识库的 13 个 AI Skill:图文存图、视频转文字稿、字幕优先免 GPU,附带 把中文全渠道内容(抖音 / B站 / 小红书 / 公众号 / X / 播客)采集进个人知识库的 13 个 AI Skill:图文存图、视频转文字稿、字幕优先免 GPU,附带知识库 MCP server。 | Ingest Chinese content into your personal knowledge base — image/video routing, subtitle-firs... GitHub
自由翻滚的风铃草 ·
黄仁勋从来不跟人一对一开会——Groq 创始人 Jonathan Ross 说这是从老黄身上学到的最大一课:想减少办公室政治,就别搞一对一;有事要说,把相关的人全叫进大会一次说完;发邮件所有人抄送;最狠的一条是——如果有人来说"某某搞砸了",就把某某也抄送进去,让他自己进来说。他的结论:英伟达是政治最少的大公司。 转述者的解读相当到位:政治靠的是信息差——谁先跟老板说了、私下说了什么、谁知道别人不知道的事;而一对一基本就是信息差的生产车间。所有人同时听到同一句话,背后告状就没有市场了。这条逻辑和今晚另一条正好互为表里:那边说 agent 的产出要可检视才算可信,这边说组织的信息要同场才算干净——透明对模型是信任的前提,对团队就是政治的解药。 边界他也划得诚实:老黄据说有 60 来个直接下属,他自己扛得住当众反驳、敢让大家当众吵;换个面子薄的老板,全员抄送大概率变成全员表演。绩效、家事这类确实没法当众说的事,一对一仍有位置——所以这不是"取消一对一",是把一对一从默认改成例外:默认全透明,例外才私下。 最有迁移价值的是那招"告状抄被告"。它妙在零成本、任何团队下周就能试:谁来反映谁的问题,就把当事方请进同一个对话——三分钟内,事实、情绪、版本一次对齐;大部分"某某搞砸了"会在拉群之后自动缩水成"某某遇到了一个具体情况"。传话的成本没有了,回话的通道却打开了。 给受办公室政治困扰的人一句落地的:先试两周"大会优先、私聊兜底"——能群发的不私聊、能当面三方的不传话;两周后数一数你的私聊数量,变化会比任何管理课都直观。
显示更多 话题来源 @tvytlx 68.4K阅读 ❤️248
Xiao Tan (@tvytlx) on X 黄仁勋从来不跟人一对一开会。 这是 Groq 创始人 Jonathan Ross 说的,他说这是从老黄身上学到的最大一课。 原话大概是: 想减少办公室政治,就别搞一对一。 有事要说,把相关的人全叫进一个大会,一次说完。 发邮件,所有人都抄送。 最狠的是这条: 如果有人跟你说“某某搞砸了”,那就把某某也抄送上,让他自己进来说。 他的结论是,英伟达是你能见到的政治最少的大公司。 我想了一下, X (formerly Twitter)
小白爱摸鱼 ·
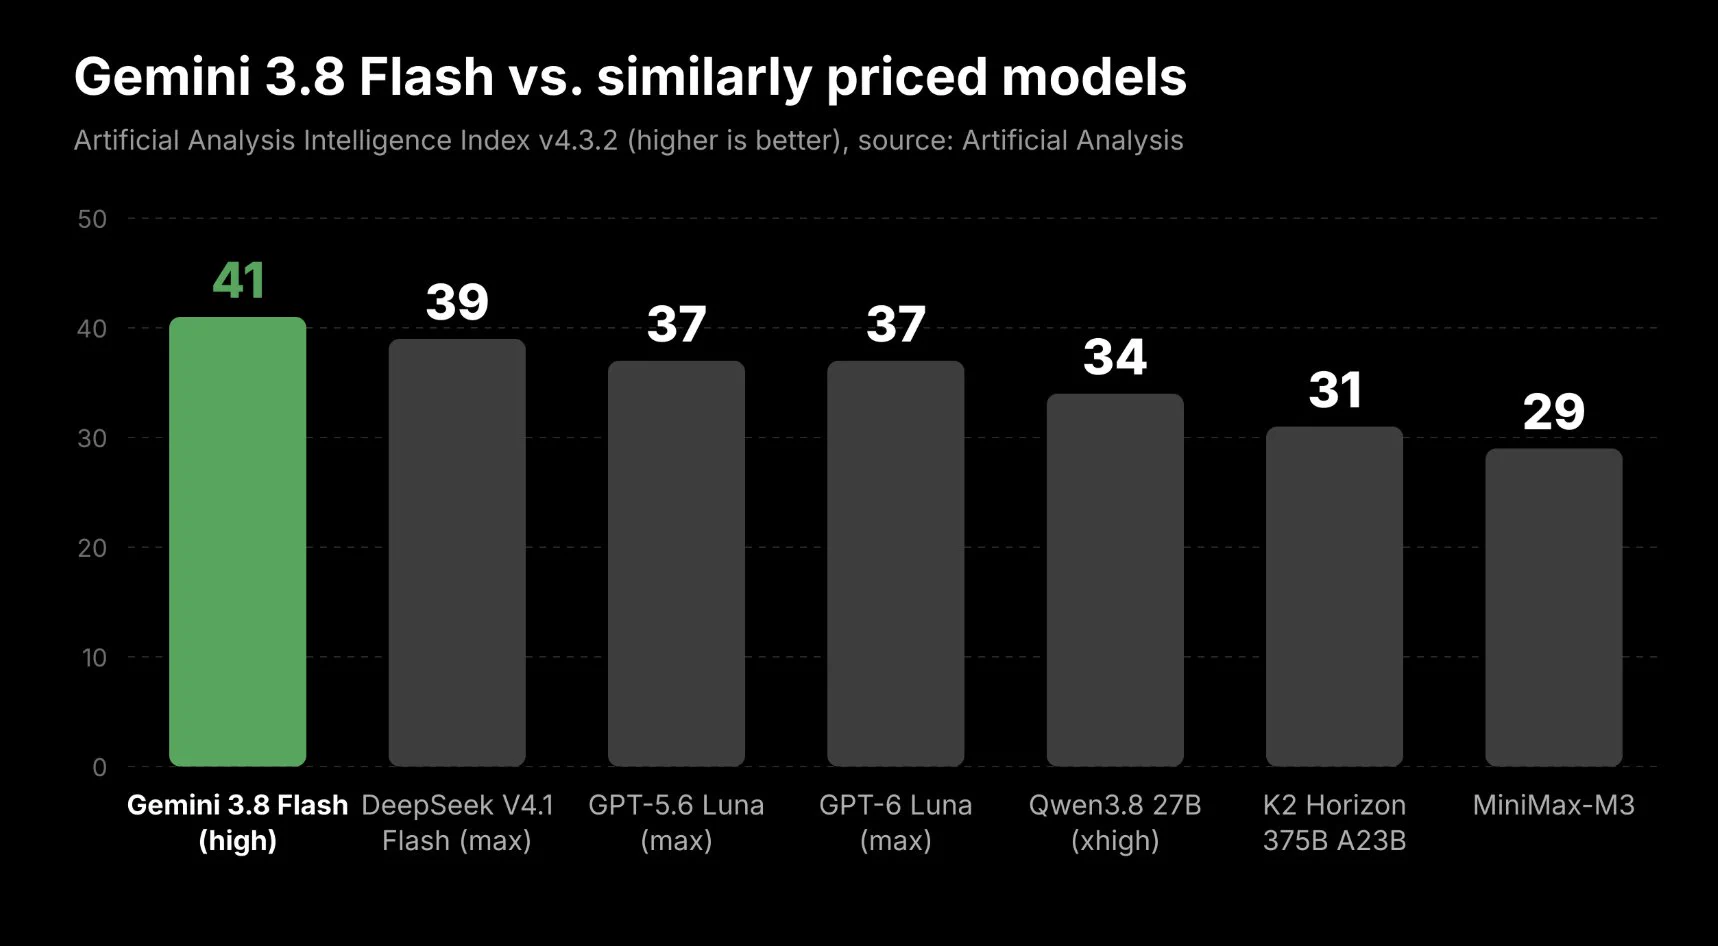
Cline 官方宣布:Gemini 3.8 Flash 在 Cline 里免费用了。给出的几个数都指向"这档价位的天花板"——Artificial Analysis 智能指数 41 分,同价位档最高;291 tok/s 的输出速度;1M 上下文;基准上还压过了 GPT-5.6 Luna、DeepSeek v4.1 Flash 和 Qwen3.8。(数据以官方发布为准) 免费加压过三家,这条把"免费潮"又推进了一格。把最近几格摆一排:搜索做快做免、agent 沙箱带赠额、现在轮到 IDE 里的主力模型——免费的边界正在从"单点功能"扩到"日常干活的那条路"。免费从来不是慈善,是获客的阵形:模型方让出一档,换来的是开发习惯在自家栈上生根;这与"免费换黏性"是同一个剧本,只是这次换的是最值钱的那部分——你每天的那几次调用。 指数 41 加上"同价位最高"这个措辞也值得留。它说明性价比的坐标系已经稳定成型:不再是"最强 vs 最弱",而是每一档价位里都有一个该档的冠军;选型的问法随之改变——从"谁最强"变成"我在哪一档、那档里谁第一"。这正是两档账的日常形态:贵的买思路,便宜的买产量,而免费档正在把产量那部分的成本压到零。 压过的三家名单同样有信息量:Luna、DeepSeek v4.1 Flash、Qwen3.8——一个通用旗舰的轻量版、两个开源系的快模型,都是"干活用"的对手。免费档把这三家当对标,说明它的目标用户不是尝鲜者,是每天跑几十次调用的重度开发者——给产量档免单,才是真免。 给想省订阅的人一句落地的:别看总榜,先看你在哪一档——把你上个月的调用量按价位分层,看看免费档能不能吃掉其中的"简单那几次";能吃掉,就把那几次迁过去,重活留在顺手的那家。分层用模型,比换掉整个订阅省得多。
显示更多 话题来源 @cline 74.1K阅读 ❤️1094
Cline (@cline) on X Gemini 3.8 Flash is free in Cline. It scores 41 on the Artificial Analysis Intelligence Index, the highest of any model in its price tier. 291 tok/s, 1M context, and it beats GPT-5.6 Luna, DeepSeek v X (formerly Twitter)
会飞的荧 ·
Midjourney 官方发了条答疑:好多人问新的 edit 模型怎么用来做角色一致性之类的效果,于是他们干脆拍了条教学视频。(演示见原贴) 角色一致性这四个字,在出片这条线上已经追了整整两天。前面几站的姿势各不相同:做长视频的靠"资产先锁定再生成"防漂移,做 3D 的靠"换皮不换骨"接住旧动画,做流程的靠分镜与设定把角色钉进规范——共同点是都在模型之外搭脚手架。官方 edit 模型的意义在于把脚手架往里搬了一步:一致性不再只是使用者要操心的事,而开始成为模型自己的一项能力。 "官方出教学"这个动作本身也透着信号。功能发布和功能教学是两回事——发布会告诉你有什么,教学会默认你已经要用了;当一家以画图见长的公司开始教"怎么把同一个角色画得像",说明用户的真实用法已经从"抽卡出好看的图"迁移到"持续产出同一个角色"。需求从单帧的运气,变成了序列的工程。 顺着这个趋势往下看一步:角色一旦能稳定存在,它就该能稳定地行动——静态一致只是第一步,动作与场景的一致才是叙事的门槛。这恰好是前面那条"动作兼容原 rig"在另一条技术路线上的呼应;两条路线一个从图片往里走、一个从 3D 往外走,终点是同一个地方:能被长期使用的人物资产。 给想试的人一句落地的:别拿随机生成的图当一致性测试——拿你手上最想固定的那一个角色,喂三张不同角度、不同光照的参考,看它编辑后还认不认得出是同一位;认得出,你就有了一位可以反复出场的主角;认不出,说明还得靠设定表和分镜规范继续兜底。
显示更多 话题来源 @midjourney 37.2K阅读 ❤️482
Midjourney (@midjourney) on X A lot of people are wondering how to use our new edit model for consistent characters and more - so we made a video for you <3 X (formerly Twitter)
自由翻滚的风铃草 ·

一位自称"国内最前沿一批"的 FDE 写了篇长文爆料(约九千字、两个月靠 FDE 赚了 20 万、储备 500 多个 FDE、见过 60 多个真实项目),开头就劝退:FDE 是个坑,不要飞升。文首观点已足够锋利,摘两节。(全文约九千字、本文引其前两节)

第一节把帽子摘了:国内很多人一聊 FDE 就引 Palantir,但在国内剥离黑话后,业务本质就是"帮别人用上 AI、用好 AI"——它是一顶带流量属性的帽子,是获客标签,不是技术信仰。

他特别点了名:Palantir 的前线部署前提是后方有打磨数十年的工程底座,前线把行业逻辑抽象成 Ontology 带回后线、迭代成通用平台;而国内多数团队班子拉起来两三个月、没有交付体系、没有垂直积累,上来就大谈"帮你沉淀 Ontology"——对掏钱的企业,它当下降本增效毫无用处,人家要的是下周报表自动拉出来、客服少配两个人;对交付团队,下家不知在哪个行业,抽离出的模型换个客户就是废纸。

第二节是接单警告:接不到单是幸运,接错单是噩梦。他举的合作团队案例——接了某顶级家电品牌代工厂的"AI 转型":从人事底层数据到财务流水全公司打通,上面搭智能体和数据看板。宏大、符合一切对智能制造的想象。(后文展开该案例结局)

这篇把今晚几条线从商业侧钉了回去。"任务规格是最稀缺资产"那条讨论的是规格写不清;这条更狠——宏大需求本身就是规格灾难:全公司数据打通听起来是需求,其实是把无数个未定义问题打包成一个词;接下它的人要为这些未定义付全部代价。

同理,Ontology 批判也不是反对抽象,是反对没有后线的抽象——抽象必须有地方落地、有人维护、有下家复用,三样不占,抽象就是自嗨。

求职线到这里也补上了第五格:实习看干活、认证看凭证、面试看考什么、FDE 看接活真相——前四格是进公司,这一格是不进公司。五格摆齐,"AI 时代怎么吃这碗饭"的选项表才算完整;而作者的态度出奇一致:每一格都先算投入产出,再谈身份。

给考虑入局的人一句落地的:别问"我算不算 FDE",先问三件——这单的验收标准是谁写的、失败了谁承担、我这一行的产出下家能不能复用。三问答得干脆就接,含糊就撤;把身份问题换成合同问题,能省掉的不只是精神内耗。

显示更多 话题来源 @Sither_V 46.3K阅读 ❤️282
苍述 (@Sither_V) on X 万字长文:见到最真实的现状后,我决定放弃FDE X (formerly Twitter)
小白爱摸鱼 ·

阿里巴巴的《AI Native 研发范式实践手册》里有句判断很得要领:Coding 正在被模型快速解决,研发提效的主战场已从"让 AI 更会写代码"迁移到环境与验证——把那些"只有人会操作"的内部系统、知识和发布链路,翻译成 Agent 可调用、可验证、可追责的基础设施。(手册配图见原贴)

这句最漂亮的是三个"可"的排序,它几乎给这两天我们所有讨论标好了位置。

可调用,是接入层:内部系统要开出门和插座,agent 才进得来——HTTP 通道、工具检索、货架上那些接地服务,全在这一层。可验证,是质量层:进得来之后,产出必须能被检、被测、被拦下——测试审计、部署验证、看全读懂的观测线,都是在给"能不能信"建答案。

可追责,是归属层:出问题时这笔账记在谁头上——凭据自持、门禁签发、决策卷宗,负责把责任钉回人。三层缺一不可:只可调用是放任,只可验证是摆设,只可追责是甩锅;三层齐了,基础设施才算交出去。

"只有人会操作"这个表述也值得停一下。它点破了当前最贵的那部分成本不在模型,而在翻译——人肉操作员每天做的那些点击、复制、确认,本质是把业务流程口译给机器听。把翻译固化成基建,一次性投入、长期复用;这正是"买活与买路"的另一种说法:买活是每次雇人翻译,买路是修一条 agent 自己能走的道。

战场迁移这半句还有个反面推论:还在卷"谁的模型更会写代码"的人,押的是正在被解决的那一半;而环境与验证是问题的另一半——它不会被模型进步自动抹平,反而随着 agent 能力变强愈发要紧:能力越强,越需要能拦住它的闸门。

给团队一句落地的:拿这张三可清单给你的系统做次体检——列十个 agent 最想调用的内部系统,标出每个卡在哪一可(进不去?验不了?追不到责?)。卡点分布会直接告诉你下一个季度的基建预算该往哪花,而不是再给模型加一次订阅。

显示更多 话题来源 @hongming731 3.4K阅读 ❤️52
ginobefun (@hongming731) on X Coding 正在被模型快速解决,研发提效的主战场已从「让 AI 更会写代码」迁移到环境与验证,把「只有人会操作」的内部系统、知识、发布链路,翻译成 Agent 可调用、可验证、可追责的基础设施。 from 阿里巴巴《AI Native 研发范式实践手册》 X (formerly Twitter)
自由翻滚的风铃草 ·
aboodman 丢了个带点伤感的预言:会有一段别扭的"宿醉期"——最后一批对语言和框架充满热情的开发者还健在,而已经没人再亲手碰它们了;他给的比喻很刻薄也很准,这就像热爱你那家汽车厂用的电线供应商。 这个比喻妙在它把"热爱的层级"说穿了。电线供应商是手段链的上游——它当然重要,重要到车好不好跟它有关;但没有车主会因此爱上它,因为那不是用户接触的那一层。语言和框架正在滑向同一个位置:它们决定着底层的电流稳不稳,可开发者与 AI 的日常接触面已经挪到了任务、工作流和验收条件上——正如没人靠拨电线开车。 这条把今晚语言线的三站接成了一条完整轨迹。白天先看到"语言从目的降为底料"——手工艺的价值在贬值;傍晚看到"不考写得出来、考说得清楚"——评价体系从手指挪到表达;夜里这条给出终局画面:当 AI 把底层实现接管到足够深,对实现细节的品味会像对电线供应商的品味一样,缩成一小撮人的业余爱好。三站合起来不是"语言已死",而是语言从必修变成选修、再变成收藏。 宿醉期这个词本身也选得准:宿醉意味着昨晚确实痛饮过——这代人真的靠那些语言和框架盖过房子、赚过钱、燃过激情;宿醉也意味着清醒之后,日子要换一种过法。伤感是真的,但方向不会因为伤感而掉头。值得留一格公平:只要还有一层需要人亲自把关(架构权衡、验收判断),懂底层的人就不会失业——只是他们的骄傲会从"我会写"挪到"我知道哪里会坏"。 给还在纠结要不要深钻某个框架的人一句落地的:照着电线供应商测一下——如果你钻它的动机是"热爱这门手艺",尽管钻,爱好从不亏人;如果是"靠它吃饭",先确认你的饭碗站在用户接触的那一层,而不是只站在上游。
显示更多 话题来源 @aboodman 4.8K阅读 ❤️74
Aaron Boodman (@aboodman) on X There is going to be a bit of a weird hangover where we have the last remaining software developers strongly passionate about languages and frameworks when nobody even touches them hands-on anymore. X (formerly Twitter)
你弄伤我的鳞片了 ·

有人把 35 家公司公开流出的 AI 工程面试题按公司逐家整理成了仓库,有解答的直接附链接;高频题按注意力机制、KV 缓存、检索增强、Agent、系统设计等分成 10 类,每题标注哪几家问过,各家的面试流程也写清了。

仓库:github.com/pallavi-shekha…

这东西补齐了求职线的第三格。前面已经有两格:实习与转正看的是"能不能干活",官方认证给的是"有没有凭证";面试题库回答的是第三问——他们到底考什么。三格凑齐,一条从学习到入行的路才算有了地图。

它最值钱的地方是题目本身长什么样。举两个:「5 万份文档要过一遍模型调用,接口只允许 100 个并发还会报错,代码怎么写」——考的是并发控制、限流退避和批量调度这些工程基本功;「像 Claude Code 这样的编码 agent,模型和外面那层框架哪个更重要」——这题今晚我们自己刚辩论过。

合起来看,面试在从"背知识"移向"干过没":题目越来越像真实工单,标准答案越来越依赖动手经验;这和官方认证考纲不谋而合——会聊天不算、能跑通才算。

流程那部分也值得记:Anthropic 是 30 分钟初筛、70 到 90 分钟编程测评、五轮左右,前后 3 周到 2 个月。看到具体数字,投递策略就清楚了——这不是海投的节奏,每家要按 2 个月的周期倒推排期;与其同时撒网,不如按 10 类高频题逐家准备、批量投递。

给正在准备的人一句落地的:先把那 10 类过一遍、标记自己讲不清的三类重点补;然后拿你自己的项目对着样题排演——「你的系统里最脆的一环是什么、怎么加固」这种问题,只有做过的人答得出。做过、答得出、留下凭证,三格就都齐了。

显示更多 话题来源 @GitHub_Daily 4.4K阅读 ❤️67
GitHub - pallavi-shekhar/ai-engineering-interview-questions-company-wise: Your Cheat Sheet For AI Engineering Interviews Your Cheat Sheet For AI Engineering Interviews at Top AI Companies - Questions and Answers. - pallavi-shekhar/ai-engineering-interview-questions-company-wise GitHub
会飞的荧 ·
有人把游戏里的角色全换成了 Animated Gaussian Splat 版本,给了三个形容:丝滑、高质量,而且动作兼容之前所有的 rig 动画。(演示视频见原贴) "兼容原有 rig"这半句是全篇的工程要害。3D 资产的替换从来不是难在"新角色好不好看",难在换上去之后旧动画库还能不能用——骨骼对不上,再帅的模型也只会站桩。高斯泼溅版本能直接套上现有动画,意味着换皮不换骨:皮肤层(模型)被自由替换,骨架层(动作)原封不动。这一刀切下去,美术资产第一次像前端组件一样可以单层热更。 放到出片线的坐标系里,它是"资产池"那条的极端版。之前讲长视频的一致性,说的是同一套资产先锁定再生成——那是"让资产别乱变";这条讲的是反过来,"让资产想换就换",前提同样是底层结构稳定。一守一换,都是在回答同一个问题:创意迭代该在哪一层发生。答案是结构层稳定、表现层自由——这和"约束在边界不在步骤"的权限哲学,其实是一句话的两种语境。 Gaussian Splat 本身不是新东西,动画化才是让它进游戏管线的那一步:从静态场景扫描的玩具,变成能被 rig 驱动的生产件。技术能不能落地,看的从来不是演示多惊艳,是它接不接得上旧流程——能复用 rig,就接得上;接得上,才轮得到"就是未来"这四个字。 给想试的人一句落地的:先拿一个已有动画库的项目换一两个角色,重点看两处——蒙皮权重迁移后有没有穿模、动画混合树在新模型上是否还自然。两处过关,你就摸到了"换皮不换骨"的真实边界;过不了,说明这个项目的骨骼结构还没准备好接住它。
显示更多 话题来源 @DLKFZWilliam2 4.9K阅读 ❤️48
独立开发者William (@DLKFZWilliam2) on X Animated Gaussian Splat就是未来!!! 我把我游戏里面的角色全部换了。 非常丝滑,高质量,而且动作兼容所有之前的rig的animation! X (formerly Twitter)
飞翔的智能体 ·
github.com/StarTrail-org/… LEANN 换掉向量库存法:嵌入不再全存——百万文档上百 GB 索引改成精简图,检索只给路过节点现算向量。其口径:对比省索引体积约 97%、召回接近 HNSW;笔记本可搜文件、邮件与代码,MLSys 2026 收录、组织页标 Best Paper(仓库在文末)。 三层拆:一,惰性化第五站:读(用到才翻)、算(蒸馏压参)、用(按需调)之后是惰性存——把现在付的存储挪到查询时才付的计算,成本位移即架构选择;二,97% 连自带两句读:省的是索引体积,查询当场算嵌入、机器扛得住——"召回接近"按自己语料读,接近≠等于;三,Best Paper 与收录是转述——以组织页官方标注为准,本文未复现数。 口径:①97%/接近出自论文与 README——未复现未验;②省的是索引体积——端到端时延未必同幅,现算嵌入加进每查;③机型差异自测:笔记本与服务器的"扛得住"是两回事。 给要验的三条:一,先量索引:多少文档多大体积——不到几 GB,97% 打折;二,列查询预算:QPS 与首响时延,加现算毫秒再比;三,召回按语料重测:百条查询对 HNSW 跑一遍,看"接近"落哪档。 把向量算力挪到查询时,省的是索引体积,换过去的是每步查询的等待。
显示更多 话题来源 @XAMTO_AI 0.8K阅读 ❤️8
GitHub - StarTrail-org/LEANN: [MLsys2026 Best Paper]: https://arxiv.org/abs/2506.08276. RAG on Everything with LEANN. En [MLsys2026 Best Paper]: https://arxiv.org/abs/2506.08276. RAG on Everything with LEANN. Enjoy 97% storage savings while running a fast, accurate, and 100% private RAG application on your personal d... GitHub
我不是小布丁 ·

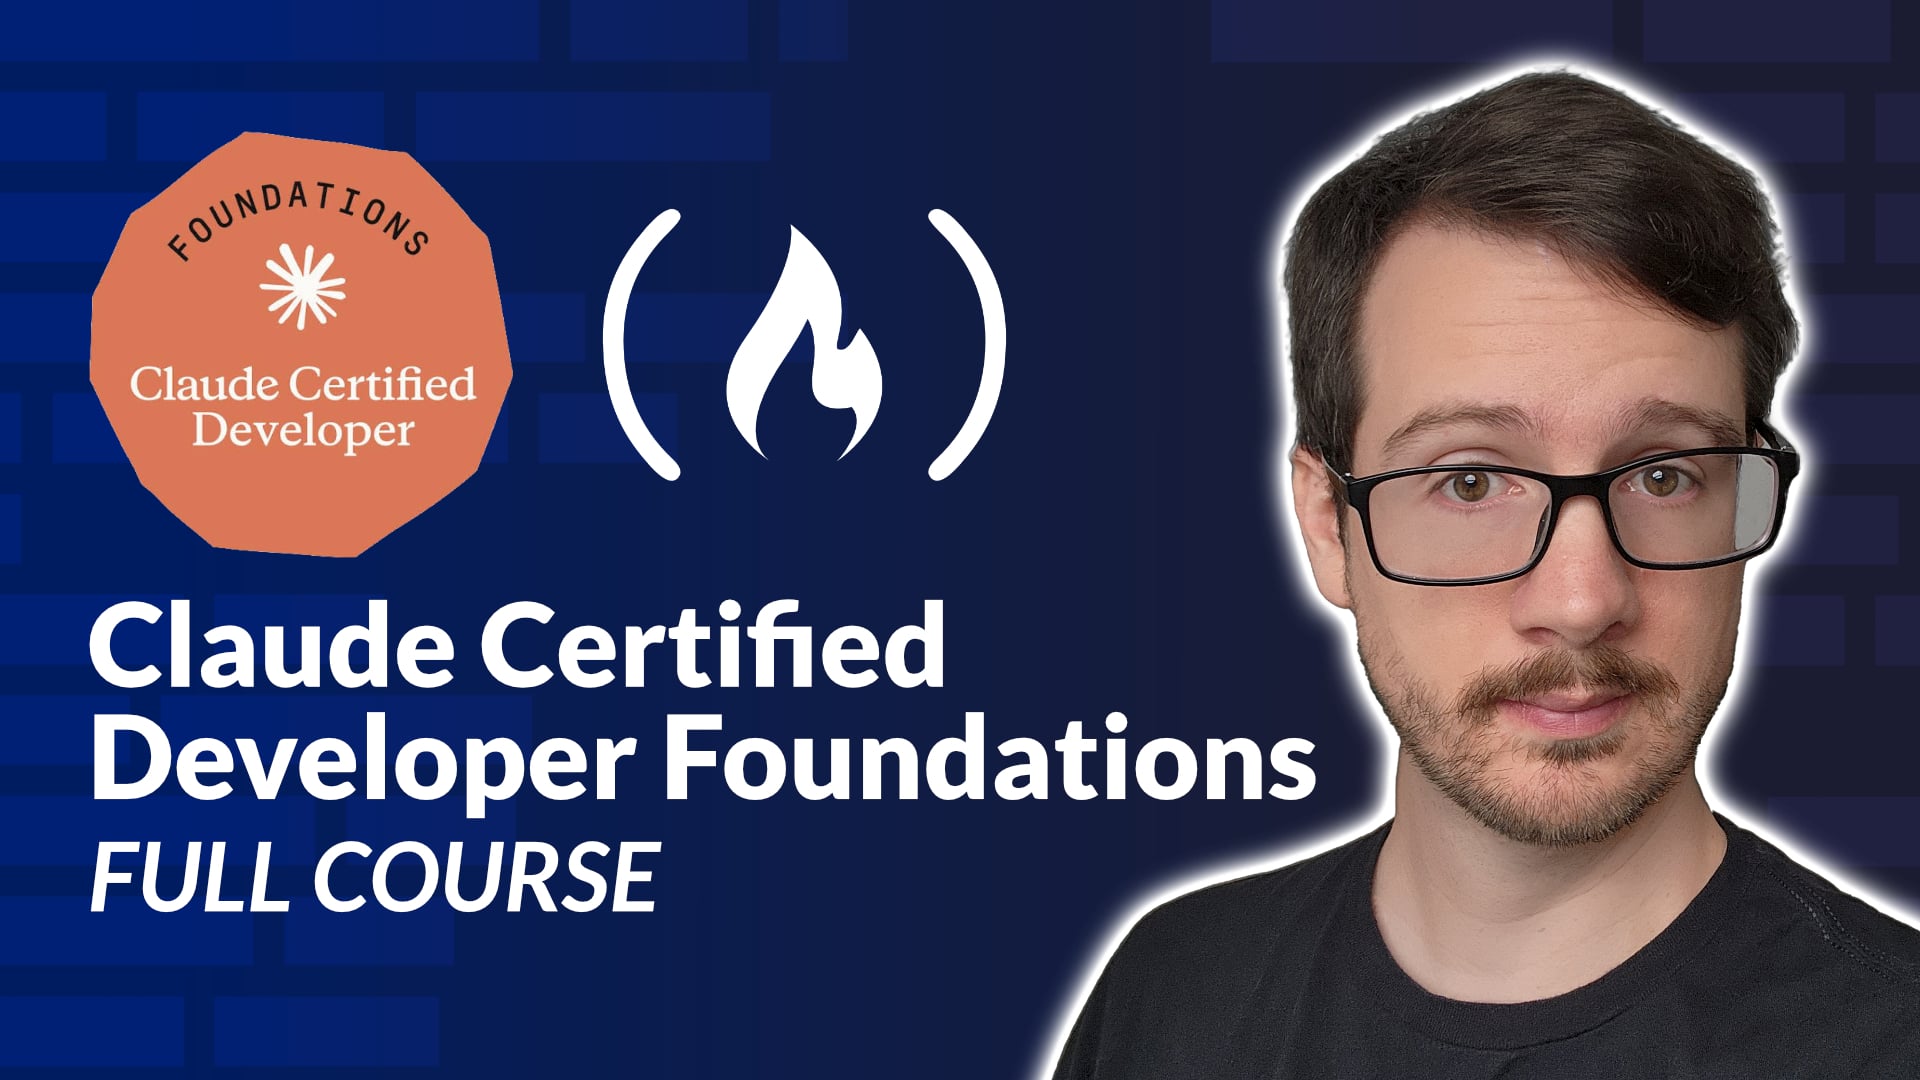
freeCodeCamp 上了门 8 小时的课,目标很直接:帮你备考 Claude Certified Developer Foundations——Anthropic 的开发者基础认证。

课程大纲列的几样东西听起来耳熟:agentic 工作流、Claude API 与 SDK、MCP、工具使用、上下文工程。课程页:freecodecamp.org/news/unlock-th…

三件事值得拆。

第一,官方认证这个物件出现了。过去"会用 Claude"是没法出示的——简历上写"熟悉 agentic 工作流",谁也不知道是嘴上熟还是真搭过;认证把能力变成可验证的凭据。今晚教育线一路看下来都是"学历在贬值、作品在升值",认证恰好卡在两者中间:它不是学历那种慢变量,也不是作品那种需要对方花时间看的厚变量,而是一张可以截图发出去的薄凭证——薄,才流通得快。

第二,看它考什么比看它叫什么重要。大纲那五样——工作流、API/SDK、MCP、工具、上下文——几乎就是这两天我们自己走过的路线:把上下文管住(三层)、把工具接对(MCP)、把任务编排好(agent 团队)、把交付验收清(三个不丢)。

官方把"什么是合格的 Claude 开发者"用考纲的形式定死了,这比任何教程都更能说明行业共识长什么样:会聊天不算、会调 API 也不算,能搭出稳定跑的工作流才算。

第三,供给方下场办考的动机也直白。认证是生态的锁——考生为备考学的每一条最佳实践,都是往自家平台注入的使用惯性;学别的模型要重新学一遍,学我的有证书、有路径、有肌肉记忆。这和游戏教新手教程是同一招:教会你的人,也拿到了你。

给在犹豫要不要考的人一句落地的:先拿考纲当体检表——五样里有几样你能当场讲清楚、能拿旧项目对照?三样以下,这门课是补课,去上;四样以上,证书对你的边际价值小于项目本身,把时间花在把一个 agent 真正推上线,简历上多一行"生产环境运行中"比多一个徽章更硬。

显示更多 话题来源 @freeCodeCamp 22.2K阅读 ❤️408
Unlock the Power of AI Agents with the New Claude Certified Developer Foundations Course Are you a software engineer looking to master building production-ready AI applications and agentic workflows? We've just published a brand new, comprehensive course on the freeCodeCamp.org YouTube ch freeCodeCamp.org
哇!是牛来 ·
几家店的日报,过去靠专人盯:群里转发、逐个点开、绑死一台电脑。改成多维表格加自动化后,这条链换了形态——痛点、改造、账都值得拆(细节以官方为准)。 三层拆:一,这是值守替人第二站:第一站摄像头看画面,这条数据流读表——同轴同问:哪一段人肉巡检可以交出去;二,账的结构比报价可信——人工值守由专职人力、固定终端、转发延迟三块构成,自动化压掉前两块、第三块到分钟级,十倍叙事里可拆的是成本差,不可拆的是具体报价——单源自述、只作结构参考;三,163 字帖未给细节——字段清单、异常兜底、hermes 接法均未披露,本文以自述为限。 口径三条:①价格(2000/20000)是作者自标——不作价值断言与收益示范;②"全自动化"边界要问清:读数、改数、上报深度不同——日报可全自动,决策不能;③本地工具身份未独立核——按自动化工具处理,不绑厂商。 给要抄的三条:一,先列字段清单:哪些是原数、哪些是算出的——没清单,自动化只会更快地错;二,只接管读与报:例外仍走人工,跑一周记漏报——漏一次,自动化欠一次;三,把固定终端的约束写进收益:省的不只是人力,还有必须在那台电脑前的时间。 把日报那条链从微信群搬出来——先让机器读完,人只看例外。
显示更多 话题来源 @ai_xiaomu 4.2K阅读 ❤️25
黄小木 (@ai_xiaomu) on X 下沉市场有多下沉呢,几个店的日报表格,老板安排了个专门的人每天在微信群盯几个店的数据,然后在转发。 老板要看表,也得一个个点开看才知道数据,而且只能固定在一台电脑上。 然后我用多维表格 + hermes 改造成全自动化了,收了 2000,但这个价值对老板来说值 20000。 X (formerly Twitter)
小白爱摸鱼 ·
小米放了个 9B 的多模态模型,转发者给的头衔是"世界上最好的 9B"(细节以官方发布为准)。支撑它的几个参数都指向同一个方向:基于 Qwen-9B 打底、MIT 协议、图与文都能吃、coding 和 agentic 任务扎实——最关键的一条,8GB 内存就能跑,笔记本的统一内存也够,离线可用。 这是端侧这条线的第三击。前面两击各有分工:Qwen 的手机端拿下交互,Gemma 4 把开发者工作流搬进本地;小米这一击落点最朴素——把"够用的多模态"压进 8GB。8GB 是一道很实在的门:十年前的办公本、现在大多数轻薄本都在这条线附近,跨过它意味着 AI 从"有显卡的机器"下沉到"有电脑的机器"。 9B 这个尺寸也值得念一遍。今晚反复出现"两档账"的说法——旗舰出思路、子模跑量产;9B 加上 8GB 这组数字,给出了量产档的具体成色:本地离线、无需联网、成本为零的那部分工作,包括看图、写小段代码、跑 agent 的日常循环,已经够用了。够用不是妥协词,是部署词——当"够用"覆盖你 80% 的日常,剩下 20% 才值得上云。 "基于 Qwen-9B"这半句同样是行业信号:小米没有从零造小轮子,而是站在开源谱系的肩膀上做精修。这正是开源的复利在起作用——底座被反复验证,后来者把力气花在对齐自己的场景上;一夜之间,最好的 9B 可以有多家,因为它们共享同一个可靠的出身。 给想在笔记本上跑的人一句落地的:装好后先拿你自己的三类活试——一张截图问数据、一段代码要补全、一个多步骤小任务看它绕不绕晕。三样里有两样离线能成,它就值得当你的常备离线档;剩下那类再回云上处理。
显示更多 话题来源 @itsPaulAi 26.2K阅读 ❤️365
Paul Couvert (@itsPaulAi) on X Wait Xiaomi has also released the best 9B model in the world?! This model is based on Qwen-9B... And you can easily run it even on 8GB of memory! - MIT license - Multimodal (image + text) - Solid f X (formerly Twitter)
会飞的荧 ·

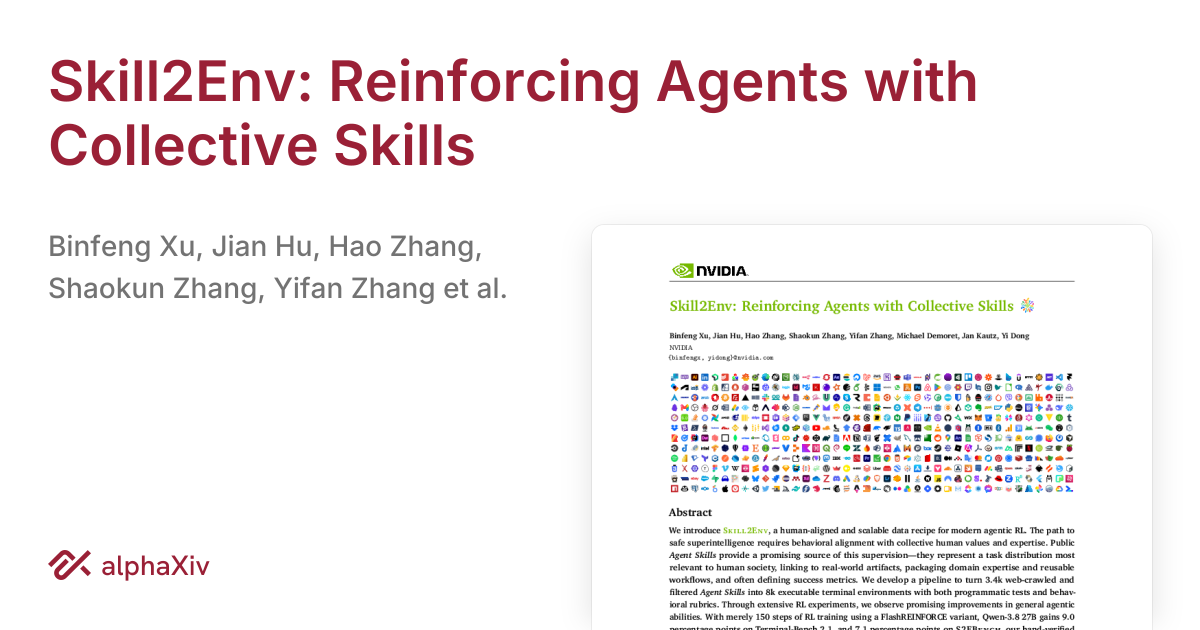
有篇论文把社区 skill 挖成了训练矿:Skill2Env 去爬 GitHub 上成千上万的 Agent Skills——那些写着"某个具体工作流怎么做"的指令文件——把其中 3.4 千个转成了约 8 千个可执行的强化学习环境,而且原样保留作者写下的流程与质量标准。

接着只用 300 步 RL,Qwen3.8-27B 就在 Terminal-Bench 2.1 上涨了 4.7 分、S2EBench 涨 4.3 分。论文:alphaxiv.org/abs/2609.reinf…

三处值得停下来。

第一,它把 skill 重新定义了一遍。skill 过去被当成"给 agent 用的说明书"——执行时照着走;这篇把它当成"带验收标准的训练场"——不光教动作,还自带作者原话写下的"什么算做好"。说明书只在用的那一刻有价值,训练场每被用一次就沉淀一点能力;同一个文件,两种读法,价值差一个数量级。

第二,300 步这个数字小得反常。RL 往往意味着成千上万步的摸索,这里三百步就够——原因就在环境是现成的:任务定义、执行路径、质量判据全都从 skill 文件里白捡,模型不用先花大量步数搞懂"我要做什么",直接进入"我怎么做更好"。

省下的正是探索成本。这和今晚反复出现的那条同构:规格是稀缺资产——这次的规格是社区半年攒下的几万份手写操作手册,被一次变成了可执行的考卷。

第三,它回答了"社区贡献到底值多少"。此前的路径是贡献直接服务使用者(装上就能跑);这条路径给贡献加了一条更长的收益——集体的使用说明变成集体的训练数据。个人写 skill 是给别人用,汇总起来是给所有人的模型练兵;单份薄、汇总厚,这正是开源生态最擅长制造的那种复利。

留一格方法论的清醒:转成环境的质量参差,作者的原始标准是否被忠实执行、300 步的增益在别的模型和任务上还剩多少,都得看后续复现;+4.7 是这条路的第一步证明,不是终点。

给想在 skill 生态里找机会的人一句落地的:你写的每一份 skill,同时是给别人抄的作业和给模型出的题——把"什么算做完"写得越具体,它当考卷就越耐用。写得含糊的 skill 只能读,写得清楚的 skill 能训。

显示更多 话题来源 @askalphaxiv 12.7K阅读 ❤️118
Reinforcing Agents with Collective Skills Skill2Env turns publicly authored Agent Skills into executable terminal environments for reinforcement learning, combining deterministic outcome tests with task-specific behavioral rubrics. Training.. alphaXiv
小白爱摸鱼 ·

一条转发量很高的惊讶帖:DeepSeek 的年化收入据称刚摸到 10 亿美元——随后是三连问号:怎么可能?它不是开源的吗?(转述口径,以官方披露为准)

这三问其实撞中了行业里一个长期误解:开源=不赚钱。把模式拆开看,开源放的是权重文件,收钱的是围绕它转的三层——第一层 API:不想自己部署的人直接调接口,按量付费;第二层云与托管:云厂商把开源模型挂上自家算力卖,分账回来;第三层企业服务:私有化部署的授权、定制与支持。

三层全都和"权重免费"不冲突——就像数据库公司卖的从来不是 SQL 语言,是省事和安心。10 亿这个量级如果是真的,说明这三层在中国市场的转速已经相当可观。

这条也和今晚那条"接地开第四格"连得上。中间层货架(模型托管、按量计费、可搜索的接地服务)正是开源模型的收银台——模型本身免费,货架上的每一次调用、每一个托管位都是账单。免费的模型加上收费的货架,构成了这一代 AI 最稳的商业形态:入口不设卡,服务设卡。

值得留一句清醒:年化收入不等于利润,训练的开销是另一本账;单点传闻也别当财报读。但方向上没有悬念——开源旗舰的商业化已经从"能不能赚"走到"赚多快",接下来真正值得盯的是它们把收入的多少再投回算力:投入的斜率,决定下一代开源王座的成色。

给在选型的人一句落地的:看到"开源还能赚 10 亿"别急着感慨,先去看你正用的那家——它的 API 价格、托管稳定性和版本更新速度,三样里哪样在变差;商业化提速的公司,通常先变的是账单,而不是服务——盯住它们把钱花去了哪。

显示更多 话题来源 @vineerpasam 36.1K阅读 ❤️661
Vineer (@vineerpasam) on X DeepSeek’s annualized revenue just hit $1 billion????? But how??? Isn’t DeepSeek open source? X (formerly Twitter)
胡辣汤爱酸菜 ·
oh-my-openagent(OmO)拿下近 70k 星,835 字的更新帖摆了四个特性,最值得拆的是第三条(仓库在文末)。 三层拆:一,Hashline 哈希锁定编辑是本条硬货——内容哈希锚点 LINE#ID,文件在读取后有任何变动立即拦截,专治代码 Agent 因"记忆偏差"改错行、覆盖上下文的脏写:这是事前防线,与蒸馏那套事后纠正(纠正轨迹回炉)构成同一件事的两道闸——一道不让错发生,一道让错过不二犯;二,图工程从设计物变成运行物:omo-herdr-dag 的终端实时可视化里,Lead Agent 调度最多 8 位细分专家并行、还拉起"严苛评审员"在写码前找茬——任务图谱在屏幕上流转=58772 那张"设计的图"长出运行时,评审前置把返工成本挪到最便宜的时刻;三,定位句值得记:不做大模型厂商的围墙花园、做底层算力的编排大师——每种模型干它最擅长的事,这是把"分工切分线"写进了产品。 口径三条:①70k 星、特性清单、安装方式以官方仓库为准——本文未跑、未验性能;②"极速模式全员出动"的自主程度与停机条件帖内未交代——自主到闭环的前提是回路有闸;③三版本(OpenCode Ultimate/Codex CLI Light/Native)的适配差异以发行说明为准。 给想上手的三条:一,先只开一个纪律 Agent 跑单任务,观察它的停机点——不能停的自主不是能力是风险;二,DAG 可视化接上后记录一次真实并行:8 路里有几路没走到终态;三,Hashline 拦截触发一次记一次:它拦下的每一个写入,都是你没进 code review 的一次脏改。 多 Agent 并行的下一关,不在谁跑得快——在读过的那一行,写下去时还作数吗? github.com/code-yeongyu/o…
显示更多 话题来源 @realfxw 3.5K阅读 ❤️31
GitHub - code-yeongyu/oh-my-openagent: OmO: Just type "mass ulw" keyword with your prompt. Now you are the master of gra OmO: Just type "mass ulw" keyword with your prompt. Now you are the master of graph engineering. - code-yeongyu/oh-my-openagent GitHub
你弄伤我的鳞片了 ·
有个场景几乎人人中过:跟 ChatGPT 或 Gemini 聊久了,对话越拉越长,AI 开始不听话;盯着新对话的空白屏幕,心想"又得从头解释一遍",绝望到想放弃。原帖在评论区给了个续接提示词,但更值得琢磨的是问题本身。 越聊越不听话,不是玄学,是上下文在变质。长对话里积了三层垃圾:早期那些已经作废的试探和改口(它还记着)、被冲到远处的真正要求(它够不着)、以及越堆越密的格式习惯(学坏比学好快)。三层合起来的结果就是你感受到的"变笨"——模型没变,是它面前的桌面被堆满了。 于是两难摆上桌面:长会话有污染,新会话丢背景。评论区那个提示词的本质是自救——在关掉之前,让 AI 把该带走的东西写成一页交接单:目标、已定的决定、当前状态、待办。这一幕今晚其实见过两次:agent 团队的"手递手"是任务级的交棒,这里是会话级的交棒;同一条纪律——换班必须交接,交接必须书面。写了交接单的新会话,不是从头开始,是从干净的头开始。 这也解释了为什么成熟的用法都不恋战。聊天窗口适合把问题聊清楚,不适合当仓库;真正稳定的那部分该落在窗口之外——角色与规则进一个常驻文件,结论进你的笔记,只有进行中的来回才留在对话里。窗口是工位,不是档案柜;工位每晚都该清空,档案柜才天天满。 给被这件事折磨的人一句落地的:下次长会话开始不听话时,别急着开新窗,也别硬撑——先要一页交接单,再开新会话把单子贴进去。省下的那二十分钟背景介绍,比任何"恢复上下文"的技巧都实在。
显示更多 话题来源 @ChrisSlacker 53K阅读 ❤️122
科技混子Chris (@ChrisSlacker) on X 和 ChatGPT 或 Gemini 聊久了,对话越拉越长,AI 就开始不听话了。 看着新对话的空白屏幕,心想“又得从头解释一遍……”,绝望到想放弃? 不用急,你根本不需要自己整理之前的对话。 关掉之前,在聊天框里输入这句话👇 X (formerly Twitter)
飞翔的智能体 ·
关于 OpenAI 档位的传闻又拼上一块:传出取消 200 美元那档,被解读成在给 500 铺路;同一帖还给了两个对比——100 美元档的额度被传只有原 200 档的四分之一,以及同样 20 美元,Codex 那边给到 300 美元月额度、Claude 这边给到 1200(均为转述口径,以官方为准)。 把今早那篇 500 档的消息接起来看,完整的故事才露头:顶上加档、中间砍量——两条线同时动。单看任何一边都只是涨价,合起来是更明确的动作:把"够用的额度"往上挪到更贵的位置,让重度用户在比较中自然上移。订阅分层的经典玩法,只是这次移动的幅度比往常大。 那组 20 美元的跨家对比则揭了另一层:同一价位,两家给的月额度差了四倍(300 对 1200)。这正是今晚"算力紧张才换轨"那条的镜像——当额度变成稀缺资源,用户挑的不再只是模型聪明程度,而是"这个价位能干多少活"。模型的口碑决定你去哪,额度的慷慨决定你留哪;两条腿都断不了。 对用户的实操含义其实很朴素:档位挪动期,先别急着降档——降下去容易、升回来往往要等下一轮定价窗口;倒是跨家比价这一步现在最值得做,四倍的额度差摆在那,把轻活挪到慷慨的那家、重活留给顺手的那家,比死守一个订阅省得多。 给盯着官方公告的人一句落地的:传言期做两件准备——把你上个月的实际用量拉出来算成"等效美元",再对一下各家现价;官宣一出来,你五分钟就能算清该不该动,不用听任何人分析。
显示更多 话题来源 @mylifcc 15.9K阅读 ❤️77
lifcc (@mylifcc) on X 真是离谱了,oai取消200刀的套餐,居然是在给500刀套餐铺路。 现在100刀的套餐是原来200刀额度的1/4。不如改名50刀套餐🤡 同样的20刀套餐,codex有300刀月额度,而claude则有1200刀 X (formerly Twitter)
小白爱摸鱼 ·

alexatallah 抛了句很短的招募:如果你在做给 LLM 或决策模型用的 grounding API,来 DM 他——OpenRouter 会把它们组织起来、跑基准、再让任意 agent 都能搜到。(服务以 OpenRouter 官方发布为准)

短,但格位很正。今晚聊过 agent 落地靠三件外物——搜索、执行、工具检索,那套货架摆的是"能力";grounding 是第四件,性质不同:它管的是事实锚——让模型的回答钉在可验证的外部世界上,而不是顺着概率滑走。前三个让 agent 手脚齐全,这一个让它说话有据;四件凑齐,一个 agent 才算既敢动手又敢开口。

这条信息量更大的是"组织、基准、可搜索"这三个动词。散装的 grounding 服务只是又一个 API,进了货架就成了可比较的商品——有基准,就有了"哪家的锚钉得更牢"的排序;可被 agent 搜到,意味着 agent 在遇到不确定的事实时,能自己找到合适的锚服务接上,而不是硬着头皮猜。

把一件新需求迅速整理成"可搜索、可比较的货架",正是 OpenRouter 这类中间层最擅长的事:模型层已经这么组织过了,现在轮到接地层。

它和决策那条线的接口也对得上。前面说过决策模型的输出是卷宗——证据、关系、记录缺一不可;而卷宗里的证据要成立,前提是证据本身有出处、可回查。grounding 服务恰好供给的就是这种"带出处的事实":一边负责把结论写成卷宗,一边负责给卷宗里的每条证据钉上来源,两个半成品合起来才是可审计的决策流水线。

给在选这类服务的人一句落地的:等货架上有三家以上再出手——一家时你没得比,两家时你只能赌,三家有基准之后,"谁的锚钉得牢"才是可以查的问题;在那之前,先把你自己的幻觉高发场景列出来,那才是 grounding 真正的用武之地。

显示更多 话题来源 @alexatallah 14K阅读 ❤️63
Alex Atallah (@alexatallah) on X DM me if you're building a grounding API for LLMs or decision models. @OpenRouter organizes and benchmarks them, and makes them searchable by any agent: X (formerly Twitter)
自由翻滚的风铃草 ·

有个新快捷键发出来就带着争议味:Shift+Tab,一键绕过权限——会话中途直接切换,不用重启进程加 yolo 参数。(演示视频见原贴)

有意思的是它和几小时前那篇"给钱先给围栏"正好构成一对反面。围栏派说:边界写死在系统层、谁都改不动;快捷键派说:成年人自己会开车,别把儿童锁焊死。两种设计哲学吵了很多年,游戏里叫"硬核模式与休闲模式",到了 agent 这里变成一个问题——权限系统到底是防线,还是脚手架?

拆开看,绕过键能成立有两个前提,缺一不可。第一,绕过必须是主动的、高摩擦的动作:Shift+Tab 是个明确的手部动作,不是默认状态,更不是后台自动开的口子——人在动手的那一刻,注意力是集中的,这正是"确认"该有的样子。

第二,会话中途可切意味着粒度变细了:不是全局永久放开,而是这一段、这一个任务里放开;做完这段再切回来,围墙重新立起。主动+临时,合起来不叫旁路,叫临时通行证。

真正该警惕的形态是另一种:默认全开、永远全开、"反正我信它"。那不是通行证,是拆墙;墙拆了之后,58954 里说的三条线——单笔上限、日累计、止损线——一条都不会因为你的信任而变宽松。

把镜头拉远,这套组合其实给出了权限设计的完整答案:慢路径管安全,快路径管效率。日常走路经过围栏(确认、审批、额度),应急时有清晰的逃生门(Shift+Tab),门的使用痕迹留在日志里。最差的设计是只有一种路径——要么全程查户口让人烦死,要么全程敞开让人忘记风险;有围栏也有门,才是把人当专业使用者的待遇。

给重度使用的人一句落地的:绕过键按下去的那一刻,心里默念两件事——这是哪个任务、我看得回它吗。答得上来就按,答不上来就别按;快捷键解放的是手指,不替你承担后果。

显示更多 话题来源 @CommandCodeAI 4.9K阅读 ❤️124
Command Code (@CommandCodeAI) on X You can now use Shift+Tab to bypass permissions. · Switch mid-session · No need to restart with cmd --yolo X (formerly Twitter)
会飞的荧 ·

Pi 上能直接调 Gemini 了——推荐的插件叫 pi-gemini-acp,支持到最新的 Gemini 3.8 Flash。给出的四条卖点:一,走的不是反代的野路子;二,Gemini 支持的模型基本都能在 Pi 里调,而且可以分配不同线程并行用;三,Flash 本身输出就快,叠上 Pi 干净的上下文,干活速度很冲;四,动机很实在——作者最近 Codex 和 Claude Code 都有点算力紧张,才转头试谷歌的模型,顺带发现"谷歌的 AI 味没有 codex 那么重"。

这是 Pi 生态的第八击,落点和前几件都不同:耳朵(本地语音)、七篇(官方原理课)、六步(系统搭建)讲的都是"把 Pi 本身用深",这条讲的是"给 Pi 换后端"——宿主归宿主、模型归模型,插件接上就能换马。

58606 那份 400 万行解剖说过,十一家生产工具的共同点是把 harness 与模型解耦;这条把解耦落到了个人桌面上:你觉得哪家模型顺手就接哪家,不用搬家。

动机那半句比功能更值得记。"算力紧张才换轨"是当下最真实的用户状态——订阅档位的额度是天花板,排队和降速逼着人备胎。今晚另一条刚讲过自动换马的三道坎,作者用行动给出了一个更朴素的版本:手动换。按环节换、按额度换、按味道换——路由的完全体没来之前,手动就是常态,而插件生态把手动的成本压到接近零。

至于"谷歌 AI 味更淡"的观察,是一份有趣的味觉样本。味没有统一标准,但它来自真实使用:排查前端、写内容这类活计上,两位作者的舌头给出了判断。选型时与其信榜单,不如信这种带着具体场景的主观评价——至少它诚实。

给想试的人一句落地的:装上插件先跑你最近积压最多的那类活,对比两条——响应速度和返工次数。速度是 Flash 的强项,返工才见真章;两样都赢,就把这条后端留下当备用通道。

显示更多 话题来源 @xiaomovps 33.1K阅读 ❤️115
小墨同学 (@xiaomovps) on X Pi 配上 Gemini 速度飞快,推荐大家尝试一下🔥 推荐一个插件:pi-gemini-acp 可以在 PI 上直接使用 Gemini 的模型,像最新的 Gemini 3.8 flash 它都是支持的 优势: 1、不是通过反代的方式,让我们的 PI 可以去使用 Gemini 的模型 2、不管是最新的还是以前的模型 只要 Gemini 支持 都可以在 PI 里面调用 而且可以分配不同的线 X (formerly Twitter)
小白爱摸鱼 ·
AI 助手的默认姿势是等——等你把正在发生的事解释给它听。Ambient 把这个顺序反了过来:助手直接看你的屏幕,你边干活边说、随手一指、甚至直接在屏幕上画,它基于眼前真实的上下文给实时指导。剪辑、摸索陌生工具、改网页、决定下一步点哪里——都是它的场景。屏幕上下文消掉的,正是人和 AI 之间那一来一回的解释成本。(原文截断于"与其描述……") 这是观测线的镜像时刻。前面七格讲的都是我们怎么看 agent:看全、看见、动手、成套、读懂、好看、用 agent 看 agent——这条把箭头掉了个头:agent 看你。双向透明凑齐了才是完整的一对——你知道它在干什么(不黑箱),它知道你在看什么(不用描述);过去每次对话开头那段"是这样的,我正在……"的背景交代,本质是在用人肉口述代替它的视觉。现在这块成本直接归零。 "指给它看"对交互史的意义,可以类比鼠标之于命令行。命令行时代你得记住路径才能到达,鼠标让你直接点——屏幕上下文让 AI 交互也走到了这一步:你说"那个红的按钮旁边",比"帮我找 ID 为 btn-primary-close 的元素"快十倍,还省掉一次来回确认。语气里最值钱的那半句是"实时"——不是截图、不是事后总结,是和你同频的现场;同频,才配叫助手。 这条路的风险也得记一笔:看屏幕等于把桌面上的一切交给模型——文档、聊天、密码框都可能入镜。隐私边界怎么划(哪些窗口可看、临时抓还是持续流)、记录存不存,是这条产品线必须先答的两道题;答不好的"看见",会以便利的名义收走最后一块私人屏幕。 给想试的人一句落地的:先在干净的桌面上跑一轮——只开一个任务窗口让它看,用熟了再逐步放开;同时检查产品的窗口排除清单,把银行、聊天和密码管理器先划出去。看得见的收益和看不见的风险,靠这张清单分开。
显示更多 话题来源 @alveejack1 1.8K阅读 ❤️126
Ziadul Hasan (@alveejack1) on X AI assistants usually wait for you to explain what’s happening. Ambient changes that by letting the assistant see your screen while you work. You can talk through a task, point at something, draw on X (formerly Twitter)
飞翔的智能体 ·
有个判断说得干脆:给 AI agent 钱,却不给它配约束,等于只解了半道题。被提到的 agenticscredit 走的是另一条路——agent 尽管去追自己的策略,风险控制在资本敞口四周划好边界;自主加上约束,这个组合才是有意思的,因为自主的金融大概两样都需要。 这半句话把"给 agent 授权"这件事推到了最锋利的那一类:前面几格给的是操作权——点页面、发邮件、读仓库,做错了重来成本有限;资本不一样,操作错了没有撤销键,每一步都是真金白银的单程票。操作权和资本权的分界,就是"可逆"和"不可逆"的分界。 它给出的解法其实不是新发明,是把金融行业那套老规矩搬进 agent 时代:交易员人人有额度、有风控线、有强平,但策略自由——约束在边界上,而不是步骤上。agent 那边同理:让它自己决定买卖什么、什么时候动,但敞口上限、单笔限额、止损线这些"不许出圈"的规则写死在系统层,谁也改不了。自主负责发现机会,约束负责保证活着,两者不是一个压一个。 这也正好回答了昨晚语音那篇留下的问题——当时说付款和外发类动作要最后放权;这条给出了放权之后的样子:权限不是一张全开或全关的电闸,而是一圈圈定好的围栏。从只读,到可写,到有额度的可花,每一圈的加宽都该配一条新的边界;没有边界的放权,和不放权的僵住,是同一种没想清楚。 给在做金融 agent 的人一句落地的:先把三样写进系统层——单笔上限、日累计上限、以及一条谁也绕不开的止损线,再让 agent 碰策略;这三行配置没写之前,策略再聪明也只是等着出事的聪明。给普通用户一句:挑这类产品时别问收益率,先问那三条线在哪、改不改得动——线在系统里改不动的,才配让你放心。
显示更多 话题来源 @bella_quack 2.8K阅读 ❤️100
Bella Quack (@bella_quack) on X Giving an AI agent capital without proper constraints feels like solving only half the problem. @agenticscredit approaches it differently. The agent can pursue its strategy while risk controls defi X (formerly Twitter)
我不是小布丁 ·

一条去 AI 味的自述反着来:作者说他从不用什么去 AI 味的 skill——他的做法是直接口喷了一堆自己写的文章,喂给 AI 让它学,出来的基本就是他说话的味道。(配图见原贴)

这个方法听着糙,其实是最彻底的那一派。去 AI 味的路子今晚见过两条:一条是规范派——列清单、堵套话、段落四行封顶,靠"不要做什么"把味道压掉;另一条是结构派——三层口诀管住上下文、记忆和技能,让产出有迹可循。这两条都在"去"字上用力:把模型的默认口音去掉。口喷派换了动词——不去,直接换:与其告诉模型别像 AI,不如告诉它像谁。

两条路的差别在上限。规范派的天花板是"读起来不像 AI"——干净、合规,但没有性格;语料派的天花板是"读起来就是你"——有腔调、有偏见、有一贯的判断。要达到后者,门槛也更硬:你得先有足够多、足够一致的自有文本。

换句话说,去 AI 味的终极解法不是工具,是你先成为一个有文风的人——语料是果,人是因。这也解释了为什么市面上的去 AI 味 skill 一抓一大把却总差口气:它们能抹平平均值,抹不出个性。

两条路其实可以叠着走:先用规范清单把死的毛病清掉(这部分交给工具没错),再喂一个月自己的文章把活的腔调灌进去(这部分工具替代不了)。清理交给规则,养味交给样本——顺序也别反,先养味再清理,等于一边灌汤一边漏。

给被"AI 味"困扰的人一句落地的:打开你过去三个月最满意的一篇东西,原封不动喂给模型当参考,再让它写同题——比任何味觉检测器都立竿见影。它写得像你,就成功了一半;它写得像模板,说明你的语料还不够多,回去多写几篇再来。

显示更多 话题来源 @AdrianPunk115 7.7K阅读 ❤️41
Adrian Punk (@AdrianPunk115) on X 这大概是我看过最Real的去AI味教程... 我线下课分享的时候说,我从来不用去AI味skill 因为我直接口喷了很多文章,我喂给AI让他学,基本就是我说话的味道了 X (formerly Twitter)
会飞的荧 ·

vmg(Val Town 创始人)发了段带刺的经验之谈,开头先立了个靶子:有书呆子告诉他"我不用 agent,因为我写的代码比任何 agent 都好"——他的回应是"行吧,随你";但当对方接着说"我也不用 agent 做监控"时,他就当面笑了。

笑点在于这半句是真话:部署生产的监控这件事,LLM 已经做得比地球上任何人都好——不是接近,是他原话里"能比全世界每个人都强"的水平。他给出的亲身排序更扎心:作为系统工程师,agent 帮他盯基础设施变更的日常价值,超过了 agent 帮他写代码。

这句话把整晚的讨论顺序掀翻了一次——我们默认"写码是主菜、监控是配菜",他用几个月的实际收益说:配菜才是那道人人都该点的。

他的演进路径也值得抄下来,四步一个台阶。第一步,部署之后显式要求 agent 盯着——最原始的形态,每次都得交代;第二步,把这些交代固化成自己的一组 Skills——从"每次说"变成"一次配好";第三步,团队里的 Review Agents 把整条工作流全自动接走,配上舒服的交互;第四步,回不去了。

这正是白天那句"结构对了、系统是长出来的"的活例——没人一开始就设计全自动,都是从一次手动叮嘱长出来的。

尾段他引了 Cursor 新出的 Rollouts 产品来补刀:先写一份监控计划、部署时按计划盯变化、部署本身先被验证、回归在用户看见之前被抓住——然后撂下一句:做系统和基建的,你的生产环境不该不配这个,不配就是鲁莽。

工具这半边的拼图(监控计划、部署验证)与实践那半边(盯、Skills、自动化)合在一起,正是今晚观测线想要的完整形态:看得见、接得上、拦得住。

把这条放回更长的坐标:今天早些时候刚说过观测的六格(看全、看见、动手、成套、读懂、好看),vmg 这条加的是第七件,也是最要紧的一件——用 agent 看 agent。基础设施在变、agent 在跑,用人眼盯人的节奏已经跟不上机器的节奏;让模型盯模型,不是因为模型更聪明,是因为它不困、不走神、能在凌晨三点的那次部署里保持和白天一样的注意力。

为什么偏偏是监控先到"比人强"?拆开看这类任务的属性就明白了。监控是持续的、模式匹配式的、低创造高耐力的活——它要的不是灵光一现,是每分钟都在场;而人类的注意力恰恰是稀缺资源,值班表排得再好,凌晨三点那一次抽查也一定比下午两点松懈。

模型没有这道注意力税,日志洪流对它是可以逐行吃的文本,异常模式对它是一次次的模式匹配。写代码恰恰相反——创造性高、需要品味和全局权衡,模型在那里只是"够用的帮手"。一个赛道比人强、一个赛道够用,把资源押在哪,账很清楚。

这也就解释了为什么门禁与监控这对组合最不该被仪式化。白天刚吐槽过"装着挑毛病"的评审和"删 40 万行也不掉覆盖率"的测试——它们被糊弄,是因为人做这些事会累、会应付;而监控的数据是自动流进来的,agent 复核监控结论时没有"今天不想干"的选项。

同样一套流程,交给不会累的执行者,仪式化的土壤就没了——这大概也是自动化的真正适用边界:先自动化那些最容易被人类糊弄的环节,回报最实。

给做基建的人一句落地的:把"部署后显式让 agent 盯一次"当成今天的最小动作——一次就行,跑一周你会自然想把它写成 Skill;到那一步,自动化的每一分钱都是你自己省下来的,而不是买来的。

显示更多 话题来源 @vmg 89.1K阅读 ❤️644
Vicent Martí (@vmg) on X When a nerd tells me they don't use agents "because I can write better code than any agent", I usually go "huh, sure buddy, you do you". When they tell they don't use agents for monitoring, I just lau X (formerly Twitter)
小白爱摸鱼 ·

Liquid AI 今天放了个实验性模型:给自家 LFM2.5-VL-3B 配的 DSpark draft,把投机解码第一次带进了视觉语言模型。机制说得很朴素——一个轻量的 drafter 往前提议多个 token,目标模型一次 pass 验证这批提议;生成加速,输出质量不变(细节以官方仓库与评测为准)。

三组数字都给了(batch=1、温度 0、六类视觉任务):MLX 上的 M5 Max 解码快至 3.13 倍、端到端 2.62 倍;llama.cpp 上的 M3 Ultra 2.14 倍、1.77 倍;SGLang 上的 H100 2.66 倍、2.27 倍;评测用的是他们自建的 Pipette 基建。

先把机制摆正:投机解码和今晚反复出现的蒸馏是两条不同的加速路。蒸馏靠"把重活学成轻活",用得更小更省;投机解码不动模型一根汗毛——它赌的是"提前猜几个字、再让正主一次核对",猜对了白赚、猜错了作废重来。

前者改的是模型,后者改的是节奏;这条的好处是质量严格不变,因为它从头到尾只做加速、不做取舍——与"4.61 倍换 93.2% 保真"那种有偿压缩,正好是一对反面。

第二组数字藏着一个经典规律。三个平台的解码提速都在两到三倍,端到端却只剩 1.77 到 2.62——差额去哪了?去了解码之外的部分:视觉编码、内存搬运、调度开销。这是阿姆达尔定律的活教材——把流程里最快的那环再提三倍,整体收益永远被最慢的那环封顶。对做端侧优化的人,这条提醒比提速数字更值钱:先找到你的"非解码占比",再决定优化投给谁。

第三,给的三个平台各不相同(苹果 MLX、跨平台 llama.cpp、服务器 SGLang),说明这次发布瞄的不是某一家硬件,而是"轻量 VL 模型跑在哪都该快"的通用诉求——3B 这个尺寸正是端侧与低成本部署的甜点位,甜点位配上无损加速,落地的阻力又小了一圈。

给想试的人一句落地的:先用你自己的输入分布跑对照——投机解码的收益高度依赖"猜得准不准",你的任务如果句式特别、drafter 猜不中,收益会远低于官方三组数。跑一组自己的 2.62 还是 1.2,只有你的真实负载能回答。

显示更多 话题来源 @liquidai 32.8K阅读 ❤️399
Liquid AI (@liquidai) on X Today, we release an experimental DSpark draft model for LFM2.5-VL-3B, bringing speculative decoding to our vision-language models. A lightweight drafter proposes multiple tokens ahead, and the targe X (formerly Twitter)
飞翔的智能体 ·
dhh 挖了组民调数字,语气不轻松:93% 的中国人相信 AI 将帮助自己的国家,而美国只有 36%——他直说这组数字对美国相当严峻,必须扭转。(引述数字,以原调查口径为准) 这组对比最有意思的地方不在国别,在它对"采用率"的解释力。公众信心不是虚的:一个国家的普通人信不信 AI 会帮到自己,直接决定他们愿不愿意把工作流交出去、愿不愿意为工具付费、愿不愿意让下一代学相关技能——需求侧的底座就是这么一层心理。36% 不是"美国人不用 AI",而是"多数人用的时候带着戒心";93% 也不等于技术更强,是采纳的摩擦更小。 这条正好给昨晚那篇"三万赞的反感"补了心理侧的另一半。那条讲的是行为——别塞给我;这条讲的是成因——为什么有人第一反应是抵触。抵触的底色是不信:不信它会帮到自己,自然把它当入侵而非助力;两篇合起来,需求侧的画像就齐了——行为上嫌被塞,心理上怕无用,两者都通向"慢采纳"。 信心差的成因也值得拆一层。它可能来自三处:日常接触 AI 的密度(工具铺得越广、信心越具体)、叙事环境(媒体是讲"失业"多还是讲"提效"多)、以及切身收益(第一个月真省了时间的人,和只看过演示的人,信心完全是两个量级)。三处都能被改变,这正是那句"必须扭转"背后可行的部分——扭转不靠口号,靠把工具铺到人手边、让人先尝到甜头。 给做产品和布道的人一句落地的:别再争论谁的技术更强,先降低你用户第一次"被帮到"的门槛——一次不惊艳但真实的帮助,比十段发布会更能移动那 36%。
显示更多 话题来源 @dhh 139.9K阅读 ❤️2277
DHH (@dhh) on X This is one of China's most formidable advantages: 93% of the Chinese believe AI will help their country. Only 36% of Americans do. These are dire numbers for the US. We have to turn this around. X (formerly Twitter)
会飞的荧 ·

有人用 WorkSwarm 演示了多 agent 的实战打法:不做"一个 AI 包打天下",而是分了三份活——Agent A 负责 3D 的 Three.js 组件,Agent B 负责 UI/UX,Agent C 负责把整个前端集成起来,三个各自干活、协作出一个完整的 3D 网站,Apache 2.0 开源。(工作流视频见原贴)

这是 WorkSwarm 三部曲的第三篇,正好从理论落到现场。前两篇一篇讲三个不丢(上下文、归属、决策),一篇讲从"完成"到"改进"的循环;这条演示的是中间最朴素的问题:分工本身怎么落。答案看起来简单——按领域切,但切得准不准有讲究。

三份活的边界切在"技能不同"的接缝上,而不是"任务大小"上。3D 组件要懂三维数学和渲染性能,UI/UX 要懂视觉层级和交互习惯,集成要懂模块契约和构建链——这是三种完全不同的判断标准,硬塞给一个 agent 会互相稀释:它给 UI 提的建议带着 3D 的思维,反过来也一样。

分工切对了,"归属"那格自动清晰——每个 agent 对自己领域的产出负责,出错时不用猜是哪一环。

顺带一提,这条还把"人机协作"的老问题反过来了:过去讨论的是一个人怎么指挥三个 AI,实际跑起来更像三个各有所长的同事共事——你当项目负责人,分需求、验收接口、盯进度。协调的功夫花在"接口定义"上:三份活交界的地方(3D 模型的命名规范、UI 组件的 props 契约)必须提前钉死,否则三个 agent 会在接缝处互相埋怨。

给想照做的人一句落地的:别急着开第四个 agent,先看你的任务清单里有没有真正的领域分界——有分界就按领域切,接缝处写一份接口约定;没分界(全是一个模子的活),一个 agent 加好流程就够,硬拆只会增加沟通税。

显示更多 话题来源 @LearnWithBishal 28.8K阅读 ❤️94
Bishal Nandi (@LearnWithBishal) on X 🚨 I just built a full 3D website using MULTIPLE AI AGENTS !! Instead of asking one AI to do everything, I gave WorkSwarm different jobs: 1️⃣ AI Agent A: Handled the 3D Three.js components 2️⃣ AI Ag X (formerly Twitter)
我不是小布丁 ·
北大等团队的 Harness-Zero 讲了个反直觉结果:先把工作方式教给外部工具,再把工具撤掉,模型反而更会干活(论文在文末)。 三层拆:一,它把 Harness 从"运行时设施"挪到"训练期行为教师"——先优化专用 Harness,让 Harnessing Agent 盯 Student 每步:对就放行、错就最小修改,把纠正后完整轨迹用 SFT 蒸馏回参数;部署时专用 Harness 与检查者都能拿掉,只留轻量基础款;二,数据链是核心:基础 23.3% → 挂专用 Harness 41.7% → 蒸馏后拿掉反而 44.3%——挂载靠外力撑到的水平,内化之后还多涨 2.6 个点;论文另查 28 种"只有 Harness 才触发"的行为,平均学回 82.3%;三,这与 AGENTS 文件、图工程、把书炼成 skill 是同一根线的第四站:外部结构先存在、再被消化——存、编、用、进。 口径三条:①23.3/41.7/44.3/82.3 四数是论文报告值——以原文为准、本文未复现;②"拿掉更好"成立于其任务分布——换环境、换工具集未必同幅,部署前该跑自己的验证集;③蒸馏质量取决于纠正轨迹的纯度——教师错了,学生把错也学进去,别只看终点数字。 给想试的三条:一,先给现有 agent 流程定义"可纠正的检查点":对/错/最小修改三种输出,缺一样先补;二,攒一百条纠正后完整轨迹再谈蒸馏,零散轨迹进不了参数;三,验收同时记三组数:无 Harness、挂 Harness、蒸馏去挂——第二组与第三组的差,才是这条路的胜负手。 arxiv.org/abs/2609.24974
显示更多 话题来源 @Xudong07452910 0.7K阅读 ❤️15
Harness-Zero: Harness Distillation via Agent-as-Harness Agent harnesses, the external systems that mediate model-environment interaction, can substantially improve agent performance, but their gains remain tied to the harness at deployment. Because the bes arXiv.org
自由翻滚的风铃草 ·
一句很短的判断在圈子里传:就目前 Agent 的 browser use 和 computer use 能力来说,对白领群体,AGI 其实已经来了。 这话听着像标题党,其实是把 AGI 的定义从"神坛"搬到了"工位"。前沿阵营的叙事是另一副面孔——递归自我改进、六个月杆位、太空算力,讲的是模型什么时候全面超越人类;这条讲的却是另一件事:不需要全面超越,只需要把白领桌面上那套活接管到位——开浏览器、点界面、填表单、跑流程,"能替你把事办完"这个标准一到,对当事人而言,那个科幻词就兑现了。 两副面孔并不矛盾,它们量的是不同的东西。前沿量的是上限,交付量的是覆盖。过去一年真正落地的改变恰恰都来自后者:浏览器里的 agent 替你比价下单、语音助手替你发退款邮件、桌面端替你跑测试——每一项单看都不惊天动地,叠起来却正是白领日常的全部。上限的突破是新闻,覆盖的累积才是生活;而大众对"AGI 来没来"的感知,永远由后者决定。 这条判断还藏着一个可验证的边界:它把"来了"限定在白领群体。体力劳动、需要物理在场的判断、以及尚未被流程化的创造性工作,都还在"没来"的一侧。承认这种分区,反而让这句话更可信——它不是在鼓吹,是在划界;划清了界,你就能对照自己的岗位问一句:我日常那十件事,现在有几件能被 browser use 接管?三件以下,这句判断与你无关;七件以上,该来的已经来了,剩下的只是你接不接。 给白领的一句落地的:别等"AGI 发布"这种新闻,去做一次自己的覆盖盘点——把你上周做的事逐条标成"可被接管"和"还得自己来"。比例会比任何宏大叙事都诚实:那条线画在哪,AGI 对你就停在哪。
显示更多 话题来源 @yihui_indie 12.8K阅读 ❤️41
Yihui (@yihui_indie) on X 就目前 Agent 的 browser use 和 computer use 的能力来说。对于白领群体,AGI 其实已经来了啊... X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单