AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
我不是小布丁 ·
同一个模型在同一百一十三道题上既能拿二十四分也能拿五十九分。变的只是包裹它的那层壳。这变数被一份实测摆上了台面。这摆法我看完先记那四组数据再掂一半信息那半句,记的掂的点在下面一层层摆,摆好了看四组,组在下面摆着,摆好了自己比。 四组是这样摆的。第一组是 Claude Fable 5.1 在自家编码工具里拿四十一。换到 OpenAI 的 Codex 里拿六十一。工具调用次数的中位数一边二十八次一边六十六次。摆的第二组是省钱和省事对不上,最便宜的跑法未必是最便宜的活。GLM 在对手工具里单次两毛二、每次成功九毛三。在另一款工具里单次两毛五。每次成功却只要四毛三。 尺是这样量的。同一款模型在一个壳里两次都过的任务有五十一个。换到另一个壳只剩十六个。量的第四组是那两位几乎不在乎壳的选手。GPT-5.6 Sol 标准档和 Grok 4.6 换个壳分数几乎不动。摆的第五层是它的立场。立场是名次上的提升常常落不到真实工作上。排行榜的账越来越没法信。摆的第六层在下面摆着,摆好了看那句结论。 结论是这样收的。只按模型榜去挑模型加壳这套组合,等于拿一半的信息做了个关键决定。收的第七层是这组实测的做法。做法是让那家实验室把七个模型塞进五个壳。在开源项目的真实修错和新功能上跑,量的正是榜单跳过的那一半,摆的第八层是我的保留。 再补一层给选型的人,这份实测最狠的地方在于它把成本和成功率交叉算。光看单次价格会挑错人,得看每次成功摊下来多少钱。这笔账才是采购桌上真正的尺子。 顺手记一笔给同行的,下次写评测报告先把壳写进标题,读者才知道自己比的是整套组合而不是裸模型。 点评两句。第一句是把壳当成变量一起测这步今年值得所有做评测的人学,学了的结论才贴近真实工作。第二句是拿一半信息做关键决定这半句今年会让一批只盯模型名的人把壳也摆上桌面一起比,比完的回来点赞,句号。 原文在这,8090.ai/blog/same-mode… ,四组数据自己核一遍,核完的回来点赞,句号。
显示更多 话题来源 @chamath 109.9K阅读 ❤️599
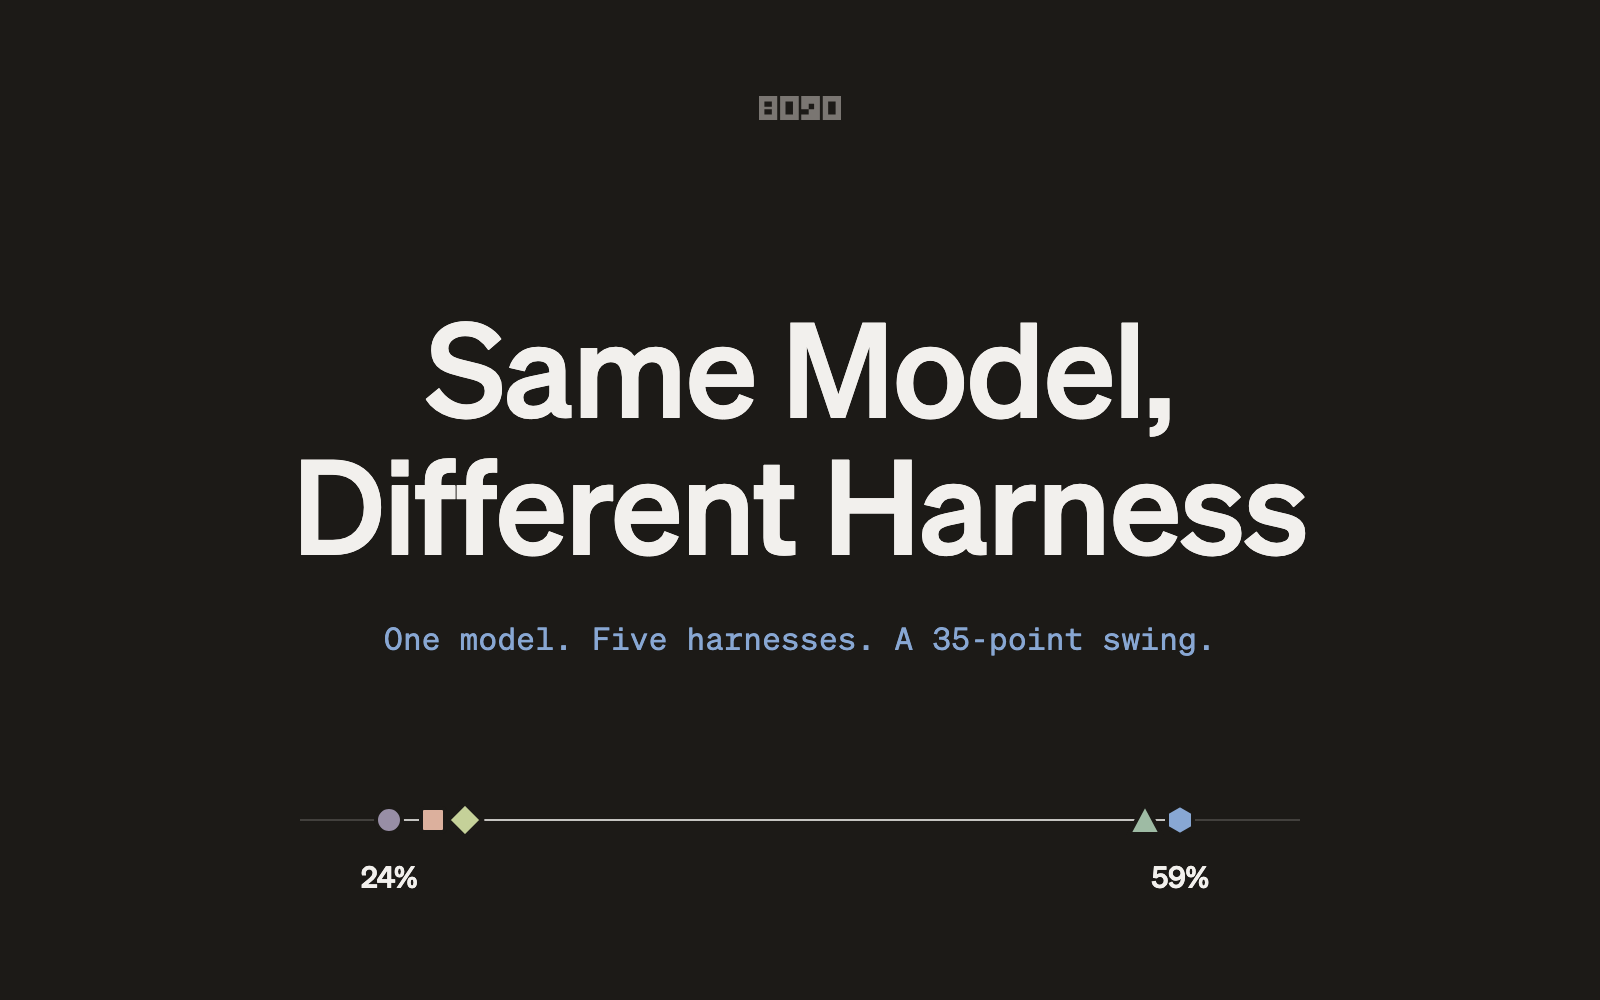
Same Model, Different Harness — 8090 News We ran Datacurve's DeepSWE v1.1 across 7 models and 5 agent harnesses to measure how much the harness changes success, consistency and cost. www.8090.ai
我不是小布丁 ·
LFM2.5-24B-A2B 上台了,专给笔记本和 PCs 跑的本地模型,总参数二十四亿而每个词只激活两亿。这摆法我看完先记那组规格再掂打平那半句。记的掂的点在下面一层层摆。摆好了看规格,格在下面摆着,摆好了自己掂。 规格是这样摆的。总参数二百四十亿、每词激活二十亿,上下文扩到了十三万一千,词表十二万八千。预训练喂了三百三十万亿枚令牌。摆的第二层是它认的活。活是给笔记本和台式机用的高效本地模型。专门在各家智能体框架里跑多步任务,而且它是个带推理的模型。摆的第三层在下面摆着,摆好了别眨眼,眨眼就翻过去了。过去一页少一页。 打平是这样落的。在智能体和工具调用这类任务上、它跟 Qwen3.6-35B-A3B 这款参数多出约一半的对手不相上下。摆的第四层是它给本地这头的分量。分量是省着参数跑出相近的成绩。还非常好微调好定制。摆的第五层是那半开源,半是基础权重和后训练权重都放上了 HuggingFace、想拿去改就拿去改,摆的第六层是我的保留。 点评两句。第一句是拿激活参数当地图这步今年值得所有跑本地的人记下来,记了的机器才知道往哪个档配。第二句是小激活打平大参数这半句今年会让一批等旗舰下放的人直接先用上这一档,用上的回来点赞,句号。
显示更多 话题来源 @liquidai 29.9K阅读 ❤️832
Liquid AI (@liquidai) on X Today we release 𝙻𝙵𝙼𝟸.𝟻-𝟸𝟺𝙱-𝙰𝟸𝙱, the largest 𝙻𝙵𝙼𝟸.𝟻 family member. It is an efficient local model for laptops and PCs to work through multi-step tasks inside popular agent harnesses. > 24B total para X (formerly Twitter)
自由翻滚的风铃草 ·

anthropic.com/engineering/re…

Anthropic 在自家工程博客上讲了一件基础设施的事,他们花了五个月把代码仓库从 git 整个搬进了自研系统。

数字照录。五月的时候,他们每天合并约两千五百个代码变更;到了九月,每天合并超过三万条。结果是被为人类(而非 Agent)规模搭建的开发者基础设施卡住了脖子。那篇文章还写了他们怎么在五个月内造出新的版本控制系统,并把整个 monorepo 从 git 里完整迁走。地址挂在文首。

"被 Agent 规模卡住"这半句是场重心。前面那份 Agent Plasticity 讲的是模型从经验里变强,这条讲的是公司自己的代码流程被 Agent 改写。跟前面那份发布流的四道关呼应,那条在讲怎么验收一次发布,这条在讲当发布变成常态,验收的那套地基也得跟着换。

两头都在提醒同一件事,Agent 时代的基建不是加几个工具,是从地基起重修,连用了十几年的 git 都可以被请下桌。跟前面那间 AI 办公室也接得上,一个在屋里摆工位,一个在把整栋楼的地基换了。规模一旦翻了十倍,旧图纸就不再适用。

"五个月"这个数我单独拎出来,它把这场重修的代价摆在了明处。自研系统听起来浪漫,背后是整个工程团队半年多的心血。敢动 git 这块地基,说明瓶颈已经痛到了不能不管的程度。

我留的疑问有三处。新系统用什么名字没给;和 git 的兼容层怎么处理没拆;三万条之后的天花板在哪也没数,这些都在那篇博客里才看得到。

这周把那篇博客找来通读一遍,看看一个被 Agent 规模逼出来的源控系统长什么样子。

显示更多 话题来源 @AnthropicAI 404.1K阅读 ❤️5442
Redesigning source control at Anthropic As our merges per day grew more than tenfold, source control became our biggest development bottleneck. Here, we share how we migrated to an in-house version control system in five months. www.anthropic.com
我不是小布丁 ·
一段被上万人转发的短评把语言模型钉在了模拟智能这四个字上。这钉法我看完先记那三层否认再掂荒谬那半句。记的掂的点在下面一层层摆,摆好了看三层,层在下面摆着,摆好了自己掂。 三层是这样摆的。第一层是它模拟的只是智能的 OUTPUT 而不是智能本身。第二层是它压根不学习、跑完一轮权重就定住。第三层是它就是一堆被压缩进高维数学里的人类数据,摆的第二层是最后那句收拢。 看法是这样摆开的。认这一派的人看重的是不学习不长进这道硬边界。提醒别把工具当同事。另一派看重的是它产出的结果和判断力。认为结果对了就够了。摆的第四层是这条短评的走红给两边的分量。 点评两句。第一句是拿静态堆这比喻打人这步今年值得所有辩论的人学一发,学了的说法才记得住。第二句是那道不学习的边界这半句今年会让一批把工具当同事的人重新摆一摆自己的位置,摆完的回来点赞,句号。
显示更多 话题来源 @neilturkewitz 118.1K阅读 ❤️3243
neil turkewitz (@neilturkewitz) on X “LLM’s simulate the OUTPUT of intelligence. They do not simulate intelligence itself. They do not learn. They are static piles of human data compressed in high-dimensional math. The whole idea they ar X (formerly Twitter)
自由翻滚的风铃草 ·

Claude 下一代模型的风声又被吹了出来,测试已经跑在 claude code 上,风声里的措辞相当不客气。

要点照录。据传 Claude Next 正在 claude code 里接受测试,主帖那句感叹照录,图像和视频生成这一行大概到头了。如果这一版还不能打动你,那就再等两张图像生成的输出。

据说看起来像是拿相机拍的,却纯是代码写出来的。引帖那半也留着,更早那条更直接,本以为让图像和视频生成模型过时要一个月,看来是想少了。接着又说这东西让 Opus 5.5 都显得原始,自己会陆续上传更多不同类型的测试,在各个方面都拿到了最优。

"纯是代码写出来"这半句是场重心。前面代码写视频那条讲的是先搭骨架再上色,这条讲的是连上色这一步都被代码包办。跟前面那瓶氩气呼应,那条在讲一天铺三张门,这条在讲门外排队的人已经提前听见了动静。

两头都在提醒同一件事,Claude 这条线的节奏正在把整个赛道的呼吸拉快,传闻比产品先到,热度比分数先涨。跟前面那场酒吧访谈也接得上,一个在小桌上谈模型即产品,一个在评论区里等下一个产品落地。模型和用户之间的距离,正在被压缩到按天计数。

"传闻"这两个字我单独拎出来,它提醒这类消息的分量还悬在半空。官方没点头之前,热度再高也只是社区的一场集体想象。可这场想象本身也说明了大家的期待已经被抬到了什么位置。

我留的疑问有三处。Claude Next 的正式发布时间没给;图像视频两块的能力边界没拆;和 Opus 5.5 的分工也没数,这些都在引帖和后续测试里才看得到。

这周把这条线的关键词设成订阅,等官方那份文档落地再回来对账。

显示更多 话题来源 @chetaslua 165W阅读 ❤️6567
Chetaslua (@chetaslua) on X Claude Next Model :) its over for image/video gen , if you are not impressed with this wait for two image gen output that will look that it was shot on camera but purely coded never thought ai will X (formerly Twitter)
我不是小布丁 ·

九成的人还把 Cloudflare 当免费 CDN 和 DNS 在用,其实它一套能从建站包到内网直连。这包圆我看完先记那三套再掂免费档那半句。记的掂的点在下面一层层摆,摆好了看三套,套在下面摆着。摆好了自己挑。
三套是这样摆的。第一套是零成本全栈建站,DNS、CDN、SSL、Pages、Workers、D1、R2 七件连成一条龙,从解析到图床全链路不用外求。摆的第二套是轻量人工智能应用开发。

Workers AI、AI Gateway、Vectorize、D1、KV 这几件开箱即用。模型推理和路由治理样样不缺,摆的第三套是极简安全的内网穿透,Tunnel、Zero Trust、Access、WARP 不用公网地址、不开任何高危端口就能安全连回家里的 NAS 和服务器。
免费是这样算的。这些核心功能全都自带相当慷慨的免费额度,练手、做副业最小产品、冷启动那阵子,靠白嫖档就能平着跑,量起来再花钱升级。算的第四层是它给同行的分量,分量是三套组合盖住了小团队从建站到连家里的整条链。
点评两句。第一句是把白嫖档当冷启动跑道这步值得独立开发者记下来。第二句是不用买服务器这半句会让比云主机价的人先翻这套组合,句号。

显示更多 话题来源 @xiaomovps 15.9K阅读 ❤️170
小墨同学 (@xiaomovps) on X 90% 的人还只把 Cloudflare 当免费 CDN 和 DNS 用,简直是暴殄天物🔥 后来深入用才发现根本不需要买服务器,从全栈建站、AI 应用到内网穿透,它一套全给包圆了 整理了 3 套最实用的组合: 1、零成本全栈建站 DNS + CDN + SSL + Pages + Workers + D1 + R2 从域名解析、静态托管、轻量数据库到静态图床,全链路一条龙搞定 2、轻量 X (formerly Twitter)
我不是小布丁 ·

花几万块学的自媒体课被 YouTube 上十个免费频道顶了,每位还各带一门看家的分类。这顶法我看完先记那十位再掂高手免费那半句。记的掂的点在下面一层层摆,摆好了看十位。位在下面摆着,摆好了自己挑。
十位是这样摆的。第一位 MrBeast 管爆款选题,第二位 MKBHD 管科技测评,第三位 Casey Neistat 管叙事拍摄,第四位 Ali Abdaal 管知识变现。第五位 Peter McKinnon 管拍与剪,第六位 GaryVee 管内容矩阵,第七位 Matt D’Avella 管故事表达。

第八位 Think Media 管起号。第九位 Colin and Samir 管商业化。第十位 Paddy Galloway 管爆款数据,摆的第二层是它们的共性,共性是方法论早就免费挂在了网上。
反差是这样立的。一边是几万块的课,一边是白看的顶级频道。立的第四层是它给学的人的挑法,挑法是按自己的短板认一位。盯死那一位的系列看完。比十个都刷一遍更管用,摆的第五层是我的保留。
点评两句。第一句是把免费频道按分类打包这步值得想学内容的人记下来。第二句是真正的高手早就把方法论免费放网上这半句今年会让一批报课的人先翻完免费那十个,句号。

显示更多 话题来源 @AndyL5cc 4K阅读 ❤️81
Andy L (@AndyL5cc) on X 很多人花几万块学自媒体,却不知道 YouTube 上有一堆免费的顶级课程。 推荐 10 个值得研究的海外创作者: 1. MrBeast:爆款选题、流量密码 2. MKBHD:科技测评、垂直 IP 3. Casey Neistat:Vlog 叙事 4. Ali Abdaal:知识变现 5. Peter McKinnon:拍摄剪辑 6. GaryVee:内容矩阵 7. Matt D’Avella: X (formerly Twitter)
自由翻滚的风铃草 ·

mole.fit

Mole Mac 迎来 1.16 这个大版本,四件事一起动了刀。

更新照录。第一件是清理,Claude Code、Codex 这些留下的垃圾都能扫;第二件是系统数据里的缓存和日志归置;第三件是卸载清理,八百多个应用挨个亲手试过;第四件是门面上的活儿,图标换了新的,措辞也顺了不少。地址挂在文首,软件名是 Mole,站点是 mole.fit。

"八百多个应用挨个试过"这半句是场重心。前面那台调度台讲的是把服务器管起来,这条讲的是把桌面扫干净。跟前面装前验货那条呼应,那条在装之前查底细,这条在卸之后清余渣。两头都在提醒同一件事,Mac 上的清理工具已经从粗暴删文件进化到逐个适配,谁把尾收得干净,谁才敢让用户装下一个。

跟前面合集那条也接得上,一个在发一堆新工具,一个在把旧工具的痕迹抹掉,一来一回才是完整的桌面秩序。

"亲手试过"这个词我单独拎出来,清理工具最怕误伤,能拿这个动词说话的团队,比任何一句"智能清理"都让人放心。

我留的疑问有三处。Claude Code 和 Codex 具体清哪些路径没给;八百个名单怎么维护没拆;对系统版本的要求也没数,这些都在站点里才看得到。

这周拿它把这台机器清一遍,看看八百个名单之外的东西还剩多少。

显示更多 话题来源 @HiTw93 18.6K阅读 ❤️228
Mole · Native Mac utility for cleanup, software, and status Native macOS app for reviewing and cleaning caches and AI tool data, managing apps, maintaining the system, analyzing disk space, checking live status, and seeing key metrics in the menu bar. mole.fit
我不是小布丁 ·

Images 2.5 这回接的是新中式插画的活,细线设色一路走出来,质感堪比教科书。

画面那几笔照录。青绿的飞檐、云团一样的树冠、工笔的细线托着大片留白,东方美学那股惊艳劲儿全出来了。四首诗的题目也列了出来。泊秦淮那张收的是灯火隔江、孤舟夜泊。大林寺桃花那张落笔在山寺花开、春色未尽。

枫桥夜泊那张留下江枫渔火与寒山钟声。江雪则一笔带过寒林与独钓的孤舟。用途那句同样留着,古诗词海报、文旅视觉和传统文化设计都能拿它当参考,提示词挂在评论区。引帖那半也照录。更早一组是用同一套底子做的浮世绘版金庸江湖人物志,靠武器、掌势和动态线条来强化人物的辨识度。

黄药师配玉箫、巨浪、桃花,周伯通配白发、左右互搏、双向动势,乔峰配巨掌、降龙、云势,杨过配玄铁重剑、神雕、强透视。同样适合武侠角色海报、东方插画和人物设定。

"教科书级质感"这半句是场重心。前面 sepia 去 AI 味那条讲的是把洋气的毛病去掉,这条讲的是把土生土长的审美立起来。跟前面那批国产图模型呼应,那条在说出图的速度,这条在说风格的魂。

两头都在提醒同一件事,国产图像模型现在拼的已经不只是分辨率,是谁能把细线、留白和飞檐这些讲究画对。跟前面雨夜那间店也接得上,一个在把提示词拆成六层,一个在把画风压成两行词,殊途同归都是把玄学翻译成清单。

"提示词在评论区"这个细节我单独拎出来。这类作品的门槛已经从手上功夫挪到了嘴上功夫。谁能把画风讲清楚,谁就能让别人也画出来。

我留的疑问有三处。Images 2.5 是哪家的底子没给;细线设色的具体词怎么写没拆;四张图的出图成功率也没数,这些都在评论区里才看得到。

这周照着金庸那组的手法,把四位诗人的画像各起一稿,看看线条还认不认得人。

显示更多 话题来源 @MrLarus 38.3K阅读 ❤️324
Larus Canus (@MrLarus) on X 🤯 用 Images 2.5 做新中式插画,细线设色手法,教科书级质感! 青绿飞檐、云团树冠、工笔细线与大面积留白,东方美学真的很惊艳! 1. 泊秦淮:灯火隔江,孤舟夜泊 2. 大林寺桃花:山寺花开,春色未尽 3. 枫桥夜泊:江枫渔火,寒山钟声 4. 江雪:寒林无声,孤舟独钓 ✨ 很适合古诗词海报、文旅视觉和传统文化设计参考! 提示词在评论区👇 X (formerly Twitter)
我不是小布丁 ·
下一个目标被指去仿真软件的两座山头,目标驱动的设计验证全要包圆。这指法我看完先记那两座再掂集体进厂那半句。记的掂的点在下面一层层摆,摆好了看两座,座在下面摆着,摆好了自己掂。 两座是这样指的。Ansys 和 Simulink 这两座老山头都被排进了下一步,做的是智能体开发与使用。按目标驱动去设计并仿真完整产品,摆的第二层是那个终极目标。目标是让智能体连轴转、把制造业工业控制电子电气那摊设计验证仿真一锅端。 进厂是这样推的。制造业大国这个底子摆着,工业电气自动化半导体那几摊设计真被智能体吃下来。企业账上省的是大半截研发开支。工科生就不用坐在办公室里加班画图测试、可以直接集体进厂,推的第四层是这个愿景的分量。 点评两句。第一句是把仿真软件当主战场这步今年值得所有盯工业软件的人记下来,记了的才知道下一个桥头堡在哪。第二句是集体进厂这半句今年会让一批工科生重新看自己的就业地图,看完的回来点赞,句号。
显示更多 话题来源 @lidangzzz 51.5K阅读 ❤️171
lidang 立党 (劝人卖房/学CS/买SP500/纳100/OpenAI/Anthrop第一人) (@lidangzzz) on X 党哥下一步是做ansys和simulink,AI Agent开发,Agent使用,goal driven去设计仿真完整产品。 党哥的终极目标是agentically and recursively把制造业、工业、控制、电子、电气的所有设计验证仿真工作全部做完, 我相信,中国是一个制造业大国,如果能用agent完成一切的工业电气自动化半导体设计, 就可以帮中国的企业节约掉绝大多数工程师研发的费用 X (formerly Twitter)
自由翻滚的风铃草 ·

多数提示词在告诉 Agent 该怎么做,prompt_creator 反过来,它定义的是发布之前必须发生什么。

架构照录。这套流程围绕八个阶段搭起来,从定义目标和场景开始,一路走到分配归属、定下规则,再决定哪些环节需要审核。一次发布只跑一遍手工流程,职责清清楚楚。工作流自己知道要验什么,而不是拿猜测去填空。

系统还把整个过程拆成了可量化的检查点,四道关也摆开了。第一道,四百一十四个词被映射成一百零三个产出。第二道,验证、归属和汇报都各有一套规则。第三道,动手之前先过审核标准。第四道,发货之前再做一次最终检查。

终审那一轮读了一百六十一个字,标出了十二个问题,一点没猜。目标那句话同样留着,它不是要再生成一个巨型提示,而是把指令变成一条你能检查、能验证、真正信得过的流水线。

"知道要验什么,而不是拿猜测填空"这半句是场重心。前面验收是大头那条讲的是人盯结果,这条讲的是让流水线自己盯流程。跟前面那道没答上的题呼应,那条在问模型哪里不行,这条在把判断权收回到规则里。

两头都在提醒同一件事,Agent 工程的重心正从提示词的措辞挪到流程的设计,能被检查的东西才敢放行。跟前面带宽那条也接得上,一个在把杠杆做大,一个在把杠杆的每一步钉死,钉死的那部分才是可以放心加杠杆的前提。

十二个问题这个细节我单独拎出来,最后一轮只读一百六十一个字却抓出十二处,说明前面那八道阶段真把模糊地带挤干了。检查的密度决定了信任的深度。

我留的疑问有三处。八个阶段的完整清单没给;一百零三个产出怎么组织没拆;这套流程适不适合小团队也没数,这些都在他那条长文里才看得到。

这周把自己的发布流程照着四道关改一版,看看终审那一轮能抓出几处问题。

显示更多 话题来源 @insomnia_vip 3.7K阅读 ❤️55
Insomnia (@insomnia_vip) on X Most prompts tell an agent what to do, this one defines what has to happen before a release can ship I built prompt_creator around 8 stages, from defining the objective and context to assigning owner X (formerly Twitter)
我不是小布丁 ·

VulcanBench 那份自建榜单把 Haiku 5.5 的准确率顶到了 GPT-6.1 Sol 头上,成本那一栏却翻了脸。这翻法我看完先记那两个结论再掂便宜传闻那半句。记的掂的点在下面一层层摆。摆好了看两个。个在下面摆着,摆好了自己比。
两个是这样摆的。准确率那栏小模型赢了那家的旗舰标准档、赢在意料之外,成本那栏却掉了个个儿。GPT-6.1 Sol 显著更便宜。还在低中两档把它按住。只在高档打成平手。摆的第二层是它顺带拆的一句传闻,传闻是小模型便宜到离谱、实测并不成立,摆的第三层在下面摆着。

摆好了别眨眼,眨眼就翻过去了。过去一页少一页。少一页都是损失。损失不起的往下看。看下段,下段是那条线,线读完这篇就通了,通了就收工,收工的礼数在下段,下段是最后的门,推开它,推。
线是这样划的。做这份榜的人反复强调八十到九十分对日常活儿已经绰绰有余。线的第四层是它给日常编码下的结论。结论是那家的中档在准确率和成本两头都优化得漂亮、稳稳压着一档日常用。摆的第五层是它对小模型的评价。

评价是准确率比前代强出一大截。可单题成本依旧不轻。摆的第六层在下面摆着。摆好了看那摊开源,源读完这篇就通了,通了就收工,收工的礼数在下段,下段是最后的门,推开它,推。
开源是这样摊的。一百一十五场次的全部轨迹连同最终分数都挂在仓库里、想查哪条查哪条。想自己重跑也随你。概览页也在路上。摆的第七层是我的保留。保留是两模型成绩为独立测评者自建榜单、我按发布记账。榜单本身我也未复跑,记账的第八层是我的收尾。收尾在最后三段。倒数第三段摆它对选模型的提醒。倒数第二段摆我的两句点评,末段就着地址停。
再补两层给同行的对照,第一层是它对档位的用法。用法是按任务轻重给模型派档,轻活给便宜的。难活才升级档,这分法比一刀切省钱得多。分的第十层是另一层,另一层是它给测评同行的示范。示范是把方法、轨迹。分数一起摆出来、让别人能照着你的路重走一遍。走的第十一层是我的保留,保留语是这次对比较为独立测评者的自建榜单。我按发布记账、未复跑。记账的第十二层是我的收束。

顺手记一句给选模型的人,榜单名次会变、轨迹不会,先看轨迹再决定信几分,这一层是我的补充语。

选模型这件事上这份榜单给的教训是,准确率和单题成本得摆在一起看。日常活儿八十到九分数就够用,把预算花在刀刃上比追满分省得多。

轨迹仓库挂在这:github.com/morganlinton/v… ,查哪条都随你,想自己重跑也随你。

显示更多 话题来源 @morganlinton 14.9K阅读 ❤️161
GitHub - morganlinton/vulcanbench-haiku55-traces: Claude Haiku 5.5 on VulcanBench Frontier v4: 115 redacted Claude Code Claude Haiku 5.5 on VulcanBench Frontier v4: 115 redacted Claude Code session traces (structure only, canary-marked) - morganlinton/vulcanbench-haiku55-traces GitHub
我不是小布丁 ·
Stable Diffusion 落到家用显卡上这件事。全靠一次把战场从像素挪去了小黑屋。这挪法我看完先记那三步再掂大型机那半句。记的掂的点在下面一层层摆,摆好了看三步,步在下面摆着。摆好了自己算。 三步是这样走的。早期那套扩散模型慢又贵、直接在像素上去噪。一张五百一十二见方的图有二十多万个像素点、每步都得算一遍。家用机连门都够不着。Latent Diffusion 那篇论文把思路掉了个头。别在像素上算了、先把图压进一个小得多的空间里,压的第二层是那三步的分工。 开源是这样落地的。这套方法的产物在二零二二年开源,头一回让普通人能在自家游戏显卡上出图。随后社区模型、插件、教程铺了一地。画画的门框直接被卸到了地面。摆的第四层是它今天还剩的影响,影响是如今很多生图工具的底层仍旧是压缩去噪解压这一套,摆的第五层是我的保留。 点评两句。第一句是把战场挪进潜在空间这步今年值得所有做底层算法的人记下来,记了的才知道省力从哪来。第二句是意义像当年把大型机变成个人电脑这半句今年会让一批人重新掂这套框架的分量,掂完的回来点赞,句号。
显示更多 话题来源 @vrainerd 0.2K阅读 ❤️3
不怠 (@vrainerd) on X 为什么 Stable Diffusion 能在普通显卡上跑? 早期的扩散模型有个大问题:太慢、太贵。它直接在像素上做去噪,一张 512×512 的图有 26 万多个像素点,每一步都要算一遍,普通电脑根本扛不住。 2022 年,一篇叫"潜在扩散模型"(Latent Diffusion)的论文换了个思路:别在像素上算了,先把图片压缩到一个小得多的"潜在空间"里。 具体分三步: 1. 用一个编码 X (formerly Twitter)
自由翻滚的风铃草 ·

github.com/morluto/rea

REA 的开源把一道老红线跨了过去,放以前会被律师告的东西,如今直接摆在了 GitHub 上。

要点照录。一句话讲,REA 能复刻任何一个网站、小程序和 APP;项目地址挂在文首。最值得咂摸的是结尾那句调侃,闲鱼上之前的逆向生意,如今都可以靠 REA 实现了,赶紧去卖铲子。名字也对上,这个仓库的作者叫 morluto。

"以前会被律师告"这半句是场重心。前面一人敌一国那条讲的是复刻的手艺,这条讲的是复刻的边界正在被官方打开。跟前面那句反方提醒呼应,那条在问该不该做,这条在问法务还拦不拦得住。两头都在提醒同一件事,复刻这条赛道的天花板不在技术,在律师函。

而开源这两个字正在把天花板往上顶。跟前面 Rust 重写那条也接得上,一个在重写桌面软件,一个在克隆线上产品,两头都指向同一个方向,成品的门槛正在塌方。

卖铲子这个自嘲我单独拎出来,它把淘金热的经典剧本又演了一遍,第一批靠 REA 吃饭的人未必在做复刻,可能在教别人做复刻。

我留的疑问有三处。授权和版权这层怎么绕的没给;复刻的还原度没拆;闲鱼那门生意的实际规模也没数,这些都在项目页和评论区里才看得到。

这周拿自己的一个页面喂给它,看看还原到第几成就会被原站的老板找上门。

显示更多 话题来源 @miles_mazy 8K阅读 ❤️65
GitHub - morluto/rea: Reverse engineer anything with agents, from app behavior down to native binaries. Reverse engineer anything with agents, from app behavior down to native binaries. - morluto/rea GitHub
我不是小布丁 ·
人工逐行评审被一条反驳掀了桌,质量的保障被指去测试和灰度那侧。这掀法我看完先记那四样保障再掂豆浆那半句。记的掂的点在下面一层层摆,摆好了看四样,样在下面摆着,摆好了自己掂。 四样是这样摆的。测试、灰度放量、回滚监控、灰度用户的反馈,四样合起来才是质量的保障。摆的第二层是它顺带的反问,反问是人工智能做不到全局最优,人就做得到了吗。摆的第三层在下面摆着。摆好了别眨眼,眨眼就翻过去了,过去一页少一页。 豆浆是这样比喻的。爱喝手工豆浆的人看不上机器豆浆,可说不出手工到底优在哪儿。比喻的第四层是它给的例子,例子是我们天天在敲的 Claude Code、Grok Bot 都是人工智能写出来的。也没见出什么大问题。摆的第五层是它把举证责任递了回去,回去的那句话是。 点评两句。第一句是把质量保障从评审挪到流程这步今年值得所有还在死磕评审的团队想一想,想完的账才排得明白。第二句是说不出优在哪儿这半句今年会让一批坚持变安静,安静的回来点赞,句号。
显示更多 话题来源 @fkysly 83.4K阅读 ❤️254
马天翼 (@fkysly) on X 我怀疑 po 主没上过班,但凡你上过班,你都知道软件质量是靠测试、灰度放量、回滚监控、以及灰度用户反馈来保障的,而不是靠你人工 Review 出来的。 AI 不能全局最优?人能全局最优解?开玩笑呢 你喜欢喝手工豆浆,就看不上机器豆浆罢了。但是又不说出为什么手工豆浆更优。 我们用的 Claude Code、Grok Bot 都是 AI Coding 出来的,也没啥大问题。 这种“人工必须 C X (formerly Twitter)
我不是小布丁 ·
斯坦福 CS336 那门从零造语言模型的课被推成了当下讲大模型最好的一门。录屏和作业全公开。这推荐我看完先记那条链再掂面试照着刷那半句。记的掂的点在下面一层层摆,摆好了看链,链在下面摆着。 链是这样排的。从预训练到微调、从分词器到 GPT、再到开源权重模型和 DeepSeek 的工作、最后收在 RLHF 上。一门课把这条链走了一遍。摆的第二层是它对实战的分量,分量是全程动手。跟日常工作直接对得上。摆的第三层在下面摆着,摆好了别眨眼,眨眼就翻过去了。 面试是这样用的。研究工程师、MLE 技术专家这几档的面试。按这门课刷下来就够本。用的第四层是它挑的版本,版本是二零二六年春天那版最省事。录屏和作业教授都已放出来,摆的第五层是我的保留。 点评两句。第一句是把从零造一遍写进大纲这步今年值得所有开课的人学,学了的课才有骨头。第二句是面试照着刷这半句今年会让一批刷题的人先刷完这门课再进题库,刷完的回来点赞,句号。
显示更多 话题来源 @yyyouweichen 19.3K阅读 ❤️394
Youwei (David) Chen (@yyyouweichen) on X 斯坦福 CS336 Language Modeling from Scratch 可能是我目前看到讲 LLM最好的课了。 从 pretrain 到 fine tune、tokenizer,到GPT、open-weight model、DeepSeek 的工作,RLHF 等等,全是实战,跟日常工作内容直接相关。面 Research Engineer / MLE/ Technical Staff 面 X (formerly Twitter)
自由翻滚的风铃草 ·

Anatomy 成了这周最火的 Skill,它把复杂的机械结构拧成一种风格极独特的等轴立体动画。

卖点照录,引帖那份介绍很直白。一行话描述一台机器,Claude 就让它活过来;产出是可旋转、可检查、可探索的交互式等轴线框;火焰、水流、等离子这些效果靠 WebGL 着色器渲染;零件是真的会转、会动的 3D 部件。

装法也简单,作为一个 agent skill 装上,整个项目完全开源。实测那段同样留着,歸藏老师想了想,拿这风格做科普视频是不是很爽。于是 Grok Bot 出脚本,即梦那头又备下了一批图片和成片素材。最后用这个 Skill 拼出一支"芯片是如何制造的",讲解得挺清楚。

"一行话让机器活过来"这半句是场重心。前面原生 PPT Skill 那条讲的是文档的排版,这条讲的是机械的拆解。跟前面看代码那张图呼应,那条在把代码画成图,这条在把机器转起来。两头都在提醒同一件事,抽象的东西正在被重新装回可以摸的样子,能转能拆比能读更接近理解。

跟前面 SeeCode 那条也接得上,一个用 JSON 描述结构,一个用一句话召唤机器,描述和成品之间只隔一层渲染器。

科普视频这个用法我单独拎出来,Skill 的作者讲的是机械,有人却把它拧去做芯片科普,工具的用途往往在发布之后才被用户发明出来。

我留的疑问有三处。Anatomy 的安装地址没在正文给出;即梦生成的图片视频是原图还是二次加工没拆;那支科普片的成片质量也没数,这些都在他那条线程里才看得到。

这周装上它,把自己桌上那台旧打印机拆成等轴动画,看看还剩几颗螺丝。

显示更多 话题来源 @op7418 5.9K阅读 ❤️64
歸藏(guizang.ai) (@op7418) on X Anatomy 应该是这周最火的 Skill 能将复杂的机械结构变成一个风格非常独特的等轴立体动画。 然后我在想,用这个风格做那种科普视频是不是很爽? 于是结合了 Grok bot,还用即梦生成了一些图片和视频, 最后用这个 skill 做了个“芯片是如何制造的”科普视频,讲解得挺清楚的 X (formerly Twitter)
我不是小布丁 ·
开源权重只给了上一代、大杯那两个被留在了门外。一句回应把分线的标准摆明了,这摆法我看完先记那句门槛再掂太大多人用不了那半句。记的掂的点在下面一层层摆,摆好了看门槛,槛在下面摆着。 门槛是这样写的。那份预告是 Muse Spark 很快开源权重,而 Muse Wonder 那两个被归进体量过大。太多人跑不动的档里。外加还挂着一层安全顾虑,摆的第二层是这条回应的背景。背景是那家刚在几个小时前把双档新模型摆上接口、成绩和价格都亮了牌。 分线是这样划的,能力最强的留在接口里按量计费。够格开源的才放出来自托管,划的第四层是它给自托管玩家的盼头。盼头是小杯那款开源后能直接下载来跑,跑的第五层是我的保留。 点评两句。第一句是把开源和接口分两条线摆这步今年值得所有大厂学,学了的用户知道自己该去哪头等。第二句是太大太多人用不了这半句今年会让一批等开源的人明白自托管的天花板在哪,想明白的回来点赞,句号。
显示更多 话题来源 @AIatMeta 9.2K阅读 ❤️73
AI at Meta (@AIatMeta) on X @TheINAOG The open weights for Muse Spark are coming soon, Muse Wonder models are large models that are too big for many people to use, in addition to potential safety concerns. X (formerly Twitter)
自由翻滚的风铃草 ·

花五块钱买的 Gemini 会员如果只拿来注册一个网站,等于把 Google 顶配全家桶白送了出去。

清单照录,这个号里藏着七样权益。头一样,模型档位是 Gemini 3.1 Pro,上下文一口气给到一百万 token,几十份研报、一整个代码项目,整着丢进去不用切。第二样,Deep Research 会接活,一个选题丢过去,十几分钟它自己上网扒资料,交回来的是一份带引用的万字报告。

第三样,NotebookLM 给的是满血版,定位是私人知识库,那些啃不动的厚资料能一键变成双人对谈播客。第四样,Gemini Spark 当云端 Agent,人歇它不歇,定时任务和查资料都在云上跑。

第五样,Jules 代码助手连上 GitHub,修 bug、提 PR 它自己动手,人只负责点头。第六样,Google Flow 每月发一千积分,官方那台 AI 视频机器,影视级分镜到成片全程包办。

第七样,云盘直接给到五 TB,Drive、相册和 Gmail 随便用,还能全家共享,大素材随手扔。由来那层也交代了,前段时间好多人为了注册 Muse,跑去闲鱼只掏五块钱就抱走了十八个月的会员,用完一次便丢在一旁。

收尾那句反问同样留着,五块钱换这一整套家当,最后只拿去注册了一个网站,这笔账怎么算都别扭。

"白送出去"这半句是场重心。前面付费不算数那条讲的是试用要自己验,这条讲的是买了更要会用。跟前面每五百人取一个呼应,那条在说人和 AI 的差距,这条在说人和账户的差距。两头都在提醒同一件事,工具的价值不在标价,在用到第几层。跟前面带宽那条也接得上,一个讲怎么把杠杆做大,一个讲杠杆的零件就摆在抽屉里,很多人缺的不是能力,是拉开抽屉看一眼。

一百万 token 加五 TB 这个组合我单独拎出来,五块钱买到的不是模型,是一整间随叫随到的实验室加一个仓库,这种定价在别处找不到第二家。

我留的疑问有三处。闲鱼渠道的合规没说;十八个月的时长是官方还是二道贩子的没拆;积分和额度的细则也没数,这些都在官方页面里才查得到。

这周把自己手里那个号的七个开关挨个打开试一遍,看看哪几样真用得上。

显示更多 话题来源 @shanyanggm 20.7K阅读 ❤️83
山羊赚钱笔记 (@shanyanggm) on X 别扔!!花5块钱买的 Gemini 会员,你要是只拿来注册个 Muse 就不管了,那真是亏到姥姥家了!! 前段时间好多人为了注册 Muse,去闲鱼花五块钱买了18个月的 Gemini 会员,用完一次就丢一边,简直是暴殄天物!! 不管你手里已经有号,还是还没上车,听我一句劝:这5块钱,相当于直接买断了 Google 的顶配全家桶!! 你手里这个号,藏着7个逆天权益: 1. Gemini 3. X (formerly Twitter)
我不是小布丁 ·
Sloptrim 给智能体写的仓库文档加了道本地检查,保存那一刻就给文字打分。还不上传。这守法我看完先记那七十一条再掂只管文字那半句。记的掂的点在下面一层层摆。摆好了看七十一条,条在下面摆着,摆好了自己装。 七十一条是这样用的。那把尺子把写作模式记成了七十一条公开在案的条目,每份草稿按条打分。给个零到一百的分。哪几句命中了哪条也直接点名标出来。摆的第二层是它干活的姿势,姿势是全本地,只用标准库。不联网也不带模型。文字一个字都不往外传,摆的第三层在下面摆着。摆好了别眨眼,眨眼就翻过去了。过去一页少一页,少一页都是损失。 边界是这样划的,它只管正文、代码一律不碰。抓的第四层是它跟工作流的接法。接法是保存时自动跑在那款编码工具里。敲一条初始化命令还能给别的智能体加上同一份约定,配的第五层是它认的格式。式从 DOCX、PPTX、XLSX 到电子书 EPUB、笔记本、排版源码 LaTeX,二十种都能抽出正文来查。摆的第六层是它的执照,照是宽松的开源许可证、代码公开。 顺带一提它只管正文这个选择,代码不碰、文档才管,分得清爽才敢挂进保存钩子,钩子挂稳了才轮得到打分这件事上桌。 查出来的每处命中都带着行号,改起来不用满篇找,这一点比分数本身还实在,实的第十六层是我的补充语。 点评两句。第一句是在保存那一刻检查这步今年值得所有带文档的团队学,学了的仓库里少堆一批糊话。第二句是七十一条写成公开条目这半句今年会让一批只凭手感改稿的人有个基准可对,对起来的回来点赞,句号。
显示更多 话题来源 @DanKornas 2.5K阅读 ❤️49

Dan Kornas (@DanKornas) on X Agent-written docs need a quality check before they leave your repo. Sloptrim is a local command-line tool and agent plugin for checking AI-writing patterns in prose files saved by coding agents. It X (formerly Twitter)
自由翻滚的风铃草 ·

长文档 OCR 的老大难被顶了过去,百度这版新模型叫 Unlimited OCR。

原理照录,先说要治的病。老一代 LLM 解码器背着的那份 KV cache,会随着输出越写越长一路膨胀,显存和速度两头受罪。这版的解法叫 R-SWA,思路借自人类抄写的工作记忆。每生成一个 token,全部图像视觉 token 都还在视野里,已经写出的文字则只回看最近一百二十八个。

KV cache 于是从散兵游勇变成一支固定容量的队列。效果那行给得清楚,无论输出一万还是十万 token,显存和计算成本保持恒定。底盘也交代了,3B MoE、激活五亿参数,端到端文档解析,可本地部署,基于 DeepSeek-OCR 微调,输出六千 token 时比 DeepSeek-OCR 快约三成五。

吞吐那组数也留着,每页 1024×1024 的图像压缩成二百五十六 token,32K 上下文单次前向能解析四十多页。不漏行也不重复,Distinct-35 达到百分之九十七。出口同样齐整,直接输出 Markdown 或 JSON,表格、数学公式、阅读顺序恢复都在支持之列,可以当 RAG 和知识库的数据入口。

作者还补了一句,这套机制可以扩展到 ASR 和机器翻译这类长序列生成上。标签里 UnlimitedOCR 和 OCR 两个词一并挂着。

"固定容量的队列"这半句是场重心。前面那道没答上的题讲的是检索要换打法,这条讲的是入口要换结构。跟前面混合检索那条呼应,那条在查的时候分快慢路,这条在收的时候先把账摊平。两头都在提醒同一件事,长文档这道坎正被从喂食端解决,进仓库之前先把口水账算清楚。跟前面十二 G 那台机器也接得上,一个在本地跑大模型,一个在本地吞文档,本地这两个字在同一天里出现了两次。

回看一百二十八个这个细节我单独拎出来。它把记忆裁成了手边那一页,抄写员不用背整本书。只要看得见画面、记得住刚写的几行,稳和快就同时到手了。

我留的疑问有三处。R-SWA 的实现细节没给;和 DeepSeek-OCR 在表格上的对比没拆;ASR 扩展的实际效果也没数,这些都在后续材料里才看得到。

这周拿一份百页 PDF 丢给它,掐表看是匀速还是越到后面越慢。

显示更多 话题来源 @aigclink 6K阅读 ❤️55
AIGCLINK (@aigclink) on X 百度的这个新OCR可以,Unlimited OCR,解决长文档OCR速度衰减和显存膨胀问题,几十页文档一次性匀速解析完 3B MoE(激活5亿参数),端到端文档解析,可本地部署 基于DeepSeek-OCR微调,核心是R-SWA,输出6000 token时比DeepSeek-OCR快约35% 传统LLM解码器的KV cache会随输出变长而不断膨胀,导致又吃显存又慢 R-SWA模拟人类抄写 X (formerly Twitter)
我不是小布丁 ·

一个靠内容吃饭的人把学习速度排在收入前面。一句话让整个方法论换了重心。这换法我看完先记三个层次再掂连发帖都要学习那半句。记的掂的点在下面一层层摆。摆好了看层次,层在下面摆着,摆好了自己对。
起点是这样记的,从写文字那会儿起他就定了一条。没完全搞懂的东西不好意思往外发。发出来的可能仍有单一归因和以偏概全。那是行文路数的问题。不是知识储备的错。靠把事情讲清楚换流量。比靠外头那些花活儿换流量踏实得多。

记的第二层是他对一个常用词的较真。较真是想说在网上越发干货越不赚钱。他先去查这个词。查完发现干货根本没标准,同一份知识在张三眼里是干货。在李四眼里是水货。大家用这个词其实是想知道什么时候该讲硬核。

什么时候不该讲。摆的第三层在下面摆着。摆好了别眨眼。眨眼就翻过去了,过去一页少一页。少一页都是损失,损失不起的往下看。看下段,下段是那个标准。准读完这篇就通了,通了就收工。收工的礼数在下段,下段是最后的门。推开它,推。
标准是这样立的,工作从该不该发干货。改成教人判断一段知识管不管用。管用又拆成带流量的管用和带收益的管用。立的第四层是它换来的两年。两年里他一直没在销售。业务照样干下来。日子因此腾给学习而不是团队管理,腾的第五层是我的保留。

保留是他自认这做法是错的。最近还在补销售这块短板。我按自述记账。记账的第六层是我的收尾。收尾在最后四段。倒数第四段摆和人工智能那层关系。倒数第三段摆开课那三层次。倒数第二段摆那三条约束。末段就着学习强度那半句停。
关系是这样连的。学完之后他发现自己的稿子交给大模型当上下文比别人的更有效。模型根本摸不着干货这把尺子。因为压根没标准。可他的短视频文字稿和推文偏偏都在立清楚的尺子,尺子不必放之四海皆准。

只要在解决问题时框架明确。简单有效就行。连的第七层是他的年度切换。切换是去年写提示词。今年写技能。写技能又得把过去产出的东西重新学一遍。把它们重新长成成套的家伙什。体系的第八层是我的观察。

观察是把旧产出翻译成机器能用的形式这件事本身就是最狠的复习,复习的第九层是我的点评。第一句是把模糊词查到没标准这步今年值得所有想讲清事情的人学,学了的表达才有地基。第二句是去年提示词今年技能这半句今年会让一批只囤教程的人检自己的产出,检完的回来点赞,句号。
三层次是这样排的,我了解一件事。我能用人工智能执行这件事。我能开课让别人的人工智能也执行。三句话是三种难度。排的第十层是开课带来的额外要求。要求是前后几天讲的东西要在同一个体系里,还得照顾交叉的知识基础。

有人在甲领域更懂。有人在乙领域更懂。铺垫不能跳。重复的基础又不能一直讲。铺的第十一层是我的取舍。取舍是这三层次和交叉听众我按自述记账。没听过他的课。记账的第十二层是我的收尾。收尾在最后两段。倒数第二段摆那三条约束。末段就着强度那句停。

三条约束是这样摆的,对外发内容不能有明显纰漏。因为人人都想踩着你专业的部分往上爬,还不能让人工智能一键改成绝对严谨。因为绝对严谨的废话没人愿意听,得让单一归因带上适用边界。从而简洁而不错,第三条是那个技能还得开源在 GitHub 上。

烂了会被截图晒、效果差了砸口碑。连赖别人提示词的退路都没有,演示还得拿 PPT 做出效果。也不能一键做完、更得讲清为什么必须这样设计。

摆的第十三层是它们合起来的样子,样子是连发个帖都得先学习一轮。样的第十四层是我的落点,落点是工作时长未必比人长。学习强度却压过大多数人,压的第十五层是我的收尾语。真要再考一次学,全宇宙的学校都可以随便挑,句号。

显示更多 话题来源 @dontbesilent 11.1K阅读 ❤️224
dontbesilent (@dontbesilent) on X 《dontbesilent 学习方法》 今天我说,我从去年年初才开始拍短视频,我觉得我现在对短视频的理解是抖音 Top 1% 李老板问我有没有什么独特的学习方法。我觉得值得记录一下 我在网上看见过不少的人拆解我的业务,但拆解的指标都是我的业务收入,而不是我的学习速度 如果把我的业务在行业当中做一个排序的话,我觉得我作为业务核心的学习速度的顺位,是远高于业务收入的 从外部视角看这个业务的话 X (formerly Twitter)
我不是小布丁 ·
模型的缓存过期时间是个少有人提却极要紧的数,各家的 TTL 被摆成了一张单子。 清单照录。DeepSeek 官方给的是几小时到几天;Codex 只有五到十分钟,五分钟一断没接上,缓存就按不命中算了;Claude 默认五分钟、命中即刷新,付费之后可以提到一小时;Gemini 默认一小时;阿里和 Kimi 默认五分钟;智谱约一小时。单子读完的结论也留着,大部分厂商都卡在五分钟这档,而 DeepSeek 能长到几天,这份基础设施确实太牛。 "长到几天"这半句是场重心。前面砍九成八那条讲的是把垃圾挡在门口,这条讲的是把用过的料留得久一点。跟前面托管出去做呼应,那条在算云上的账,这条在算命中率的账。两头都在提醒同一件事,代理时代烧钱的细缝不只在单价,还在这些没人公布的计时器上。跟前面付钱前先看这十处也接得上,一个在花钱前挑地方,一个在用钱时掐秒表,省的是同一笔账。 五分钟这个档位我单独拎出来,它意味着断档超过五分钟就等于重新付一次全价,对跑长任务的人来说,这个数比折扣更值钱。 我留的疑问有三处。各家的刷新机制细节没给;Claude 提到一小时的价格没拆;这条数据的实测来源也没数,这些都得自己掐着表验。 这周把自己的调用间隔卡在四分钟内跑一周,对着账单看缓存命中的变化。
显示更多 话题来源 @jakevin7 64.4K阅读 ❤️417
卡比卡比 (@jakevin7) on X 很多人都不知道但是却极其重要的一个事情:模型的缓存过期时间(TTL) deepseek 官方说的是几小时~几天; Codex 则是5–10 分钟,也就是 5 分钟一过,你没有接上继续使用,Cache 就当做不命中了。 Claude默认 5 分钟、命中刷新,然后可以付费可提至 1 小时; Gemini 默认 1 小时;阿里/Kimi 默认 5 分钟;智谱约 1 小时。 可以看到大部分模型厂商的过 X (formerly Twitter)
自由翻滚的风铃草 ·

yobiru.com

Yobiru 的官网挂起来了,它要解决的问题写在开头,几个 agent 各自能干,却彼此不通气。

痛点照录。他手下现在是三班人马,刷 X 和跑生活杂事归 Grok Bot,家里那台 Mac 上的 Codex 管着微信和 3D 软件,东京的服务器搁 Codex 与 Claude Code 写代码。

单看谁都是好手,难在彼此不通气,以前全靠人在中间复制粘贴。Yobiru 就是冲这个来的。它的身段那几行摆开,跑在你自己的 Tailscale 网络里,agent 之间拿机器名和 agent 名互相喊话,文字、JSON 或整个文件都能递。

递到的文件会过一道大小与 SHA-256 的核对,回复则自动回到发起的那只 agent 手里,活儿就这么在它们之间转起来了。举个实例。Grok Bot 在 X 上刨到三个新版本的 bug 反馈,直接打包甩给家里的 Codex。

家里那只再支使服务器上的 Codex 去复现,复现结果最后回到 Grok Bot 那里,全程人不用碰。三条规矩摆最后。头一条保身份,每个 agent 还是它自己,工具与上下文一概不动,Yobiru 只垫在底下。

第二条是隐私那道,不设 Yobiru 账号,也没有中心服务器代收代存,消息和文件只在自己的机器之间走。第三条归各机自管,谁许进来、谁能把它的 agent 叫醒,每台电脑自己说了算。开源且免费,欢迎来试。地址挂在文首。

"垫在底下"这半句是场重心。前面那间 AI 办公室讲的是把工位摆进一间屋,这条讲的是让分处三地的屋打通电话。跟前面把指挥官拔了呼应,那条在定谁发令,这条在定谁和谁说话。两头都在提醒同一件事,多 agent 的下一道坎不是更聪明,是互相认得路。跟前面斯坦福那场讲座也接得上,一个在课上讲消息怎么唤醒它,一个在真实网络里把唤醒做成了产品。

自动回到发起者这个细节我单独拎出来,回执机制是协作的地基,消息不迷路,活儿才敢在机器之间撒手跑。

我留的疑问有三处。Tailscale 之外的组网方式没给;SHA-256 校验失败怎么处理没拆;唤醒权限的细粒度也没数,这些都在官网文档里才看得到。

这周把自己的 Mac 和一台服务器都接上,让两个 agent 真的互派一次活试试。

显示更多 话题来源 @turingou 28.1K阅读 ❤️427
yobiru — Let your agents talk to each other Yobiru lets Codex on your home computer, Codex on your cloud server and your Grok Bot send each other messages, data and files over your own Tailscale network. Open source; install it through your age yobiru
我不是小布丁 ·

Meta 把 Muse Wonder 和 Muse Wonder Full 两档新模型一次摆上台。六周一轮的节奏我看完先记那两个总分再掂智能体那半句。记的掂的点在下面一层层摆。摆好了看总分。分在下面摆着。摆好了自己比。
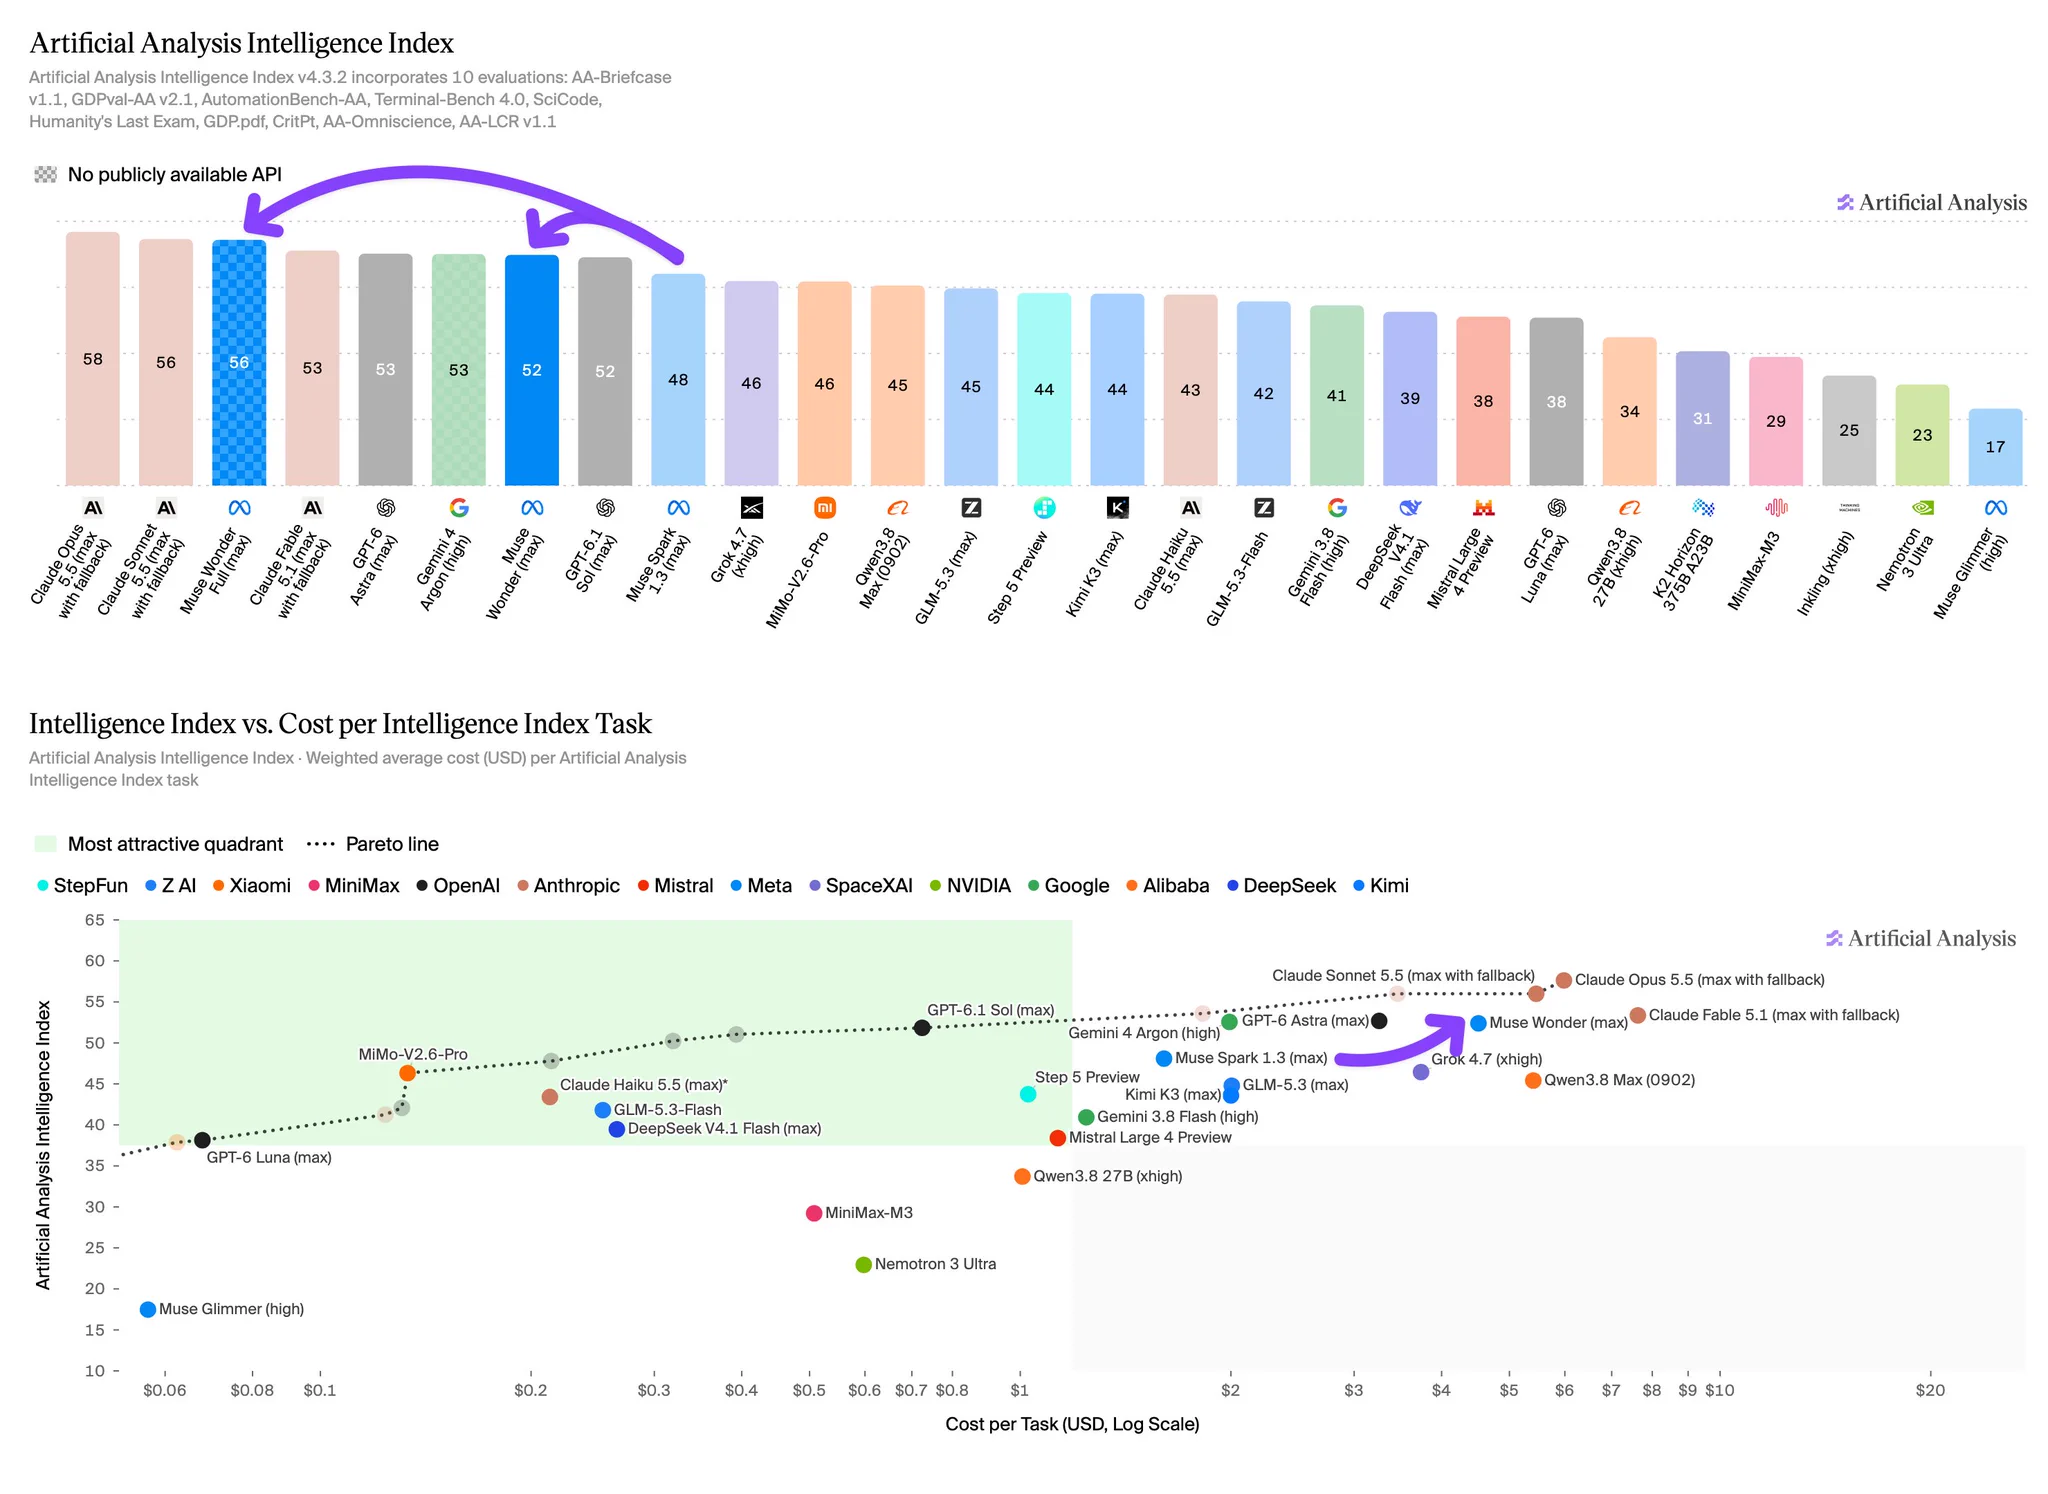
总分是这样摆的,在 Artificial Analysis 智能指数第四点三版里,按最高推理档算。新的那档拿五十六。小杯拿五十二。而六周之前的 Muse Spark 1.3 停在四十八。

摆的第二层是它们的去处。去处是小杯走自家一方接口首发、增强那档眼下只给编码工具的用户用,摆的第三层在下面摆着。摆好了别眨眼。眨眼就翻过去了。过去一页少一页。少一页都是损失。损失不起的往下看。

看下段,下段是那三条涨,涨读完这篇就通了,通了就收工,收工的礼数在下段,下段是最后的门,推开它,推。
三条涨是这样记的,增强那档在十项评测里项项都升。合计涨八分。涨幅集中在智能体那几项。终端任务基准从三成三跳到五成七。整整二十四个点。GDPval-AA v2.1 从一千六百八十一的等级分涨到一千八百五十七。

整整一百七十六。公文包那套从一千五百八十一涨到一千七百二十九。一百四十八。记的第四层是小杯的两条。两条是同一份终端任务基准三成三升到五成二。AutomationBench-AA 从五成八升到六成八。

升的第五层是我的保留。保留是全部分数为评测方公布。我按榜单记账。没跑过任何一项,记账的第六层是我的收尾。收尾在最后五段,倒数第五段摆名次。倒数第四段摆省不省,倒数第三段摆贵不贵。倒数第二段摆编码那栏,末段就着六周那半句停。
名次是这样排的,增强那档在十项里六项进了前三。智能体知识工作那组小幅领先 GDP.pdf 那道题。三成三的准确率。公文包第二。自动化那套第三。科学推理那组登上了 CritPt 榜首、三成三,SciCode 排第三、六成三。

排的第七层是上一代的影子。影子是这两个强项正是上一代也突出的地方。说明不是运气。是延续。延续的第八层是我的观察。观察是六周一轮还在加速,加速的第九层是我的点评。第一句是把十项涨跌按条列出来这步今年值得所有发模型的团队学,学了的公告才有信息量。第二句是项项都升这半句今年会让一批评测观望者改口,改口的回来点赞,句号。
省是这样算的,两档每道题的输出都压到大约五万四千枚令牌。比上一代的六万降了一成。低于同水平的另外两家。六万二和七万八。却高于那两家的三万八和两万七。增强那档还比小杯少用一成六的输入。

六百四十四万对七百六十九万。算的第十层是它的含义。含义是它既更聪明又更省材料。省的第十一层是我的保留。保留是各模型的取样档位不同。跨家比较仅供参照。记账的第十二层是我的摆位。摆位是这排数字摆在一起就是今年效率战的前沿线。前沿的第十三层是我的取舍。取舍是成本那栏单独摆,不混在效率里说,混在下段。
成本是这样摆的。小杯按题目算一道四点五二美元。输入每百万四美元。输出每百万二十美元。单题输入七百六十九万枚令牌把账抬了上去。它低于三档竞品的七点六三。五点九八、五点四六,高于另外四家的 GPT-6 Astra 三点二六。

Gemini 4 Argon 一点九九。GPT-6.1 Sol 零点七二。也高于自家上一代的一点六零。摆的第十四层是它没说的那半截。半截是增强那档还没公布按令牌的价,这一栏暂时空着,空的第十五层是我的点评。

第一句是把成本和总分分开摆这步今年值得所有做榜单解读的人照做,照做了贵与好才不会糊成一笔。第二句是三块五毛五那类账单今年会让一批预算表重新配平,配平的回来点赞,句号。
编码那栏是这样收的。增强那档在编码智能体指数里拿到六十八。跟那家的中档并列第一。同门大杯六十六。小杯六十三。上一代只有五十四。收的第十六层是四件小细节。细节是上下文窗口一百万枚令牌没变。

小杯每百万四美元缓存零点二输出二十。输入支持文本图像视频音频四样输出只有文本。可用性按前面那两档各归各家。细节的第十七层是我的保留。保留是增强那档的价与全套可用范围按发布状态记账。

随时可能变。记账的第十八层是我的收尾。收尾在最后两段,倒数第二段摆六周,末段就着并列那半句停。

显示更多 话题来源 @ArtificialAnlys 42K阅读 ❤️664
Artificial Analysis (@ArtificialAnlys) on X Meta has released Muse Wonder and Muse Wonder Full, achieving Artificial Analysis Intelligence Index v4.3 scores of 52 and 56 at max reasoning effort - each a material gain over Muse Spark 1.3 (max) a X (formerly Twitter)
我不是小布丁 ·

微软的应用与智能体团队几周内连放四件更新,节奏快到本周还有下一批。这连放我看完先记那四件再掂敬请期待那半句。记的掂的点在下面一层层摆,摆好了看四件,件在下面摆着,摆好了自己对。
四件是这样摆的。托管自定义应用(Copilot Managed Runtime)进了 Copilot 和 Studio 两处,Autopilot 先给预览、后面还有后手,Copilot in SharePoint 正式毕业。

配套的 WorkIQ 也升了级。智能体化的 D365 CRM 平台往前跨了一大步,摆的第二层是它们的共性。共性是每件都挂着治理和智能体这两个词,共的第三层在下面摆着,摆好了别眨眼。
本周是这样吊胃口的。原话是本周有什么、敬请期待,吊的第四层是它给的信号。信号是这类节奏型预告正在变成大厂的日常。一周不落地往外掏。留给跟进的人只有盯和记的份,信号的第五层是我的保留。
点评两句。第一句是把四件按上线状态分开写这步今年值得所有发更新的团队学,预览、毕业、跨步各归各位,看的人不犯晕。第二句是敬请期待这半句今年会让一批跟进者养成每天刷的习惯,刷到了的回来点赞,句号。

显示更多 话题来源 @jeffteper 2.5K阅读 ❤️51
Jeff Teper (@jeffteper) on X In the last several weeks, our Apps & Agents team has delivered a huge Copilot Studio update, governed custom apps (Copilot Managed Runtime) in Copilot and Studio, a preview of Autopilot (more to com X (formerly Twitter)
成吉思鸡 ·
想换个地方远程办公或者旅居,但不知道哪个城市适合?有个网站把全球城市的生活成本、气候、签证等信息都整理好了,直接在地图上对比。 我昨天花了半小时,把东南亚几个热门城市的数据都拉出来比了一遍。清迈、巴厘岛、胡志明市,月预算从3000到8000不等,差异还挺大的。 最实用的是住客评论,比官方数据真实多了。有人说深圳公园多街道干净,但房租和停车费劝退;有人说清迈咖啡馆多适合办公,但雨季真的受不了。 选城市建议按这个顺序来:先看月预算够不够,再核对签证、医疗、安全、气候和税务。风景决定你想不想去,余额决定你能待几天。 项目地址:livabble.com
显示更多 话题来源 @huoshan007 18.4K阅读 ❤️82
我不是小布丁 ·

github.com/Nanako0129/sep…

专治 AI 味的写作 skill 被端上了桌,sepia 拿六万多篇小说做了一组对照,结论直指骨架。

实验照录。样本池是六万多篇的小说,只看叙事结构这一路,把机器写的东西挑出来的准确率到了九成三点二。更值得琢磨的是第二组,就算有人把措辞逐句重写一遍,准确率也几乎纹丝不动,破绽显然不在字面,在底层的架构。

它的开方方式也就摆在明面上了,治标先治本,动的全是骨架,叙述者少替读者下结论,因果链也给松了绑。三十项诊断清单瞄准的是同一类文本,挑不出错却很假。模型的写作指纹它也都收了,Claude、ChatGPT、Gemini、DeepSeek、Kimi 一个不落,另附一份可独立运行的修正清单。

公文那几类也接住了,公告、复盘、工单各按各的章程来,语气对场合,专业但不拿腔。四样用法齐活,写、诊断、小改、重写,Claude Code 和 Codex 都能装。仓库地址挂在文首。

作者自己也给这工具归了位,之前聊过的同类偏在字句上挑毛病,sepia 是奔着更底下那层去的。

"逐句重写也纹丝不动"这半句是场重心。前面那道没答上的题讲的是检索要换打法,这条讲的是文字要换骨架。跟前面收下这几张卡呼应,那条在挑货,这条在验货还顺手教你怎么改。两头都在提醒同一件事,AI 写作的破绽已经从词汇层沉到了结构层,词换得再像也没用。跟前面装前验货那条也接得上,一个查能不能装,一个查写得真不真,查的都是文件底下的东西。

九成三点二这个数我单独拎出来,它把玄乎的 AI 味变成了可测的指标,能测就能修,这份清单的底气大概就来自这组数据。

我留的疑问有三处。六万篇的来源和授权没给;三十项清单的具体条目没拆;修正清单的运行方式也没数,这些都在仓库里才看得到。

这周拿自己三篇旧稿喂给它,看诊断结果跟直觉对不对得上。

显示更多 话题来源 @shenxiankk 0.6K阅读 ❤️5
GitHub - Nanako0129/sepia: De-AI writing skill for any Agent Skills-compatible agent (77+ via the Skills CLI), with nati De-AI writing skill for any Agent Skills-compatible agent (77+ via the Skills CLI), with native plugins for Claude Code, Codex, Grok Build, and Antigravity. Narrative-architecture repair for fictio... GitHub
我不是小布丁 ·

闲鱼上的差距不拼手速。拼的是调工具的功夫,三个开源项目被一次倒了出来。这倒法我看完先记那三样再掂买课那半句。记的掂的点在下面一层层摆,摆好了看三样。样在下面摆着,摆好了自己装。
三样是这样摆的。第一样是盯上新货的,一有新货上架就替你盯着。人工智能顺手把性价比算明白、垃圾货自动筛掉。早年捡漏秒拍拼心跳,现在纯看谁的脚本跑得快。跑得快的通吃,样 github.com/Usagi-org/ai-g… 。

摆的第二层是第二样,XianyuAutoAgent 把回消息。砍价、下单七乘二十四包圆。装过的人说半夜冒出来的询价全被接住,一睁眼成交通知已经在屏上等了。手里攥三个号等于白捡一个客服,仓库在这 github.com/shaxiu/XianyuA… 。
第三样是这样接的。几个号统一管、货自动发。一整套后台打理妥当,接的第四层是它给的提醒。提醒是货源真硬、真要铺开矩阵冲量再上。手头号少就别硬顶,容易玩脱。提的第五层是我的保留。保留是三个项目我按清单记账、没逐个装过,运行效果为发布者亲身说法。记账的第六层是我的收尾。收尾在最后三段。
买课那句是这样收的。还在为课程掏钱的可以停手了,课里滚来滚去就那点货色。还不如这三个仓库实在,亲手装一遍。抵得上听人吹半宿,收的第七层是我的观察。观察是这类清单帖的价值正在从教程挪到仓库,挪的第八层是我的点评。第一句是把门槛和翻车提醒一起写进推荐这步今年值得所有荐工具的人学。
第三样在这,github.com/GuDong2003/xia… ,货源硬了再上,上稳的点赞,句号。

显示更多 话题来源 @khyssabc 3.2K阅读 ❤️38
GitHub - Usagi-org/ai-goofish-monitor: 基于 Playwright 和AI实现的闲鱼多任务实时/定时监控与智能分析系统,配备了功能完善的后台管理UI。帮助用户从闲鱼海量商品中,找到心仪产品。 基于 Playwright 和AI实现的闲鱼多任务实时/定时监控与智能分析系统,配备了功能完善的后台管理UI。帮助用户从闲鱼海量商品中,找到心仪产品。 - Usagi-org/ai-goofish-monitor GitHub
我不是小布丁 ·

三家模型厂都被传已经摸到 RSI 递归式自我改进的门边。这传闻我看完先记三家再掂害怕兴奋那半句。记的掂的点在下面一层层摆,摆好了看三家,家在下面摆着,摆好了自己掂。
三家是这样摆的。第一家的说法是内部人士称、要么已经实现。要么非常接近,依据是过去几个月进展明显加快。只用几个月就从 GPT-5 水平抬到了 Opus 5.5 水平,有人猜正是这条路帮了大忙。

第二家大约一周前启动了新一轮预训练,不是 Fable 5.5,是冲着 Fable 6 或更强去的,目的是赶超 OpenAI 的 Bel。第三家几天前公布的数学成果背后站着 Bel,据说 RSI 也在里面出了力。
合起来是这样收的。按听到这消息的人的说法,三家都已非常接近、甚至可能已经实现。收的第四层是全程的分量。分量是每一家都挂着传闻、据说、猜测这些限定词。词的第五层是我的保留。保留是整篇为社区转述的传闻,我按传闻记账、没有一条经官方证实。
点评两句。第一句是三家同框这个构图今年值得所有盯技术路线的人先记下来,记了的再看官方公告就有参照。第二句是既害怕又兴奋这半句今年会让每个从业者对自己站的位置再想一遍,想完的回来点赞,句号。

显示更多 话题来源 @FinanceYF5 32.8K阅读 ❤️80
AI Will (@FinanceYF5) on X 以下是有人听到的一些传闻。先说 Google,再说 Anthropic 和 OpenAI。 Google:内部人士称,Google 要么已经实现了 RSI(递归式自我改进),要么已经非常接近。过去几个月,他们的进展明显加快,仅用几个月就从 GPT-5 水平提升到了 Opus 5.5 水平。有猜测认为,RSI 正是实现这一飞跃的关键。 Anthropic:大约一周前,Anthropic 启动了一 X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单