 小白爱摸鱼
@chaozuoye
蚂蚁开源了一套声纹验证模型 AntSpeaker/MECT,超小、可实时跑:100ms 低延迟下保持高精度的声纹特征提取(细节以官方发布为准)。
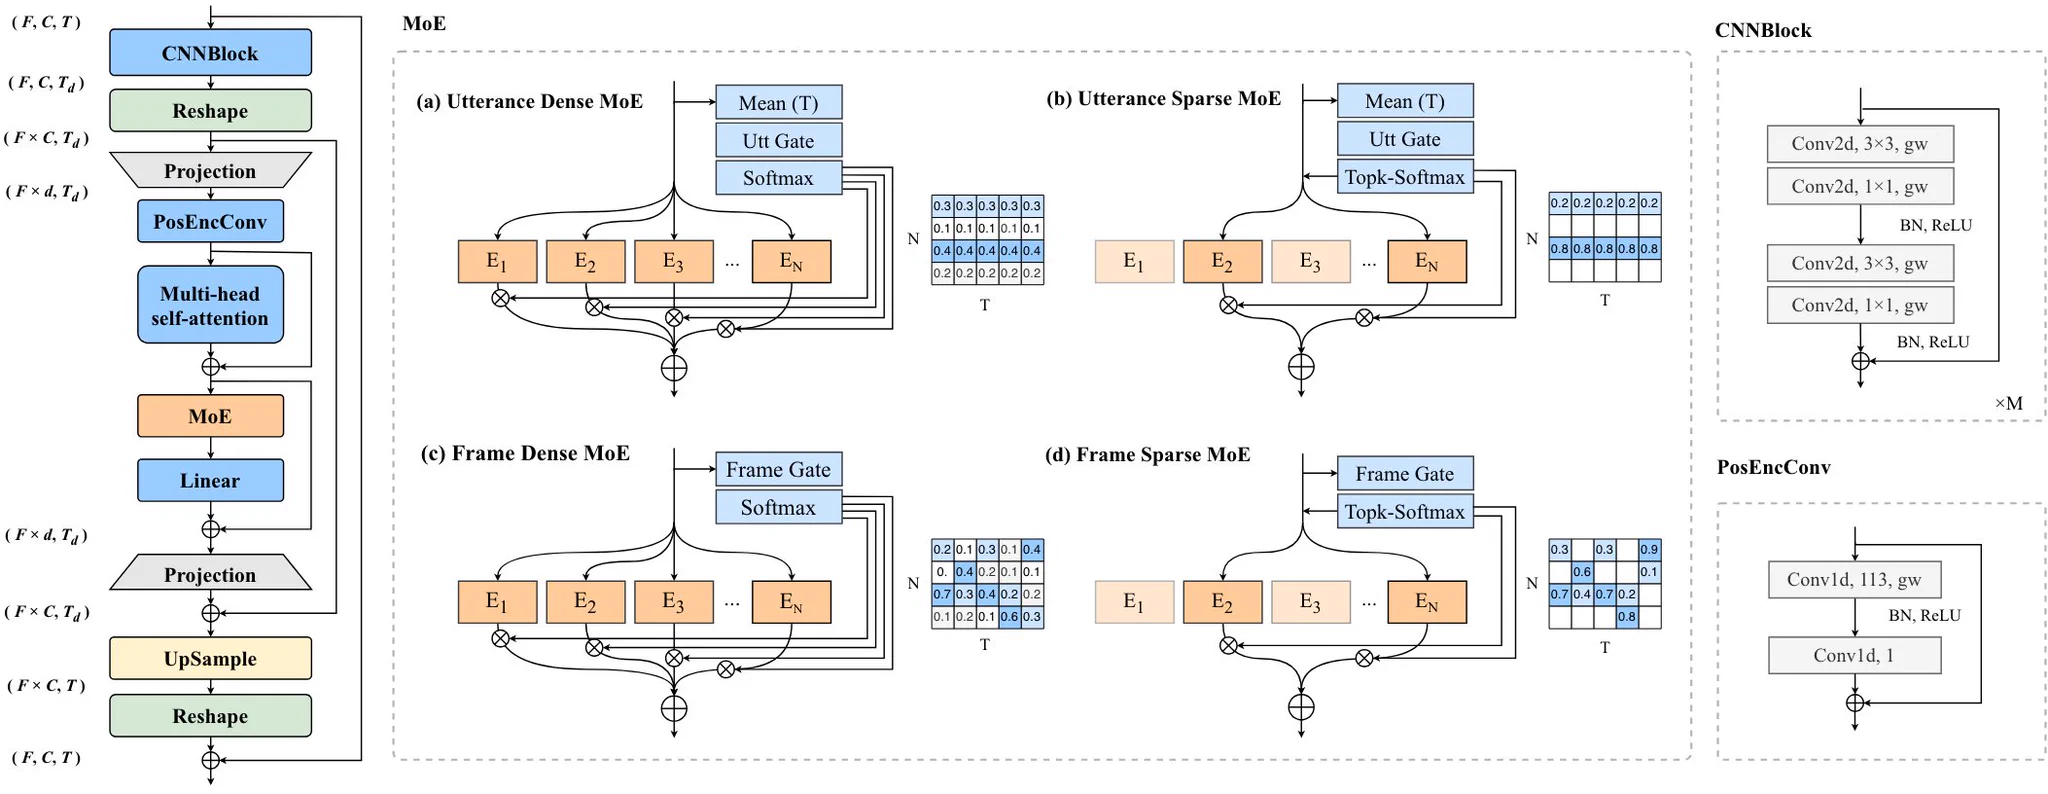
数字部分是这篇的硬通货。他们把 MoE 引进了全监督的声纹训练,用一个 957 万参数的小模型,在 VoxCeleb1 上追平、平均指标反超了 5.87 亿参数的预训练模型——参数差 61 倍,小的那个赢了。
这等于把"专家分工"这套大模型的看家玩法,原样搬进了一个小模型的全监督任务里:不是把一切知识塞进一个大脑,而是让门各归其位、按需唤醒。晚上刚聊过模型路由"按环节配",这条给出了它的参数版——任务够窄,专家就够省。
因果重训练那半句决定它能不能落地:100ms 延迟加近离线的精度,意味着模型真的能进实时场景,而不是只能在论文里跑分。声纹验证最怕的就是等——"请说一句话验证身份"说完没反应,体验直接归零;100ms 是把等待压进了人耳察觉不到的区间。
场景给得也直接:银行与客服热线的电话核身、App 登录、设备唤醒只认主人声音——金融核身与端侧解锁是最自然的落点。把它放回语音管线的坐标系,和之前几块拼图正好对上:耳朵(本地听写)、嘴(朗读)、床(音轨分离)、再到今天的"验明正身"——一句"谁在何时说"由时间戳管、"是不是同一人"由声纹管,分工写得清清楚楚。语音链从"能听懂"补到了"可信地听懂"。
给要做语音核身的人一句落地的:先拿你真实环境的声音试——电话信道的压缩、环境噪声、戴口罩说话,这三样是实验室精度的三大杀手;VoxCeleb1 上反超 61 倍是基准的胜利,你的场景信不信,得用你自己的录音测。
269 浏览 0 评论
0 反应












