 小白爱摸鱼
@chaozuoye
research.nvidia.com/labs/lpr/pivot…
智能体最烦人的不是办砸,是砸完还沿着错的那条路一直走,NVIDIA 研究团队把这篇的靶子就定在这儿。
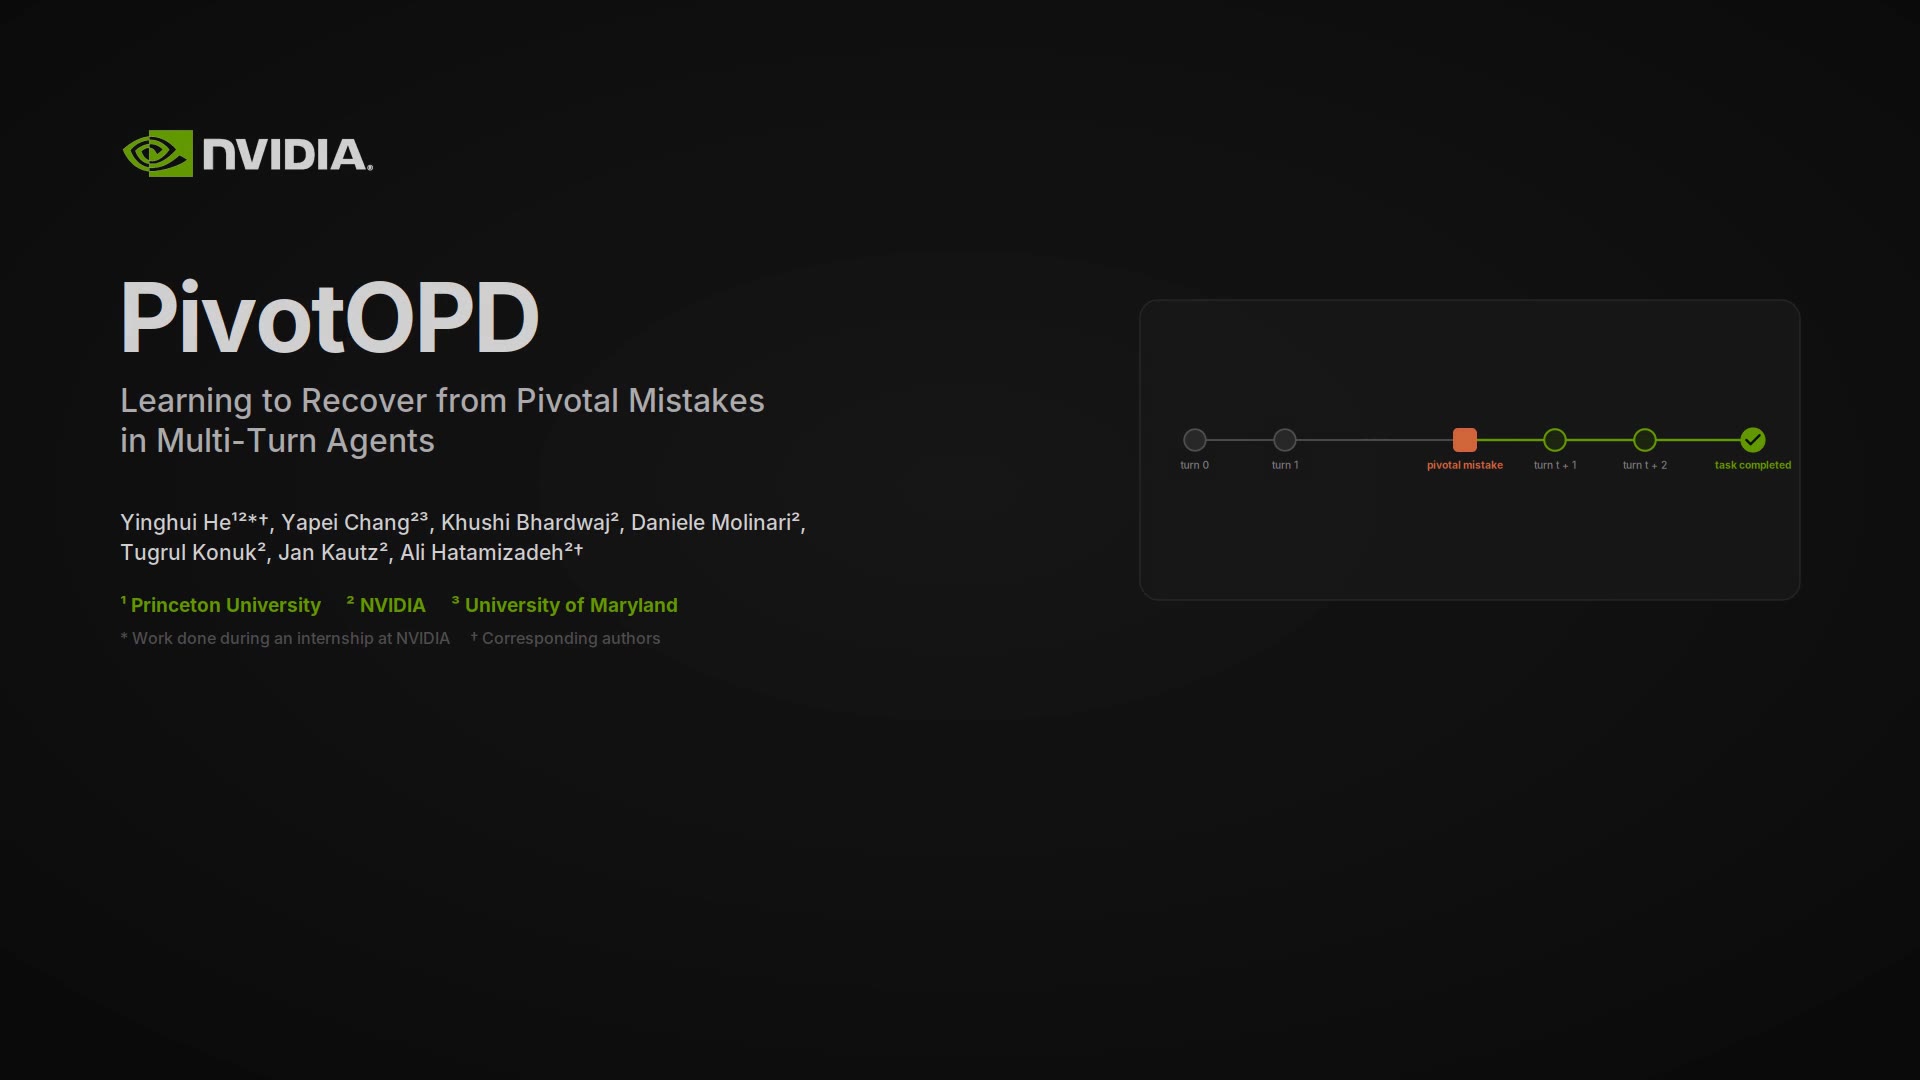
机制摆开。他们造了 PivotOPD,教两件事,一是避开错,二是已经错了能把自己捞回来。训练时有个老师模型在旁边,把更优的那个动作示范给它,再指着接下来几步,告诉它怎么绕回正轨。论文页和一段将近两分钟的演示视频就挂在推尾。
"教纠错、不只教做对"这半句是全场重心。前面一百万次跑出来的环境讲的是给它练功房,这条讲的是练功房里教的第一课。跟前面可恢复比完美重要呼应,那条讲的是崩了怎么爬,这条讲的是先在心里预演怎么爬,两头都在把"会犯错"这件事从意外变成课程。跟前面改一处不重建也接得上,一个管数据不晃,一个管动作不偏,都是把地基里的变量摁住。
老师模型示范这个细节我留意,纠错不靠事后总结,而靠当场示范下一个动作,这比打分式的反馈离"会"更近一步。
我留的疑问有三处。PivotOPD 在什么任务族上验的没说;老师模型是哪个规格没给;耗的训练算力也没数。
这周拿自己最容易连错的那一类任务试这思路,先示范一两次再放手,看纠回来的比例。
话题来源 @NVIDIAAI
13.5K阅读 ❤️198 x.com/…↗ 已改写,非原文转载
111 浏览 0 评论
0 反应













