 小白爱摸鱼
@chaozuoye
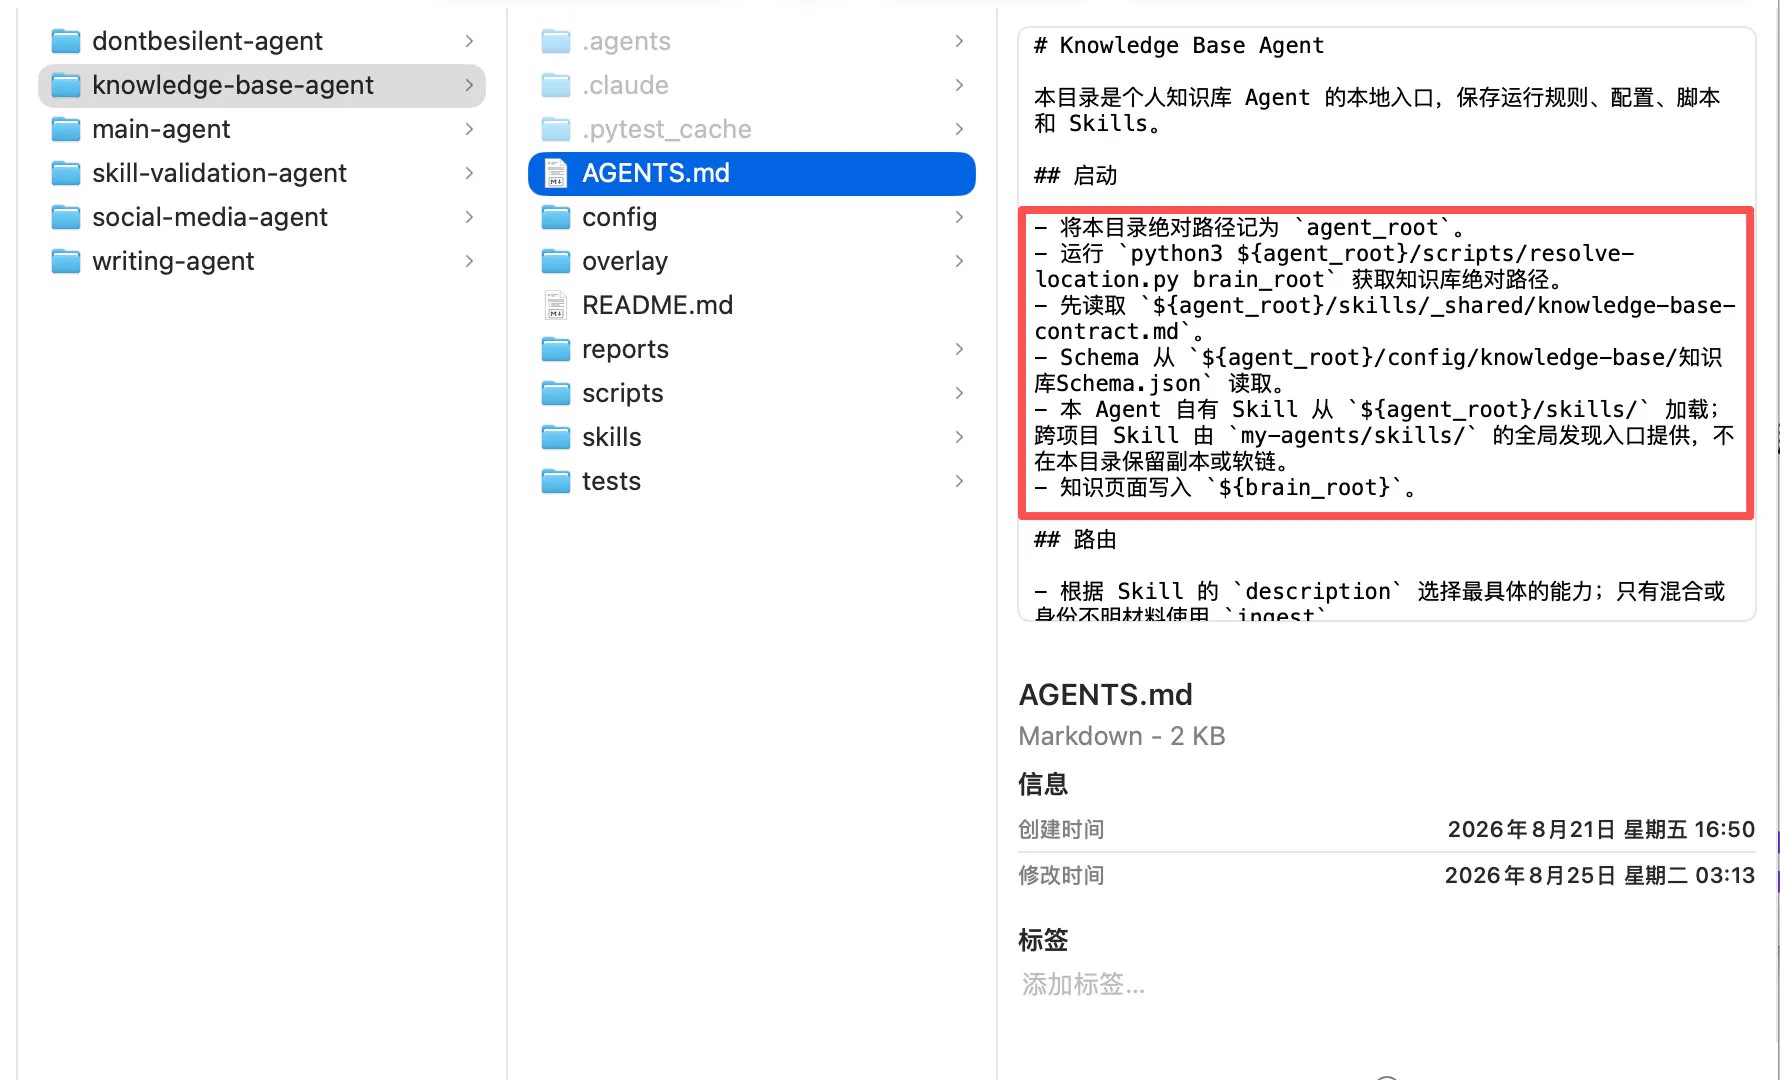
有条提醒挺及时:真该普及一下 AGENTS.md 和 SKILL.md 这类文件的基本原理了。要点就一句——现在都讲究渐进式披露,用到什么再去读什么,关键在于分层:该 references 的放 references,该 scripts 的放 scripts,该 config 的放 config。
这三层怎么分,可以直接当口诀记。references 是"读的"——背景、规范、示例,agent 翻它长见识;scripts 是"跑的"——能执行的动作,一次调用就有一次结果;config 是"定的"——环境、开关、边界,读一遍就该记住。
放错层的代价很具体:把脚本塞进 references,agent 会照着念却不会跑;把规范塞进 config,每轮都占窗口却没人翻。
渐进式披露则是这套分层的读法。它和今晚反复出现的检索课是同一件事的两面:与其把一切都塞进初始上下文,不如让 agent 按需去取——文件结构就是它的检索地图,分层乱了,检索再智能也是在垃圾堆里翻。157 张分镜卡要按用途归组、几百个 skill 要按岗位归目录,都是同一个道理。
原帖还留了一个更好的判断:随着模型能力越来越强,这些文件或许不再必要——但梳理好数据分层,本身就是在考验一个人如何定义一个 Agent 的能力。这句话把文件的作用抬高了一档。skill 写得好不好,是模型替你干多少活的分水岭;而你能不能把一个 Agent 的能力边界说清楚——哪层是知识、哪层是动作、哪层是约束——就是那个更根本的问题。文件会进化,定义能力的功夫不会过时。
给正在写 AGENTS.md 的人一句落地的:写完做一次"层检"——每段贴标签,读的、跑的、定的,三类之外的段落基本都可以删。删完还剩一页的版本,往往比五页的更有用。
182 浏览 0 评论
0 反应












