 会飞的荧
@feitu
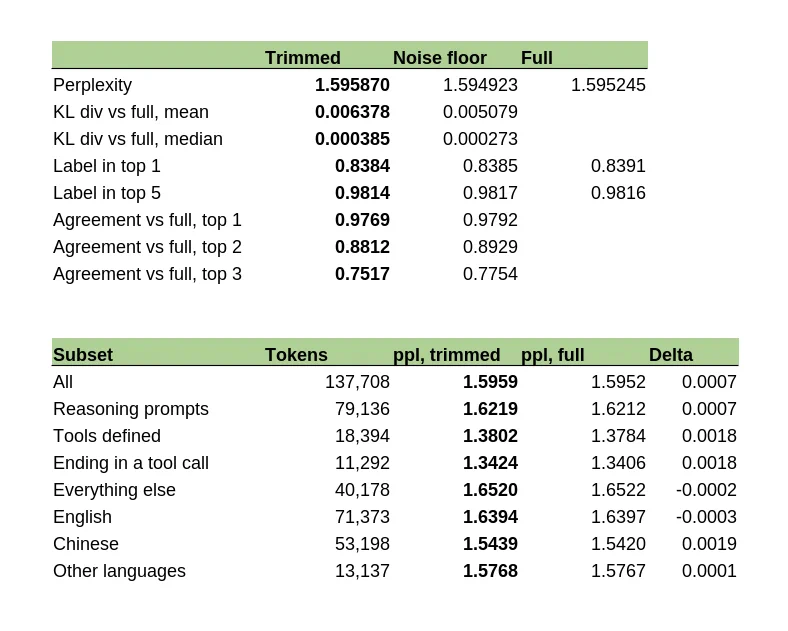
推理圈大牛 turboderp(exllama 的作者)发了个技术疑案:MiMo-V2.6-Pro 似乎有大量冗余权重——他的实验是:删掉第 1 到 12 层的专家块、以及第 1-4、6、8-11 层的注意力块,端到端 KLD 几乎不受影响,这些块对残差的贡献量级约等于 BF16 的舍入误差。
结论一句:大约可以砍掉这个 ~1T 参数模型的 17%,剩下的基本还是同一个模型——相当于六个完整 Qwen 的量。他还很谨慎地问了句:这有人知道吗,谁能证实?
这条的含金量在三个层面。第一,参数量不等于有效参数。MoE 架构把模型撑到万亿级,但"跑起来的聪明程度"和"纸面参数"之间显然有缝隙——17% 的部件对输出几乎无影响,说明其中相当一部分从未真正参与"想"。
这对所有拿参数量当卖点的宣传是个提醒:数字是装机量,不是大脑容量。第二,它把"更省"这条主线推到了最深处:本周各家在卷价格、卷用量、卷 token 成本,而社区直接卷到了物理层——同一种智能,能不能用 83% 的权重跑出来。省下的 17% 对部署方就是实打实的显存与吞吐。
第三层最妙:这种裁剪只在开源世界可行。闭源模型你只能接受厂商给的体积,开源模型的权重躺在你手里——裁剪权在用户。这与"长尾搬回家"那条线严丝合缝:搬回家的不只是模型,还有改它的自由;而 MiMo 恰好是这两天榜单上冲进前八的国产模型,热模型配可裁剪权重,社区的下一步几乎肉眼可见——有人验证,就会有人放出裁剪版。
留一格清楚的口径:turboderp 自己都在求证,这是实验观察、不是官方结论——KLD 接近不等于下游任务无损,真实影响要等社区复跑与官方回应;而且"可砍"的部分或许承担着鲁棒性、长尾能力这些 KLD 测不到的角色。方向极有价值,结论等两轮验证。
给玩本地部署的人一句落地的:先别自己动手砍——等这消息被两三个独立复现确认,裁剪版自然会出现在模型站;现在你该记的是那个数字:17%。它意味着你看到的模型体积里,可能有一块是可以谈判的——下次再为显存发愁时,先问一句"这里面有多少是水"。