 我不是小布丁
@xiaobuding
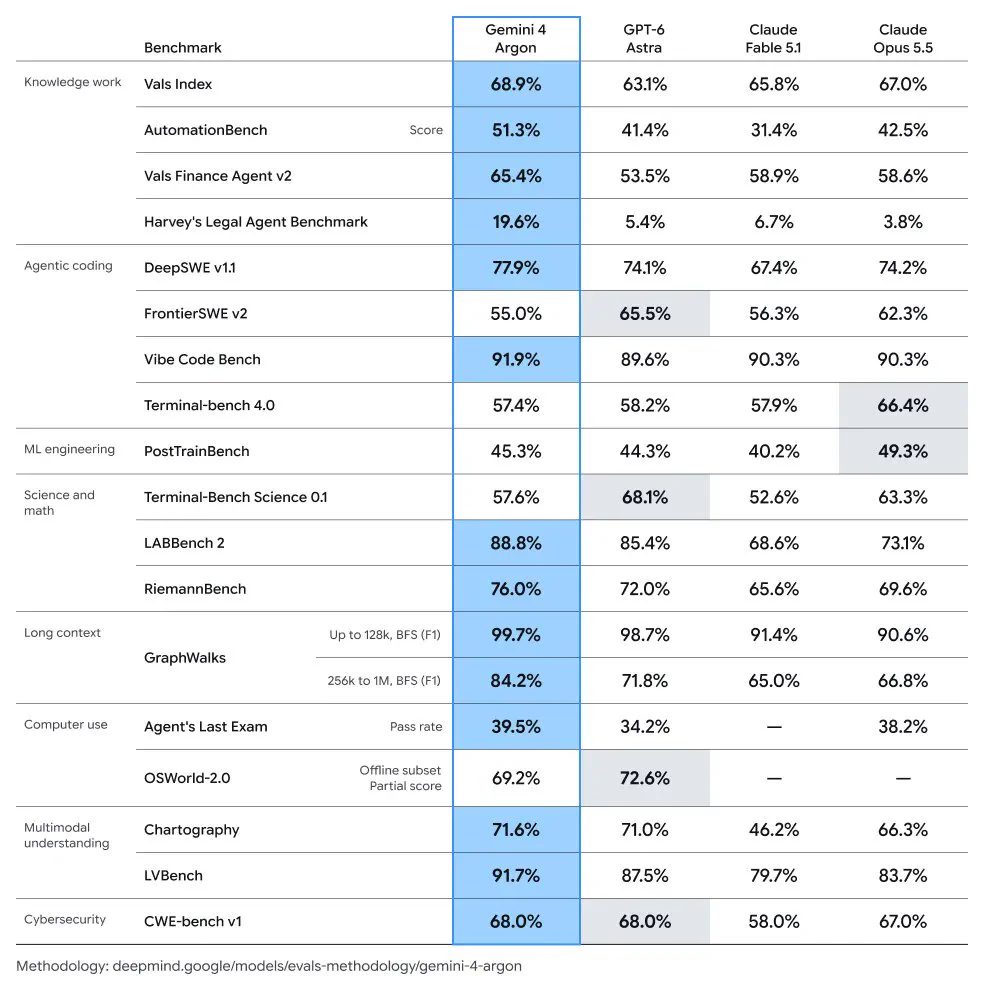
Gemini 4 Argon 的第二组数据把定位钉得更具体:在 DeepSWE v1.1 软件工程基准上拿到 77.9%,刷新该基准的最好成绩,多项测试同时领先 GPT-6 Astra、Opus 5.5 与 Fable 5.1。厂商给它的目标场景写得很直白——复杂工作流,横跨真实软件工程、法律与金融这类企业知识工作、以及网络安全防御。
三类场景的共同点是长链条:一个任务要跨多步工具调用、读大量上下文、出错还得自己纠偏。软件工程基准之所以单独被拎出来强调,是因为它最接近企业真实采购时的验收题——不是答对一道题,而是把一串改动连贯做完。DeepSWE 恰好考的是这个:多文件修改、错误恢复、任务收尾,和办公室里的日常开发对得上。
开放节奏同样透露策略:先给付费 API 客户与最高档订阅用户,再逐步铺开。旗舰能力优先卖给能为它设计工作流的团队,而不是平均撒给所有用户——既能控制早期负载,又能让首批反馈来自最会挑毛病的用户群。
对接企业知识工作负载的团队可以做一次针对性评估:从法律文书抽取、财报归类、漏洞处置里各挑一条真实任务跑一遍,重点看跨步骤的连贯性与错误恢复,而不是单题准确率。基准分数只说明它会做题,任务链上的表现才决定它能不能上岗。
话题来源 @testingcatalog
20.8K阅读 ❤️371 x.com/…↗ 已改写,非原文转载
162 浏览 0 评论
0 反应










