 小白爱摸鱼
@chaozuoye
vllm.ai/blog/2026-10-0…
同一只模型换了跑道,三周之后快出一个量级,这份功课是 vLLM 自己交的。
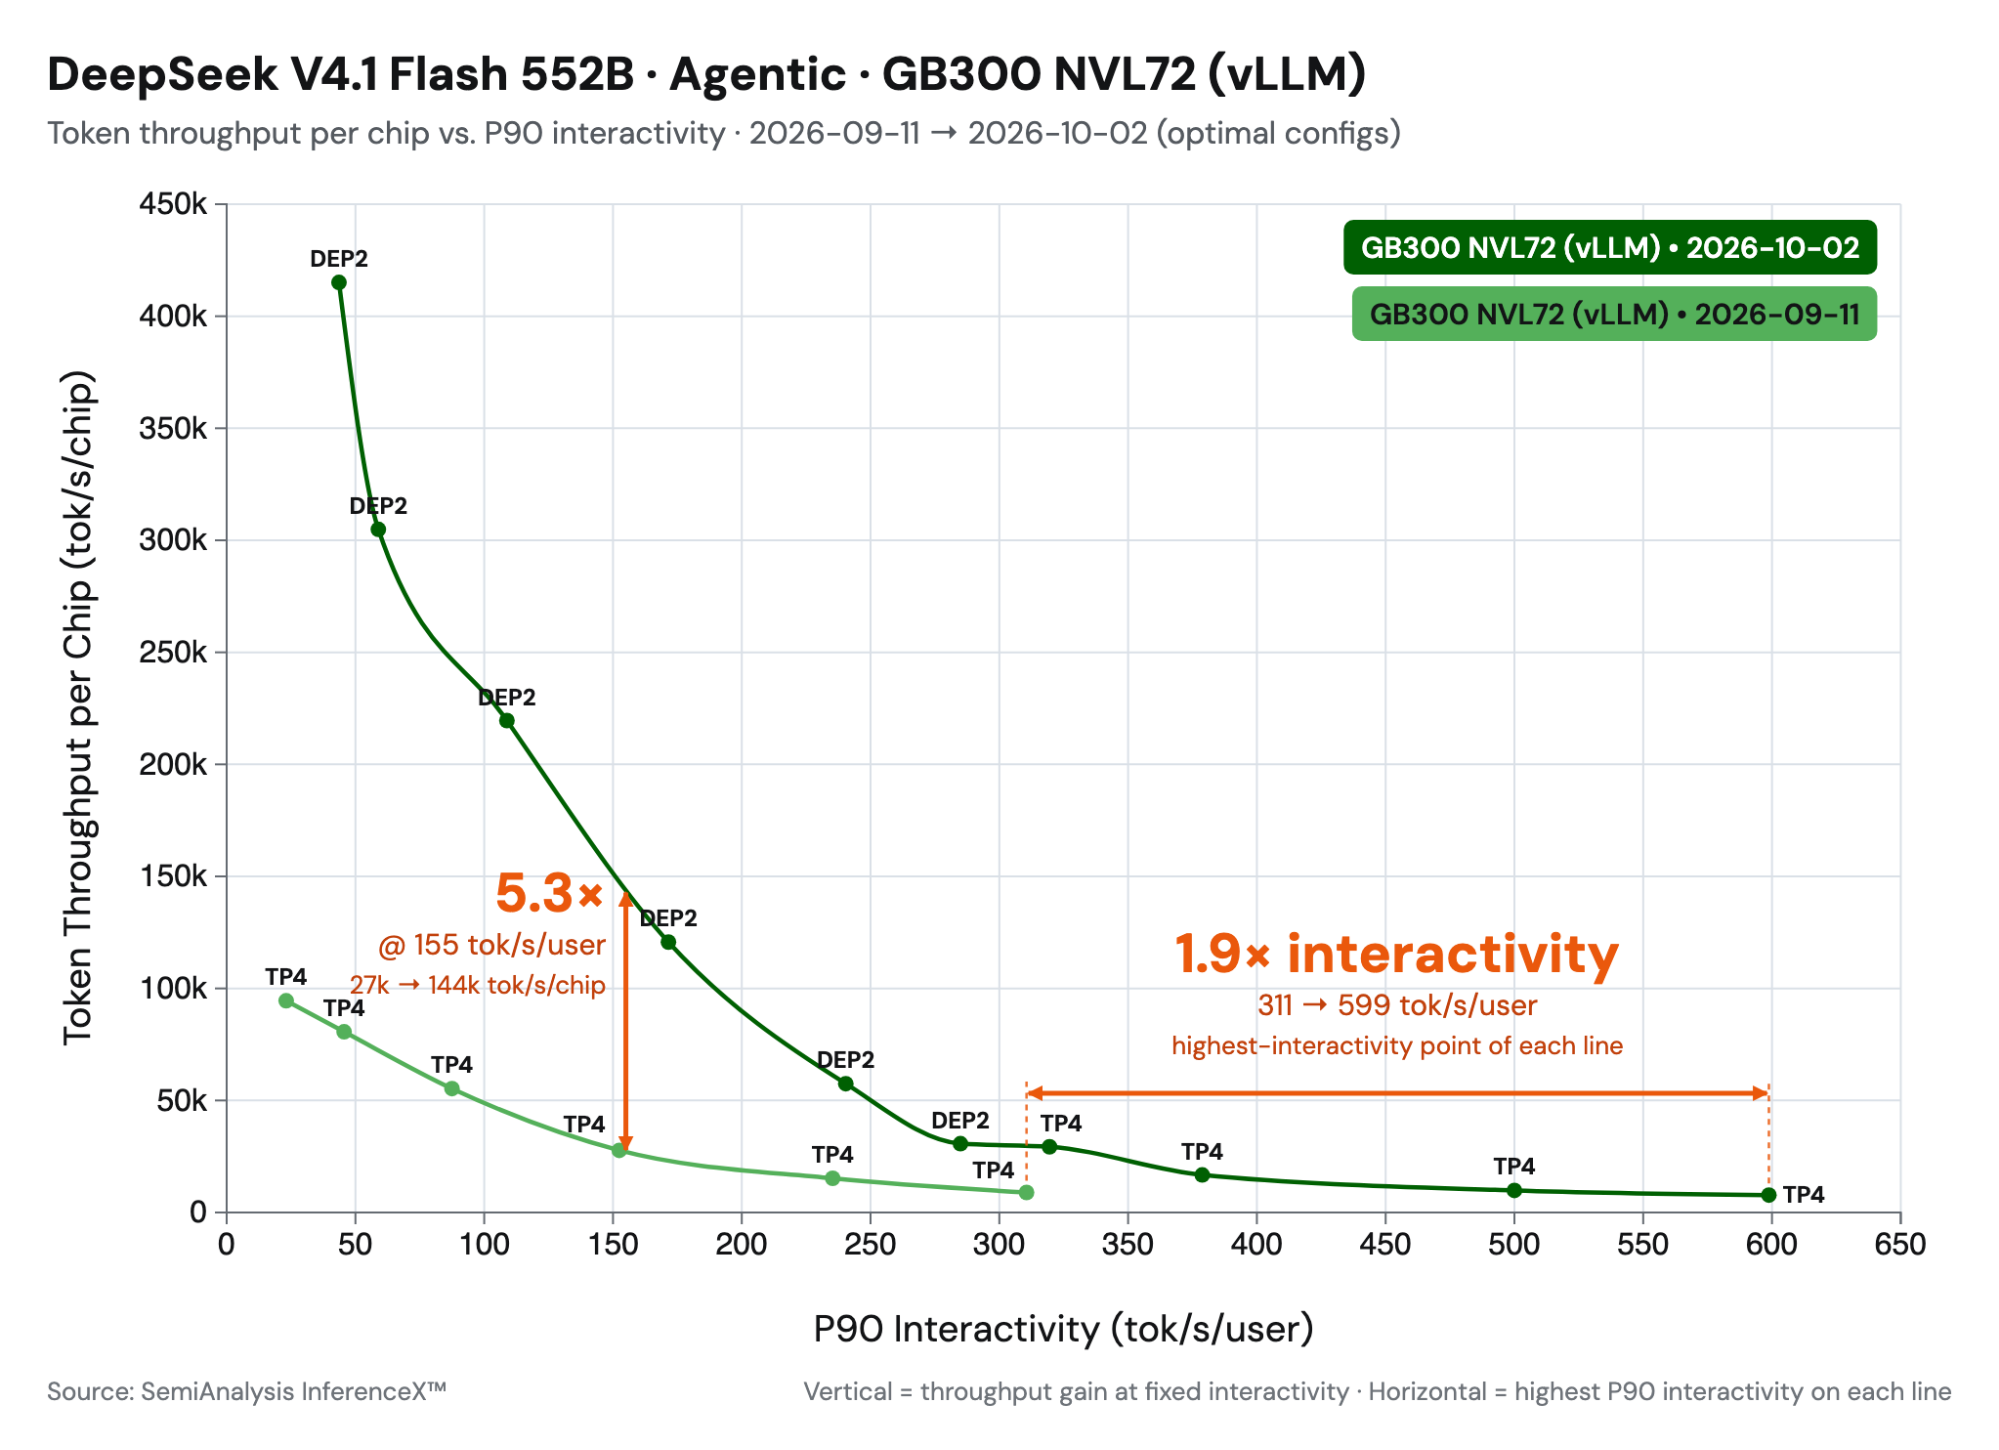
数字摆开。DeepSeek-V4.1-Flash 摞在 vLLM 上,低并发时快一点九倍;到了每个用户一百五十 token 每秒这个压强下,吞吐量做到五点三倍,测的地方是 SemiAnalysis 的 AgentX,交互式图表就挂在博客里,一步一步能点着看。推的开头那句也照录,"Three weeks from day 0",从零起算三周整。
"模型不动、地基换一层"这半句是全场重心。前面三档全包那条讲的是把分数铺满,这条讲的是把同一个分数跑得更快。跟前面一百二十亿超了原定目标呼应,那边备钱进产能,这边在现有硬件上榨余量,两头都在跟算力这件事较劲。跟前面一天快一半那条也接得上,一个改模型的默认速度,一个改引擎的调度路数,提速这件事从来不只有一处可下手。
三周这个工期我单拎出来记。模型十月上旬才落地,下旬地基就翻新完,这种跟随速度意味着跑得快不快,越来越取决于你脚下踩的是哪套引擎。
我留的疑问有三处。一点九倍是在什么硬件上测的没说;五点三倍的压强点只给了一个;升级要不要改配置也没写。
这周把自己那套 DeepSeek 的服务照博客换一版 vLLM,看延迟能不能掉到原来的一半。
话题来源 @vllm_project
5.8K阅读 ❤️38 x.com/…↗ 已改写,非原文转载
99 浏览 0 评论
0 反应











