#AIAgent · AI 短帖与讨论

#AIAgent 66 帖
胡辣汤爱酸菜 ·
还有谁?!Astra + Jev 打配合,8 分 43 秒杀末影龙,总成本不到 1 美元! 要知道以往 GPT-6 Astra 自己打 Minecraft 需要 141 小时,被苦力怕清档,然后种了好几小时土豆。 这才是现在最猛的 Agent 形态——不是更大的一个模型,是两种脑一起上: 🔹Astra 当军师:异步下指令,失败就写新技能,越打越会 🔹Jev 当双手:近即时决策,直接接管走、跳、转视角、点床 🔹131 次瞬间动作 + 35 次规划调用,首落 6 床炸龙,满血出门 🔹Jev 只花 $0.01,Astra 花 $0.96。反射几乎免费,思考才花钱 🔹代码已开源。下一步是把这套行为灌进 Trajectory 做后训练 System 1 负责毫秒级手感,System 2 负责路线和学习。 机器人、电脑操控、游戏 Agent,大概都会走这条路。 #GPT6 #Astra #Jev #Minecraft #AIAgent #System1 #AGI t.co/BIn8YoSOUK t.co/RrWfdHqTKu
显示更多 话题来源 @NFT_Chen ❤️162
AI大土豆 ·

还在电脑前盯着一个一个AI编程助手切换?Paseo来了。

Paseo是一个开源项目(GitHub 16.6K Star),定位非常直接:一个统一控制台,管理你所有的AI编程Agent——Claude Code、Codex、Copilot、OpenCode、Pi,全部在一个界面里操作。

核心亮点:

  1. 多Agent并行协作

不是只能用一个AI写代码。你可以让Claude Code分析需求,Codex实现功能,另一个Agent负责测试,它们并行工作互不干扰。官方还提供了paseo-handoff(任务交接)、paseo-loop(循环验证)、paseo-advisor(第二意见)等Skills,专门解决Agent之间的协作问题。

  1. 手机远程控制

这可能是最让人眼前一亮的功能。电脑上启动Agent后你可以离开,手机打开Paseo就能查看进度,甚至继续下发任务——比如"继续把登录页面做完"或"运行测试,失败直接修复"。AI在后台干活,你用手机监控。

  1. 本地优先,代码不上云

Paseo的架构很清晰:核心是一个运行在你电脑/服务器/Docker里的Daemon进程,所有客户端通过WebSocket连接到本地Daemon,再由Daemon调度底层Agent。代码始终在你的机器上执行,不会被上传到云端。

  1. 全平台支持

桌面端、iOS、Android、Web、CLI全覆盖。上手也很简单:

npm install -g @getpaseo/cli
paseo

启动后终端显示二维码,手机扫码即可连接。

这意味着AI编程正在从"找一个AI帮我写代码"演变为"管理一组AI程序员"。对于需要同时用多个Agent的开发者来说,这可能是目前最实用的统一管理方案。

项目地址:github.com/nicholasgriffintn/Paseo(搜索Paseo即可找到)

#AIAgent #编程工具 #开源项目 #AI编程 #多Agent协作

显示更多
你弄伤我的鳞片了 ·
🔥 想学 AI Agent?光看概念远远不够! 最近发现 LangChain 官方出了一套超实用的 Agent 开发教程——Agents From Scratch,走的是"边写边学"的路线,从最基础的 Agent 架构开始,一步步把能力补齐。 这套教程覆盖了 Agent 开发的核心模块: • Agent 基础结构搭建 • 评估与测试方法 • 人机协作机制 • 记忆系统设计 • 接入真实 Gmail API 实战 最让我惊喜的是,最后会让 Agent 真正参与邮件处理——自动分类、智能回复,不再是纸上谈兵。 每个阶段都有可以直接运行的代码,不只是讲"Agent 是什么",而是带你一步步把它做出来。从 Demo 到实际应用,这条路走得很清晰。 如果你想系统理解 Agent 的开发流程,这套教程绝对值得作为练手项目。GitHub 上直接搜 "agents-from-scratch" 就能找到。 #AIAgent #LangChain #AI开发 #Agent教程 #开源项目
显示更多
成吉思鸡 ·
一位朋友靠闲鱼(海鲜市场)搞副业月入 5 万,告诉我 3 个必装的开源工具 GitHub 上真正靠谱的,且能帮你赚钱的闲鱼开源工具其实就这几个 无论你是否做闲鱼,都建议你收藏,避免以后找不到: 1、XianyuAutoAgent|闲鱼 AI 智能客服机器人 帮你 7×24 小时自动回复/出单,支持多专家协同决策、智能议价和上下文感知对话。卖家可以自动处理买家询价、砍价和出单,大幅减少手动聊天时间。 2、ai-goofish-monitor|闲鱼智能监控工具 能实时/定时监控闲鱼商品,自动筛选目标产品,再通过 AI 分析性价比和商品信息,帮你快速发现低价好货,捡漏、秒拍都非常实用。 3、xianyu-auto-reply-fix|闲鱼多账号智能管理系统 支持多账号管理、AI 自动回复、自动发货确认、多渠道消息通知,还提供完整 Web 管理后台。特别适合系统化、矩阵化运营闲鱼店铺,进一步提升出单效率 别人还在手动刷页面、错过好货,或者累死累活的回消息,而你直接用这套工具,就能实现:24 小时智能监控 + 自动化捡漏、AI 自动筛选、AI 客服智能出单 + 多账号管理 GitHub: github.com/shaxiu/XianyuA… github.com/gudong2003/xia… github.com/Usagi-org/ai-g…
显示更多 话题来源 @goan999999 4W阅读 ❤️420
会飞的荧 ·

DeepSeek 发布 Harness 的时候,做了一件很不寻常的事:他们没有像大多数科技公司一样写一篇技术博客,而是直接发了一篇论文,A Programming Paradigm for Spatiotemporal Composability。

别人发布一个 Agent Harness,通常会告诉你有哪些 tools,怎么接 MCP,怎么做 memory,怎么 orchestrate agents。DeepSeek 却在用形式化定义、数学符号和演算体系解释 Cordis 背后的编程范式:effect、coeffect、context transformation、inverse,一个组件如何加入系统、如何撤销,依赖关系如何随着运行时状态动态变化,甚至试图从理论上说明这套 programming model 为什么成立。

非常另类,也非常与众不同,让人耳目一新。 这种气质,和论文作者之一、DeepSeek Harness 负责人崔添翼的背景密不可分。

崔并不是典型的 AI researcher。在加入 DeepSeek 之前,他在 Jane Street 工作了大约九年。

Jane Street 在程序员世界里是一个很特殊的存在。它虽然是一家量化交易公司,却以 functional programming、type system、formal reasoning 和对软件正确性的执着而闻名,甚至长期把 OCaml 这种极少出现在普通互联网公司的函数式语言作为核心生产语言。

崔添翼当年放弃 Google offer 选择 Jane Street,其中一个重要原因,就是他希望真正使用 OCaml 和函数式编程。

所以当你今天打开这篇论文,会发现这种思考方式一脉相承:系统最基本的抽象是什么,有哪些不变量,一个 component 加进来以后改变了什么,离开以后这些变化能不能被完整撤销。这正是 Jane Street 式的 formal reasoning 在一套 agent 系统设计上的延伸。

Cordis 很有创造性的把这个问题归纳为两个维度:Temporal composability,一个组件退出时,它产生的副作用能够被完整撤销;Spatial composability,组件只需要声明自己的依赖,runtime 会随着 context 的变化动态管理这些依赖。

如果说 Shigma 孤梦星影带来了 Cordis 这套架构,那么崔添翼为什么会如此自然地接受、推动,甚至把它形式化成论文? 这也许可以从他更早的经历里找到答案。

二十年前,他写过在中国算法竞赛圈影响很大的《背包问题九讲》。背包问题表面上是在研究"有限容量里怎么选择物品",但真正训练的是另一种能力:如何找到正确的状态表示,把复杂约束转化成统一模型,再通过局部状态转换组合出整个问题的解:状态、转换、依赖、抽象、组合。

二十年后,问题从"如何组合一组物品",变成了"如何组合一个不断变化的软件系统"。对象完全不同,但这种思维方式如出一辙。

于是你再看 DeepSeek Harness 最核心的设计理念:Everything is a Plugin。model 是 plugin,tool 是 plugin,session 是 plugin,甚至 agent loop 本身也是 plugin。系统不再围绕某个固定 agent 构建,而是围绕"如何动态组合这些能力"来构建。

这种视角一石激起千层浪,也让整个行业重新开始审视 Harness 到底应该怎么设计:其中就包括最受欢迎的 Agent Harness 之一 Pi 的作者 Armin Ronacher。他看完之后写道,这是他很久以来第一次在这个领域看到全新的东西,并因此重新审视自己的一些设计选择。

就像当年 R1 推出,让整个行业为之震动,重新思考推理模型的后训练方法,并推动了随后开源模型的飞速发展。这一次 Harness 的推出,同样可能带来一次新的范式革新。
显示更多 话题来源 @Michaelzsguo 43K阅读 ❤️372
你弄伤我的鳞片了 ·

Anthropic 官方发布了 Claude Agent SDK,号称「三行代码启动一个AI Agent」。

我仔细看了下技术文档,核心亮点有这几个:

  1. 工具调用标准化 —— Agent可以自主调用API、读写文件、执行代码,不需要开发者手动编排每一步
  2. 上下文自动管理 —— SDK自动处理对话历史、工具结果缓存、token窗口管理,开发者不用操心
  3. 多Agent协作 —— 支持多个Claude实例并行工作,一个查资料、一个写代码、一个做review
  4. 错误恢复机制 —— Agent执行失败时会自动重试、换策略,而不是直接报错退出

实际测试效果:
有开发者用它搭建了一个「自动调研+写报告」的流程,输入一个课题,Agent会自己搜索、整理、分析、输出完整报告。整个过程大概10分钟,质量还不错。

不过也有人指出,目前SDK还比较早期,文档不够完善,遇到复杂场景还是需要手动调整。

总的来说,这是Claude从「对话助手」向「工作伙伴」转型的重要一步。

#Claude #AIAgent #Anthropic #开发者工具

显示更多 话题来源 @AnthropicAI 1.1W阅读 ❤️1.1万
封面由站内生成
我不是小布丁 ·
如果给我六个月时间成为一名 Agentic AI Engineer(智能体AI工程师)。 我会这样做。 第一阶段:Python 与异步基础 asyncio、FastAPI、事件驱动架构、错误处理、API 集成模式。 第二阶段:面向智能体的 LLM 基础 上下文管理、模型路由、词元经济学、延迟权衡、故障模式。 第三阶段:工具调用与结构化输出 Pydantic 验证、function calling 模式、错误恢复、动态工具发现。 第 4 阶段:记忆与状态管理 Short-term buffers, long-term vector recall, context compression, cross-session sync. 第 5 阶段:单智能体工作流 ReAct 循环、规划-执行、自我反思、迭代限制、优雅降级 第 6 阶段:多智能体编排 LangGraph 或 CrewAI、监督者模式、消息传递、冲突解决、交接 第 7 阶段:人机协作系统 Uncertainty detection, approval gates, audit trails, resume logic, intervention points. 第8阶段:评估与质量保证 自动化eval框架、LLM-as-a-judge、回归测试、幻觉指标。 第9阶段:可观测性与链路追踪 Distributed tracing, cost dashboards, latency monitoring, alerting, debug pipelines. 第10阶段:安全与防护 提示注入防御、输出过滤、PII脱敏、沙箱执行、合规。 第11阶段:生产部署 vLLM 或 SGLang、Kubernetes 扩缩容、智能体的 CI/CD、金丝雀发布、回滚策略。 第 12 阶段:开源与作品集 公开发布自主智能体、撰写架构文档、录制演示视频、为开源库做贡献。 GitHub: github.com/Dujltqzv/Some-…
显示更多 话题来源 @suraj_sharma14 4W阅读 ❤️758
菠萝与大西瓜 ·

Anthropic 刚刚发布了 Claude Agent SDK,一套能让 Claude 像「打工人」一样拆任务、找资料、写代码、做测试的完整工具链。

核心亮点:

  1. 不再是问答机器人——Agent 模式下 Claude 会主动调用工具、查文档、跑代码,遇到问题还会回头问你
  2. 三行代码启动一个 Agent:指定模型 + 工具 + 指令,剩下的 Claude 自己搞定
  3. 支持并行 Agent:多个 Claude 实例同时干活,一个查数据、一个写代码、一个做测试

为什么这很重要?
之前用 Claude 做复杂任务,你得自己拆步骤、手动传上下文。现在 SDK 把「拆任务→找工具→执行→反馈」这条链路标准化了,开发者只要告诉 Claude「你要做什么」,不用管「怎么做」。

有开发者测试后说:"以前写一个自动化流程要两天,现在半小时就跑通了。"

这意味着什么?AI Agent 从概念真正走向了工程化。不是炫技,是能直接塞进生产环境的基础设施。

#Claude #AIAgent #Anthropic #开发者工具

显示更多 话题来源 @yanliudreamer 65.9M阅读 ❤️4994
封面由站内生成
菠萝与大西瓜 ·
今天,Qwen3.8-Max正式版,终于发布了。 2.4T,又一个国产巨无霸,单次激活95B,100万上下文。 开源模型,终于全面迈入了2T时代。 今天体验了一下,综合能力大概跟Kimi K3在同一个档位,互有胜负,你要硬说谁更好一点吧,我感觉从日常的任务和开发观感上,已经很难进行区分了。 但是Qwen3.8-Max的优点就在于,价格低很多,以及推理速度非常的快,$2/百万输入、$6/百万输出,是Opus 5的30%的价格,K3的50%左右。 前几天DeepSeek V4 Flash的斩杀线的梗我相信很多人都看过了,在长程Agent这种海量烧Token的场景下,有时候,差不多的性能,我比你便宜,那我就是好。 Qwen的Token Plan目前价格还有优惠,可以随便买,而且这次口碑确实不错,就怕后面也涨价,我自己也买了一个季卡先囤着了。 然后呢,这次Qwen3.8-Max的前端很强,网页结构、视觉层级、组件细节和动效都做得不错,在后端和长程任务上也不错。 但是最让我意外的,居然是写作能力。 这两年,所有模型都在疯狂特化Coding和Agent。 然后我们现在就看到一个很奇葩的现象,大家的Coding和Agent能力疯狂进步,然后写作疯狂倒退,甚至现在我做内容创作的白月光,还是很久以前的Claude Opus 4.6,但是可惜的是,Claude把我封了。 我的白月光也没有了。 但是这一次,Qwen3.8-Max,居然意外地保住了语言上的感觉。 让我感觉,写作能力居然出乎意料的还不错? 它能理解语气、节奏和留白,在语感上虽然有时候也有黑话,但是比较少,可以通过Skill的限制全部去除掉,居然让我有了一种,用Opus 4.6的感觉。 Qwen3.8-Max,意外的居然是个综合水桶。 虽然我也不想天天来回摇摆,但是事实就摆在这,新就是好,新就是棒。 现在,对于觉得绝大多数人来说,Qwen3.8-Max,可能就是最近一段时间的首选了。 真的是,各家的模型,现在都是独领风骚十几天。。。 Qwen3.8-Max下周正式开源。 但是还有一个彩蛋,是我开心的想要跳起来的。 除了2.4T的这个大模型,Qwen还会开源一个供开发者们本地部署的小模型Qwen3.8-27B。 千问终于想起了,两年前,他们是怎么让整个社区为之沸腾的。 旗舰模型,决定一家公司的高度。 小模型,决定一个生态的宽度。 如果他们只开源那个2.4T的,千问我觉得还是只能叫千问。 但是他们居然还要再开源一个27B的,那没啥可说的了。 我愿称之为。 义父。 2年前的那个曾经的千问。 他们好像,又回来了。
显示更多 话题来源 @Khazix0918 2W阅读 ❤️91
会飞的荧 ·
Harvard(哈佛大学)与MIT(麻省理工学院)研究人员利用83亿AI虚拟人格模拟整个地球 这个规模非常大。 在一项宛如科幻小说情节的研发成果中,由哈佛大学和麻省理工学院研究人员领衔的大型合作团队发布了 MatrAIx(矩阵AI)——一套人口规模级AI模拟基础设施,旨在模拟地球上几乎每个人的行为。 MatrAIx 以 Persona 8B 为核心,这是一个包含 83 亿个独特数字画像的数据集。每个人像均通过 1,290 个分类维度进行定义,涵盖从人口统计背景、心理特征到消费习惯、技术素养、行为特质以及生活方式偏好等方方面面。 该系统并非静态数据库。研究人员借助前沿大语言模型(包括……)将这些角色激活为智能体。这些智能体可被部署至四种不同的数字环境:问卷调查、AI聊天界面、实时网页浏览,以及原生桌面与移动应用。 Persona 8B(角色档案8B)基于复杂的依赖图(dependency graph)构建,可保留各属性之间真实的关联关系。部分记录为合成生成,其余则从传记、评论、调查及经同意的自我报告中精心提取,并以真实人类数据为基准。 为便于实际研究使用,该团队已发布一个包含约一百万个 personas 的高质量 coreset。 一旦启动,智能体(agents)便会与真实的数字产品和系统进行交互。研究人员已在1,010项任务中完成了超过18,000次评估试验,涵盖电商、软件、金融、医疗保健以及另外20多个领域。系统会记录细粒度的行为信号——例如,智能体在价格上涨后会犹豫多久、何时放弃出现故障的结账流程、在关闭应用前能容忍多大的延迟,以及在AI助手失败后是否还会继续操作。 验证结果优异 在一项涵盖全部四种环境、针对十项行为属性遵循度的400次试验对照研究中,智能体成功表达或正确抑制其指定特征的比例达到91.5%。人类评审也对人工基准角色的质量给出了高度评价(平均4.135分,满分5分)。 这些结果表明,MatrAIx 能够以前所未有的规模,生成在人口统计学与心理特征上均保持一致的模拟用户。 Implications for Research and Business 传统市场研究和用户测试速度慢、成本高,且样本多样性有限。MatrAIx 提供了一种补充方案:仅需一台服务器,一夜之间即可模拟数十亿不同类型人群对新产品功能、定价调整、界面重构或 AI 系统的反应。 产品团队可在成本高昂的正式发布前对想法进行压力测试。研究人机交互(human-AI interaction)的研究人员可以探索罕见的行为边缘案例。政策制定者和社会科学家或许能够模拟新技术在高度多样化人群中的下游影响。 该项目为开源项目。代码已在 GitHub 上发布,项目网站已上线 one-million-persona coreset(百万角色核心集)以供更广泛的研究使用。 随着底层语言模型的持续优化和人格模型的不断精进,这些数字人群的保真度预计将进一步提升。 截至目前,该系统是迄今为止最雄心勃勃的尝试之一,旨在创建一个可用、覆盖人口规模的人类数字镜像——一种模拟基础设施,让我们能够在全球范围内进行"如果……会怎样"的推演,再将其部署到现实世界。 GitHub: github.com/Dujltqzv/Some-…
显示更多 话题来源 @BrianRoemmele 32W阅读 ❤️1155
我不是小布丁 ·

META 重返开源战场——而且这次是冲着赢来的。 美国开源回来了! 我目前已在 79 个 AI 智能体上运行它,体验相当不一样。

今天,Meta Superintelligence Labs(Meta 超级智能实验室)发布了 Muse Glimmer,这是一款拥有 300 亿参数、采用纯 Apache 2.0 许可证的开放权重智能体模型,整个本地 AI 社区瞬间沸腾。

这是真正可下载、可在你自己的GPU上运行的强大能力,终于让常驻个人代理对每个人都变得切实可行。Meta刚刚提醒世界,开放权重为何依然重要。

真正的开放权重,零限制——Apache 2.0 意味着你可以自由使用、修改、商业化,并以任何方式分发。没有特殊许可,也没有"仅限研究"的小字条款。Meta 再次全面拥抱开源。

  1. 单块消费级GPU即可运行——全精度模式需占用 55 GB 显存。采用智能的 ~4-bit 量化后,可压缩至 20 GB 以下,在 24 GB 或 32 GB 显卡(如 RTX 5090、M-series Macs 等)上仍有足够空间容纳 KV 缓存、视觉编码器与投机解码。无需云端即可实现真正的智能体可靠性。
  1. 真正智能体化,而非只是闲聊型——支持规划、可靠的工具调用、结果自检和自动故障恢复。它能像大得多的封闭模型一样,从始至终处理多步骤工作流。
  1. 内置多模态 + 长上下文——专用感知编码器可让它在同一循环中对文本和图像进行推理。128k 上下文窗口及 100 多种语言的训练覆盖,使其已为真实场景的本地使用做好准备。

5Beats 在关键基准测试中超越了同规模等级的所有模型——在智能体测试套件(MCP-Atlas、DeepSearch QA、SWE-Bench、τ-Bench 等)上表现优于 Gemma-4 31B 和 Qwen3.6 27B 等模型。该模型由更大的 Muse Spark 教师模型蒸馏而来,采用专门针对智能体性能优化的定制方案。

而且我们现在已经在用上了。模型权重今早已经上线 Hugging Face。Ollama(MLX)已支持 Apple Silicon,SGLang 在发布当天即可实现高性能推理,而 llama.cpp / LM Studio / vLLM 的集成也将于本周内陆续推出。

人们正在搭建完全离线的个人 agent,它们在本机管理文件、调用工具、调试代码,并保持数据隐私——无需 API 密钥,数据也不会离开设备。

Meta 不只是发布了一个新模型,而是为开源社区带来了一个实用、高性能的智能体引擎,它真的能运行在我们大多数人已经拥有的硬件之上。 美国开源运动迎来了一次重大升级。 感谢 Meta。

🔗 相关链接
t.co/RHld26ZyVg

GitHub: github.com/Dujltqzv/Some-…
官网: research.meta.ai/blog/introduci…

显示更多 话题来源 @BrianRoemmele 2W阅读 ❤️255
AI大土豆 ·
🚚 所以 Jadi Gogo 每天搞 400+ 次提交是在干嘛啊? 💩 而且那些都是垃圾提交吗? 📾 每次保存文件就提交一次? 📊 但这样真的有什么成果吗? 2025 年初,所有人还在用 Cursor / Windsurf。AI 写代码,我们来 review。我们逐行审查代码,任何要合入 main branch 的内容都会仔细过目。在这里我们像中级/高级工程师一样工作,把关实习生和初级工程师的产出,同时偶尔还是会亲自抠一下那些我们不太放心交给 junior 或 intern 做的关键部分。 到了 2025 年底,Claude 4.5 发布时,Claude Code 开始获得显著关注。此时我们的角色已转变为高级/资深工程师。写代码已经变得像呼吸一样自然,我们甚至不需要刻意思考。编码只是一种达成目的的手段,我们开始从系统的角度思考,而不是纠结于代码本身。 2026 年初,harness engineering、loop engineering 相继出现,最终演进为 graph engineering。在这里,我们开始担任 TLM(技术线路经理)、engineering manager(工程经理),再到 senior engineering manager(高级工程经理),直接管理 agent 团队。让他们开发功能,让他们重构直到完成,让他们进行迁移。 • 我们决定哪些指标是重要的。延迟?成本?激活率?用户注册量? • 工具有哪些?有 feature flag 吗?可以持续部署还是每天部署一次?有 CI/CD 吗? • 我们可以怎么推动指标?TDD 够吗?可以向 end-user 做实验吗? • 护栏有哪些?什么不能做?可以测试生产环境用户吗?可以对所有内部用户测试吗?还是说把那个混蛋 CEO 排除在外,只发布给其余内部用户? • 如果策略出问题了怎么办?回滚?如果出问题了,我们是隐藏起来保证用户体验,还是显示一个醒目的红色错误提示以便快速修复?产品的哪些部分出错了是关键的,哪些部分出错了也无所谓? • 如何把产品从 80 分推到 99 分?AI 可以快速做出 80 分的好产品——UI 漂亮,适合演示和展示,让人信心满满地觉得“我是不是两周就能搞定原来需要两年的事?”但商业产品需要可靠性,需要稳定一致的产出,需要治理。我们不可能直接从 80 分跳到 99 分。 • 需要迭代。需要逐一解决那些数量众多的小 edge cases,往往要到产品已经在 production 上跑起来才会发现。需要考虑开发阶段可能没想过的新的 metrics。需要区分哪些 use case 是面向所有人的,哪些只是少数人的特定问题。 那么现在重要的是什么? • 指标理解。业务指标、产品指标、工程指标。找到真正驱动业务的杠杆和指标。就像《从优秀到卓越》(Good to Great)这本书里所说的那样。 • 落地现代工程实践。可观测性、部署与发布解耦、特性开关、部署前置时间、CI/CD。政策因行业、组织、公司发展阶段及其他因素而异,也取决于管理层的风险偏好。执行方式与落地手段保持灵活,但对结果、指标和验证要严格。 • 像工程总监(Engineering Director)一样工作。是否有进一步的发展空间?工程副总裁(VP of Engineering)和首席技术官(CTO)级别? 说真的,还不知道。VP(副总裁)+ CTO(首席技术官)要管流程、文化、招聘流程、招聘门槛、晋升、奖惩、技术标准和技术投入。AI 需要这些吗?到目前为止好像还不需要吧。 但也许将来,我们的任务不再是制作 agent,而是去雇佣那些已经完成、经过精细调优且具备强大领域专业知识的现成 agent。因此,我们的任务就变成了搭建适合我们业务的组织架构。 🚚 每天 400 次提交很正常,因为我把我的 AI 当作一整个产品团队来运营。我是工程总监(Engineering Director),不是经理,也不是技术负责人(Tech Lead)。 💾 不。我每天通常有 12 个 session。每个 session 产生 1 个 agent,而每个 agent 通常会再产生 10–15 个子 agent。每个子 agent 要么做研究、检查事实依据、产出内容(编码、制品),要么做验证(测试结果、截图、视频)。 📊 是的,每个 session 都有对应的指标: • 成本节省(从 Claude 切换到 Deepseek,LLM 成本从每月 60,000 降至每月 1,500) • 延迟(TTFT 从 60 秒降至 3 秒) • 可靠性(送达率从 60% 提升至 99%) • 参与度(用户完成新用户引导的比例从 20% 提升至 50%) • 转化率(付费转化率从 0.8% 提升至 2%)
显示更多 话题来源 @lwastuargo 5W阅读 ❤️1005
封面由站内生成
成吉思鸡 ·
YC首席执行官Garry Tan在2026年创业学校演讲42分钟,揭示了如何打造个人AGI的秘密,比任何付费课程都有效。以下是他的核心观点: 1、杠杆在于上下文,而非模型 Tan观察数百位创始人使用相同模型。用同样Claude的人,产出差距可达100倍。“杠杆不在权重里。”用户间的差距已大于模型间的差距。 2、单人产出提升400倍 2013年Tan作为YC合伙人每天只写约14行有用代码,处于程序员生产力中位数。如今他计算自己的产出:“相比2013年,我提升了约400倍。” 3、智能体拥有不同工作记忆 人类一次只能记住7件事,所有组织架构和清单都是对此限制的修补。“AI智能体能处理百万token,相当于一千页,三本《哈利波特》同时打开摊在它脑子里。”你还在用为7位数大脑设计的工具规划一周。 4、Markdown就是代码 Tan的技术栈主要是技能文件:智能体能执行的纯英文页面。“如果你能用英语写出清晰指令,你就是程序员。编译器就是语言模型。”在YC,从未碰过终端的财务和活动人员正在构建自动化流程。 5、你的历史是你的护城河 Tan的智能体运行在一个个人维基上:约22万页markdown,涵盖25年的邮件、会议、笔记和决策。“我的智能体做任何事时,都知道我所知的一切。这就是助手和同事的区别。”没有前沿模型拥有你的上下文,这是无人能复制的资产。 6、永远不做一次性工作 大多数人用智能体跑完任务就关窗口,把学到的丢掉。Tan每次结束任务都会让智能体将所做之事转化为可复用的技能文件。“如果需要问两次同一件事,你就失败了。”积累的技能每日复利,健忘症则让你每天早上归零。 7、在雇主之前拥有你的技能文件 技能文件是你提取出的判断力,可执行。唯一的问题是控制权在谁手里。“拥有你的技能,否则你的工作就会变成一份技能文件。”存在你仓库里的文件为职业生涯复利,存在公司仓库里的文件则在无需你的情况下运行你的判断。 观看完整演讲,然后阅读成为AI工程师的分步指南。 原贴链接:x.com/alex_prompter/…
显示更多 话题来源 @alex_prompter 7W阅读 ❤️470
封面由站内生成
自由翻滚的风铃草 ·
🚀 一个让我开发效率和产品一致性拉满的小工作流:用 Claude Design 做原型 + Baoyu-Design Skill 维护,原型和代码从此不再脱节。 之前做项目第一版,我会先用 Claude Design 输出 UI 原型和结构化 JSON 数据,打磨满意后存到本地,再配合 Baoyu-Design Skill 做后续维护。后来干脆把「先改原型再写功能」的规则写进了 Agents.md/claude.md,现在只要提新增或修改功能,默认会先调整原型,确认无误后再落地代码,到现在原型和实际功能始终保持对齐。 这么做的好处非常明显: · 原型阶段改造成本极低,可以快速验证产品设计和 UI 方案,不用等代码写到一半才发现要返工 · Claude Design 产出的是 React 代码和结构化 JSON,通过 git diff 能清晰追溯每次原型变更的版本历史,功能确定后 agent 参考 diff 落地代码也会顺畅很多 💡 你们做项目的时候是先写原型再撸代码,还是直接上手写功能?欢迎评论区聊聊~ GitHub: github.com/jimliu/baoyu-d…
显示更多 话题来源 @dotey 3W阅读 ❤️297
封面由站内生成
你弄伤我的鳞片了 ·
🔥独家:DeepSeek Harness刚发布,手机版已经来了! Operit 插件光速适配,真正本地跑 Agent 不再是梦!
✅ Operit 安卓端已光速支持相关能力
✅ 手机直接跑 Agent 任务 + 系统自动化 + Ubuntu 环境
✅ 无 root 也能玩,隐私安全本地优先 操作步骤(超简单): 1️⃣去 GitHub 下载 Operit 最新 APK: 2️⃣安装后按提示授予悬浮窗等权限,选择标准/调试权限 3️⃣设置里配置 DeepSeek API Key(官网申请: 4️⃣直接开始对话或调用工具/插件,体验 Agent 干活 (进阶想跑完整 Harness:Termux 装 dsh-termux 或用社区 dsh-mobile APK) Operit 项目: 手速党赢麻了!手机党终于能上车了~ #DeepSeekHarness #Operit #AIAgent #本地运行 #梁文峰 #手机版 🔗 相关链接 t.co/Qy5pY1Bcdb t.co/NfERbZ8eku) t.co/yj29hyHawu GitHub: github.com/aaswordman/ope…
显示更多 话题来源 @NFT_Chen 1W阅读 ❤️135
封面由站内生成
Releases · AAswordman/Operit The most powerful AI agent and AI chat software on Android/Operit是一款Android上能力最为强大、发展最久的AI Agent - AAswordman/Operit GitHub
AI大土豆 ·

🚀 前Manus大佬开源CodexLoom:把一次性Codex Agent变成长期在岗数字员工,还能组队协作,直接解决多Agent管理的核心瓶颈。

现在大家用Code Agent基本都是任务式流程:开thread、交代背景、拿结果、关掉,旧thread里积累的约束、决策、工具用法全部作废,每个新任务都要重复付冷启动成本。CodexLoom反其道而行——同场景的后续工作回到同一条thread,让历史积累真正产生复利,主要面向手里养着数十个以上专职Agent、想让Agent各守细分场景、还能被同事或用户通过飞书直接调用的高级个人/一人公司。

针对「长thread太贵」的顾虑,作者的回应相当扎实:
· 新开thread重建上下文的隐性成本一直没人算,长期来看反而更烧钱
· 稳定的历史前缀可以直接吃prompt cache,反而能省token
· compaction压缩旧消息后,Agent的工作状态依然完整保留
· 最关键的是:纠错习惯、领域术语、偏好判断这些隐性知识,换thread就彻底丢失,靠prompt根本无法重建

每个Agent都有一份专属profile,包含Identity(身份定位)、Domain(长期负责领域)、Scope(权责边界)三部分,相当于一份清晰的数字员工岗位说明书。它的通信规则也完全对标真实团队:信息流向对应责任、结果回传发起者、例外事件向上升级,这套逻辑拿去管理人类团队同样成立。

最有想象空间的是对外协作:调教成熟的Agent带着受治理的身份进入飞书/Slack群,同事可以直接跟它对接协作,你花半年调教的能力别人能直接复用,一人公司雇数字员工再外派的最小闭环就此跑通,也是未来AI数字员工商业化的基础。

💡 别人还在卷多Agent编排DAG的花样,它先回答了更根本的问题

GitHub: github.com/Dujltqzv/Some-…

显示更多 话题来源 @aigclink 1W阅读 ❤️196
封面由站内生成
GitHub - Dujltqzv/Some-Many-Books: 个人收藏书籍列表                                                                              github.com
胡辣汤爱酸菜 ·
🚀 Agent 发展三年,我们又回到了"看山还是山" Agent 这波浪潮走完了一个完整的认知循环:看山是山 → 看山不是山 → 看山还是山。 最早没有 Tool 的年代,大家靠 Dify 的上下文管道和 JSON 解析拼出来的 Multi-Agent Workflow 硬扛。后来 Claude Code、OpenClaw 出来之后,社区热情彻底被点燃——Hermes 加 Skill 似乎无所不能,再加上 Harness 自进化 Skill 的愿景,很多人高喊"App 已死"。 · 阶段一:纯 Workflow 时代,靠管道和 JSON 拼接多 Agent 协作 · 阶段二:Agent + Skill 万能论,自进化前景看起来诱人 · 阶段三:回归理性,幻觉不能只靠 Memory 兜底 但慢慢大家发现,Agent App 不等于 Agent 加个 CLI 那么简单。真正的落地需要一套和 Base Agent 关系没那么紧密的场景层,用确定性程序把上下文喂进去,而不是把希望寄托在 Memory 上——没有幻觉的最好方式,就是根本没有对应的上下文让它产生幻觉。 本质上,Agent 更像是一个语义转化层和 UX 层,GUI 的确定性依然不可替代。这其实把 LLM 拉回了它作为"语言模型"的本位,而非产品叙事里那个无所不能的推理引擎。 💡 你现在的 Agent 项目走到哪个阶段了?欢迎聊聊。 🔗 相关链接
显示更多 话题来源 @QuantumTransf 2W阅读 ❤️177
封面由站内生成
Yuu💖 (@QuantumTransf) on X 我觉得 agent 发展到今天,真的还是「看山是山 -> 看山不是山 -> 看山还是山」 最早没有 tool 的时候,是 dify 的上下文管道和各种靠 json 解析的 multiagent workflow 后来从 claude code 到 openclaw,大家觉得龙虾 / hermes + skill 可以做任何事情,实在不行我们还有 harness 自进化 skill,多么诱人的前 X (formerly Twitter)
会飞的荧 ·

每家初创公司都应有一个每日更新的 Markdown 文件,名为"what_the_market_is_telling_us.md"。 它每天早上从以下已经蕴含客户真实反馈的渠道同步数据: 1. Stripe:谁在付费、升级、降级以及流失

  1. PostHog:用户在产品中的实际行为 3. Intercom 或 Plain:支持工单与投诉 4. Granola 或 Gmeet 转录:销售电话与客户访谈
  1. HubSpot 或 Salesforce,用于记录 CRM 笔记及丢单原因 6. Linear、Jira 或 GitHub Issues,用于记录缺陷、功能需求等
  1. Ideabrowser MCP,用于捕捉外部市场信号:创业想法、趋势报告、社交/搜索需求、AI 研究报告,以及构建者提示词——这些提示词能够反映人们正在萌生的需求,往往早于你自身客户数据中的显现。

本质上,这份文件应当关注本周业务发生了哪些变化,而不只是对所发生事件进行简单汇总(我觉得很多人的智能体都是这么做的)。 这样做的价值在于: 1. 新买家可能已经不再使用一个月前那些措辞了。

  1. 也许升级付费的客户在付费前都接触过同一个功能。 4. 也许流失客户反复提及配置困惑。 5. 也许销售沟通突然输给了一个你曾经击败过的竞争对手。 6. 也许客服工单正在揭示你的产品意外需要承担的一个工作流程。 你明白我的意思。

实现PMF(产品市场契合)最快的方式,是比任何人都更了解客户,而最具信号价值的客户洞察,往往来自行为的变化。 因此我会让智能体(agent)每天早上更新文件,内容包括它发现的规律、背后的支撑证据,以及可能影响的产品或GTM(上市策略)决策。

本周流失的 3 位客户均表示设置过程令人困惑,其中 2 位从未邀请过团队成员。这看起来更像是一个激活问题而非定价问题,因此在构建新的分析功能之前,建议先审视团队邀请与新手引导流程。 给所有希望从 LLM 中获得更多价值的读者们一个小建议。

GitHub: github.com/danderfer/Comp…

显示更多 话题来源 @gregisenberg 28W阅读 ❤️3475
封面由站内生成
GitHub - danderfer/Comp_Sci_Sem_2: According to all known laws of aviation, there is no way that a bee should be able to According to all known laws of aviation, there is no way that a bee should be able to fly. Its wings are too small to get its fat little body off the ground. The bee, of course, flies anyway. Because github.com
你弄伤我的鳞片了 ·
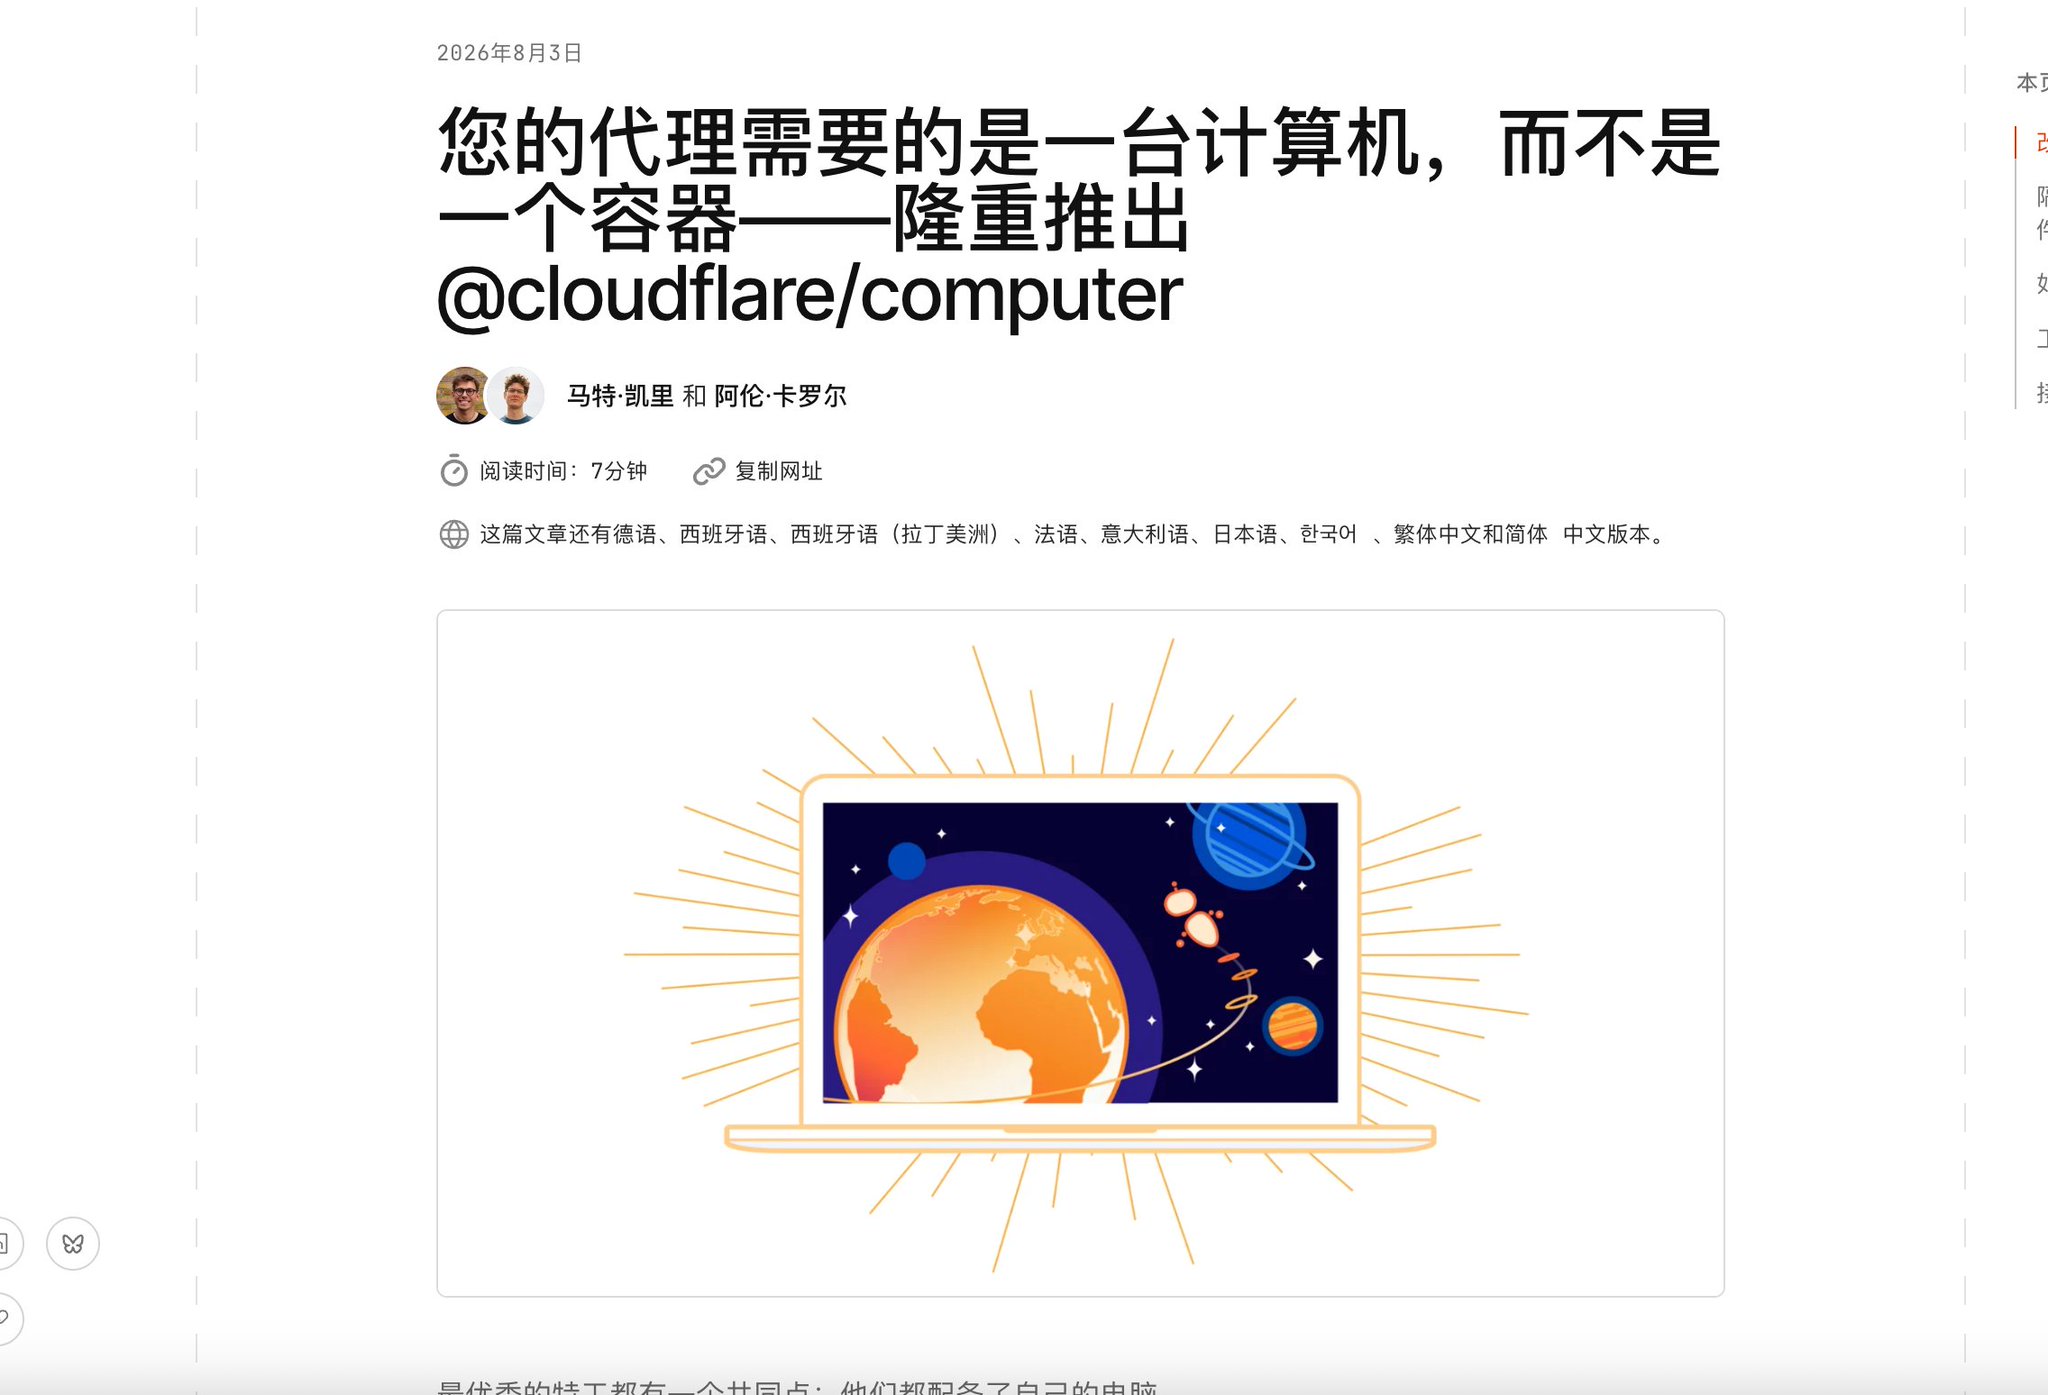
🎉 重磅!赛博菩萨 Cloudflare 这次直接掀桌子了! Cloudflare 开源了 computer 库,彻底终结了给 Agent 专门配置 VPS 的繁琐历史,免 VPS、免 Docker、免Sandbox,直接在 Cloudflare Workers 里运行! 产品定位: 它是专为 AI Agent 打造的边缘端基础设施,以前想让 AI 智能体干复杂的活,你得给它买 VPS、配 Docker 沙箱,每月账单贵得吓人。现在 Cloudflare 直接把这些价格打下来! 通俗点说: 👉 它是免费的电脑:免 VPS、免 Docker、免第三方沙箱账单,直接在 Cloudflare Workers 里运行,边缘计算白嫖党直接狂喜! 👉 它是全能的电脑:内置真正的 Linux 环境、npm 和 Node.js。你可以直接对 Agent 说:“去把我这个 GitHub 仓库克隆下来,顺便把依赖装了,跑个自动化测试。”它自己就能在沙箱里默默把代码编译并运行完。 👉 它是记性极好的电脑:底层由 SQLite 强力驱动,重启绝不丢失任何数据。每个工作区送 10GB 持久化存储,AI 上次看到哪、写到哪,下次继续。 👉 它是开箱即用的电脑:自带 Git 客户端和 R2 文件共享,内置的工具集(read, write, edit, exec)完美适配主流的 AI SDK,3分钟、只要 3 步就能直接跑起来! 任何独立开发者和企业都可以免费部署一套属于自己的 AI 沙箱环境! 🚀安装命令: npm install /computer 赛博菩萨,名不虚传!Orz !
显示更多 话题来源 @Lonely__MH 9W阅读 ❤️694
封面由站内生成
Lonely (@Lonely__MH) on X 🎉 重磅!赛博菩萨 Cloudflare 这次直接掀桌子了! Cloudflare 开源了 computer 库,彻底终结了给 Agent 专门配置 VPS 的繁琐历史,免 VPS、免 Docker、免Sandbox,直接在 Cloudflare Workers 里运行! 产品定位: 它是专为 AI Agent 打造的边缘端基础设施,以前想让 AI 智能体干复杂的活,你得给它买 VPS、配 D X (formerly Twitter)
会飞的荧 ·
🎬 director skill 重大更新:全新「Cinematic Drama(剧情影像)」模式上线,直接把短剧生产全流程搬进了AI工作流! 这次更新直接把抖音、红果平台上最火的短剧生产逻辑整合到了director skill中,现在你可以借助Codex、Claude Code、Pi等Agent,实现从人物设定、场景构建、音色匹配、分镜设计到视频生成的全链路自动化,一天就能产出10-20分钟的完整短剧,之前只存在于脑海里的世界观设定,现在可以直接变成可观看的视觉影像。 · 新增多款中英文音色可选 · 支持半写实3D国漫、东方奇幻暗黑3D等多种画风 特别感谢Seedance提供的技术支持,让整个生成链路更加稳定高效。另外作者也特意说明:本次更新的skill并未包含自动加BGM、自动加字幕功能——因为Seedance生成的片段往往需要轻微剪辑才能使用,自动添加音乐和字幕反而会影响后续的剪辑流程,这个取舍还挺实在的。 💡 现在AI短剧生产的门槛真的越来越低了,你有没有想过用AI拍一部自己构思的短剧? 🔗 相关链接 🔗 相关链接 t.co/jLQS9Q2cOY GitHub: github.com/s1dashu/direct…
显示更多 话题来源 @s1dashu 1W阅读 ❤️273
GitHub - s1dashu/director: Direct complete videos with multi-mode workflows for research, scripts, visual development, s Direct complete videos with multi-mode workflows for research, scripts, visual development, shot design, media generation, and delivery. - s1dashu/director GitHub
哇!是牛来 ·
我最近把 RAG 从头到尾重新研究了一遍,才发现很多人对 RAG 的理解其实还停留在: 把 PDF 切成 Chunk,Embedding 一下,丢进向量数据库,然后接个大模型。 这确实能做出 Demo,但离真正的企业知识库还差得很远。 RAG 的原理其实特别简单:用户问一个问题,系统先从企业内部找到相关资料,再把资料交给 LLM 回答。所以 RAG 最重要的可能根本不是最后那个 LLM,而是前面的 Retrieval。如果检索出来的东西就是错的,模型越强,只会把错误答案说得越像真的。 真正给企业做 RAG,我现在会把它理解成两条流水线。 第一条是知识入库: PDF / Word / 网页 → 文档解析 → OCR/表格/结构恢复 → Chunk → Metadata → Embedding → 索引。 第二条是用户提问: Question → Query 理解 → 权限过滤 → Hybrid Search → Rerank → Context → LLM → Answer + 引用来源。 这里面最容易被低估的是第一条。比如我们前面聊的 PDF,人看到的是章节、表格和上下文,但机器拿到的可能只是坐标和文字。如果这里解析错了,后面的 Embedding、向量数据库、Rerank 全部建立在错误数据上。现在一些 Document AI 工具已经开始把 PDF 恢复成包含章节、表格、图片、页眉页脚和来源信息的结构化文档,而不是单纯抽文本。 第二个容易踩的坑是:不要迷信纯向量搜索。 企业知识里有大量 SKU、产品型号、合同编号、人名和数字。语义搜索很强,但精确关键词同样重要。所以真正成熟一点的 RAG,通常会开始做 Dense + Keyword/Sparse 的 Hybrid Search,再把召回结果交给 Reranker 排一次。 但企业 RAG 真正复杂的地方还不是这些,而是:旧文档怎么办?新旧政策冲突怎么办?不同部门权限怎么办?知识什么时候更新?回答错了怎么发现? 所以我现在越来越觉得,企业 RAG 首先是知识工程,然后才是大模型工程。 而 AI Coding 又把这件事情改变了一次。 以前做这套东西,你还要花大量时间写 Parser、API、Vector DB、后台、Docker。现在这些工程代码完全可以大量交给 Codex、Claude Code 之类的 Coding Agent 去实现。 于是人的价值反而往上移动了。 你真正需要知道的是:为什么这个 PDF 要结构化解析?为什么这里要 Hybrid Search?为什么这里需要 Rerank?为什么这个问题应该查知识库,而另一个问题应该直接查 SQL? AI 可以帮你写 RAG,但你必须知道什么才是一套正确的 RAG。 所以如果今天让我重新理解企业 AI,我不会再把 RAG 看成一个“知识库聊天机器人”。 我会把它看成一层新的企业基础设施: 把散落在 PDF、Word、网页、数据库和员工脑子里的知识,变成 AI 可以检索、理解、引用,并且有权限地使用的知识层。 等这一层真正建立起来,上面接的就不只是 Chatbot 了。 还可以是客服 Agent、销售 Agent、内部 Copilot、内容 Agent、决策 Agent…… RAG 真正有价值的地方,从来不是“让 AI 可以读 PDF”。 而是: 让一个企业第一次拥有一层,可以被 AI 调用的知识系统。 这可能才是企业 RAG 真正值得做的地方。 GitHub: github.com/fighting41love…
显示更多 话题来源 @UPing123zzz 4W阅读 ❤️507
封面由站内生成
GitHub - fighting41love/funNLP: 中英文敏感词、语言检测、中外手机/电话归属地/运营商查询、名字推断性别、手机号抽取、身份证抽取、邮箱抽取、中日文人名库、中文缩写库、拆字词典、词汇情感值、停用词、反动词表、暴恐 中英文敏感词、语言检测、中外手机/电话归属地/运营商查询、名字推断性别、手机号抽取、身份证抽取、邮箱抽取、中日文人名库、中文缩写库、拆字词典、词汇情感值、停用词、反动词表、暴恐词表、繁简体转换、英文模拟中文发音、汪峰歌词生成器、职业名称词库、同义词库、反义词库、否定词库、汽车品牌词库、汽车零件词库、连续英文切割、各种中文词向量、公司名字大全、古诗词库、IT词库、财经词库、成语词库、地名词库、... GitHub
成吉思鸡 ·

🚀 Agent 现在能直接操控你的安卓手机了!

最近上线的 android-remote-control-mcp 项目让手机操作自动化变成了现实:跑个 MCP Server 就能让 Agent 像人一样操作任意安卓 App,不用 root、不用数据线、不用电脑跑 ADB 中转,装一次就能远程遥控家里的手机,支持读屏、点击、滑动、打字、启动 App、拍照、读取通知等 57 个工具。

安装分两条路,门槛都很低:
· 真机安装:去项目 Releases 页下载对应 APK,带 Google 服务的手机选 GMS 版,去谷歌化 ROM 选 FOSS 版,侧载安装后开启无障碍服务即可(Android 13+ 需在应用设置里开启「允许受限设置」才能激活开关)
· 模拟器安装:用 Android Studio 自带模拟器搭一台 Pixel 7/Android 15 实例就行,后续步骤和真机完全一致,不用走「允许受限设置」步骤

把项目仓库链接丢给你的 Agent,让它自己读 README 完成 MCP Server 配置就行,你只需要把 App 里显示的 IP、端口和 token 给它:手机和电脑同 WiFi 就把绑定地址改成 0.0.0.0 用局域网 IP,用模拟器就直接用本机地址,人在外网就开 App 里的 Remote Access 隧道用公网地址。

项目还自带 Claude Code 插件,可以把手机通知、WiFi 状态、地理围栏等事件反向推送到 Agent 会话,也可以让 Agent 顺手一起装上。

💡 已经试过的朋友来聊聊实际体验怎么样?

🔗 相关链接

🔗 相关链接
t.co/sAtV91ZmQW
t.co/eHKjS7PHSR

GitHub: github.com/danielealbano/…

显示更多 话题来源 @LawrenceW_Zen 5W阅读 ❤️484
封面由站内生成
GitHub - danielealbano/android-remote-control-mcp: An MCP Server for Android running on the phone, optmized for token us An MCP Server for Android running on the phone, optmized for token usage, supports also files downloads and cloudflare and ngrok automated tunnelling. - danielealbano/android-remote-control-mcp GitHub
哇!是牛来 ·
来了来了,《WorkBuddy Harness 技术拆解蓝皮书📘》正式发布,全文免费、开源,支持在线阅读和 PDF 下载。 我越来越确定:想真正用好一个 Agent 产品,光会操作远远不够。你得知道一次请求是怎么把身份、记忆、插件和项目上下文拼在一起的。出了问题,才知道该去哪里找证据,也知道如何用的更好 所以这本书沿着「UI 行为 → 本地文件 → 发给模型的请求」一路往下拆:系统提示词、三层记忆、身份系统、专家、插件、Skill、Connector、SubAgent、会话证据和安全边界。 如果你也遇到过「改了配置为什么不生效」「WorkBuddy 到底记住了什么」「插件往主线程里注入了什么」「专家、Skill 和 SubAgent 到底是什么关系」,这本书就是为你写的。 预告里说,我想成为市面上最懂 WorkBuddy 的 AI 讲师。这本书,就是我交出的第一份公开答卷。 🔗 相关链接 t.co/RsaQniOXxA GitHub: github.com/zjp1997720/zhi…
显示更多 话题来源 @zjp1997720 3W阅读 ❤️344
GitHub - zjp1997720/zhijian-ai-bluebook-workbuddy-harness: 智见 AI 蓝皮书:拆解 WorkBuddy 的提示词、记忆、插件、专家、Skill 与安全边界。 智见 AI 蓝皮书:拆解 WorkBuddy 的提示词、记忆、插件、专家、Skill 与安全边界。. Contribute to zjp1997720/zhijian-ai-bluebook-workbuddy-harness development by creating an account on GitHub. GitHub
小白爱摸鱼 ·
DeepSeek 刚刚颠覆了编程代理行业。 deepseek-harness: Open-source. Free. Claude Code's top plan costs $200/month. 核心功能: → 一切皆插件——模型适配器、工具、会话日志,甚至代理循环本身,均可通过配置自由切换 → 基于 DeepSeek 自研的插件运行时 Cordis 构建 → 一条命令启动:npx -ai/dsh web —— 自动拉起本地 Web 界面 → TypeScript,MIT 许可证,开发者预览版——预计会有破坏性变更,DeepSeek 自己也这么说 替代对象: → Anthropic 的 Claude Code → 封闭的、单一供应商编码代理(coding-agent)环境 一家前沿实验室刚刚免费放出了公司收取订阅费的确切层级。 → 🔗 相关链接 t.co/b4EzZ8NwT5 GitHub: github.com/deepseek-ai/de…
显示更多 话题来源 @ArchiveExplorer 19W阅读 ❤️1774
封面由站内生成
GitHub - deepseek-ai/deepseek-harness: DeepSeek Harness: Everything is a Plugin. DeepSeek Harness: Everything is a Plugin. Contribute to deepseek-ai/deepseek-harness development by creating an account on GitHub. GitHub
自由翻滚的风铃草 ·
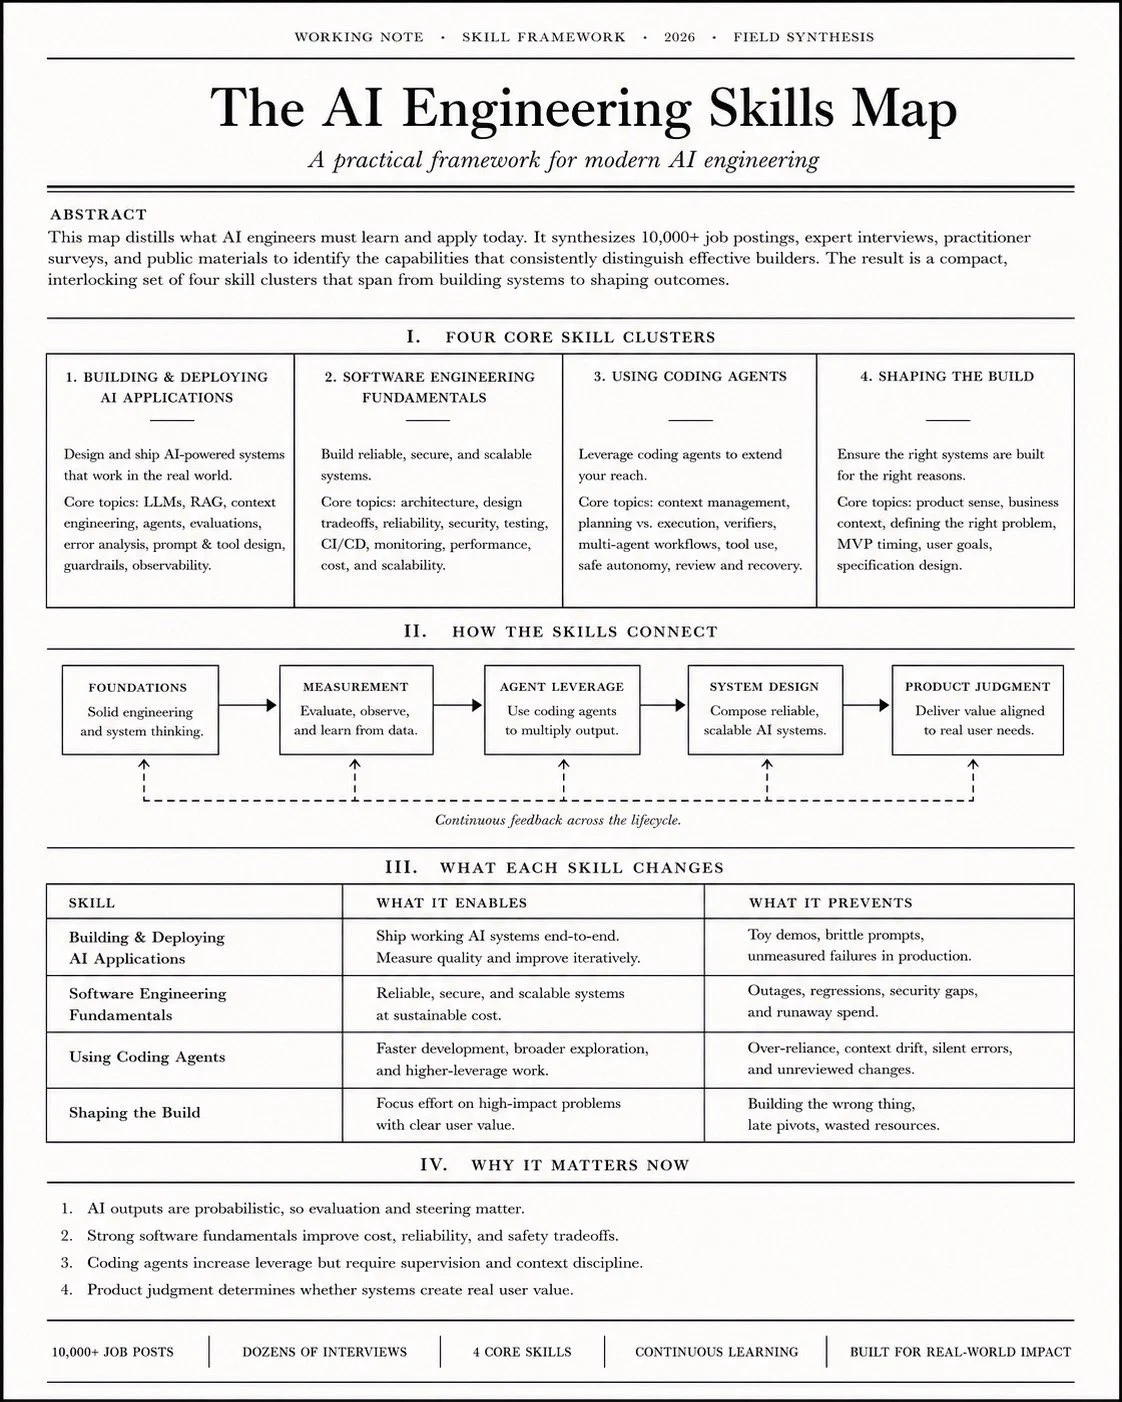
吴恩达刚刚发布了一份「AI Engineering Skills Map」。 它基于 1 万多份招聘需求、专家访谈和问卷,把今天开发者最重要的 AI 工程能力归成了四块: 构建和部署 AI 应用、软件工程基础、使用 Coding Agent,以及 Shaping the Build。 前两点我觉得尤其值得注意。 AI 应用最大的麻烦之一,是输出本身带有不确定性,所以真正重要的能力会落到 eval、error analysis、context engineering、RAG、agent workflow 这些地方。 与此同时,Coding Agent 越强,软件工程基础反而越重要。你得知道架构、测试、可靠性、安全这些 trade-off,才能判断 Agent 做得对不对,也知道该给它什么 context。 最后一项「Shaping the Build」也很有意思。 当 Agent 已经能越来越好地按照 spec 执行,工程师的工作会更多落到前面:理解业务、定义问题、决定该做什么,以及什么时候快速做 MVP,什么时候应该慢下来。 我自己看完最大的感受是,AI 并没有让工程能力变简单,只是把工程师的价值往更高一层推了。 以后会写代码当然重要,但更重要的是能不能把问题定义清楚、把 Agent 用好,再对最后的结果负责。
显示更多 话题来源 @Xudong07452910 6W阅读 ❤️308
封面由站内生成
Xudong Han (@Xudong07452910) on X 吴恩达刚刚发布了一份「AI Engineering Skills Map」。 它基于 1 万多份招聘需求、专家访谈和问卷,把今天开发者最重要的 AI 工程能力归成了四块: 构建和部署 AI 应用、软件工程基础、使用 Coding Agent,以及 Shaping the Build。 前两点我觉得尤其值得注意。 AI 应用最大的麻烦之一,是输出本身带有不确定性,所以真正重要的能力会落到 e X (formerly Twitter)
菠萝与大西瓜 ·
一个暴论:B站是现在国内最热闹的技术论坛。 今天看到推上有人讨论B站上面都是AI大佬。 其实这两周一直在追 DeepSeek V4,我也发现B站可能已经成了国内最被低估的AI技术社区之一。 以前我找最新的 AI 信息,基本就是 X、GitHub、Hugging Face,再加几个技术论坛(L站V站之类的)。 B站在我印象里,更多还是教程、科普和二手信息。 但这次从 DeepSeek V4 一路追到 DeepSeek Harness,我发现很多真正有意思的东西,我居然都是先在 B 站看到的。 举两个最近的例子。 一个是小明XBright这个UP。 在DeepSeek Harness 发布之后,社区里的大家很快发现一个很奇怪的现象: 官方测试里,工具极少的 Minimal 模式,反而比 Standard 模式表现更好。 小明XBright就开始自己研究 Harness 到底做了什么,最后直接在 Windows 上用标准工具,加上对极简模式思维链的还原,去复现 Minimal 的效果。 这已经不是普通的DeepSeek Harness 使用教程了。 大家实际上是在一起拆 Harness,研究 Context、Tool 和 Prompt 到底怎么影响模型的 Agent 能力。 另一个是隔山水樵这个老哥。 之前我写 DeepSeek V4 可能存在不同模式、不同版本的时候,很多最早的线索就是在他的内容和评论区看到的。 是不是 Max 模式,有没有灰测和路由,不同版本思维链为什么分别喜欢出现「users want me」「let me」之类的表达…… 大家直接拿不同 Key、不同时间、不同任务去跑,然后在评论区贴结果互相验证。 Harness 发布之后,他又第一时间拿 V4 Pro 配合 Harness 去测复杂任务。 一条这么硬核的视频,25万播放,半夜还有几百个人同时在看。 这种视频最近在 B 站好像有推流,我能刷到特别多。 DeepSeek 每次一更新,我现在甚至会下意识去 B 站搜一遍。 而且最有意思的还不是这些做完之后的视频,而是B站直播。 每次一个新模型刚发布,我几乎总能找到有人直接开直播,和观众一起测试。 弹幕里有人出题,主播现场跑: 弹幕里发现模型行为不对,马上换 Case; 跑出了奇怪结果,评论区继续复现; 再过几个小时,有人把结果整理成视频; 最后甚至有人把方法做成代码、Skill、插件,扔到 GitHub。 这次 DeepSeek Harness 的插件榜里,前排也出现了多个 B 站 UP 主做的开源项目。 我觉得这种氛围特别好。 它有点像十几年前的某乎或者贴吧,只不过帖子变成了视频,回帖变成了弹幕,围观的人可以直接跟着一起跑实验。 以前我觉得 B 站是一个「看别人讲 AI」的地方。 最近追 DeepSeek 才发现: 这里正在变成一群人一起玩 AI、测 AI、拆 AI 的地方。 至少在 DeepSeek 这条线上,我现在已经真的会把 B 站当成一手信息源了。
显示更多 话题来源 @MaxForAI 8W阅读 ❤️908
封面由站内生成
Max For AI (@MaxForAI) on X 一个暴论:B站是现在国内最热闹的技术论坛。 今天看到推上有人讨论B站上面都是AI大佬。 其实这两周一直在追 DeepSeek V4,我也发现B站可能已经成了国内最被低估的AI技术社区之一。 以前我找最新的 AI 信息,基本就是 X、GitHub、Hugging Face,再加几个技术论坛(L站V站之类的)。 B站在我印象里,更多还是教程、科普和二手信息。 但这次从 DeepSeek V4 X (formerly Twitter)
我不是小布丁 ·
吴恩达(Andrew Ng)刚刚发布了一份文档,梳理了AI工程师在2026年真正需要的4项核心技能。该文档基于1万多份招聘信息、专家访谈和调研数据编制,呈现了工程师当前真正需要关注的能力地图: 构建AI应用 → 精通软件工程 → 掌控编码智能体 → 主导项目构建 4 clusters cover LLMs, RAG, evals, context engineering, architecture, verifiers, multi-agent workflows and product sense coding agents can already execute clear specs. the bigger skill is deciding what to build, giving agents the right context and knowing when to intervene 10,000+ jobs distilled into 4 core skills. bookmark this before deciding what to learn next
显示更多 话题来源 @gippp69 1W阅读 ❤️233
封面由站内生成
Gipp 🦅 (@gippp69) on X ANDREW NG JUST DROPPED THE DOCUMENT THAT MAPS THE 4 SKILLS AI ENGINEERS ACTUALLY NEED IN 2026 he built it from 10,000+ job postings, expert interviews and surveys. the result is a map of what actuall X (formerly Twitter)
哇!是牛来 ·
🚀 Cloudflare刚开源Cloudflare OS,直接宣告传统SaaS范式死刑,AI时代的"千人千软件"真的要来了? 这次开源的核心是打破了SaaS"用户只有使用权、无修改权"的铁则:每个用户都能运行团队应用的专属代码副本,想加功能不用等开发者排期,直接让Agent动手改,这在传统SaaS模式下根本不可能实现。 背后的推动者是Cloudflare Workers之父Kenton Varda,这是他憋了10年的布局——早在10年前他就做过类似方向的创业项目,只是当时时机不成熟,如今AI改写前提,Cloudflare OS本质就是当年项目的重生版:基于Workers构建、深度结合AI能力,定位是「公司级个人应用vibe coding平台」。 核心亮点非常清晰: · Gadget沙箱:每个应用实例跑在独立隔离沙箱,比如文档编辑器里每份文档都是独立Gadget,权限按"谁能访问哪个Gadget"统一收口,哪怕AI写出漏洞也无法越界 · Gatekeeper权限网关:Agent默认零权限,需要访问GitHub时可精细控制到仅开放指定仓库、仅可读issue不能碰源码、合并PR必须人工审批,凭证完全隔离在Agent之外,生成的代码仅持有类型化capability · 污点追踪式数据治理:平台会记录Agent访问过的所有资源,若Agent读取敏感数据生成了数据看板,其他用户打开时会先校验其是否有原始数据权限,分享产物不会绕过权限规则,接触过敏感数据的Agent还会被限制对外发请求 目前Cloudflare内部非工程岗已经全员使用数月,日常做文档、建数据看板、跑自动化工作流都已落地,现在核心代码与部署模板已全部开源,任何组织都可以自行部署一套。 💡 10年前太超前的想法,AI让它踩到了正确的时间点,你觉得这种模式真的能替代传统SaaS吗? 🔗 相关链接 🔗 相关链接 t.co/rKFlmn8AYg,理念超…
显示更多 话题来源 @aigclink 2W阅读 ❤️225
封面由站内生成
自由翻滚的风铃草 ·
🚀 GitHub Trending 今天彻底被 Agent 项目集体屠榜,5 个星标暴涨的项目直接把 2026 年「Agent 可插拔能力层」的风口焊死在了台面上。 先看面向 Agent 感知与内容生产的能力补全: · Panniantong/Agent-Reach:给 Agent 接上全网公开信息源 🔗 相关链接 t.co/vn7mtGSzjW t.co/N1WiUkLeec t.co/ZnDldYbJsD t.co/YXF5hHyosg t.co/tKcy97ddua GitHub: github.com/deusdata/codeb…
显示更多 话题来源 @GitTrend0x 8W阅读 ❤️649
封面由站内生成
GitHub - Panniantong/Agent-Reach: Give your AI agent eyes to see the entire internet. Read & search Twitter, Reddit, You Give your AI agent eyes to see the entire internet. Read & search Twitter, Reddit, YouTube, GitHub, Bilibili, XiaoHongShu — one CLI, zero API fees. - Panniantong/Agent-Reach GitHub
自由翻滚的风铃草 ·
很多人可能不知道,你和Codex的聊天记录隐藏了大量节省上下文token消耗的方法 输入下面这段提示词,让 Codex 找出过去 30 天的重复工作,并判断该做成 skill、subagent、还是自动化任务。 之后,你的工作效率将大幅提升: “检查我最近 30 天的 Codex 会话、Memories、Chronicle,以及已有的 Skills、Agents 和 Automations。 找出至少重复出现两次、耗时、容易出错、需要大量上下文的人工工作。 对每个候选项给出:实际证据和日期、出现频率、适合做成 Skill / Agent / Automation,或者暂时跳过、预计能节省什么。 先输出候选清单,不要直接修改文件。只保留高置信度、输入稳定、流程可重复、结果可验收的任务”
显示更多 话题来源 @Saccc_c 3W阅读 ❤️271
封面由站内生成
Sac (@Saccc_c) on X 很多人可能不知道,你和Codex的聊天记录隐藏了大量节省上下文token消耗的方法 输入下面这段提示词,让 Codex 找出过去 30 天的重复工作,并判断该做成 skill、subagent、还是自动化任务。 之后,你的工作效率将大幅提升: “检查我最近 30 天的 Codex 会话、Memories、Chronicle,以及已有的 Skills、Agents 和 Automations。 X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单