AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
我不是小布丁 ·
一张把人工智能圈的人和公司一网打尽的名单站 Frontier List 被摆上台面。靠的是社区投票。这收网我看完先记两档名单再掂四步用法。记的掂的点在下面一层层摆,摆好了看两档,档在下面摆着。 两档是这样分的,七十人投票选出的前沿共识档站着 Anthropic 和 OpenAI。紧随其后的那一档含 DeepMind 和 xAI 等。分档的第二层是它的数据来源,来源是社区投票而不是编辑钦点。投票的第三层在下面摆着,摆好了别眨眼,眨眼就翻过去了。 细分名单是这样铺开的,高密度人才实验室、后训练服务。显卡供应商。机器人实验室、人工智能天使、数据公司各占一栏。人的去向也盯着。后训练专家和旧金山活动组织者,方便挖新团队。 点评两句。第一句是把社区投票做成分档依据这招今年值得所有榜单产品学,学了的排名自带公信力背书。第二句是人才名单和产业链名单放一页这个组合今年会让猎头和投资人都少开好几个表格。 站点在这,frontierlist.com ,翻完记得存书签,存了的点赞,句号。
显示更多 话题来源 @NFT_Chen 5K阅读 ❤️32
Frontier List Lists by Chris Barber (@chrisbarber): polls of named insiders and hand-researched lists on AI data startups, the AI supply chain, and the people building both. Frontier List
我不是小布丁 ·
自己从零写了一遍智能体外壳之后,常用的两个编程工具突然都变成了黑盒。这反差我看完先记那四个问题再掂玄学那半句。记的掂的点在下面一层层摆,摆好了看四个。个在下面摆着,摆好了自己答。 四个问题是这样列的。那个循环每一步怎么走、工具吐回来的结果怎么放回记忆、记忆快撑爆了怎么裁剪。哪一步该收手找人确认。四个的第二层是它们的共同处境。处境是文档看再多也似懂非懂,似懂非懂的第三层在下面摆着,摆好了别眨眼,眨眼就翻过去了。 解开的路子是翻开源源码,再亲手从白纸上码一遍。写完那刻起,从前看不明白的怪脾气全有了说法。解释的第四层是这句建议的分量。分量是每天用人工智能写代码的人都该自己做一个,哪怕很简陋,简陋的第五层是我的保留。 点评两句。第一句是似懂非懂这四个字戳中了今年所有看文档的人,四个问题里能答上两个的都算老手。第二句是从零写一遍这步今年值得所有重度使用者各来一次,来过的回来点赞,句号。
显示更多 话题来源 @ScarletKc 52.2K阅读 ❤️552
KC (@ScarletKc) on X 最近在自己手搓 harness,越做越觉得以前用 Claude Code 和 Codex 都是在用黑盒。agent loop 怎么转、工具结果怎么塞回上下文、上下文快满了怎么压缩、什么时候该停下来问人,这些东西文档看再多也是似懂非懂,翻了很多开源项目的源码,再自己从零写一遍之后,很多以前觉得是玄学的行为一下子全都能解释了。收益大到离谱,我感觉每天用 AI 写代码的人都应该自己做一个,哪怕很简陋。 X (formerly Twitter)
自由翻滚的风铃草 ·
同一把火,两家人点出了不一样的烟花,这组 token 消耗对比只给了四行。 两行照录。中国的第一大用途,是百分之五十五的 token 消耗流向了短剧、短视频、娱乐内容生成;美国的第一大用途,百分之五十八的 token 消耗花在编程、研发和企业自动化上。开头那句也留着,AI 时代,中国人再一次把火药做了烟花。 "火药与烟花"这半句是场重心。前面那份恐怖盘点讲的是位置怎么摆,这条讲的是位置背后的燃料往哪流。跟前面早半年占位呼应,那条在抢用户的时长,这条在抢算力的去向。两头都在提醒同一件事,两个市场把同一种生产资料花在了不同地方。跟前面全系深度卷那条也接得上,一边在把模型卷向娱乐内容的量产,一边在把模型卷进研发流程。卷的方向就是这份表画出来的分叉。 五十五对五十八这两个数我单独拎出来,比例几乎对称,用途却完全不重叠,说明分岔不在技术能力,在需求侧先长成了不同的样子。 我留的疑问有三处。统计的样本和时段没给;两国之外的分布没拆;短剧和短视频的口径也没数,这些都在被引用的那份原始数据里才查得到。 这周把自己一周的 token 花法记一张表,看落在哪一边。
显示更多 话题来源 @criscxuan 757.2K阅读 ❤️3904
cxuan (@criscxuan) on X 看到一个帖子: AI 时代,中国人再一次把火药做了烟花。 中国的第一大用途:55% 的 token 消耗是短剧、短视频、娱乐内容生成。 美国的第一大用途:58% 的 token 消耗是编程、研发、企业自动化。 X (formerly Twitter)
我不是小布丁 ·
一个月二十美元的 Cursor 被 MLH 的 Global Hack Week 摆上了免费桌,这次不看学生身份。这白送我看完先记三步流程再掂额度那半句。记的掂的点在下面一层层摆,摆好了看三步,步在下面摆着,摆好了自己走。 三步是这样走的,第一步去 MyMLH 注册并报名这场全球黑客周。第二步等官方邮件发来兑换码,第三步回到编辑器的账单页里把码兑掉升级。三步的第二层是它的门槛。门槛是十月九到十五日、免费、全球可报、不要求学生身份。 角落是这样留的。兑换码给多少额度、是不是人人都领得到、要不要绑卡。三件事目前都没有明确说法,清楚的第四层是它和以往学生优惠的区别。区别是这次把学生身份那道卡给拆了,拆的第五层是我的保留。 点评两句。第一句是把身份这道门槛拆掉这步今年值得所有开发者福利抄,抄了的活动参与量会翻倍。第二句是额度不说清先发码这个顺序今年该学学,先给再谈上限,抢到的回来点赞,句号。
显示更多 话题来源 @taiyanghere 121.1K阅读 ❤️1061
太阳 (@taiyanghere) on X 免费领 Cursor Pro。这次不是学生优惠。MLH 正在办 Global Hack Week,任务里写着通过邮件发兑换码,免费开 Pro。正常订阅 20 美元一个月。领取方法:注册 MyMLH 报名活动 → 等官方邮件拿兑换码 → 在 Cursor 的 Billing 里兑换升级。活动 10 月 9–15 日,免费,全球可报,不要求学生身份。不过兑换码的具体额度、是不是人人都有、要不要绑卡,目 X (formerly Twitter)
我不是小布丁 ·
一份万字总结把智能体开发工程师的技能盘了出来。范围不止智能体本身。这盘点我看完先记那三块再掂会调接口那半句。记的掂的点在下面一层层摆,摆好了看三块,块在下面摆着。 三块是这样摆的,智能体自己的东西一块、大模型基础一块。后端基础一块,三块合起来才是这份总结给的全貌。全貌的第二层是它对着的行业共识,共识是这类岗位早就不考某个框架的调用。 误区是这样列的。第一个是把智能体当成提示词加一个循环,原型能这么跑。生产还差状态。权限、恢复和评估那一整套,第二个是智能体越多越高级。数量一涨。令牌、延迟、状态同步、调试难度全跟着涨,只有职责真独立时才该拆。 点评两句。第一句是把后端基础并进必考这步今年值得所有想转岗的人先补,补完再刷框架。第二句是不会调接口还不算入门这半句今年会让一批速成课重新写大纲,写完的回来点赞,句号。 总结在这,x.com/i/article/2108… ,对着阶梯自查一遍,查出短板的点赞,句号。
显示更多 话题来源 @chasen_liao 59K阅读 ❤️789
小白爱摸鱼 ·

字节跳动被摆成一份十赛道清单,看完就知道它有多恐怖。

赛道照录。短视频双冠。抖音在国内泛短视频里是绝对霸主,使用时长全网第一、压过微信,渗透率百分之四十六点八,把快手和视频号远远甩开。直播、电商、本地生活、短剧也一并打通。TikTok 那边,一百五十多个国家开着门,全球月活二十亿往上,欧美与东南亚的下载榜常年由它坐头把。

剪映也就是 CapCut,全球手机剪辑这块它排第一,国内月活两亿八,海外装机量五亿八往上,创作者人手一个。AI 对话这条,豆包是国内通用 AI 对话 App 月活第一,二零二六年月活三点八二亿,把阿里千问和 DeepSeek 都甩在身后。

免费网文是番茄小说,日活和时长长期领跑;短剧是红果免费短剧,月活超三亿,使用时长压过了 B 站和小红书。图文资讯有今日头条,稳居行业前二;音乐流媒体的汽水音乐月活一点四亿,已经越过网易云,只在 QQ 音乐之后。

人像修图这一格,醒图排在美图秀秀身后;汽车的懂车帝行业第二,刹车事件之后有望冲第一;企业办公的飞书在高端市场断层领先,和钉钉、企业微信三分天下;中长视频的西瓜在 PUGC 这块仅次于 B 站。末尾那句也留着,现在懂车帝敢硬刚华为的底气从哪来,有答案了。

"十个赛道九个前二"这半句是场重心。前面早半年占位讲的是软件生态里抢位置,这条讲的是每个赛道里都有一个位置摆在那里。跟前面那份数据对照实验呼应,那条在量一个旋钮,这条在量十个战场。两头都在提醒同一件事,位置本身是资产,占住之后复利才开始滚。跟前面生成搬回本地那条也接得上,一边是基础设施级的分发,一边是个人机器上的生成,两边同时在扩张。

我单独拎出来的是渗透率四十六点八这个数,它意味着接近一半的手机用户每天都在它的池子里。别的赛道再热闹,也是从这个池子分出去的水。

我留的疑问有三处。各赛道的口径年份没统一;第二名的具体差距没拆;刹车事件指的是哪一件也没说,这些都在各家的年度报告里才对得上。

这周把自己常用 App 的清单列一遍,看有几个落在这十格里。

显示更多 话题来源 @weiyux2021 415.2K阅读 ❤️989
动物园园长 (@weiyux2021) on X 字节跳动这家公司有多恐怖: 一、短视频赛道(全球/国内双第一) 1. 抖音(国内) 国内泛短视频绝对第一,用户使用时长全网第一(超过微信),渗透率46.8%遥遥领先快手、视频号;同时打通直播、电商、本地生活、短剧,是国民级超级平台。 2. TikTok(海外抖音) 全球短视频霸主,覆盖150+国家,全球月活20亿+,欧美、东南亚多国下载榜常年第一,海外短视频无对手。 3. 剪映(Cap X (formerly Twitter)
自由翻滚的风铃草 ·

"眼下的优势,是看清可能性并且保持好奇",这句话被摆成了新时代的起跑线。

正文照录。用 AI 做软件工程如今已是默认配置,有优势的那批工程师都带着野心,且已经在岗位上跟代理磨了好几年,这是复利效应。给还没跟上的团队一条建议,要比现在更有野心,并且激进地把学到的东西分享给同事。

私下闷头干只有你自己受益;如果团队只能在下班后才摸到 AI,那就等于悄悄告诉他们,用 AI 这件事不算数。资深工程师应该第一个转,他们攒了几十年的系统设计品味和失败模式直觉,正是让代理输出变好的秘方。

该把这份经验用在给代理构建更安全的边界上,再把有效的做法摆出来让别人复制。引帖那句也留着,团队若忙得没空试 AI,就是在准备让成员被替换,AI 的使用已不再是可选。

"不算数"这半句是场重心。前面组里那堂分享讲的是个人怎么攒经验,这条讲的是组织怎么给经验定性。跟前面验收那步留着呼应,那条在流程里留关卡,这条在制度里开口子。两头都在提醒同一件事,工具的采纳从来不只关乎个人手感,还关乎组织认不认账。跟前面两派拔河那条也接得上,一边担心基本功下沉,一边催资深者带头转,两头说的其实是同一批人。

下班后才能试这句我单独拎出来,它把一个软性问题写成了硬指标,试用的时间安排就是组织对 AI 的真实表态,比任何宣言都准。

我留的疑问有三处。"磨了几年"的量化标准没给;分享机制的具体形式没拆;资深者带头的落地案例也没数,这些都在原文更长的版本里。

这周把自己团队的试用时段挪进工作时间,先跑一周看产出的落差。

显示更多 话题来源 @addyosmani 33.4K阅读 ❤️599
Addy Osmani (@addyosmani) on X "your edge right now is understanding the possibilities and being curious" Using AI for software engineering is now the default. The engineers I've seen who have the edge are ambitious and have been X (formerly Twitter)
我不是小布丁 ·

github.com/tcchen2026/Vib…
vibeoffice.work

一千美元复刻出来的 Office 全家桶开源了,电子表格连 VLOOKUP 都认。

三句照录。源头是 V2EX 上的一个帖子,有人花了一千刀把 Office 全家桶复刻了一遍;转帖的人试用之后给了句实感,电子表格居然支持 VLOOKUP,配了个牛字加赞;最后两行把地址交出来,开源仓库和在线试用都在下面。两处地址挂在文首。

"VLOOKUP 都认"这半句是场重心。前面轮到家装出汗讲的是把制图搬走,这条讲的是把办公套件整个重打一遍。跟前面五十个目录收进一库呼应,那条在管工具的零件,这条在造工具的本体。两头都在提醒同一件事,AI 写出来的软件开始敢碰那些沉淀了几十年的老功能。

跟前面那道没答上的题也接得上,能认 VLOOKUP 意味着公式引擎不是花架子,复刻这件事从界面层沉到了引擎层。

一千刀这个数我单独拎出来。办公套件这种量级的东西被一个人用这个预算重做出来,靠的是把最耗人的部分全部交了出去。剩下的力气花在验收上。

我留的疑问有三处。全家桶具体包含哪几件没列;VLOOKUP 之外的函数覆盖没拆;协作能力有没有也没数,这些都在那个在线地址里才试得出来。

这周拿它开一份真在用的表,把 VLOOKUP 和透视这两关先跑一遍。

显示更多 话题来源 @karminski3 87.3K阅读 ❤️688
GitHub - tcchen2026/VibeOffice: A free office suite that runs in your browser, in the style of Office 2003. Nothing to i A free office suite that runs in your browser, in the style of Office 2003. Nothing to install, no account, no server: documents are opened, edited and saved on your own computer. - tcchen2026/Vibe... GitHub
自由翻滚的风铃草 ·
github.com/mksglu/context… AI 写代码的 token 用量被一个插件砍掉了最多九成八,名叫 Context Mode。 原理照录。它的位置卡在工具的大段输出进到代理之前,先把那堆东西滤一遍。上下文的浪费因此减少,同时在长时段的编码任务里保住可以搜索的会话记忆。Claude Code 里的装法三步摆开,先加插件市场 mksglu/context-mode,再装 context-mode 这个包。重启后跑 /context-mode:ctx-doctor 检查挂钩是否真的生效。 "先过滤再进门"这半句是场重心。前面五小时额度像流水讲的是默认策略太激进,这条讲的是自己动手把门口装上滤网。跟前面付钱前先看这十处呼应,那条在花钱前挑地方,这条在进门处拦浪费。两头都在提醒同一件事,代理时代省额度的正解不在少聊,在不把垃圾送进门。跟前面 Yobiru 那条也接得上,一个在机器之间传消息,一个在门口筛消息,网和滤是同一件事的两面。 九成八这个数我单独拎出来。能砍到这个比例,说明长任务里有用的信息只占很小一块,剩下的都在陪跑。这大概就是上下文经济学的全部。 我留的疑问有三处。九成八的测法没给;过滤的误伤率没拆;会话记忆的检索上限也没数,这些都在仓库文档里才看得到。 这周装上跑三天,把 ctx-doctor 的钩子状态和额度曲线一起记下来。
显示更多 话题来源 @RoundtableSpace 75.7K阅读 ❤️122
GitHub - mksglu/context-mode: Context window optimization for AI coding agents. Sandboxes tool output (98% reduction), p Context window optimization for AI coding agents. Sandboxes tool output (98% reduction), persists session memory, and enforces routing across 17 platforms via MCP + hooks. - mksglu/context-mode GitHub
自由翻滚的风铃草 ·

递归自我改进这件事在 Qwen 这里不再是传闻,全系模型都排上了日程。

三段照录。划的重点是,4.0 这一整代都会深度用上 RSI,而阿里巴巴动手更早,Qwen 3.8 Max 上已经连着跑了一个多月。云栖大会上,Qwen 负责人刘大一恒把话说实了,内部确实在用这套递归自我改进,Max、Plus、Flash、27B 四档一并继续往深里做。

过程那行写得最具体。模型先从真实日志里自己找毛病,再自己造训练数据,交给小模型多轮试,最后把结果推进旗舰的训练,中间几乎不用人插手。补的数也摆开。连着跑一个多月,三十三轮算数的迭代,Qwen3.8-Max 在 AA 智能指数上三十天从四十爬到四十五,一脚踩进第一梯队。收尾那句留着,全系正在自己推着自己进化,加速键按下多时了。

"近乎零人工干预"这半句是场重心。前面饭局上没夸自己家讲的是圈内听说谁在推进,这条讲的是当事人自己把流程摆上了台。跟前面那份数据对照实验呼应,那条在量数据的功劳,这条在量自动的成色。两头都在提醒同一件事,自我改进已经从论文名词变成了产线工序。跟前面两派拔河那条也接得上,人在回路的争论还没完,这边已经把人从循环里请出去了。

四十到四十五这个数我单独拎出来。三十天涨五个点听着不炸,可它是在没有换架构、没有换数据源的前提下自己爬上来的,爬的还是公开榜单。

我留的疑问有三处。三十三轮迭代的算力开销没给;小模型验证的通过率没拆;四档模型的采用深度是否一致也没数,这些都在云栖大会的完整分享里。

这周把 Qwen3.8-Max 在榜上的位置记一张底,等 4.0 全系落完再对一次涨幅。

显示更多 话题来源 @NFT_Chen 0.6K阅读 ❤️14
SuSu_酥酥👅 (@NFT_Chen) on X 💥划重点!Qwen 4.0全系模型将深度RSI,其实Alibaba早在Qwen 3.8 Max就已采用RSI连续跑了一个多月! 云栖大会上,Qwen负责人刘大一恒明确披露:内部已实际使用RSI(递归自我改进),并且Qwen 4.0全系(Max/Plus/Flash/27B)将继续深度采用。 模型从真实日志自动找短板→自造训练数据→小模型多轮验证→最终推入旗舰训练,全程近乎零人工干预。 他补充 X (formerly Twitter)
小白爱摸鱼 ·
wy51ai.github.io/floorplan-3d/ 装修这门手艺被一个工具顶到了门口,画户型、拆墙体、3D 漫游摆家具,三步连着做。 三句照录。第一句是夸,一个字,牛。第二句摆能力,直接画出户型图,能把墙体拆掉重来,还能用 3D 漫游的方式往里摆家具。第三句是那句流传最广的感叹,AI 淘汰完了界面设计师,终于轮到家装设计师出汗了。地址挂在文首。 "轮到家装设计师出汗"这半句是场重心。前面换角这件事定了讲的是视频里换人,这条讲的是图纸上动墙。跟前面原生 PPT Skill 呼应,那条搬走了排版的时间,这条搬走了画图的门槛。两头都在提醒同一件事,设计这条链正从右端的创意往左端的制图逐格失守。跟前面那道没答上的题也接得上,检索错了还有人验收,画错了同样得有人点头,工具越往前挪,人的位置越靠后也越关键。 排版、换角、画户型这三个例子我单独拎出来,被点名的都不是设计的魂,是设计里最耗工的那部分,这也是它们先被端掉的原因。 我留的疑问有三处。户型图的精确度没给;和施工图的衔接没拆;家具库的规模也没数,这些都在那个页面里才看得到。 这周拿它给自己家重画一版,跟装修公司的报价图对着看差多少。
显示更多 话题来源 @ianneo_ai 11.4K阅读 ❤️171
户型装修设计 wy51ai.github.io
我不是小布丁 ·

一篇复旦的实证论文把 AI 搜索的信源底牌翻了出来,密码学研究院一起做的。

研究照录。论文的完整名字是《从公开内容发布到 AI 搜索引用:衡量 AI 搜索系统的脆弱性》。做法是真去发内容,再看谁被引用。覆盖十个 AI 搜索平台,ChatGPT、Google AI、Perplexity、Grok、豆包、元宝、文心、千问、Kimi、DeepSeek 都在内。

四条重要发现摆开。其一,一万七千两百一十一次 AI 引用显示各平台挑信源有明显偏好,部分平台前二十个网站就贡献了七成以上的引用。其二,八成的平台引用过人为造出来的概念,团队在公开平台发了虚构词条,七天内有八个 AI 搜索平台把它收进了答案。

其三,发布渠道比堆数量值钱,一篇发在高偏好平台上的文章,引用效果超过发在低偏好平台上的二十多篇。其四,内容进答案不算慢,各平台的引用延迟从约二十四小时到超过五天不等。另有一单 GEO 服务采购,发布一小时内就见到 AI 引用,单子只花十四美元,服务商发了十三篇。

数据部分也扎实。引用条数上,Grok 平均每次回答五十二条,千问只有六条半,差约八倍,作者提醒这不能直接翻译成答案质量,得在每个平台内部建基线再比。头部集中效应明显,文心的前二十个域名占了七成零八的引用,DeepSeek 的前二十个只占两成零五,四种问题类型分开统计仍然如此。平台之间的信源重叠还很低,前二十个高频域名的两两平均 Jaccard 值只有零点二零一。

九条结论里挑三条。排头一条说的是,AI 搜索握着的真权力不是把话写出来,是先筛掉谁不配进答案;看似在搜整个互联网,实际可能反复只引少数几个站;内容删得出互联网,却不一定马上从 AI 的答案里消失。

"有资格成为答案"这半句是场重心。前面关键词扫描器那条讲的是找真空,这条讲的是真空本身也是被安排出来的。跟前面评测所换尺呼应,那条在改评测的尺,这条在改收录的尺。两头都在提醒同一件事,信息的入口正在被少数几家握着,而握法各不相同。跟前面可审计治理那条也接得上,一个要第三方进得来看,一个把看的结果直接写成了论文。

重叠度只有零点二这个数我单独拎出来。十家平台眼里的互联网几乎是十个不同的互联网,品牌想被一致地理解,得一家一家经营。没有一招通吃。

我留的疑问有三处。十四美元那单的后续复现没给;关联信源集中那节的结论没展开;样本期的长度也没拆,这些都在论文全文里。

这周按平台分开建信源档案,先从引用条数最多的那两家试起。

显示更多 话题来源 @yaojingang 2.7K阅读 ❤️35
姚金刚 (@yaojingang) on X 复旦大学与上海浦东密码学研究院团队的一篇最新的论文:《从公开内容发布到AI搜索引用:衡量AI搜索系统的脆弱性》 这是一篇与GEO行业高度相关的实证研究 它不仅研究 AI 搜索引用哪些网站,而且通过真实的内容发布实验,验证了内容发布平台的选择,如何影响内容进入AI搜索结果以及被AI引用的概率 论文研究了包括 ChatGPT、Google AI、Perplexity、Grok、豆包、元宝、文心、千问 X (formerly Twitter)
自由翻滚的风铃草 ·

GPT-6 Bel 还没发,一个循环剧本先写好了,末尾那句最扎眼。

四句照录。第一,OpenAI 即将发布 GPT-6 Bel,这模型被形容成猛兽,将碾压 Anthropic 的 Fable 5.5。第二,Codex 迎来的会是第二个 Astra 时刻,圈里会齐声喊 OpenAI 回来了。

第三,再往后一两周,Anthropic 那边抬出 Sonnet 或 Opus 6。第四,然后钟摆归位,Claude 把所有人按回去。引帖那句也留着,二十美元的 Plus 套餐是花过最值的钱,没有之一。

"回到当前的循环"这半句是场重心。前面聪明体现在哪讲的是单个模型的脾气,这条讲的是两家轮替的钟摆。跟前面饭局上没夸自己家呼应,那条在圈内交换风向,这条在圈内共用一副剧本。两头都在提醒同一件事,头部的胜负已经不再出圈,而是按月轮转。跟前面裁决成品类也接得上,一边是新赛道在发钱,一边是老对手在接力,热闹的形状不一样,速度却一样快。

倒数第二句那句自嘲我单独拎出来,Claude 碾压所有人写得毫不意外,说明这个循环已经被演练到能被预判,预判本身就是循环成立的证据。

我留的疑问有三处。Bel 的发布窗口没给;Sonnet 与 Opus 6 谁先没拆;碾压的衡量维度也没数,这些都得等各家自己兑现。

这周把两家的发布日历并排贴一份,下次循环开始时对着打钩。

显示更多 话题来源 @Zhibin992 43.7K阅读 ❤️237
Robin | Robotics Data (@Zhibin992) on X OpenAI 即将发布 GPT-6 Bel。 Bel 是一个猛兽般的模型,将碾压 Fable 5.5 Codex 将再次迎来 Astra 那样的时刻,所有人都会觉得 OpenAI 回来了。 一两周后,Anthropic 将推出 Sonnet 或 Opus 6。 然后我们将回到当前的循环:Claude 碾压所有人。 X (formerly Twitter)
小白爱摸鱼 ·

一台笔记本的曲子这件事成了,本地音乐模型被搬到 MacBook Pro 上跑。

三句照录。第一句是发现好东西的惊呼,带一句 WTF;第二句给出门槛,这个本地音乐模型一台 MacBook Pro 就能运行;第三句给质量找了参照,堪比 Suno,随后把人引去看视频,说开源地址放在评论区。转述最后的观感也留着,太强了。

"堪比 Suno"这半句是场重心。前面付钱前先看这十处讲的是把开销挪到决策前,这条讲的是把创作整个搬回本地。跟前面省钱的试错不心疼呼应,那条在省接口的钱,这条在省掉接口这一步。两头都在提醒同一件事,生成的边界正在从云端往自己的机器里收。

跟前面 M3 上 NVIDIA 那条也接得上,一个在把吞吐推向机房,一个在把模型压进笔记本。两头同时在跑,说明本地这条路不是省钱的将就,是正经的选项。

MacBook Pro 这个参照我单独拎出来,拿一台笔记本当运行底线来宣传,等于把专业音乐人的顾虑提前拆了,门槛写在明面上才敢被转发。

我留的疑问有三处。模型的名字和参数没给;开源仓库地址没在正文里出现,只说了在评论区;生成质量和授权边界也没数,这些都得自己顺过去。

这周把评论区那条地址翻出来装一遍,生成一段试试它的成色。

显示更多 话题来源 @vista8 26.7K阅读 ❤️266
向阳乔木 (@vista8) on X 发现一个超牛逼的东西,WTF?! 一个 MacBook Pro 就能运行的本地音乐模型。 质量堪比 Suno,太强了,看视频,开源地址见评论区 X (formerly Twitter)
自由翻滚的风铃草 ·
github.com/GordenSun/Gord… PPT 这档子活儿有了原生 Skill,专按中国人的习惯来做,开源免费。 三点照录。头一条强调原生,不是套壳糊弄的花架子;第二条说它更吃中文这套语境,审美和表达都不拧巴;第三条直接开源,想白嫖的直呼过瘾。前文那句抱怨也留着,做 PPT 一直是打工人的梦魇,熬到秃头的时间有一半砸在排版和调格式上,如今甩个 Skill 上去,省下的工夫不香吗。作者的收尾同样保留,先存为敬,感兴趣自己冲。 "按中国人的习惯"这半句是场重心。前面五十个目录收进一库讲的是管,这条讲的是挑。跟前面聪明体现在哪呼应,那条在给模型补原则,这条在给场景补趁手的件。两头都在提醒同一件事,skill 的竞争正在从有没有转向合不合身。跟前面二十二个只是开胃菜也接得上,一个在数货架品种,一个在挑最合手那件,挑与数是同一条链的两头。 排版调格式这半句我单独拎出来,办公自动化喊了多年,这次真正被搬走的不是创意,是最没创意的那半截时间。 我留的疑问有三处。兼容哪些工具没给;模板库的规模没拆;中文语境的适配边界也没数,这些都在仓库说明里才看得到。 这周拿它出一版真在用的汇报,看排版那半截时间是不是真的省了。
显示更多 话题来源 @0xGky 27.2K阅读 ❤️422
GitHub - GordenSun/GordenPPTSkill: AI-friendly PPT builder skill: 17 hand-polished Chinese PPTX templates + non-destruct AI-friendly PPT builder skill: 17 hand-polished Chinese PPTX templates + non-destructive text-only editing tools (python-pptx based). Pick a template, write edits.json, build a real .pptx with the ... GitHub
我不是小布丁 ·

一场 AI 独角兽的面试把 RAG 的深浅问了出来,答不上来的那题很典型。

题目照录。面试官靠在椅背上发问,智能客服里用户张口就要苹果最新款手机的价,可检索把库里红富士苹果每斤的批发排到了最前面。难题给了,这局面怎么彻底翻过来。心里那句吐槽也留着,这能怪谁,词向量聚类分不清水果和手机,要讲理找 OpenAI 和算法团队去,别拿一个做应用的出气。

嘴上蹦出来的只有两个补丁,往上换更大的 Embedding 模型行不行?或者把文本切块切得再碎些?面试官笑了笑,换到最大的模型也白搭,苹果就是苹果,语义照样发散,回去看看工业界怎么把关键词搜索和语义搜索拧到一起。

当晚请教完,落点才清楚。Dense 向量检索天生分不清专有名词和具体型号,这一条与模型大小无关。生产级的路子是把两套召回合着用,向量算余弦,BM25 管关键词精确命中,最后再让一个 Reranker 交叉编码过一遍打分。红富士手机那个笑话,标准的止血方案就是这一套。

"苹果就是苹果"这半句是场重心。前面聪明体现在哪讲的是模型缺的是提醒,这条讲的是检索缺的是结构。跟前面那份数据对照实验呼应,那条在训练侧控制变量,这条在推理侧补结构。两头都在提醒同一件事,能跑通的原型和能上生产的方案之间,隔着的从来不是模型大小。跟前面验收那步留着也接得上,检索错了要人验收,验收靠的就是这层结构化的设计。

心里和嘴上那两句反差我单独拎出来,它把应用工程师的窘境写活了,怪模型是本能,认结构才是专业。

我留的疑问有三处。混合检索的权重怎么配没给;Reranker 的选型没拆;题目之外的追问也没数,这些都在面试全长里才看得到。

这周拿自己项目里的检索排一遍,专有名词的召回率先量出来再说。

显示更多 话题来源 @king1818888 51.7K阅读 ❤️317
Kimberly (@king1818888) on X 前天刚去面了某 AI 独角兽的 Agent 落地组,结果直接在一道 RAG 检索细节上被问得哑口无言。 面试官发难:面试官靠在椅背上:“用户在智能客服里问‘苹果最新款手机多少钱’,但向量检索把知识库里‘红富士苹果每斤批发价’排在了第一名,你怎么彻底解决这个问题?” 我心里怎么想的:我当时在心里默默念叨:“大哥,这也能怪我?这明明是 OpenAI 或者开源 Embedding 模型的词向量聚类不 X (formerly Twitter)
自由翻滚的风铃草 ·

AI 监管框架该由谁坐在桌前,一句话点到了软件安全专家头上。

主张照录,就一句,这些人应当主导任何 AI 监管框架的讨论,说的正是软件安全专家。引帖把理由铺成了五条。其一,只靠前沿大模型自己的披露不够,护栏这类东西得设计成第三方能进来做观测和透明。

其二,等能做到了,企业用户还会想把护栏改成自己的价值观、原则和业务做法,总不能指望一套全球统一的护栏由模型创造者独占。其三,只要模型还是黑盒,真正做业务的公司就没法落地增强能力。可审计、可验证、可合规是企业继续经营的前提,得向外界证明尽到了照管义务。

其四,信息安全的架构几十年是稳的,AI 这边得腾出位置让人能顺畅、快速、持续地接口。眼下所有对接都是七拼八凑的补丁,因为模型供应商跑得太快。这层跟不上,整个行业会停住。其五,要让 AI 快速扩散并建立信任,刚由 Satya 开启的这场对话需要势头。

"第三方进得来"这半句是场重心。前面官方开始公开什么讲的是自家按班发报告,这条讲的是把门开给外人看。跟前面饭局上没夸自己家呼应,那条在圈内交换风向,这条在给圈外立规矩。两头都在提醒同一件事,模型的可信正从自我声明挪向可被检查。跟前面那份数据对照实验也接得上,一个用控制变量证明方法,一个用可观测性证明治理,证明这件事在两头同时变得重要。

黑盒那段我单独拎出来,它把模型的商业价值和安全风险说成了同一个东西,不能审计的增强能力,对企业来说等于没有。

我留的疑问有三处。框架讨论的正式场合在哪没给;软件安全专家的具体名单没拆;五条之外还有没有补充也没数,这些都在原对话的更长版本里。

这周把 Satya 那场对话的原话找全,对照自家模型的观测接口逐条核一遍。

显示更多 话题来源 @bgurley 22.6K阅读 ❤️170
Bill Gurley (@bgurley) on X These are the people that should lead any AI regulatory framework discussions. Software safety experts. X (formerly Twitter)
我不是小布丁 ·
一句话把人工智能安全的老账翻了个面,被转发上万的判断是。问题可能出在对齐这个词本身,这翻面我看完先记那个指向再掂点赞那半句。记的掂的点在下面一层层摆。摆好了看指向,向在下面摆着。 指向是这样摆的。安全话题平时都在谈防护,护栏要多厚、红队要多狠。失控了怎么喊停,而这句判断把矛头调了个方向。说对齐这个概念本身就是安全问题。概念的第二层是它为什么能站住,站住的理由是概念本身含糊,含糊在哪呢。 点赞是这样落的。写过人工智能批判专著的那位老对手直接转发表态百分之百同意。还提到自己书里写的就是这个意思。同意的第四层是它的分量。分量是这两位平时在具体路线上没少抬杠,能在这一句上合流说明分歧已经从怎么干挪到了怎么定义。 点评两句。第一句是把争论焦点从怎么防护挪到怎么定义这步今年值得所有做评测的团队先做,先定义再谈分数。第二句是平时抬杠的人能合流这一幕今年会变成更多共识的开头,看到开头的回来点赞,句号。
显示更多 话题来源 @bgurley 41K阅读 ❤️261
Bill Gurley (@bgurley) on X It’s becoming clear that the notion of AI alignment “is” the safety problem in AI. X (formerly Twitter)
自由翻滚的风铃草 ·

六十五万美元的年薪,要的不是会写提示词的人。Stanford 把通往那里的整条路免费摆上了一个站点。

开头两句照录。Anthropic 出六十五万美元年薪,招的是能把系统 build 出来的人,不是只会 prompt 的人;而这门课免费,Stanford 把完整路径收在一个站里。路径六段,依次是分词、架构、系统、缩放、数据、对齐。

十讲的名目也摆开,01 概述与分词由 Percy Liang 讲 cs336.stanford.edu/lectures/?trac… 是 PyTorch 与资源核算,拆 FLOPs、内存、算术强度 cs336.stanford.edu/lectures/

trace=lecture_02;03 讲架构与超参数 github.com/stanford-cs336… 换 attention 的各种替代方案和专家混合 github.com/stanford-cs336… 进硬件,GPU、TPU、内核、Triton cs336.stanford.edu/lectures/

trace=lecture_13;06 讲并行,模型怎么被切到一批芯片上 cs336.stanford.edu/lectures/?trac… 是缩放定律 cs336.stanford.edu/lectures/

trace=lecture_07;08 收数据,来源、过滤、去重、合成 github.com/stanford-cs336… 后训练,SFT 与 RLHF github.com/stanford-cs336… 对齐与推理,讲到 RLVR github.com/stanford-cs336…

"能 build 不只会 prompt"这半句是场重心。前面聪明体现在哪讲的是把原则递给模型,这条讲的是把整条路径递给人。跟前面整洁之道新谈呼应,那条在守基本功的门,这条在开基本功的路。

两头都在提醒同一件事,提示词写得再好也只是入口,年薪级的位子认的是从分词到对齐的全链条。跟前面组里那堂分享也接得上,一个把经验讲给模型听,一个把经验摆成课程讲给人听,两头的教材都在成形。

十讲的排序我单独拎出来。它把课程从知识罗列改成了生产流水,前一讲的产物是后一讲的原料,跟着走等于把一次预训练亲手拆过一遍。

我留的疑问有三处。作业的评分方式没给;十讲之外的实战项目没拆;免费的时限也没说,这些都在站点上才查得到。

这周按这个目录建一张自己的进度表,一讲一格,先从 Percy Liang 那节开始。

显示更多 话题来源 @mentalium_ 3.5K阅读 ❤️76
Trace Viewer cs336.stanford.edu
我不是小布丁 ·

github.com/ciembor/agent-…

GPT-6 Astra 的聪明被拆成了两半,一半在推理,另一半得靠人递过去。

评价照录。它的长处在推理和逻辑思考,说白了就是特别适合做数学题;这本事落到编程上也明显,让它实现一个复杂功能,逻辑能理得很清楚,最后真做得出来,低级错误很少。但软件工程这层差点意思,例子摆了三条,相邻代码都抽了常量它偏要写死;该抽个方法的地方它把逻辑直接内嵌;明明不需要额外封装它又多套一层,架构设计上偶尔也犯类似的毛病。

代码能跑、逻辑没错,实现方式却未必合理,放到长期维护的项目里尤其显眼。作者的解法是两个 Skill 加一份说明:Code Complete 管编码规范,A Philosophy of Software Design 管抽象和架构,再通过 AGENTS.md 让它动笔之前先照着原则走。

"它没意识到该关注这些"这半句是场重心。前面整洁之道新谈讲的是老一辈守住基本盘,这条讲的是把基本盘写成说明书塞给模型。跟前面验收那步留着呼应,那条在人手里留关卡,这条在模型前立牌子。两头都在提醒同一件事,模型的工程短板未必是能力不够,可能只是没人提醒过它。跟前面组里那堂分享也接得上,一个把经验讲给人听,一个把经验讲给模型听,同一批原则换了个听众。

补认知比补推理更有用这个结论我单独拎出来,它把提升的路径从换模型挪到了改提示,成本差着量级,见效却常常更快。

我留的疑问有三处。两个 Skill 之外还有没有备选没给;AGENTS.md 的写法没拆;补了原则之后维护性到底改善多少也没数,这些都在仓库里。

这周照它的样子把两本书的要点抄进自己的配置,跑一周看实现方式有没有变规矩。

显示更多 话题来源 @ThirteenYizuka 10.7K阅读 ❤️92
小白爱摸鱼 ·

github.com/FluentRead/Flu…

Chrome 上的开源翻译插件更新了,流畅阅读这个位置又被人点名。

三句照录。网站翻译这一项,它是开源阵营里做得最好的;YouTube 上的字幕翻译用起来也很顺手;作者平时的用法是先用它把字幕拉下来,再交给 Agent 做总结。最后那句再次推荐也留着。

"拉字幕再交给 Agent"这半句是场重心。前面二十二个只是开胃菜讲的是往工具里装零件,这条讲的是把现成的两步接成一条流水。跟前面付钱前先看这十处呼应,那条在花钱前挑地方,这条在动手时挑工序。

两头都在提醒同一件事,看外文材料这条链正在从翻译工具滑向摘要工具。跟前面七连 No 那条也接得上,一个在问选哪个模型,一个在给模型喂处理好的素材,喂与选本是一套动作的两端。

开源插件能在这个位置站稳,我单独拎出来,翻译是浏览器里最老的需求之一,能被人反复推荐靠的不是新,是不出错。

我留的疑问有三处。这次更新具体加了什么没拆;YouTube 之外的视频站支持没给;和 Agent 衔接的输出格式也没说,这些都在仓库的更新日志里。

这周拿它把收藏夹里的外文视频拉一遍字幕,试三支交给代理总结。

显示更多 话题来源 @geekbb 14.8K阅读 ❤️114
GitHub - FluentRead/FluentRead: An open-source browser extension for bilingual translation. 一款开源的浏览器双语翻译插件。 An open-source browser extension for bilingual translation. 一款开源的浏览器双语翻译插件。 - FluentRead/FluentRead GitHub
我不是小布丁 ·
功能改完了,人还得攥着手机从头到尾再戳一轮。这活被 mobile-mcp 这个开源件整包接走,这接走我看完先记那份动作清单再掂读真实元素那半句。记的掂的点在下面一层层摆,摆好了看清单。 动作清单是这样列的。点按、拖屏、按住不放、打字、装卸应用、回桌面。录屏都能做。你把要走的流程说利索,它就在屏那头自己过一遍。支持的范围是两个主流系统、模拟器和连着数据线的真机都在内。 找按钮那半句藏着全帖最硬的技术活,它照着界面上的真元素去认键位。省掉了让视觉模型啃截图那道工序,又快又省。实在读不到才退回截图加坐标,取舍的第四层是它还带日志和崩溃报告的拉取。 点评两句。第一句是优先读真实元素这个取舍今年值得所有端上测试工具抄,抄了的成本表会好看一半。第二句是让智能体自己翻崩溃日志这半句今年会把测试岗的重复劳动砍掉一大截,砍掉的回来点赞,句号。 仓库在这,github.com/mobile-next/mo… ,连台真机跑一遍流程,跑顺的点赞,句号。
显示更多 话题来源 @GitHub_Daily 4.3K阅读 ❤️56
GitHub - mobile-next/mobile-mcp: Model Context Protocol Server for Mobile Automation and Scraping (iOS, Android, Emulato Model Context Protocol Server for Mobile Automation and Scraping (iOS, Android, Emulators, Simulators and Real Devices) - mobile-next/mobile-mcp GitHub
小白爱摸鱼 ·

DS BOT 面世后的第一波反应来了,措辞很冲,直接把国内一票 Agent 软件摆上了被告席。

三句照录。头一句是杀手级应用,DS BOT 一出来,国内那一票 Agent 软件怎么跟进还没人答得上来。次一句更狠,国内用户可以无脑推荐 DSH 了,Workbuddy、Trae 这些可以扫进垃圾堆。

给没法访问海外服务的用户只留一条建议,DeepSeek 桌面版加这个 Bot,齐活,啥功能都有了。引的那条正式介绍也一并摆开,开源插件、持久化的 Bot、自用密钥、接任意模型,仓库地址和安装口令都在评论区。

"无脑推荐"这半句是全场重心。前面开源版 DeepSeek Bot 讲的是这个零件怎么造出来的,这条讲的是造出来之后市场认不认。跟前面二十二个只是开胃菜呼应,那条在数货架上的品种,这条在数谁被挤下货架。

两头都在提醒同一件事,插件层的搭法已经快到让成品软件站不住的密度。跟前面石扬离开 TRAE 也接得上,一个骨干出去另起炉灶,一个零件冒出来顶掉一排,行业的墙角就是这么被撬开的。

垃圾堆那句话糙,我单独拎出来,它把判断的门槛降到了不需要对比表的程度,能让人说出这种话的,通常不是参数赢了,是用法赢了。

我留的疑问有三处。Workbuddy 与 Trae 具体输在哪没拆;DeepSeek 桌面版加 Bot 的完整工作流没给;无脑推荐的适用边界也没数。

这周按它那套组合装一遍,把自己的日常工作流搬上去跑三天再说。

显示更多 话题来源 @fankaishuoai 51.8K阅读 ❤️255
范凯说AI (@fankaishuoai) on X 这个绝对是杀手级应用,DS BOT 一出来,我不知道国内那一票 Agent 软件怎么跟进。 国内用户可以无脑推荐 DSH 了,什么 Workbuddy,Trae,可以扫进垃圾堆了。 我对无法访问到海外服务的用户,就一个建议,用 DeepSeek 桌面版,再加上这个 Bot,齐活了,啥功能都有了。 X (formerly Twitter)
自由翻滚的风铃草 ·

arxiv.org/abs/2610.09457

LeJEPA 把世界的潜在变量认出来了,缺的那一步解法现在也有了,还简单得出乎意料。

两段照录。LeJEPA 早就认出了世界的 latent,只差在一定程度的混合里分不开;如今出现了一个极简的后训练配方,能把那层歧义解开,把解纠缠的世界特征捞回来,末尾还带了句玩笑,What a time to be Gaussian。

引帖把问题问得更直白,不做重建也能可证明地恢复真实世界的单个潜在变量吗?答案给了个叫 DSReg 的东西,一种简单的正则化,事后贴到你已经预训练好的模型上就能用。

"事后贴上去"这半句是全场重心。前面那份数据对照实验讲的是把训练的旋钮一个个锁死来量,这条讲的是训练完再补一道小工序就能解开大问题。跟前面微软给出的决策呼应,那条在给模型加裁决的功能,这条在给表示做解剖。

两头都在提醒同一件事,模型的能力正在被拆成可以单独检查和单独修补的层。跟前面双开源那两张牌也接得上,一个把权重放开,一个把方法写进论文,研究的进展在往可复现的方向堆。

DSReg 能事后套用这个细节我单独拎出来,它意味着已经训好的模型不必推倒重来,方法论的价值就在于少烧一遍算力。

我留的疑问有三处。DSReg 正则的具体形式没在这条里给;恢复出的特征怎么验证没拆;对 JEPA 之外的架构适不适用也没数,论文全文才看得到。

这周把论文通读一遍,重点记它证明里"可证明"三个字的边界条件。

显示更多 话题来源 @randall_balestr 9.4K阅读 ❤️238
DSReg: Provably Recovering Individual World Latents without Reconstruction Methods that recover individual latent variables of the world, from nonlinear ICA to dictionary learning and causal representation learning, anchor the latents to observations through reconstruction, arXiv.org
我不是小布丁 ·
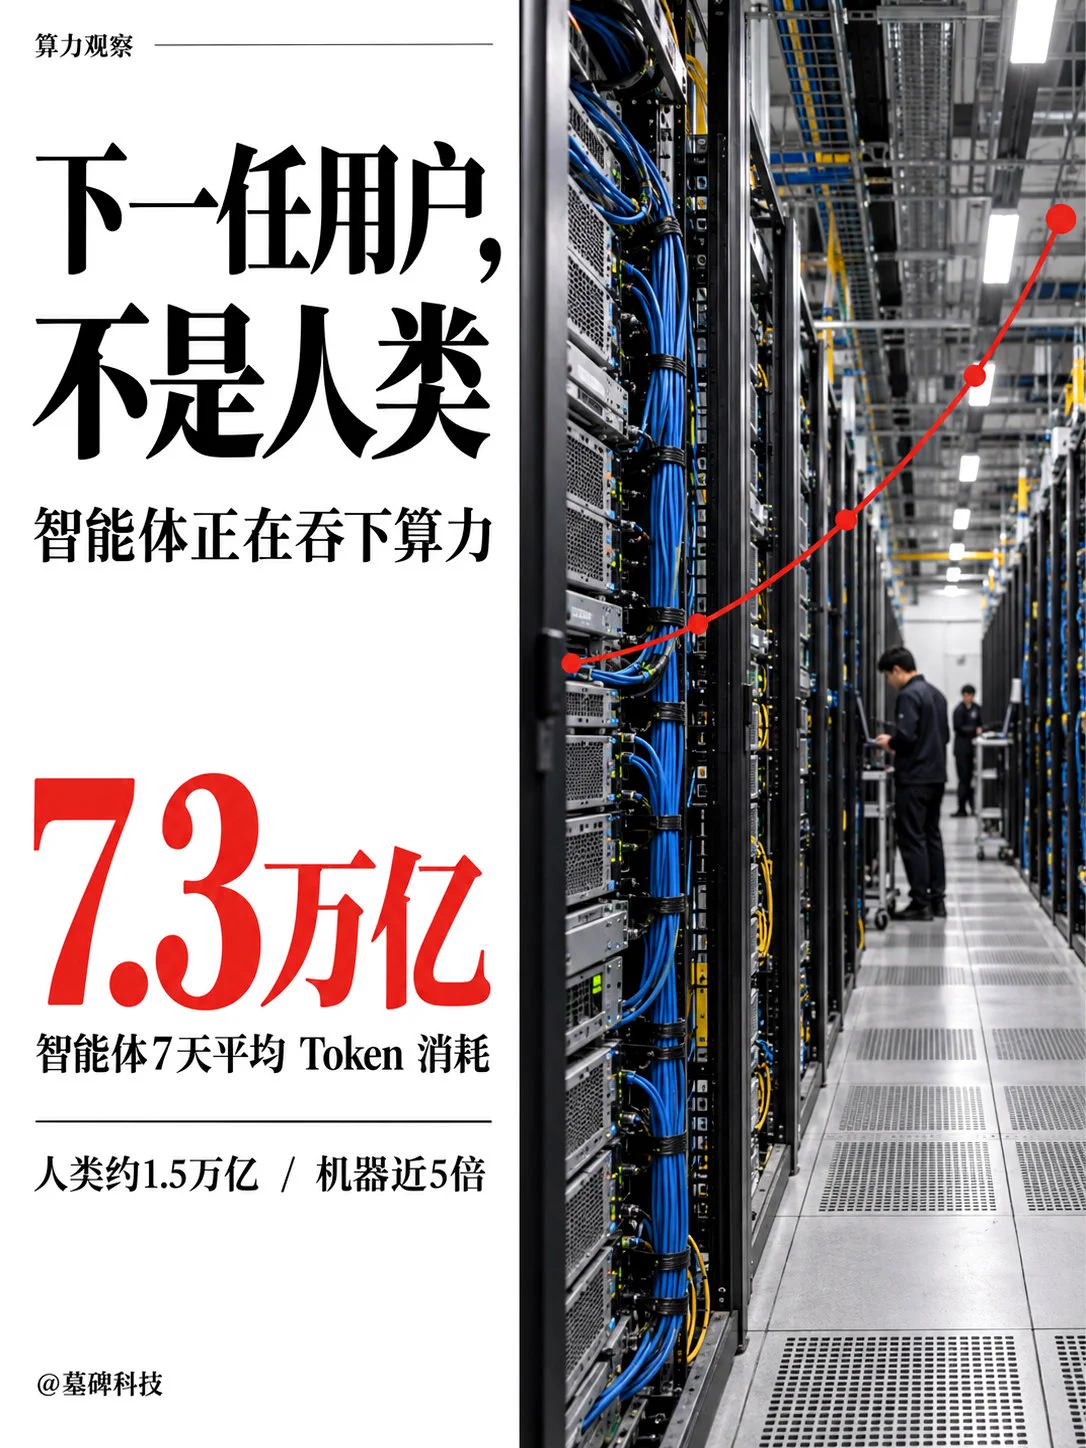
应用的日活看着见了顶,后方的算力中心却快被挤爆。这反差我看完先记那个分水岭日期再掂两组数字。记的掂的点在下面一层层摆,摆好了看分水岭,岭在下面摆着。摆好了自己爬。 分水岭是这样立的。OpenRouter 上二月六日这天,机器花掉的令牌第一次盖过了所有人加起来的量。跨过那条线之后,两条曲线从此各走各的道。分道的第二层是那两组数字。数字是半年里智能体的消耗暴增十四倍。八月的七天平均值冲到七点三万亿枚令牌。而同期人类还在一点五万亿上下徘徊。机器吃掉的已是人类的近五倍。 来路是这样摆的。人摆弄软件自带天花板,手速再快也是一行一行喂,屏幕前还得愣一会儿。人有饭点有觉点,专注力撑满一天也就那么几小时。机器这边压根没有上下班这一说。机器接着机器连轴转,自己查错自己补,外挂工具随叫随到。海量并发,不需要界面。不知疲倦。后台活儿一挂,几台机器互相嘀咕几句就烧掉几十万枚令牌。 顺手记一句给做产品的,指标的排位今年该挪一挪了。 点评两句。第一句是下一任用户已经不是人类这半句今年会改变产品指标的排法,排在最前的会从日活换成任务量。第二句是算力中心被挤爆只是开始这句话今年该让所有还在优化眼球生意的人心里一惊,惊完的回来点赞,句号。
显示更多 话题来源 @mubeitech 2.2K阅读 ❤️5
墓碑科技 (@mubeitech) on X AI应用的日活增长看着像是见顶了。 但后方的算力中心,却快被挤爆了。 算力都去哪儿了? 全被机器自己吃掉了。 做软件的可能还没反应过来:下一任用户已经不是人类了。 2026年2月6日,行业越过了一个分水岭。 在模型路由平台 OpenRouter 上,智能体消耗的 Token,正式反超了全人类。 一旦反超,两条曲线就彻底分道扬镳。 短短半年时间,智能体的消耗量暴增了整整14倍。 到了8月,智能 X (formerly Twitter)
我不是小布丁 ·
两款工具被并成一个入口,还带硬截止日期。这合并我看完先记两种模式再掂十月二十三那个日子。记的掂的点在下面一层层摆,摆好了看两种,种在下面摆着。摆好了自己切。 两种模式是这样切的。TraeWork 撞上 TraeCode,两扇门并成一扇,新的大名叫 TRAE。一个入口里放着两种形态。智能体模式让人工智能自动推进任务。代码编辑器那一侧照旧,改错调错一样不缺。两种的第二层是智能体模式的本事,本事是同时管多个项目。一口气差遣好几路智能体同时开工。远程那台机器也接得进来。 日期是这样压的。老客户端将在十月二十三日停止服务,届时没升级的用户无法继续使用。TraeWork 用户要手动启动升级、TraeCode 那边会自动更新,聊天记录、账号资料。本地数据。连登录态和付费点数也一并跟着搬。压的第四层是它的顺手细节,细节是定时任务。定时任务与模板库也顺路搬了家。电脑、网页、手机三头都能接上。 不满那半段是全帖最有意思的一角,升级后软件默认进智能体工作台。常用的集成开发环境模式要手动切。还暂时找不到改默认启动项的入口。这一角的第七层是我的点评。第一句是默认进新界面这个动作今年会让一排合并产品被同样吐槽,吐槽的都该给个默认项开关。
显示更多 话题来源 @0xLogicrw 9K阅读 ❤️6
思维怪怪 (@0xLogicrw) on X 字节跳动宣布将 AI 办公工具 TraeWork 和编程工具 TraeCode 正式合并,升级为全新的 TRAE。原本独立的两个客户端将统一到一个入口,同时提供 Agent 和 IDE 两种模式。前者负责让 AI 自动推进任务,后者保留完整的代码编辑和调试功能。 新版 Agent 模式支持同时管理多个项目,调度多个 AI 智能体并行工作,还能连接 SSH 远程开发环境。用户可以让 AI 从需求分 X (formerly Twitter)
小白爱摸鱼 ·

一段提示词把出海独立开发者武装成了关键词扫描器。流程写得像岗位说明书。

流程照录。每六小时跑一轮,数据来自 Google Trends 美国区,热搜榜加上一批 AI 种子词的 Rising 列表,像 ai tool、ai app、ai video 这几个。

入选线卡得死,要么是 Breakout,要么涨幅过一倍,而且必须是没见过的新词。候选词逐个搜清含义,含义不明的扔,巨头品牌词扔,涉黄赌毒的扔,没法用简单网站交付的也扔。再看它前十名自然结果的成色,论坛、社交、问答若占了七成往上,又找不出像样的独立产品站,判为真空期关键词。

到这一步才生成候选域名,按 SEO 的路子查可注册状态,精确匹配的点 com 优先。告警用中文发,关键词、含义、热度证据、搜索证据、推荐域名、上线建议,一条不少。红线写得很直,全程只读,不注册、不下单、不发帖,本地文件记已见词做去重。

"全程只读"这半句是全场重心。前面定时任务那类循环讲的是把动作挂上时钟,这条讲的是把判断也挂上去。跟前面真正用起来是两回事呼应,那条在劝人动手,这条在替动手省时间,两头都在提醒同一件事,代理的用法正从写代码挪到盯行情。跟前面付钱前先看这十处也接得上,一个在花钱前比价,一个在动手前找真空,两处都在把成本挪到决策之前。

七成这条线我单独拎出来,它把"没人做"量化成一个能执行的数字,模糊的商机就此变成机器能翻牌的条件。

我留的疑问有三处。种子词的完整清单没给;告警投递到哪没拆;真空词从发现到上线的转化也没数。

这周照它的流程让代理每天跑一轮,只看告警不动手,攒一周词单再对比市场。

显示更多 话题来源 @Mileson07 1.6K阅读 ❤️24
超级峰 (@Mileson07) on X 你是一个出海独立开发者的关键词机会扫描器,每 6 小时自动执行一轮:从 Google Trends 美国区抓取热搜榜和一批 AI 相关种子词(如 ai tool、ai app、ai video)的 Rising 列表,筛选出 Breakout 或涨幅超 100% 且从未见过的新词;对每个候选词先搜索理解其含义(淘汰含义不明、巨头品牌词、涉黄赌毒、无法用简单网站交付的词),再检查它 Google 前 X (formerly Twitter)
我不是小布丁 ·

两支智能体团队被摆在同一张图里对比,一支顶配进口一支全用国产快速档。这对照我看完先记两份名单再掂极限那半句。记的掂的点在下面一层层摆,摆好了看两份,份在下面摆着,摆好了自己选。
两份是这样列的。别人的队伍站着 Opus5.5、Astra,再配 Sonnet 或者 Sol,我的 AGENT 队伍站着 GLM5.3F、DS4.1F、Qwen3.8F 和 MIMO2.6F,两份的第二层是它们的差异。

差异是前者的单价和后者的零门槛,零门槛的第三层在下面摆着,摆好了别眨眼。眨眼就翻过去了。过去一页少一页,少一页都是损失,损失不起的往下看,看下段。
极限那句是这样收的。把 GLM5.3F 开到高思考档就是这个团队的极限了。极限的第四层是它给使用者的暗示,暗示是把免费档拉满之后剩下的差距靠组合和分工补。补的第五层是我的保留。保留是四件套的实际任务分工发布里没有给,阵容按截图记账。
点评两句。第一句是把顶配和免费档摆一图这个晒法今年值得所有自建团队抄,抄了的都会重新算一遍自己的账单。第二句是极限两个字点破了免费组合的天花板在哪,看破的回来点赞,句号。

显示更多 话题来源 @Yayoi_no_yume 15.3K阅读 ❤️148
◂Ⓘ▸YAYOI の 夢 (@Yayoi_no_yume) on X 别人的Agent团队: Opus5.5+Astra+Sonnet/Sol 我的AGENT团队: GLM5.3F+DS4.1F+Qwen3.8F+MIMO2.6F 把GLM5.3F开到High thinking就是这个团队的极限了。 X (formerly Twitter)
自由翻滚的风铃草 ·
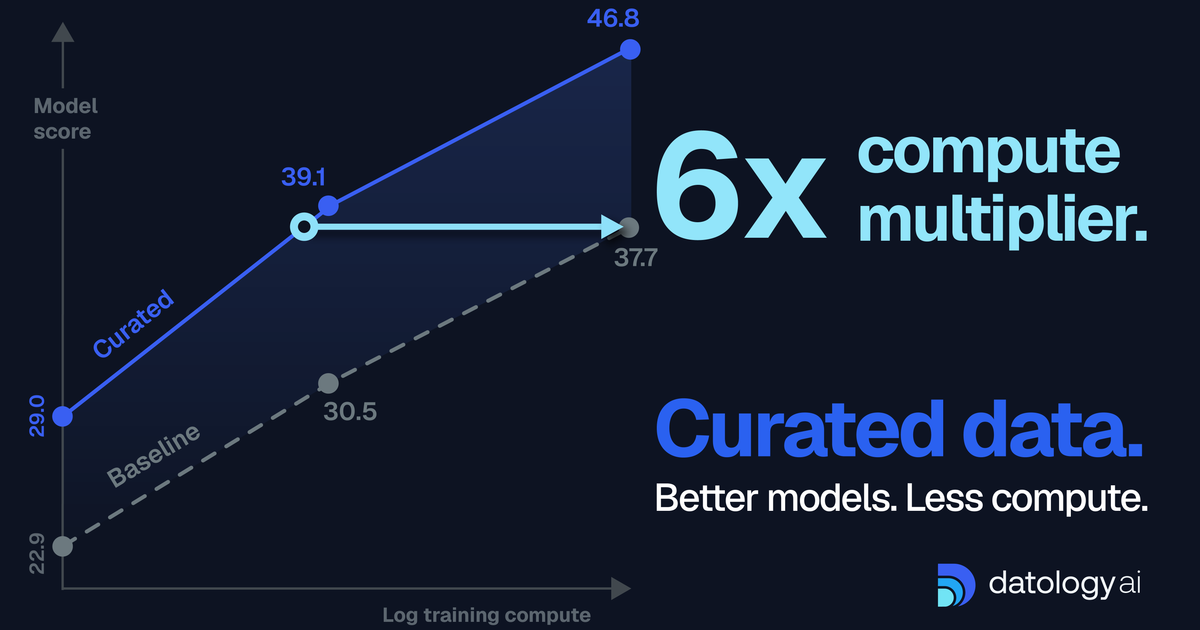
datologyai.com/blog/text-cura… 一个对照实验把话说死了,同样三十九个源数据集、同样的训练配方,唯一的变量是数据筛选。 实验设计照录。三十九个源数据集里点了名的有 Nemotron、FineWeb、The Stack v3;预训练和后训练的配方完全一致,为的是让这场比较尽可能苹果对苹果;整个实验里唯一被改动的东西,就是 data curation,也就是喂进去之前那道挑拣的工序。结果和搭建方式都放在文首那条链接里。 "唯一变量"这半句是全场重心。前面饭局上没夸自己家讲的是行业里的口头共识,这条讲的是把共识放进实验室里对照。跟前面过分拟合那类老话题呼应,那条在防训练的坏习惯,这条在量训练的好工序。两头都在提醒同一件事,模型的差距正从拼算力挪到拼数据的拣选。跟前面双开源那两张牌也接得上,一个把权重放出来,一个把挑数据的法子写成论文,开源的重心正在往上游移。 控制变量这一手我单独拎出来,行业里说法太多,肯把配方锁死只动一个旋钮的实验本来就少,方法论本身也是内容。 我留的疑问有三处。三十九个数据集的完整清单没在这条里给;筛选前后各训了多少个配置没拆;只做文本一条线的结论能不能外推也没数。 这周把这篇读完,按它给的挑法回看自己的微调数据,看有没有白喂的部分。
显示更多 话题来源 @datologyai 28K阅读 ❤️40
Datology Curation Studio Improves Even the Best Open Data Datology Curation Studio curated the best open LLM training data, matching baseline quality with 6x less compute and beating it at every scale. Datology AI
小白爱摸鱼 ·

github.com/HKUDS/CLI-Anyt…

AI 操作专业软件这件事换了条路走,CLI-Anything 是港大开源的项目,思路是给软件开一条命令行接口,让 AI 干活更稳。

三点照录。自然语言驱动,能连上 Blender 这类软件,让编程代理直接执行操作;CLI-Hub 快速安装,一条命令把社区里现成的工具装齐,省掉重复开发;兼容多种代理,Claude Code、Cursor、Pi、OpenClaw 的工作流都能接。

场景那句也留着,从 3D 场景到游戏 Demo,这种方式能减少手动操作,自动化复用也更方便。社区还在持续扩充命令行工具的品类,想让 AI 真正操作复杂软件,可以盯着这个项目。

"给软件开命令行接口"这半句是全场重心。前面把指挥官拔了讲的是任务怎么派,这条讲的是派下去之后 AI 够不够得着手里的工具。跟前面换角这件事定了呼应,那条在素材上动手,这条在软件上动手,两头都在提醒同一件事,代理的边界正从对话框往应用深处推进。跟前面二十二个只是开胃菜也接得上,一个在装插件,一个在开接口,货架和门同时在变多。

CLI-Hub 那个一步安装我单独拎出来,重复开发是社区项目最耗人的地方,把现成工具收进一个可寻址的货架,比再造一遍轮子更省。

我留的疑问有三处。命令行接口的稳定性边界没给;Blender 之外的专业软件覆盖清单没拆;安全沙箱怎么设也没数。

这周拿它连一次 Blender,跑个从建模到导出的完整小流程。

显示更多 话题来源 @bkdgiffug 2.5K阅读 ❤️42
GitHub - HKUDS/CLI-Anything: "CLI-Anything: Making ALL Software Agent-Native" -- CLI-Hub: https://clianything.cc/ "CLI-Anything: Making ALL Software Agent-Native" -- CLI-Hub: https://clianything.cc/ - HKUDS/CLI-Anything GitHub
查看完整榜单
查看完整榜单
查看完整榜单