AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
我不是小布丁 ·
又一件造环境的家伙什放出来了,名叫 Karotte,公告背后压着一百万次跑数。 摊开看。它是拿来搭强化学习环境的框架。过去一年一直在给前沿实验室搭 MLE 的强化学习环境。上线前经了两道关,超过一百万次的评估运行,加上红队的轮番锤炼,两条都写进了公告那两行里。 "先有一百万,再有开源"这半句是全场重心。前面给奖励加一层讲的是把分数算得更准,这条讲的是把练功房整个交出来。跟前面十轮实验别建立在假结果上呼应,那边管结果别作弊,这边管场地先过关,两头都在给训练这件事打地基。跟前面两天换掉工作台也接得上,一个是搭干活的底座,一个是搭练兵的底座,先后顺序却一样,先跑熟再示人。 一年自用、百万次锤炼这个次序我留意,把内部吃过的苦转成公开的框架,这一手比直接丢个仓库要稳当得多。 我留的疑问有三处。框架怎么搭一个新环境没给示例;红队测的哪几类没拆;对外的许可条款也没数。 这周照它搭一个最小环境,看从零到能跑评估要几步。
显示更多 话题来源 @chem_safety 51.1K阅读 ❤️564
Jennifer Zhou (@chem_safety) on X Today we are open-sourcing 🥕Karotte, our framework for building RL environments. We've used it for the past year to build MLE RL environments for frontier labs, and it's been hardened through 1M+ eva X (formerly Twitter)
自由翻滚的风铃草 ·
opendocrouter.ai 文档解析这行当换了思路,LlamaIndex 把 OpenDocRouter 推了出来,一个接口底下搁十个模型。 背景那两句摆开。Hugging Face 上的 OCR 模型大约四千个,前沿实验室几乎每月出一个,今天最合适的下季度未必还合适,所以别再问该用哪个,要问换得快不快。五条承诺照录:换模型一行,同一个请求、同样的 markdown 输出、不用新提示词也不同集成;上线就带十个前沿与开源模型,Claude Opus 5.5、Gemini 3.8 Flash、GPT-6 Luna、MinerU2.5-Pro、PaddleOCR-VL-1.6 都在内;每个模型按 ParseBench 给质量和成本打分,拿证据选;输出可追溯,"layout: true" 会给不原生支持的模型也补上对齐框和同一套版面类别;按 token 计费,失败的页不收钱,二十五美元起充。 价差那句是全文最亮的地方,每千页零点八六到四十八点八二美元,差了五十多倍,全看文档到底需要什么。 "问换得快不快"这半句是全场重心。前面团队都在把 Opus 分给谁讲的是模型之间的分工,这条讲的是模型之间的换手。跟前面模型不动砍三倍开销呼应,那条在会话里省,这条在工具里省,两头都在同一件事上使劲,把锁定这件事拆掉。跟前面一个空间三种检索也接得上,一个管读,一个管换,读不动就换,是同一个动作的两头。 五十多倍这个价差我单拎出来记,同一个任务、同一种产出,选型选错就是这个量级的浪费,打分榜的价值全在这儿。 我留的疑问有三处。ParseBench 的题型怎么配没写;跨模型输出一致性的验收方式没给;失败页怎么算也没数。 这周拿自己那批最乱的扫描件在这十个模型上过一遍,看打分榜排的位置对不对。
显示更多 话题来源 @llama_index 38K阅读 ❤️206
OpenDocRouter PDF to markdown with the frontier model you choose, every page at once. opendocrouter.ai
我不是小布丁 ·
一张点名册拿了百万级阅读,美国七个名字中国五个。最后一行只留了一个问号。这落差我看完先数那两列再掂那个问号。数的掂的点在下面一层层摆,摆好了看第一列,列在下面摆着,摆好了自己数。 第一列七连排是 ChatGPT。Claude、Gemini、Grok、Llama、Muse、Dots,七个国家队的牌子一字排开,排开的第二列五连排是 DeepSeek。Qwen、Kimi、GLM、Hunyuan,五连排的第三层是那个问号,问号前面挂着一整块大陆的名字,一个能念出声的都没有。空着的第四层在下面摆着。摆好了别眨眼,眨眼就翻过去了,过去一页少一页。 格式的杀伤力在于它不需要论据,两列名单自己会说话。说话的第二层是被点名和没被点名的差,被点名的产品哪怕只占一格也进了这场牌桌。没被点名的连评论区都替你想不起名字,想不起的第三层是这张册子今年之所以成立。 点评两句。第一句是百万阅读买的不是名单是那句没写出来的悬念,悬念在评论区自己补成了万赞现场。第二句是下一个被这张册子点名的位置空着,空位迟早有人坐,坐上去的回来点赞,句号。
显示更多 话题来源 @ronisarkar_exe 122.2W阅读 ❤️4147
Roni (@ronisarkar_exe) on X America has ChatGPT. America has Claude. America has Gemini. America has Grok. America has Llama. America has Muse. America has Dots. China has DeepSeek. China has Qwen. China has Kimi. China X (formerly Twitter)
我不是小布丁 ·
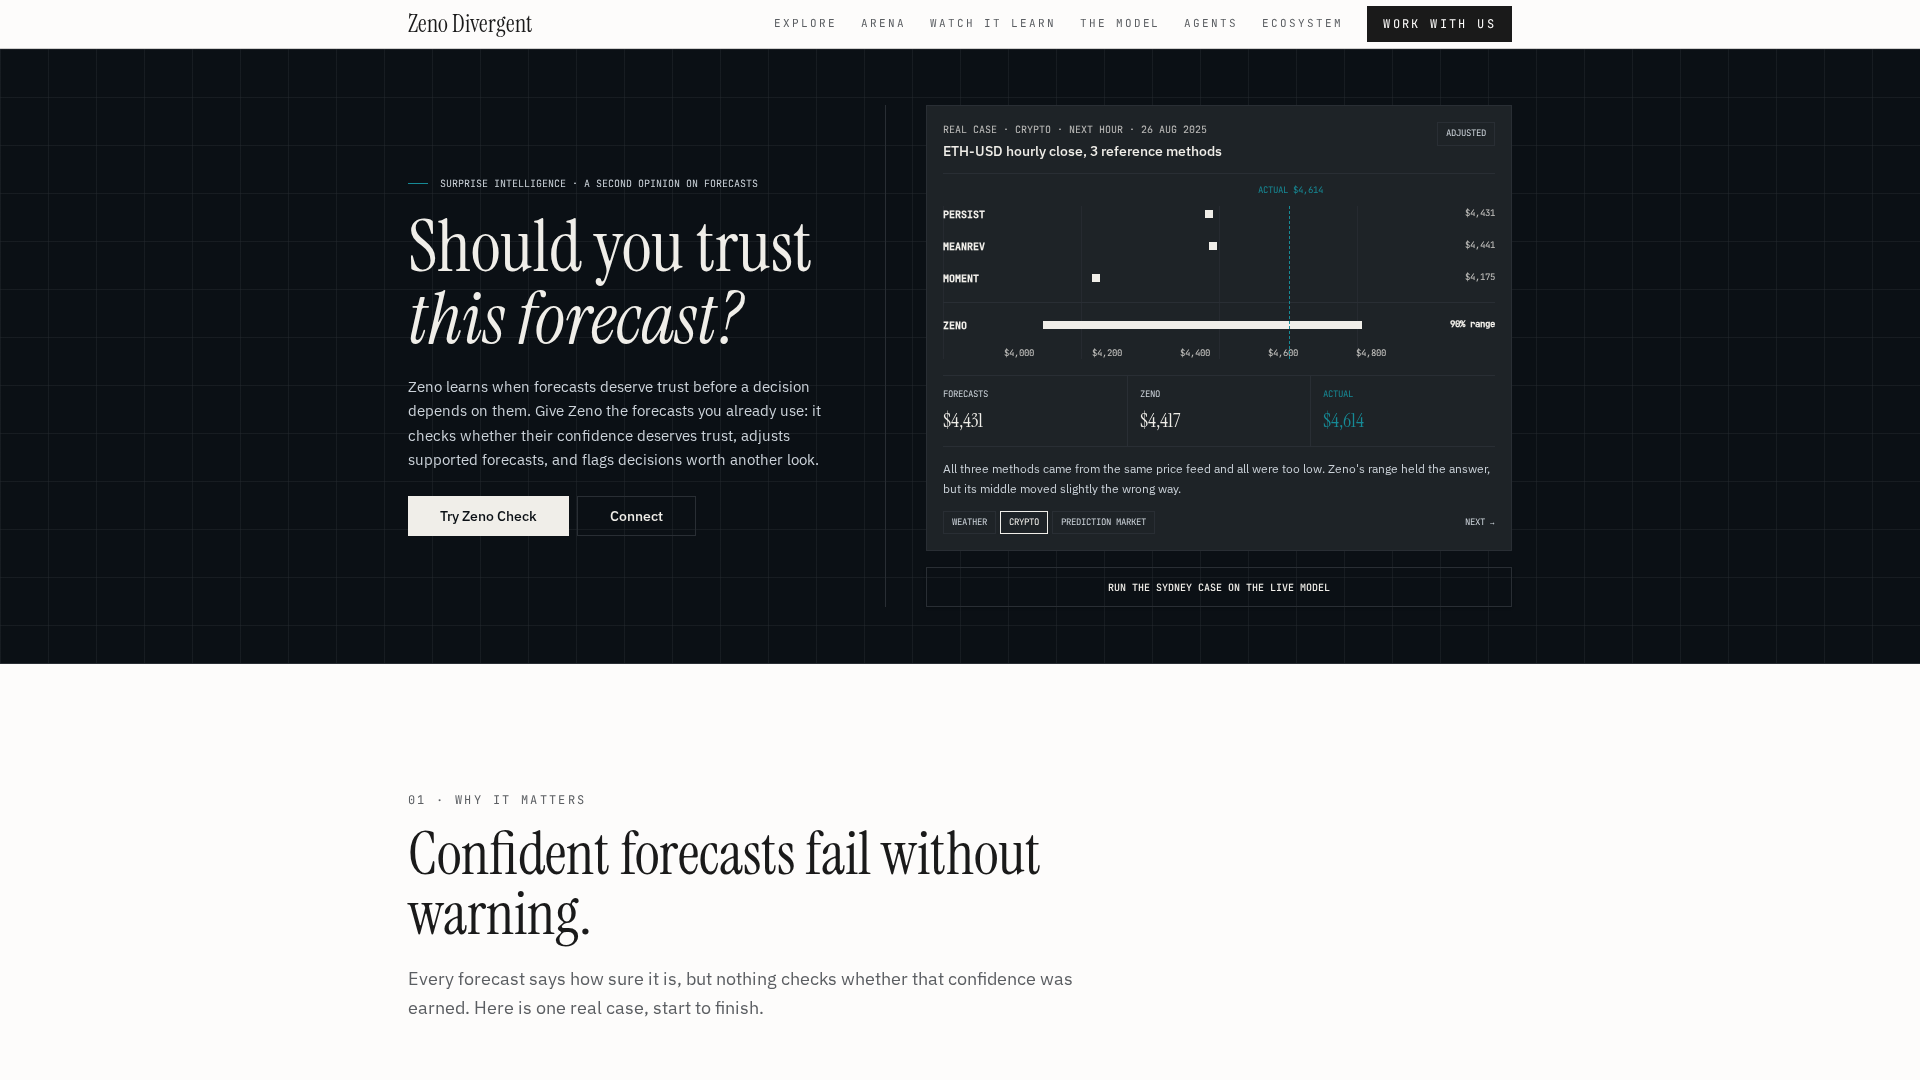
zeno-divergent-v057 这个预测模型把上手成本压到了秒级,三条路任选一条就能开跑。这三条我看完先记轻量那半句再掂管线那半句。记的掂的点在下面一层层摆,摆好了看第一条,条在下面摆着。 第一条路是去 Hugging Face 克隆权重。权重有 Safetensors 和 ONNX 两种格式可选,选后者的那半句最实在。标准 Python 就能推不需要背着 PyTorch 跑,不背框架的第二层是给谁省的。省的是数据工程师和运维。他们的环境里本来就不该有那套庞然大物。 第二条路是打开网页试真实面板,不装环境先看疗效这招对尝鲜的人最友好。第三条路留给干活的。用 API 和 MCP 直接从智能体管线里取预测集,三条路摆完是一个完整的漏斗。 点评两句。第一句是不背框架那半句今年在推理圈已经从卖点变门槛,背着框架出门的模型会被直接跳过。第二句是三条路的漏斗设计值得所有开源项目抄,抄了的回来点赞,句号。 试用在这。zenodivergent.dev ,秒跑的朋友回来点个赞,跑不动的也回来吐槽,句号。
显示更多 话题来源 @zenoVision_ 0.1K阅读 ❤️2
Should you trust this forecast? — Zeno Check Zeno checks forecasts from the models you already use, flags the ones likely to miss, and returns an adjusted forecast with its evidence. Zeno Divergent
自由翻滚的风铃草 ·
github.com/pixlcore/xyops 服务器运维最烦人的其实不是任务多,是工具太多,cron、监控、告警、工单各占一套,出事还得来回切窗口。 xyOps 干的就是把这几摊并到一起。任务、触发条件和监控流程用可视化的方式编排起来;调度那块比传统 cron 更灵活;实时监控配精细告警,把无效通知压下去;告警一响,自动把进程、负载、网络这些故障快照记下来;工单也能联动,方便接着往下查。自托管,数据在自己手里,许可证是 BSD,仓库地址也在推里。 "把来回切窗口这一步省掉"这半句是全场重心。前面三百多个代理被画进一张图讲的是把选型摊开,这条讲的是把切换消灭。跟前面给代理配个引路的呼应,那条递的是参照物,这条递的是一张桌子,两头都在给日常运维减负。跟前面插件有了自己的门也接得上,一个往对话里安工具,一个把工具安到一块屏上。 故障快照这一手我单独拎出来,告警时刻现场先留一份,比事后翻日志靠谱,这类细节是真被用过的人才会想到的。 我留的疑问有三处。支持哪些操作系统没写;告警的误报率没给;与既有监控体系怎么共存也没数。 这周把手上几台机器的告警和工单按它接一遍,看一天能少切几次窗口。
显示更多 话题来源 @bkdgiffug 0.2K阅读 ❤️2
GitHub - pixlcore/xyops: The next generation of Cronicle: open-source job scheduling, visual workflows, server monitorin The next generation of Cronicle: open-source job scheduling, visual workflows, server monitoring, alerting, and incident response. - pixlcore/xyops GitHub
我不是小布丁 ·
Step 5 Preview 的口号把今年的工具热泼了半盆冷水,不需要新工具只需要新模型。这泼法我看完先记那三组数字再掂十月十五。记的掂的点在下面一层层摆。摆好了看那三组,组在下面摆着。 三组数字是这样的。StepFun_ai 的 Step 5 Preview 已经摆上 OpenRouter,Kilo Code、Cline、Hermes Agent、OpenCode 四处都能调用。工作流一个不动只换模型这半句是卖点的主心骨。主心骨的第二组是上下文一百万,第三组是单任务成本约为 Claude Opus 5 的八分之一。 日期指的是开放权重十月十五。先托管后开权重是今年的固定顺序。顺序的好处是先靠接口收用户再把本地派发出去。本地派发意味着企业私有部署这扇门也开着,开着的第四层是那句口号的含义。 点评两句。第一句是保住工作流只换模型这招给所有被工具折腾过的人递了台阶,台阶下得越顺换模型的阻力越小。第二句是十月十五那个日期配上八分之一的比价是今年最直白的一次叫板,被叫板的回来点赞。 预览在这。openrouter.ai/stepfun/step-5… ,调用试试性价比,试出感觉的点赞,句号。
显示更多 话题来源 @Its_Nova1012 0.8K阅读 ❤️27
Step 5 Preview - API Pricing & Benchmarks Step 5 Preview is StepFun's flagship model for agentic work, built on a sparse Mixture-of-Experts architecture (27B active / 600B total parameters). $1 per million input tokens, $2.70 per million outp openrouter.ai
我不是小布丁 ·
platform.claude.com/docs/en/build-… Opus 5.5 在多数 Claude 团队里被用反了,这帖把更干净的分法连账单一起摆了出来。 分法摆开。便宜的探索交给 Sonnet 5.5 开路,Opus 5.5 只在循环攒出真凭据、确实需要更多推理时才进场。核心循环六步,Sonnet 起步,第六轮左右设一个检查点;过了就继续,不过就停掉这场;然后把任务、那条失败的检查、还有关键的几个文件交给 Opus,绝不整段誊写过去。 那条规则改账单的数字也给了一串,上下文两万时差一点八八倍,十五万时一点四九倍,四十万时一点二六倍;在三十万处才切换是一点五美元,干净地在两万处交接只要零点一美元。配套还有一段能直接粘进 Claude Code 的话,六条,第 6 轮设真检查、失败就开新会话、交接压在两万 token 以内、先看改动的差异再说动手。底下挂的出处是 Claude 平台关于提示缓存的说明页。 "不整段誊写"这半句是全场重心。前面大部分请求不给 Grok 自己做讲的是按活分级,这条讲的是按证据换人。跟前面模型不动砍三倍开销呼应,那条省在提示本身,这条省在交接这一下,两头都卡在同一个地方,多带的东西都是钱。 零点一和一点五这个差价我单拎出来记,同一件事,交得干净与交得拖沓,价差十几倍,这类账只有把动作拆到这一步才算得清。 我留的疑问有三处。第六轮这个检查点的通用性没验;三组倍数测的哪类任务没说;Opus 进场后的收益也没给数。 这周把自己那套流程照六条改一遍,记一周的账单再对着看。
显示更多 话题来源 @fleyta88 2.4K阅读 ❤️63
App unavailable in region Unfortunately, Claude isn't available here. Claude
小白爱摸鱼 ·

订阅里开始直接塞 API 额度了,这一步是 Anthropic 先走的,官方那句原话很直白。

额度表照录,月度 Claude Platform API credits 发给 Max 和 Team 两个计划,Max 5x 这档一百美元,Max 20x 这档两百美元,Team 档最高五百美元且是池子共享。

后面还跟了一句,任何模型都能用,包括 Haiku 5.5,写在你自己的代码里、或者第三方的 harness 里都行。领取的图和怎么算,社区里也整理成了两张。

"订阅的钱换个袋子花"这半句是全场重心。前面两百块值一万二讲的是把账摆平,这条讲的是把两个袋子合一个。跟前面大部分请求不给 Grok 自己做呼应,那条在模型之间挪活,这条在订阅和接口之间挪钱,两头都在拆墙。跟前面二十块两小时只吃一成八也接得上,一个算用量,一个直接发钱,付费这件事正在从"用多少结多少"往"按月包干"滑。

一百美元这个数我单拎出来记,配上 Haiku 5.5 那个价位,够跑的东西比过去多出一大截,小模型一便宜,额度就显得更耐花。

发的那张图末尾还带了一句调侃,这下轮到 OpenAI 难受了。

我留的疑问有三处。月度额度不用会不会清零没说;Team 池子怎么分账没写;与第三方 harness 的结算细则也没数。

这周把自己那档订阅的 API 额度领了,记一轮实际能跑多少请求。

显示更多 话题来源 @op7418 11.1K阅读 ❤️48
歸藏(guizang.ai) (@op7418) on X Anthropic 这个决定真是王炸 他们现在会给每个 Max 和 Team 用户直接送对应额度的 API 金额 我把对应额度和怎么领取做了两张图 这个 API 你在哪里用都行,只要这个产品支持输入 API 结合昨天晚上发布的 haiku 5.5 的价格,这 100 美金相当够用了 这下轮到 OpenAI 难受了 X (formerly Twitter)
我不是小布丁 ·

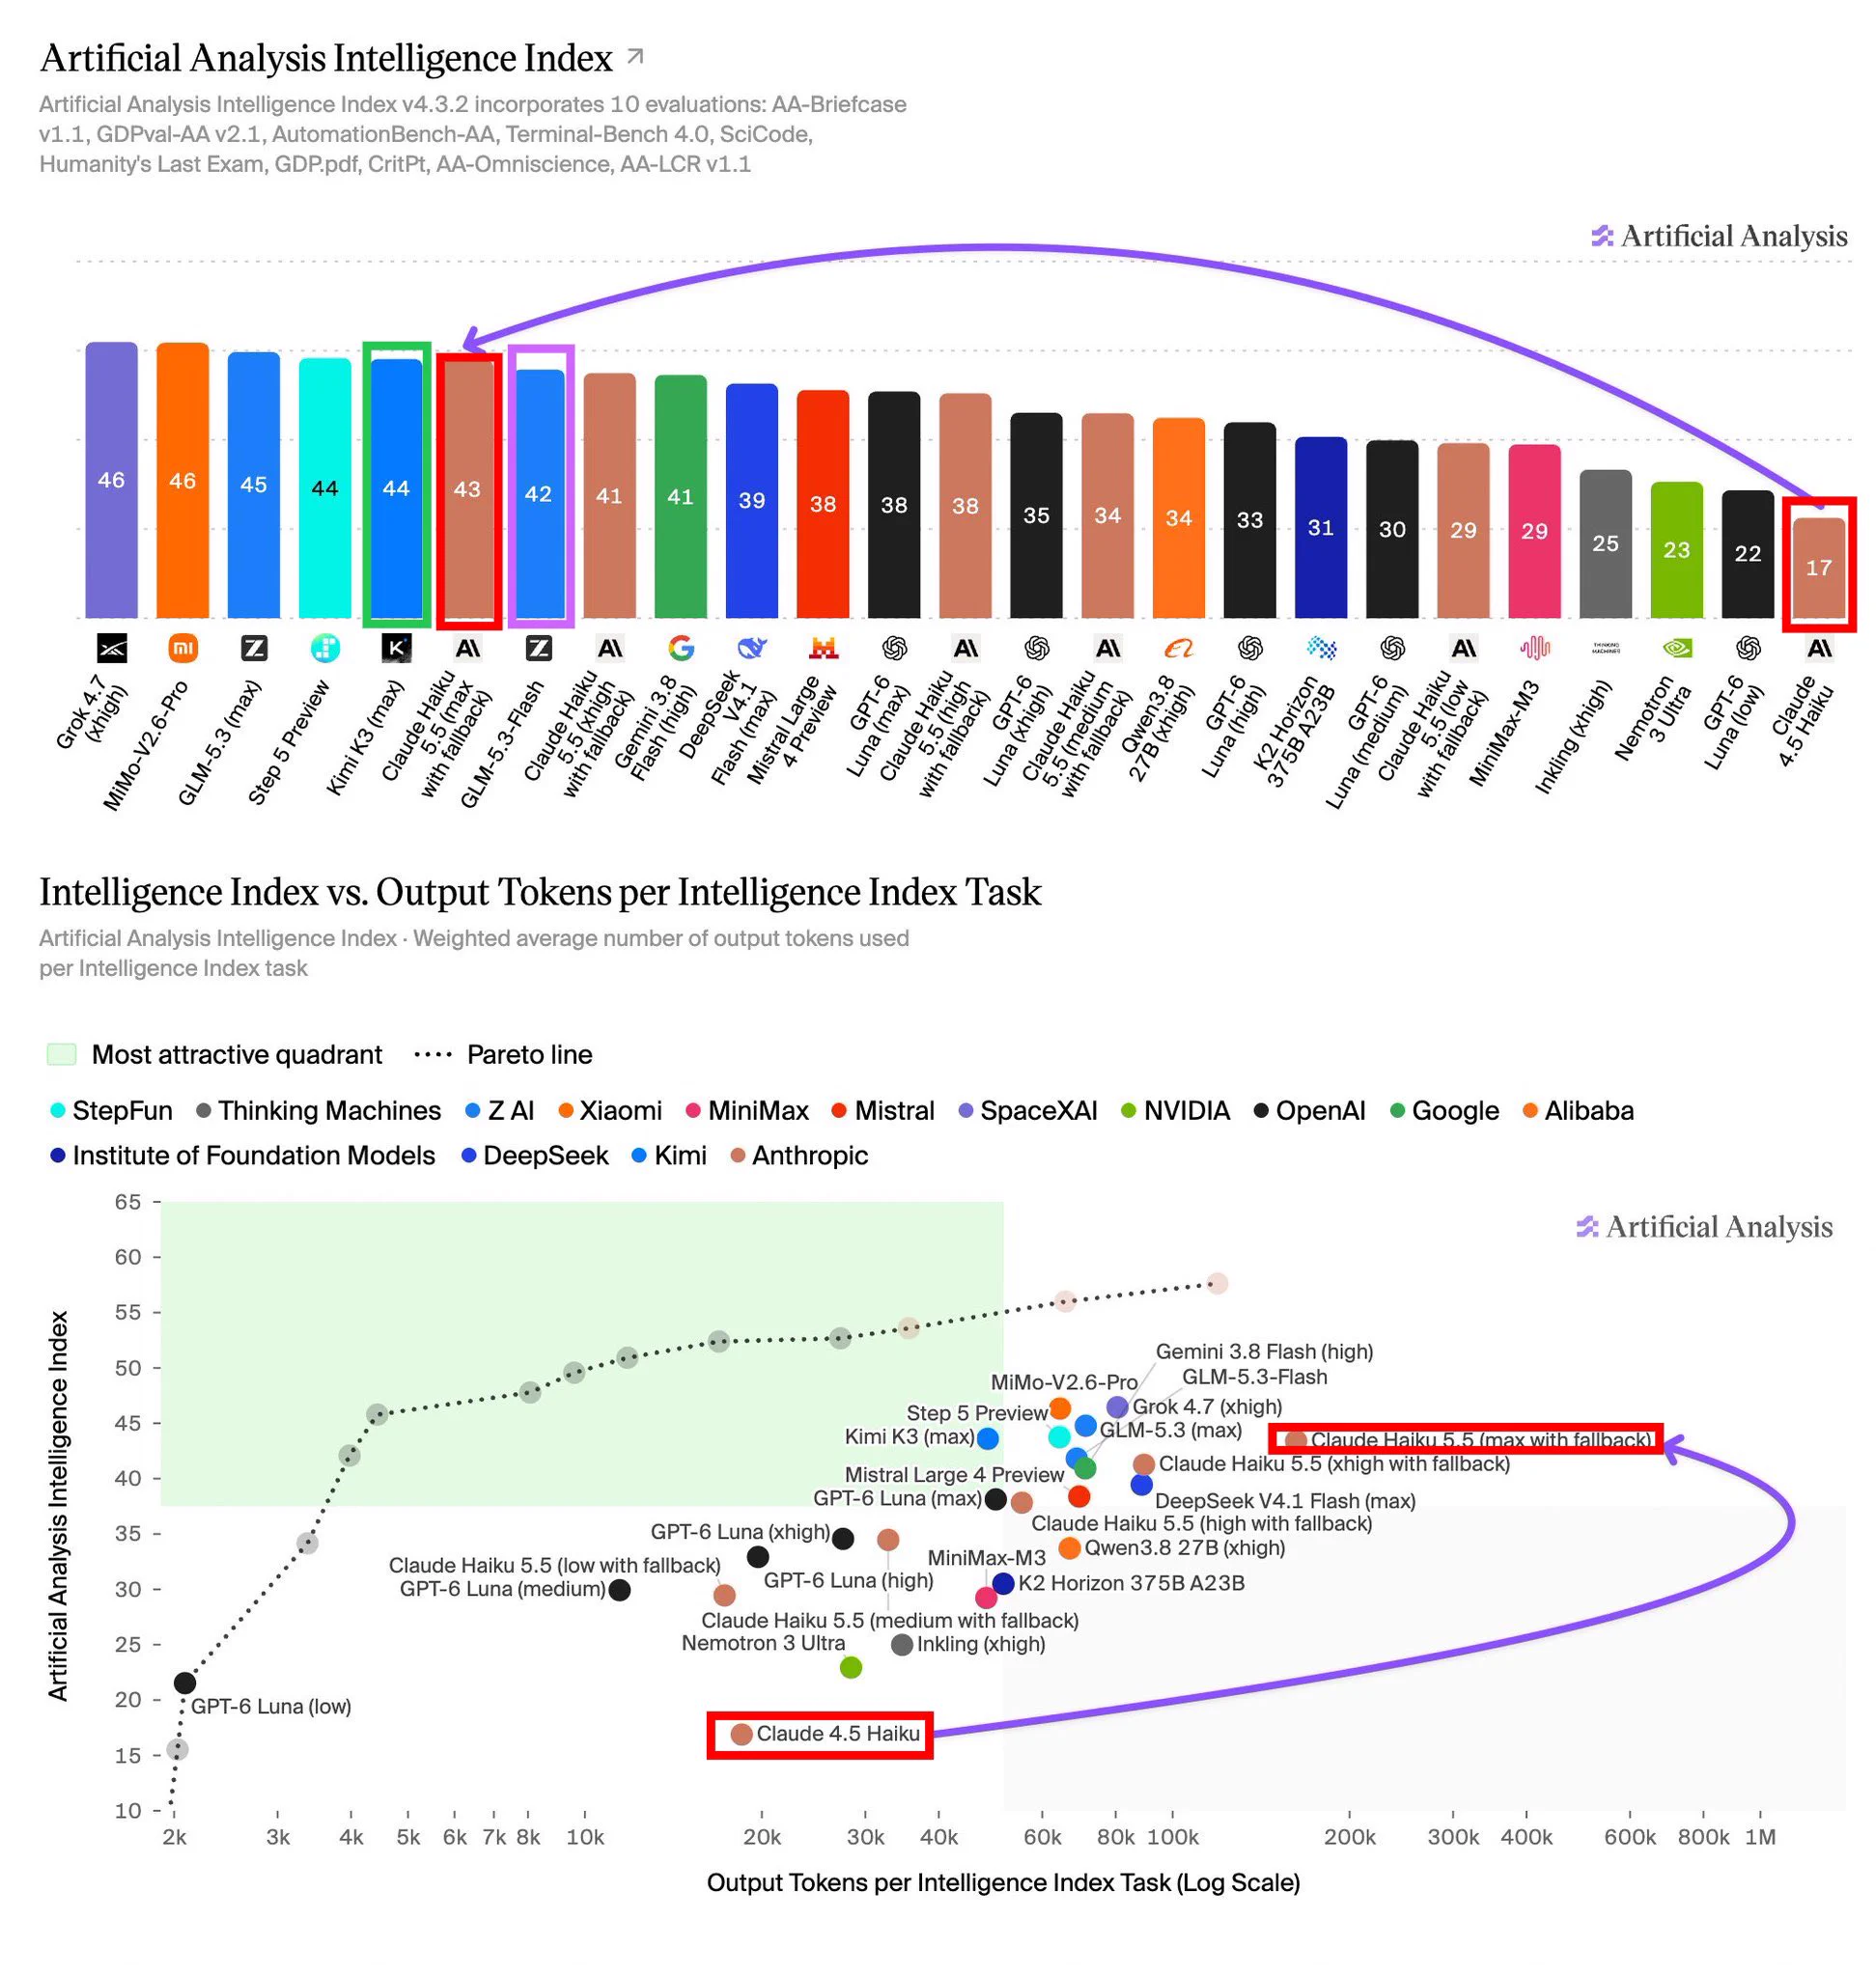
Claude Haiku 5.5 在基准榜上摸到了旗舰的门槛。四十三分把一串中国模型甩在身后。这分数我先记再掂那个代际差。摆好了看那四十三。三在下面摆着。
那张表在 ArtificialAnalysis 基准上。成绩四十三分,反超 GLM-5.3 Flash 的四十二,直逼 Kimi K3 的四十四只差一分。高于 DeepSeek V4.1 Flash 的三十九。

高于 Qwen3.6 27B 的三十四。高于 MiniMax-M3 的二十九。仍低于 GLM-5.3 的四十五和 MiMo-V2.6-Pro 的四十六。六个对照摆完这张表就有了画面。

画面是小个子挤进了大个子的那一桌。那一桌的第二层是代际的落差。上一代 Claude 4.5 Haiku 只有十七分。这一代直接涨二十六。涨二十六的第三层在下面摆着,摆好了别眨眼,眨眼就翻过去了,过去一页少一页。

少一页都是损失。损失不起的往下看。看下段。下段是那根没被堆长的思维轴。轴读完这篇就通了。通了就收工,收工的礼数在下段,下段是最后的门,推开它,推。
思维轴那半句说的是这张成绩不是靠把思考链无限拉长换来的。拉长思维链是最省事的涨分办法。代价是延迟和费用一起涨。用可控的输出摸到同一档意味着高并发场景真的能省钱又能打。能打的第四层是结论那句改判。

改判前的旧印象是便宜但弱。改判后是高并发低成本里能打旗舰的那一档。印象翻面的第五层是我的保留。保留是单一基准不等于综合实力。一分之差在误差带里可能就是平手。先按榜面记账。记账的第六层是我的收尾。

收尾在最后一段,最后一段到了就推门,门后是我的两句点评,读完这篇正式结束。结束语不留悬念,悬念是给没看完的人的,看完的人不需要,不需要的直接收,收在下段。
点评两句。第一句是二十六分的代际跳变说明这版的功夫下在了训练效率上而不是参数上,效率跳变比参数堆料值钱。第二句是中国小模型被自家对手追平这件事本身说明赛道已经挤到贴身,贴身的回来点赞,句号。

显示更多 话题来源 @NFT_Chen 23.3K阅读 ❤️73
SuSu_酥酥👅 (@NFT_Chen) on X 😱中国模型压力山大!Claude小模型Haiku 5.5 把 Kimi K3 追到只差 1 分!Dario 这波操作无敌了! AA基准上 Claude Haiku 5.5 (max with fallback) 打出 43。 对比主要中国模型:
🔹反超 GLM-5.3 Flash:43 vs 42
🔹直逼 Kimi K3 (max):43 vs 44,只差 1 分
🔹高于 DeepSeek V X (formerly Twitter)
我不是小布丁 ·
Claude 订阅里开始按月发接口额度了,三档数字摆得干干净净。这加码我看完先记那三行账再掂末尾那句喊话。记的掂的点在下面一层层摆,摆好了看那三行,行在下面摆着,摆好了自己对。 三行账是这样的。高档订阅每月送一百美元,顶档每月送两百。团队版最多送五百而且是共享,送的载体是接口额度,送的第二层是这步棋的位置。位置在订阅和接口之间架了一座桥,桥的两边本来是两套账本两群用户。 喊话只有三个词,轮到你了,喊的对象是对面的 OpenAI。喊话能进转发说明这步棋确实踩在了行业的痒点上,痒点是所有人都在问同一句话。付月费的和按量付费的到底是不是一群人,这一步给出的答案是把两群人合并成一群。 点评两句。第一句是把接口额度塞进订阅包等于承认纯聊天订阅的天花板到了,天花板上面要靠开发者续命。第二句是那句轮到你了是今年最短的催战书,收到战书的回来点赞,句号。
显示更多 话题来源 @kimmonismus 67.5K阅读 ❤️1208
Chubby♨️ (@kimmonismus) on X Anthropic keeps on giving: Anthropic is adding monthly API credits to Claude Max and Team subscriptions. - Max 5x: $100 - Max 20x: $200 - Team: up to $500 shared OpenAI: your turn. X (formerly Twitter)
自由翻滚的风铃草 ·

大部分请求其实轮不上"最好的模型",马斯克把这层交代清楚了。

原句两行摆开,"most @Bot requests are pretty simple and will be handled by a lightning-fast version of Grok 4.8 when that comes out.",简单的活儿,等 Grok 4.8 的极速版出来自己扛;原则那句也直,"give Grok Bot users the best possible combination of speed & intelligence",把速度和智能拼出最好的组合。

引帖那头给的分法更细,按任务挑,Claude Opus 5.5、Midjourney、Suno,谁合适谁上,"Best model wins"。

分层这半句是全场重心。前面插件有了自己的门讲的是给工具发座位,这条讲的是给活儿分级。跟前面模型不动砍三倍开销呼应,那条省的是重复,这条省的是杀鸡用牛刀,两头都在把力气花在刀刃上。跟前面聚合器被马斯克接了也接得上,同一件事的两面,一面是往外派,一面是往内省。

"极速版出来之前"这个时间点我留意,话是提前放出去的,等于把路线图当成了承诺,这类说法兑现的那天才是真账。

我留的疑问有三处。Grok 4.8 极速版的时间表没给;简单与复杂的分界怎么划没说;选错模型的责任也没提。

这周记录自己手头任务里简单活的占比,看给"极速版"留的位置有多大。

显示更多 话题来源 @elonmusk 654.6W阅读 ❤️1万
Elon Musk (@elonmusk) on X However, most @Bot requests are pretty simple and will be handled by a lightning-fast version of Grok 4.8 when that comes out. Operating principle is to give Grok Bot users the best possible combina X (formerly Twitter)
我不是小布丁 ·
便宜四分之三的小模型正式上岗了。官方给它的定位是给两位大哥打下手,这定位我看完先记那笔账再掂打下手三个字。记的掂的点在下面一层层摆,摆好了看那四分之三。 那笔账是这样算的。Haiku 5.5 的平均运行成本比上一代 Haiku 4.5 低约百分之七十五。四分之三这个降幅在定价表上属于断崖,断崖的第二层是它的上岗地点。地点是 Claude Platform 和 Claude Code 两处,两处都是干活的地方不是尝鲜的橱窗。 分工的原话是和 Opus 5.5 或 Sonnet 5.5 配对当子代理,配对两个字把主从关系摆明了。贵的那位掌舵便宜的那位跑腿,跑腿的活单上写着三样。摘要、上下文压缩。数据库查询,三样的共同点是量大又不太吃脑子。 点评两句。第一句是子代理这个角色今年终于配齐了人手,主将加力卒的编制比全员精锐省钱得多也稳得多。第二句是把三样脏活写进公告等于官方替用户划了重点,划到重点的回来点赞,句号。 演示在这。twitter.com/ClaudeDevs/sta… ,看完回来算算你的摘要任务能省几成,算得出的点赞,句号。
显示更多 话题来源 @ClaudeDevs 735K阅读 ❤️1万
ClaudeDevs (@ClaudeDevs) on X Haiku 5.5 is now available in the Claude Platform and Claude Code. On average, it costs around 75% less to run than Haiku 4.5. It pairs well with Opus 5.5 or Sonnet 5.5 as a subagent. Use it for high X (formerly Twitter)
小白爱摸鱼 ·
一句吐槽挂在时间线上:今年花得最不值的一笔 AI 支出,是 kimi 的年费会员。 三条不满照录。套餐的用量本来就少,认了;五小时那道限额,也认了;最让人窝火的是,个把小时缓存就失效,用着用着还得重新来。末尾连着三个感叹号,最后一句是,竟然才发现。 "发现比涨价更气人"这半句是全场重心。前面两百块值一万二那条讲的是别人替你把账摆平,这条讲的是自己掏了钱却没看懂条款。跟前面二十块两小时只吃一成八呼应,那条盘得明白,这条盘亏了,两头都在提醒同一件事,订阅这东西要月月对账。跟前面小模型先降七成五也接得上,一个把价降下来,一个把价藏在细则里,同样一张价签,读法差很远。 缓存失效这一条我单独拎出来。别的都能忍,唯独缓存过期会让长活从头再来,这类隐藏成本最伤实际体验,却很少写在套餐页的大字上。 我留的疑问有三处。缓存的过期时长官方怎么写没说;kimi 这档年费对应的额度也没在帖里列;同类订阅有没有同款毛病也没数。 这周把自己手里几张订阅的缓存时长和限额挨个记下来,看谁经得起长活。
显示更多 话题来源 @luojiuyue 14.9K阅读 ❤️132
luojiuyue (@luojiuyue) on X 今年花的最不值的一笔ai支出—— kimi的年费会员!!! 套餐用量少就算了,有5小时限额也算了 甚至个把小时缓存就失效…… 我竟然才发现!!! 气到了!!! X (formerly Twitter)
我不是小布丁 ·
Grok bot 悄悄从聊天工具升格成了值班员,能搜能读还能盯着指定的内容报警。这升级我看完先记能力表再掂那个报警例子。记的掂的点在下面一层层摆,摆好了看那个监控,控在下面摆着,摆好了自己开。 能力表三行是搜索。阅读、监控指定内容,前两行今年是标配,第三行才是这轮的分水岭。分水岭的意思是机器人从你问它答变成了它替你盯着。你问它答的交互每分钟都要有人在场,它替你盯着的交互把在场两个字从流程里划掉了。 免费加不走旧接口这两点摆在一起是个信号。信号是官方把这功能收进了自己的地盘,以前要靠 xapi 绕着实现的活现在成了原生能力。原生化的第四层是它对别的工具的压力。 点评两句。第一句是从答到盯的这半步是今年工具型机器人最值钱的进化,盯住的场景天然带着提醒、摘要和订阅三样生意。第二句是那个额度重置的例子建议所有做提醒类产品的抄下来当范本,抄了的回来点赞,句号。
显示更多 话题来源 @op7418 5.3K阅读 ❤️14
歸藏(guizang.ai) (@op7418) on X Grok bot 最近真猛啊! 现在可以搜索、阅读甚至监控指定的推特内容 比如你可以让他在 tibo 重置 Codex 额度的时候通知你 这些都是免费的,不通过以前的 xapi 实现 X (formerly Twitter)
自由翻滚的风铃草 ·

github.com/usestrix/strix
github.com/666ghj/MiroFis…
github.com/screenpipe/scr…
github.com/getzep/graphit…
github.com/trycua/cua

三百多个 AI 代理被人收进一个 GitHub 仓库,这帖挑的重点是,比那几个人人转的宝藏更值得看。

五枚照录。Strix 自主地给你的应用做安全体检;MiroFish 放一大群代理去模拟结果、改进预测;screenpipe 从你电脑上发生过的事里,给代理造出可检索的上下文;Graphiti 建的是连着的记忆,不是囤旧聊天;Cua 让代理在隔离的虚拟桌面里干活。

光这五个,加起来约二十二万五千颗星。分类也顺手给了,编码的、浏览器的、记忆的、研究的、多代理团队、沙箱,六个筐。

原句那句收尾我也留着,"before building anything from scratch, check whether someone already solved it"。

"先查有没有人解决过"这半句是全场重心。前面一百二十八个扫出九个讲的是替你挑能用的,这条讲的是替你避开重造。跟前面给代理配个引路的呼应,那条递的是参照物,这条递的是别人的成品,两头都在同一件事上省力。跟前面发仓库给它学也接得上,一个给模型看,一个给自己看,翻仓库这个动作正在变成日常。

五个筐这个分法我留意,清单本身没新意,把它们按"能解决哪类问题"摆开才是那句收尾的底气。

我留的疑问有三处。仓库的收录标准没给;300 这个总数怎么统计的没说;二十二万五千颗星的时间点也没标。

这周照这五个把自己的项目清单对一遍,看有几件其实早就有人做过了。

显示更多 话题来源 @RoundtableSpace 50.2K阅读 ❤️66
GitHub - usestrix/strix: Open-source AI penetration testing tool to find and fix your app’s vulnerabilities. Open-source AI penetration testing tool to find and fix your app’s vulnerabilities. - usestrix/strix GitHub
我不是小布丁 ·
一条七十四字的吐槽拿了八万多阅读,憋太久的那口气终于吐出来了。这吐槽我看完先记那两句判断再掂憋太久四个字。记的掂的点在下面一层层摆,摆好了看那两句,句在下面摆着,摆好了自己接。 两句判断是这样的。第一句是 GPT 6.1 Sol 和 GPT 6 Astra 的优势越来越弱,第二句是跟 Claude 的差距也越来越大。双重转向摆在一条吐槽里。转向的第二层是说话人的身份信号。身份是一个最近高频率使用者,高频使用者的体感比任何排行榜都来得早。 憋太久三个字泄露了一件事,说话人以前大概是前者的用户。从拥护到吐槽的距离要用好几个月的落差走完。走完以后敢公开说出来的那条是相对的差距而不是绝对的能力,绝对能力可能还在涨,涨不过对家在用户心里就是弱了。 点评两句。第一句是模型大战的民间比分今年开始走口碑渠道了,口碑比跑分更难追回来。第二句是憋太久才吐的槽通常是最真的槽,最真的回来点赞,句号。
显示更多 话题来源 @liangzhu_AI 84.8K阅读 ❤️138
良竹 (@liangzhu_AI) on X 卧槽,最近GPT用得多,越来越觉得不管是6.1 Sol还是6 Astra的优势越来越弱。 跟Claude 的差距也越来越大。 吐槽一下,憋太久了。 X (formerly Twitter)
我不是小布丁 ·
十四亿个词元被砸进了一个记忆框架,砸完直接免费开源。这手笔我看完先记那笔账再掂那句逆向工程,记的掂的点在下面一层层摆。摆好了看那十四亿,亿在下面摆着,摆好了自己称。 十四亿这个数用的是 Opus 5.5 的词元。换算成人话就是一家团队拿顶级模型烧出了大批量的记住与忘记,烧出来的经验被倒推成一套方法论。方法论的载体是 GitHub 上一个免费仓库,仓库名带着回望的意味。 逆向工程这四个字在开源圈有分量。分量在于它说明这套东西不是拍脑袋的设计是拆开别家的实现反推出来的规律。反推的规律比原创的设计多一层可信度,可信度的第四层是免费这个姿态。 点评两句。第一句是记忆这道坎今年从加分项变成了必答题,交卷的方式居然是把卷子先发出来。第二句是烧掉的词元数配上免费仓库,这个组合今年少见,少见的回来点赞,句号。 仓库在这 github.com/vectorize-io/h… 。自己去翻那套逆向出来的记忆方法,翻完回来点赞,句号。
显示更多 话题来源 @RoundtableSpace 43.5K阅读 ❤️73
GitHub - vectorize-io/hindsight: Hindsight: Agent Memory That Learns Hindsight: Agent Memory That Learns. Contribute to vectorize-io/hindsight development by creating an account on GitHub. GitHub
自由翻滚的风铃草 ·
github.com/yetone/magpie 又一套代理基建被点名推荐,名字叫 magpie,作者是 yetone。 用法摆开。想开发 AI 工具、又想把各种模型配置和 OAuth 登录都接住,路子很省,把现成仓库发给 Agent,让它照着学、照着改。平台图标那一侧借了 lobehub 整理的那套,添加服务商的入口做得直观,不用自己一个个配。 "发仓库给它学"这半句是全场重心。前面像对同事那样说话讲的是怎么开口,这条讲的是连参照物都直接递过去。跟前面六个仓库各接一段呼应,那条是别人接进生态,这条是拿别人的成果当范本,两头都在把"从零搭"这三个字省掉。跟前面插件有了自己的门也接得上,一个往里安家,一个教你怎么安。 基建这种东西我留意,它不像模型那样天天上头条,可每次被点名推荐,都说明有人真在上面盖过房子。 我留的疑问有三处。magpie 支持的模型清单没在推里给;OAuth 覆盖哪些提供商没说;仓库的活跃度也没数。 这周把仓库地址翻出来按它试搭一个,看从发仓库到能跑起来要几步。
显示更多 话题来源 @vista8 19.6K阅读 ❤️159
GitHub - yetone/magpie: Every agent's model. One place. Codex on DeepSeek, Claude Code on Kimi, from the menu bar. Every agent's model. One place. Codex on DeepSeek, Claude Code on Kimi, from the menu bar. - yetone/magpie GitHub
自由翻滚的风铃草 ·
同一批实验换个机器跑出两样结果,数据加载器这个老疙瘩又被摆上了台面。 痛点摆开。Datology 一年跑成千上万次数据实验,两件事反复咬人:同一个任务,十六块 GPUs 和八块卡跑出来的评测不一样;流程每改一处,整个数据集得从头物化一遍。这两条都不是模型的锅,是喂数据那层在晃。 解法也点了名,Zephon,他们自研的实时数据加载器,一边读一边处理,且是确定性的,串起一条六十几秒的讲解视频跟着发。 "确定性"这半句是全场重心。前面近二十亿只为把数据铺开讲的是把量堆起来,这条讲的是把量喂稳。跟前面一百万次跑出来的环境呼应,那条管练兵场过关,这条管来料不晃,两头都在给上层的模型打不晃的地基。跟前面三周快五倍也接得上,一个在推理那层省时间,一个在数据那层省重算,省的位置不同,省的是同一口气。 十六卡八卡跑出不同结果这个细节我留意,复现不了的实验等于没做,这类底层的确定性,往往比多刷几个点更值钱。 我留的疑问有三处。确定性的实现代价没拆;物化省下的时间没给数;十六卡与八卡差异的根因也没在串里点破。 这周把自己那条流水线的输入换成这个思路,看改一处还要不要全量重建。
显示更多 话题来源 @MaxiBoether 24K阅读 ❤️133
Maximilian Böther (@MaxiBoether) on X At @datologyai we run thousands of data experiments. Two things keep biting us: - Same run on 16 vs 8 GPUs → different evals - Every pipeline change → re-materialize the dataset Introducing Zephon, X (formerly Twitter)
小白爱摸鱼 ·

biohub.org/news/virtual-b…

Google DeepMind 把手伸向了生物学的地基,落点不在模型,在数据。

宣布摆开。话说得很直,构建预测性生物学模型是这个时代最重要的科学挑战之一,而解它需要前所未有的大规模新实验生物数据。说这话的是 Google Cloud 首席科学家、DeepMind 副总裁 Pushmeet Kohli。他宣布 DeepMind 将与 Chan Zuckerberg 的虚拟生物学计划联手,造出改进预测性生物模型所需的多模态数据集。

底下那层逻辑也交代了。生命要在多个尺度上才看得懂,从 DNA 和单个蛋白质,到活细胞,再到整体健康;AlphaFold 和 Protein Data Bank 走过的路给了同一条教训,没有高质量的开放数据,重大的生物学难题根本解不开。

公告那张卡片把价码也亮了出来。跨国跨部门的协作承诺投入接近二十亿美元,Biohub、能源部、国立卫生研究院和伙伴一起生成开放、标准化的数据。这些数据拿来训练模型,目标是预测细胞如何响应干预。

文末一串名字排开,艾伦研究所、布罗德研究所、格拉德斯通、人类细胞图谱、蛋白质图谱、桑格尔研究所、Isomorphic Labs、Meta。

"先备数据、再谈模型"这半句是全场重心。前面一百二十亿超了原定目标讲的是把钱备进产能,这条讲的是把钱铺进语料。跟前面一个空间三种检索呼应,那条管怎么找,这条管找什么,两头都在给下一批模型备原料。跟前面给奖励加一层也接得上,一个把准绳装进训练,一个把原料倒进训练,同一条链子的前后两端。

AlphaFold 那句教训我单拎出来记,当年赢在算法,如今要补的是数据,这说明到了某个阶段,瓶颈会从聪明挪到勤奋。

我留的疑问有三处。二十亿的分配比例没给;数据集的发布节奏没排期;参与的机构各自出什么也没数。

这周把公告那篇 biohub.org/news/virtual-b… 和他那篇尺度文章 linkedin.com/pulse/understa… 都读完,看自己这边最缺的是哪一层数据。

显示更多 话题来源 @pushmeet 18.6K阅读 ❤️318
Open data for predictive AI models of biology: $1.8 billion committed Biohub, DOE, NIH, and partners will generate open, standardized data to train AI models that predict how cells respond to interventions. Biohub
自由翻滚的风铃草 ·

一个开放研究选题被当众认领,卡住它的不是想法,是钱和算。

Nathan Lambert 的原话摆这儿。如果有人要做蒸馏对前沿进展影响的开放研究,"we happily would at @trillium_labs",乐意做。但得先把资金和算力撑起来才能开工,后面还跟了一句,"you know where to find me",随时可以找他把这事提前。

他自己的身份也在推尾挂着,开放模型研究者、Trillium Labs 的创始人兼主管,之前在 Ai2 共同负责 Olmo,还写后训练那本书和 interconnects 通讯。

蒸馏这件事本身的背景不复杂,小模型向大模型的输出学,学出来的东西够不够、损了多少,正是这篇选题要回答的。

"先认领、后要粮"这半句是全场重心。前面近二十亿只为把数据铺开讲的是大机构把粮草备进语料,这条讲的是小团队把粮草卡在门口。跟前面一百二十亿超了原定目标呼应,一个在融资端排队,一个在研究端等拨,两头都在同一件事上使劲,把想法换成算力。跟前面三周快五倍也接得上,一个省着花算力,一个连花的都还没有。

选题挂出、缺口明说这个姿态我留意,把"缺什么"直接写进认领里,比先应下来再悄悄搁浅要诚实得多。

我留的疑问有三处。这项研究的题目清单没给;需要的算力规模没数;资金从哪来也没提。

这周把自己的算力账摊开看一遍,顺手替这项研究估一估最小可行的那档要多少。

显示更多 话题来源 @natolambert 4.8K阅读 ❤️77
Nathan Lambert (@natolambert) on X If you want people to do open research on the impact of distillation to frontier progress, we happily would at @trillium_labs, but just need to scale up funding/compute before getting that done. Hap X (formerly Twitter)
自由翻滚的风铃草 ·
perplexity.ai/hub/blog/multi… Perplexity 把检索这件事的底座换了换,一次放出 pplx-embed-v2-late 两个模型。 机制摆开。它们用的是晚交互那套嵌入,文本、图片、页面三样一起抓。两个模型共用一个嵌入空间,好处写得很直白,跨模型之间能互相查,不用在两个池子之间来回搬数据。官方给的定语是两条,双双达到前沿性能水平,并且已经在 Hugging Face 上公开可取。 "两个模型、一个空间"这半句是全场重心。前面把 Twitter 交给它盯讲的是内容进来之后怎么归置,这条讲的是进来之前先把地基并成一块。跟前面汇话那个库呼应,那条管读出来的结果,这条管读进去的坐标,两头都在把多模态这摊东西摆进同一个抽屉。跟前面一句话把伏笔捞出来也接得上,一个捞自己写的,一个捞全网的,动作一样,尺度不同。 共用嵌入空间这一手我留意,跨模型查询意味着换模型那天不必重灌语料,这类省下来的隐形成本,往往在换人的那一刻才被想起来。 我留的疑问有三处。晚交互的算力开销没给数;两个模型的分工没拆;HF 上的许可条款也没在推里。 这周拿自己库里最乱的那批图文按这篇的思路重嵌一遍,看换模型还用不用重建索引。
显示更多 话题来源 @perplexity_ai 60.7K阅读 ❤️416
小白爱摸鱼 ·

一笔订阅被换算成另一个量级:两百美元值一万二的 token。

哪家计划给得出,原句说 this is not close。

四句引言照录,一句比一句直白。"They're selling to willing buyers at the fair market price. This is capitalism.";"You can pay $200 for a Claude plan and get $12,000 of Opus 5.5 tokens at API pricing. So that's obviously a good deal.";也有人往回收了收,说两百块的计划在特定模型、特定负载下值多少钱得算,可 5.5 本身是个怪物,值六千甚至五千。

最后一句把话推到对面,这么一比,谁给的多已经不重要,是 ChatGPT 和 Anthropic 两家订阅之间的较量。配的视频四十来秒,两位本周做客对谈的人名字也在推尾。

"用 API 价签给订阅记功"这半句是全场重心。前面二十块两小时只吃一成八讲的是自己盘算用量,这条讲的是别人替你把两本价签并排放好。跟前面小模型先降七成五呼应,那条压的是单价,这条翻的是倍数,两头都在替算账这件事找新基准。跟前面一百二十亿超了原定目标也接得上,一个在融资端比钱,一个在订阅端比货,同一条价格线的两端。

六倍这个落差我单拎出来记,能把差价摆到明面上的,从来不是官方,而是拿着两边价签的第三方,谁替你算,比算了什么更关键。

我留的疑问有三处。一万二按哪档用量折的没说;两百块计划的细则差异没拆;这场对谈的完整结论也没在推里。

这周把自己那两档的月度用量按 API 价折一遍,看落在哪条线上。

显示更多 话题来源 @SemiAnalysis_ 10.2K阅读 ❤️34
SemiAnalysis (@SemiAnalysis_) on X A $200 AI subscription can be worth $12,000 in tokens. Which plan delivers it is not close. "They're selling to willing buyers at the fair market price. This is capitalism." "You can pay $200 for a C X (formerly Twitter)
小白爱摸鱼 ·
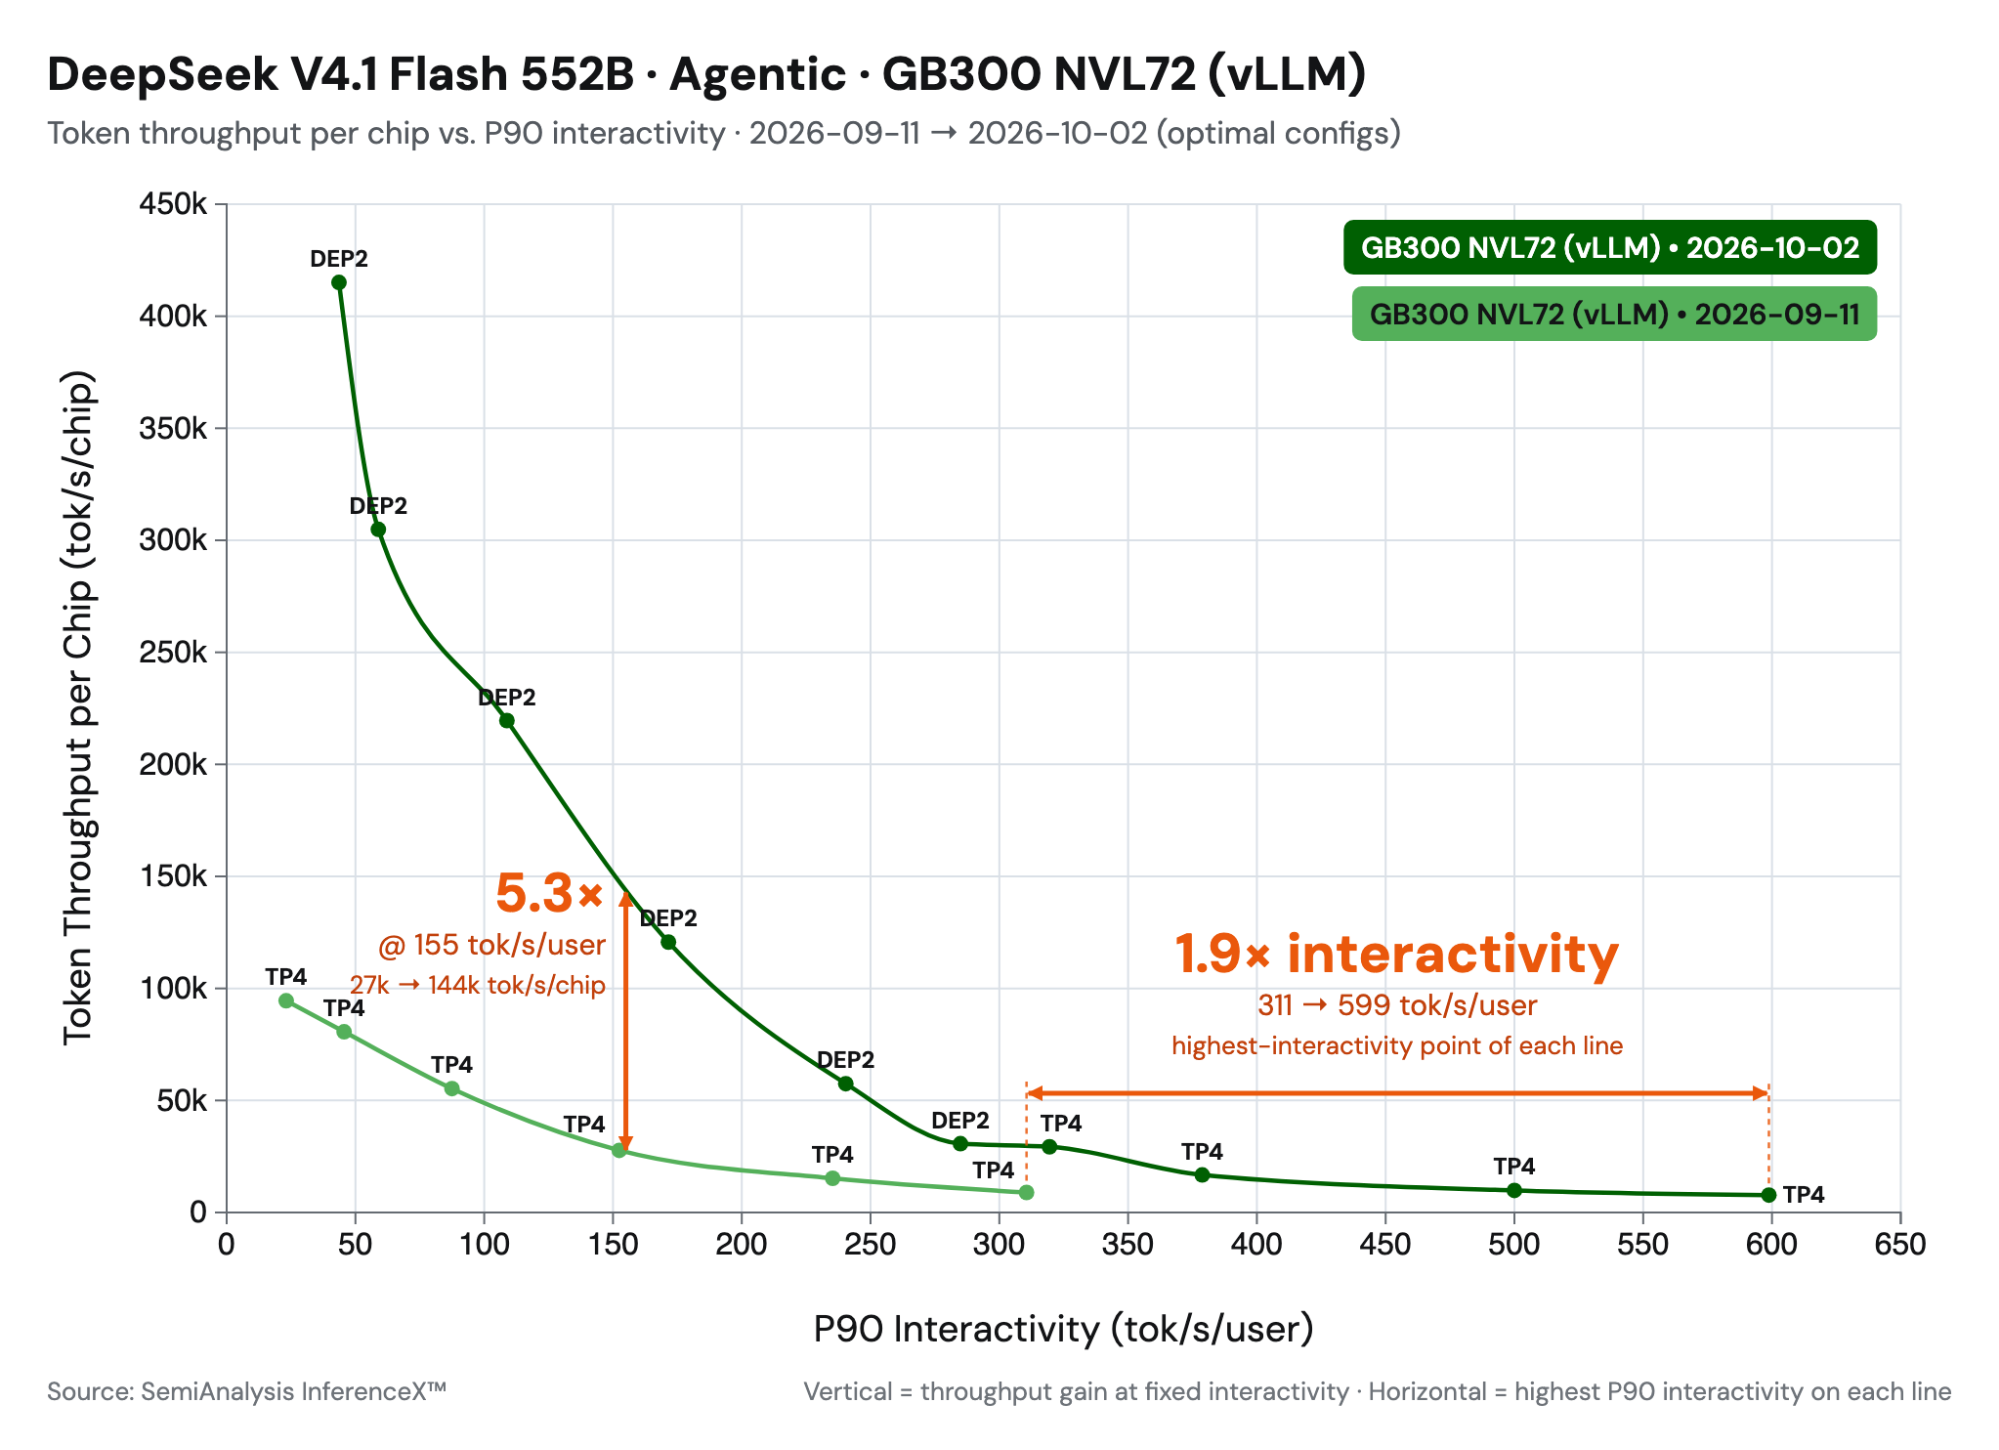
vllm.ai/blog/2026-10-0… 同一只模型换了跑道,三周之后快出一个量级,这份功课是 vLLM 自己交的。 数字摆开。DeepSeek-V4.1-Flash 摞在 vLLM 上,低并发时快一点九倍;到了每个用户一百五十 token 每秒这个压强下,吞吐量做到五点三倍,测的地方是 SemiAnalysis 的 AgentX,交互式图表就挂在博客里,一步一步能点着看。推的开头那句也照录,"Three weeks from day 0",从零起算三周整。 "模型不动、地基换一层"这半句是全场重心。前面三档全包那条讲的是把分数铺满,这条讲的是把同一个分数跑得更快。跟前面一百二十亿超了原定目标呼应,那边备钱进产能,这边在现有硬件上榨余量,两头都在跟算力这件事较劲。跟前面一天快一半那条也接得上,一个改模型的默认速度,一个改引擎的调度路数,提速这件事从来不只有一处可下手。 三周这个工期我单拎出来记。模型十月上旬才落地,下旬地基就翻新完,这种跟随速度意味着跑得快不快,越来越取决于你脚下踩的是哪套引擎。 我留的疑问有三处。一点九倍是在什么硬件上测的没说;五点三倍的压强点只给了一个;升级要不要改配置也没写。 这周把自己那套 DeepSeek 的服务照博客换一版 vLLM,看延迟能不能掉到原来的一半。
显示更多 话题来源 @vllm_project 5.8K阅读 ❤️38
DeepSeek-V4.1-Flash on vLLM: 5x Agentic Throughput Since Day 0 Within three weeks of release, vLLM made DeepSeek-V4.1-Flash 1.9x faster at low concurrency and lifted its throughput 5x on SemiAnalysis AgentX, with SWA bounde vllm.ai
自由翻滚的风铃草 ·
OpenRouter 把排名这件事搬到了决策模型上,新榜的名字就叫 Decision Model Rankings。 榜面摆开。它同时亮两个份额,花出去的钱占多少、吐出去的 token 占多少。还按决策模型和任务类型拆开看,相关性、正确性、指令遵循这几栏都在其中,一段二十来秒的视频跟着推一起发。当天的头名那句也照录,"@typesafeai is leading all categories today",所有分类领先。 "连花的钱都要上榜"这半句是全场重心。前面 d1 把权重放出来讲的是货能搬回家,这条讲的是货上了架之后谁在被买。跟前面给形状不给自由发挥呼应,那条管形状,这条管流水,两头都在给决策这层装上计量。跟前面五十九万亿断层第一也接得上,一个数大模型的调用量,一个数小模型的花钱额,两本账终于记的是同一门生意。 决策这层刚开源就开榜,我留意的是这个节奏,货、秤、价一天里凑齐,行业给新东西定规矩的速度比过去快得多。 我留的疑问有三处。份额的统计窗口没说;typesafeai 的分类拆解没给;相关性和正确性怎么算的也没数。 这周盯这张榜一周,看领先是位置还是运气,顺便把自己的调用也归进某一栏里。
显示更多 话题来源 @OpenRouter 59.5K阅读 ❤️313
OpenRouter (@OpenRouter) on X New: Decision Model Rankings! See the spend share and token share of different decision models and task types, including Relevance, Correctness, Instruction Following and more. @typesafeai is leadin X (formerly Twitter)
自由翻滚的风铃草 ·

liquid.ai/blog/d1-open
huggingface.co/LiquidAI/d1-3b
huggingface.co/LiquidAI/d1-om…
docs.liquid.ai/lfm/models/dec…

d1 把权重放了出来,决策模型这条线头一回能整个拖回家跑。

两枚照录。d1-3B 管高质量的文字与视觉决策,占地有讲究就试实验性的 d1-omni-600M,权重下载、微调、本地部署都行。机制上它们不生成文章,一次前向就交出结构化的答案,是或否、挑标签、按评分表打分。

底座各不相同,一个建在 LFM2.5-VL-3B 上,小的那只用 LFM2.5-Encoder-350M 再加视觉和音频编码器。成绩是自报的,Decision Index 0.2.1 上 d1-3B 拿 48.57,压过 Decider 35B-A3B 的 47.11。

延迟那栏,单问在 Jetson AGX Thor 上十六毫秒、Orin 二十六毫秒、Orin Nano 五十毫秒。

四条链接摆全,博客、两个模型页、文档,一处都别漏。

"不生成一个字、只交答案"这半句是全场重心。前面给形状不给自由发挥讲的是让主模型吐出能进流程的形状,这条讲的是连吐都不吐、单程直接出结果。跟前面把决定挪进系统呼应,那条改的是谁在定,这条改的是定得多快,两头都在往省的那一侧压。跟前面三天走下来那批大动作也接得上,一个把界面越做越厚,一个把输出越削越薄,两边同时往两头走。

我单拎出来的是那个十六毫秒。放在路测这个量级上,答案比眨眼还快两个数量级,这类数字一旦进了生产链路,人对响应的期待就得重写。

我留的疑问有三处。音频那边的基准成绩没给;许可写的是 LFM 1.0、具体条文没在推里;生产环境的真实表现也没第三方验。

这周拿一段本来要调大模型的分类活换它试试,看十六毫秒是不是能在真链路上站住。

显示更多 话题来源 @liquidai 4.5K阅读 ❤️68
Open d1: Edge decision models for text, vision, and audio | Blog d1-3B and d1-omni-600M, open-weight decision models from Liquid AI for text, vision, and audio that run in milliseconds from NVIDIA DGX to Jetson Liquid AI
小白爱摸鱼 ·

openai.com/index/teens-le…

OpenAI 把大学申请这件事搬进了聊天框,同一天还把一份针对它的评估争议摆在了台面上。

四件照录。官方那条讲,ChatGPT for Teens 交进度,顺带预览 College Planner,配新的学习工具,也给升学顾问和青少年发声那头加支持。被系统认出未满十八岁的账号自动进这个版本,保护默认开着。

College Planner 把申请要求、截止日期、任务和助学金步骤归拢到一处,先面向美国申请四年制大学的高中生。iOS 上还多了把多页笔记拍成 PDF、再做成卡片和小测的活。

使用数官方自己给。学习可视化一周近一百二十万青少年在用,Study Mode 十八万出头,人均每天在 ChatGPT 上不到十五分钟。能用上青少年版的比还没用上的,平均多发出约二百七十万条学习相关消息。规划器还只是预览,没给发布日期。

争议同日落地。Common Sense Media 的青少年 AI 安全研究所在四千多条提示的测试后,把青少年版评为对十八岁以下用户不可接受的风险。理由是,涉及自残与饮食障碍的长对话中家长警报没有出现,且测试者能绕过 Study Mode,要求在问题处理前停供未成年人。

OpenAI 反驳,测试没有准确反映保护机制的实际运作,还点出某些保护没有正确触发的技术错误。该研究所也披露,自己的资金来自包括 OpenAI 基金会在内的公益与产业方,编辑独立。

"功能与护栏同一天摆出来"这半句是全场重心。前面第三天那条讲的是量的冲刺,这条讲的是面的下沉。跟前面修路的多装监控的少呼应,那条是路先跑监控后补,这条功能和争议前后脚到场,两头都在把安全这题摆到明面上。

我单拎出来记的是那句结尾,官方说会继续评估这些工具和保护在实际里怎么工作、把学到的分享出来。承诺的姿势摆得挺正,接下来就看动作跟不跟得上。

我留的疑问有三处。警报失效的技术错误何时修没说;四年之外的院校何时覆盖没排期;顾问那边的评测结果也没数。

这周把自己的学习节奏跟它那套工具对一周,看十五分钟这条线对普通学生是宽是紧。

显示更多 话题来源 @OpenAI 124.2K阅读 ❤️1247
我不是小布丁 ·

二十八天走到第三天,Tibo 一口气交了三样,还顺手给所有付费账户存了次重置。

三样照录。重头是 GPT-6 进了 ChatGPT 的聊天页,同日上线的 Intelligent UI 能吐出图表、表单和可点的控件;第二样是庆祝,Codex 和 ChatGPT Work 合计活跃用户冲到四千万的新高;第三样进兜里,所有付费账户都会收到一次能存着以后用的重置,原句是 "Loading a banked reset in everyone's paid accounts"。

引的第二天汇总也摆着,自动评审不占用量、给开发者的简化 API、会议笔记入内、Decisions API 上线,四件一排。

"先存着、别现在花"这半句是全场重心。前面第一天讲的是提速,第二天讲的是省用量,这条把重置改成存款。跟前面第一天就提速呼应,那条改的是快慢,这条改的是节奏,两头都在替额度这件事重新排座次。跟前面二十块两小时只吃一成八也接得上,一个记自己花了多少,一个记对方还欠你多少。

四千万这个数我单拎出来记,两家的口径都没给窗口,一个把周活、月活混在一起报,越是这种时候,数字越要连着它的算法一起读。

我留的疑问有三处。四千万的统计窗口没写;存起来的重置何时到期没说;GPT-6 在聊天页和在 Work、Codex 里是不是同一套也没数。

这周把存的那次重置留到周末,看它够不够撑一整晚的长活。

显示更多 话题来源 @thsottiaux 168.7K阅读 ❤️6429
Tibo (@thsottiaux) on X Day 3/ The big one is GPT-6 in Chat, but today is also a little celebration day with a new high of 40M active users across Codex and ChatGPT Work. Loading a banked reset in everyone's paid accounts. X (formerly Twitter)
自由翻滚的风铃草 ·

Cowork 把虚拟机整个搬上了云,工程师先道了歉。

新旧摆开。旧版的推理早在云端,工具调用却跑在发到用户电脑的那台虚拟机里,加它是为了能力和安全,只映射用户显式加进会话的数据。用户喜欢 Claude 能干的那些活,却受不了三样,占的盘、耗的电、拖慢的性能,还有一条更要命,笔电一阖上,活就停了。

新版把推理和虚拟机一并放进云里,每个会话拿到独立的沙盒,互相不共享状态;云端要用设备上的文件,由桌面应用出面接这一次调用;只碰用户显式加入会话的那些文件夹,会话一结束沙盒就销毁。

三项好处照录:阖上笔电活还在跑;调度的任务不再要求设备在线;桌面、网页、手机之间同步,手机上就能发任务。官方说明中心补的时间点是,10 月 6 日起,Pro 和 Max 新建的 Cowork 任务一律云端,"仅在你的电脑上"那个选项被拿掉了。

"阖盖不停工"这半句是全场重心。前面新会话上云那条讲的是把跨设备那节接上,这条讲的是把干活的机器整个挪走。跟前面两天换掉工作台呼应,那条是底座两天搭好,这条是底座连位置都换了,两头都在把本机那份负担往外搬。跟前面修路的多装监控的少也接得上,一个搬算力一个搬视线,都发生在你看不见的地方。

那句道歉我单拎出来记,"这个变更比我们希望的更让人意外"。改动发了邮件也发了应用内通知,还是先把话说软了,这种姿态比改动本身更难得。

我留的疑问有三处。Team 和 Enterprise 啥时候跟进没给;数据合规那条边没写;云上沙盒跑得久了,额度怎么算也没数。

这周把自己的 Cowork 任务全改到云上跑一次,阖盖出门,看回来它是不是真把活干完了。

显示更多 话题来源 @felixrieseberg 180.4K阅读 ❤️633
Felix Rieseberg (@felixrieseberg) on X Hi! I work on Cowork. Probably no surprise, but we want to make our users as powerful as possible with Claude - and you're right that explaining and keeping up with the capabilities is hard. Affected X (formerly Twitter)
我不是小布丁 ·
一句话的预告拿了近九十万阅读,原话只有一行。你现在还不知道我们下周要发布什么,这克制我看完先笑再记它凭什么爆。笑的记的点在下面一层层摆,摆好了看那一行,行在下面摆着,摆好了自己接。 一行字的爆点有三层。第一层是句式,句式是对着另一个人说的。被回复的对象是 poteto。对话体的亲口感比官方公告轻十倍,轻的语气里藏着又一个重磅的暗示。暗示的第二层是下周这个时间词,时间词把悬念装进了倒计时。 什么都不说的理由是行业今年学乖了,提前放料的版本号和功能表全被对家截走做了适配。适配完的先发优势就被提前清零。清零的先例看多了自然学会只给时间不给内容,只给时间的预告把注意力聚到发布会上。 点评两句。第一句是近九十万阅读买一行字这笔账今年罕见,罕见的原因是悬念本身被当成了产品。第二句是被回复的那个代号值得顺藤摸一下,摸到的回来点赞,句号。
显示更多 话题来源 @thsottiaux 895K阅读 ❤️1569
Tibo (@thsottiaux) on X @poteto Hey now. You don’t know what we’re releasing next week X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单