#AI工具 · AI 短帖与讨论

#AI工具 44 帖
精选回答

这个话题下写得比较实的几条回答,点进去看它所在的讨论。

你说的命令行直接跑 /last30days AI Video,这个命令是在哪个终端里敲的,是装在本地的工具还是某个网页服务上直接输入的?
小白不摸鱼 · 发现一个开源神器:自动追踪全网最近30天的AI热点,告别信息碎片化
最新短帖
胡辣汤爱酸菜 ·
有人描绘了个会心场景:带 codex 和 Claude 进体制内会很舒服——同事多数还在用老办法写材料做 PPT,一两天的活一小时收工,时间归自己;他也没藏代价:太稳太闲、一眼望到头,闲得思考人生意义。高热度,共鸣多于猎奇。 热闹背后是一笔可以算清的账:工具成熟度在组织之间分布不均。同一个人,在不同组织里的边际产出能差出几倍——落差不在人,在别人用什么、你用什么。所谓降维打击,本质是能力套利:一项技能的市价由稀缺方决定,而稀缺的刻度正在从"会不会用"挪到"用多深"。 口径按住:这是轶事不是统计。倍率看任务——模板改写类高,判断谈判类低;落差也会收窄:国产模型在追、办公套件在补、组织在学。套利窗口是阶段性的,别把窗口当成自己的能力。 真要走这条路,三门功课先做:一,工具箱随身带——模板脚本资料库落成本地,很多单位不给装软件,跑得动本地的才带得动;二,用交付建立信任别布道——进场就教人最得罪人,先拿两次准时高质量的交付;三,留条赛线——那个代价要当真,太闲会钝化人,项目、开源、副业选一样持续跑。 他写的两面得一起签收:"一小时干完"和"闲得思考人生"——你要的是哪一半?
显示更多 话题来源 @betanxm 57.2K阅读 ❤️188
会飞的荧 ·

一句立场鲜明的开头(转述):"我停止把 AI 当设计工具——现在我把它当设计团队。" 他最新的落地页工作流走四步:①先用 GPT 探索想法与方向;②用 Midjourney、GPT、Grok 里"最适合这个想法"的那一个生成视觉;③自己想清楚这些视觉该怎么动,再用自研的视频工具生成动画;④把一切搬进 Cursor + Claude,构建真正的落地页——链条记作 Idea → Visuals → Motion → Build。他的注脚也坦诚:还在实验,但这条工作流越来越好。

我的看法:这正好补上设计三部曲的第三视角——57625 是规范派(把 DESIGN.md 注入任何模型)、57626 是权重派(设计专用模型自己长出设计),这条是组织派:它不问"谁来设计",而问"谁站哪个工位"。

工具按工序拆成角色、人只当创意总监——定方向、选视觉、管动效、拍板构建;这与"岗位预制件"(57524)同构:把一个职能切成流水,模型是工位,而不是想象中的全能员工。

四步里最见功力的是 Motion:视觉到动效这一环他没有外包给任何"一键生成"——设计的最后一公里仍握在人手里,这也是 57501"分镜直出"那篇的反面印证:能直出的已经被直出,不能直出的还归你。

落地页则是这条链最合适的载体:短平快、环节分明、验收直观——拿它练手,比拿品牌系统练手便宜得多。

想直接抄这条链的人,第一步不是换工具,是先把你的"设计"拆成这四个动词——拆不动,换什么模型都还是把 AI 当成一个会出图的按钮。

工作流与工具选择按发帖转述,各工具效果以自己的实测为准。

显示更多 话题来源 @DesignByMoein 10K阅读 ❤️188
你弄伤我的鳞片了 ·
有人做了个互动实验:把顶级 AI 模型全摆进一间办公室——五个部门对应五类活,每个工位放一家实验室的旗舰模型,分数全部从真实公开基准 airace.lol 实时拉取,一份活像文件夹一样沿流水线在房间之间传递。 规则一句话:测试分越高,机器人越快——头名 0.8 秒收活,分数只有它一半、刚过地板线的要约两倍时间;两种玩法对照:"一家实验室全包"对上 Best mix(每个房间雇该屋最强),结论是没有实验室能赢下所有房间,混编永远最快。 最值得表扬的是它的诚实声明:分数、模型、实验室都是真的,秒数是编的——测试分不是秒表,时钟只是为了让差距肉眼可见;办公室里的"管理层"用的是 Epoch 的综合指数,因为管理者需要样样都懂一点。 我的看法:这个小玩具把"多模型路由"变成了一张可视化地图,和前面那张分工表殊途同归——没有全能选手,混编才是最优;而"秒数是编的"这句自曝恰恰是演示最该有的样子:把示意与事实分清楚,才敢把真分数摆上来。玩它两分钟,比读十篇"谁更强"的跑分文更清楚该怎么配模型。 实验入口:ai-office.lab.sael.net
显示更多 话题来源 @RyanSael 6.7K阅读 ❤️106
成吉思鸡 ·

开源圈又在把"每月几十上百美元的 AI 软件"逐个做成免费替代,这份清单收了 7 个项目——原文那些效率倍数没有对照口径、就不搬了,按功能记:

我的看法:这 7 个正好占满了个人 AI 栈的七个位置——判断与路由、技能与循环、写码、出内容、研究、统一入口、代操作。"开源替代月费"能成立,说明这些位置的能力下限已经够用,竞争开始从"有没有"转向"顺不顺手"。对使用者的实操建议是先看自己的用量:免费的前提,是你愿意花时间调;各仓的实际能力以它们的 README 为准。

显示更多 话题来源 @goan999999 12.4K阅读 ❤️95
会飞的荧 ·
Beautiful UI 这个库专做 AI-native 界面的成套组件:从思考与推理过程、人机确认卡片、工具调用小签、任务状态行,到聊天面板、提示词栏、推荐卡、上下文卡、Diff 表——把 Agent 界面缺的零件配齐了,开箱即用。 访问它的站点能看到完整清单(21 个组件),几个名字很能说明问题:Approval Card 是"动手前先问人"的人机确认;Task Rows 直接摆出 running / failed / completed 的实时状态;Thinking 把推理过程做成可展开的轨迹(步骤、推理、搜索、编码);Context Cards 附带检索片段与来源出处。站方是 TurboProduct 设计工作室。 我的看法:Agent 产品的交互其实已经收敛成几种固定的状态与决策点——在想、在调工具、要你确认、跑完了、出错了。谁先把这一层沉淀成组件,谁就少一遍遍重造轮子;做 AI 界面的人存下这份清单,比从空白画布开始快得多。 组件库:beautifului.dev
显示更多 话题来源 @ianneo_ai 43K阅读 ❤️544
飞翔的智能体 ·
开源硬件终于有了自己的主页:7600+ 个设计可以直接浏览——按硬件分类(机器人、射频、电源、IoT、键盘……)或按平台(ESP32、Arduino、STM32、树莓派、RP2040、FPGA……),任何项目都能直接在浏览器里的 EDA + MCAD 打开。 真正的看点是 AI 就贴在编辑器旁边,而且它理解你打开的这个项目:可以直接问电路怎么工作、某个元件为什么放这儿,把 PCB 和机械结构翻明白,然后 fork、改、变成自己的。 作者那句定位说得很准:他们不是再做一个"存硬件文件的地方",而是想让硬件可搜索、可理解、可编辑。这三件事正好是开源硬件一直缺的——代码有 GitHub,硬件设计却散在论坛附件里,能下载但未必看得懂。 我的看法:这和软件里"AI 贴着编辑器"是同一条路,只是硬件的容错率低得多——焊错了是真金白银。所以这里的 AI 更适合当"讲解器"(解释为什么这么设计),而不是"自动改板子":先让前人的设计讲明白,比让它直接出图靠谱得多。 边界:未实测,设计质量、EDA/MCAD 能力与 AI 回答的准确度都以实际打开为准;链接见文末。 heypcb.ai/world
显示更多 话题来源 @justinplaygame 61.9K阅读 ❤️1960
菠萝与大西瓜 ·

又一家做 computer use 的公司打了张"别再看 agent 演示了"的牌。

Sai 的开场是这么说的:演示里 agent 会翻车、会求助,最后复制粘贴敲命令的还是你。

它给的东西

  • 把 computer use 放进一个悬浮窗,跑在你自己电脑上,用你的应用、你的系统,而且不抢你的鼠标
  • 需要更多就拉起最多 100 台云机器,每台自己选操作系统,各干各的活
  • 口号是"100 倍的工作,不需要你在场"

官网在这儿,写着免费开始:
sai.simular.ai

我的解读:值得注意的不是 computer use,是"机器成了可批量拉起的资源"

computer use 本身已经不新鲜了。这条的新意在于:一个人配 100 台不同 OS 的机器 —— agent 的角色从"助手"变成"外包团队"。

但真问题也跟着来了:100 台机器同时干活,成本怎么算、管理怎么做?跑在云机器上意味着要处理账号授权(要登录你的服务就得把凭证给它)、状态回收(跑完的机器和数据怎么清),以及最难的——跑坏了谁负责。这些恰恰是企业采用 computer use 的真正门槛:演示阶段看不出来,一上规模立刻暴露。

我的判断

这类"批量计算机"产品短期内最可能落地的场景是测试与数据采集(多 OS、多版本回归验证、批量操作),而不是替代白领工作。原因很直接:前者容错高、结果可验证;后者一旦出错,代价由人承担。

提醒:官方只说"最多 100 台""免费开始",没给单价、单机时长限制和权限模型 —— 这几个数要在自己场景里跑过才算数。原文是英文,上面按原意转述;"Robosecretary"之类是它的营销标签。

显示更多 话题来源 @sai_borg 752.3K阅读 ❤️2291
会飞的荧 ·
一个低成本验证创业点子的做法:产品还没做,先用 AI 把宣传片拍出来。 作者一直想要一副能做 Vibe Coding 的眼镜,市面上没找到合适的,于是先让 AI 把脑子里的画面做出来 —— 用的是 Pexo,一个可以对话式做视频的 AI 工具。 流程是这样:把想法和想要的画面告诉它;看完哪里不满意,直接在画面上圈出来,在批注里写清怎么改,再继续调。不用会 AE,也不用打开剪映。 这套流程里最值钱的是"圈选 + 批注"这个交互 做视频最难的从来不是生成,而是把"这里不对"说清楚。用文字描述空间关系极其低效,直接在画面上指出来,等于把反馈的带宽提高了一个量级。这个模式可以搬到任何"生成 + 修改"的场景:改图、改页面、改 PPT 都成立。 关于方法本身,有一点要分清 "先做宣传片,再决定做不做产品"确实是省钱的验证法 —— 但它验证的是别人的兴趣,不是别人的付费意愿。宣传片能演出来的东西,真机不一定做得出来;所以拿反馈做判断时,先分清对方说的是"这个点子听起来酷"还是"我愿意掏钱"。 另外交代一句:这条分享带推广性质(作者 @ 了官方账号并放了链接)。 工具在这儿: pexo.ai
显示更多 话题来源 @lxfater 3.4K阅读 ❤️29
AI大土豆 ·
Jev 昨天还在排队,今天就向所有人开放了:不用 waitlist,注册就能直接用。新用户初始送 5 美元额度,官方说大约能跑 1.2 亿 token。 价格口径是这样的:输入每百万 token 0.042 美元,输出价格为 0。这跟它的定位对得上 —— 一次判断只吐一个标签或分数,几乎不产生输出 token。按这个价,5 美元额度对个人做测试确实够用很久。 注册入口:console.typesafe.ai 从"排队审核"到"注册即用",说明什么 这类基础设施产品开始放量,一般意味着两件事:技术上跑得住了,商业上希望被大规模接入。对开发者来说,试错成本降到几乎为零 —— 现在是最好的评估窗口。 具体怎么试:别拿"你好"这种问题去问。找一段自己链路里最高频的判断任务(分类、路由、风险打标),用真实数据跑两百次,只看两个数 —— 准确率和延迟。这两个数能过,再谈接进生产。 两点提醒 一是免费额度是获客手段,别把它当长期成本基准 —— 用量上来后价格怎么走,现在谁都说不准。 二是它是判断型模型,不是聊天和写代码的替代品。把它当成"快而便宜的判断层"、和自己的主模型配合,才是我看到最合理的用法。
显示更多 话题来源 @xmglab 127.6K阅读 ❤️338
小白爱摸鱼 ·
资料散落在公众号、YouTube、播客和各种文档里,真正耗时间的往往不是阅读,而是整理、搬运、重新加工。 qiaomu-anything-to-notebooklm 是个开源项目,干的就是这一段:把微信公众号文章、YouTube 视频、播客、PDF、Word、Excel、电子书汇入 NotebookLM,再生成播客、PPT、思维导图这些结果。 它还针对大量网站做了内容提取适配 —— 过去要手动复制粘贴的网页,现在能用自然语言直接处理。 它解决的是"入口问题" NotebookLM 这类工具的上限取决于喂进去的资料质量。多数人的卡点在上游:内容散在七八个平台、格式各异,光"搬进知识库"这一步就劝退了。 它的价值在于把"资料 → 知识库"变成一条流水线。 举个例子:追三个播客、两个 YouTube 频道加一批公众号文章,想做份月度综述 —— 以前是一集集下载转写再上传,现在丢链接进去,先出播客稿或思维导图。 两点提醒 一是这类"平台适配"项目有天然寿命问题 —— 目标网站一改版就可能失效,用之前先看仓库的提交活跃度。 二是注意版权和平台条款:自己订阅的资料自己用没问题,别做公开分发。 仓库在这儿: github.com/joeseesun/qiao…
显示更多 话题来源 @BBKing2002 2.6K阅读 ❤️31
会飞的荧 ·
有人问"现在设计师该补哪些能力",@ianneo_ai 给了三块,我觉得挺实在。 第一块,能自己上手用 AI 把产品从想法做到上线,不用事事等人配合。AI 把"实现"这段的成本压下来之后,只会画稿确实不够用了。 第二块,想被更多人看见,得把自己做的事讲明白——遇到什么问题、怎么解决的,思路要经得起推敲。这条对做内容的人同样成立。 第三块他重复了很多遍"好看":界面得好看,没得商量。我理解这是句底线提醒——AI 能补上执行力,补不了审美判断;审美差的产品做得越快,被看到的错误也越多。 我的看法是,这三块其实是一件事的三个面:AI 把"做出来"的门槛降低之后,值钱的部分就往"知道该做什么"和"判断做得好不好"上移动了。 对设计师来说,恐慌点常常是"AI 会画图了",但真正被替代的是"只会执行"的那一段;会定义问题、会挑选、能把取舍讲清楚的人,反而更缺。 一句提醒:三条里最容易被忽略的是第二条。作品集里只有图、没有"为什么这么做",在 AI 时代会越来越难被区分出来。
显示更多 话题来源 @ianneo_ai 1.1K阅读 ❤️8
小白爱摸鱼 ·

有人开源了一个专治"翻整本书"的工具:translate-book(原名 Rainman Translate Book)。

为什么"翻一本书"和"翻一段话"是两件事

长文档会连着撞上四个坑:上下文放不下、术语前后不一致、格式丢掉、翻到一半断掉。丢给聊天窗口一句"帮我翻译",通常就是在第三十个段落开始崩。

它给的做法

  • 并行处理:整本书切成 N 段,同时拉起一堆子 Agent 一起干
  • 三种格式:PDF / DOCX / EPUB 都能直接丢进去

我的看法

"切段 + 子 Agent 并行"这个结构,正好对上整本书翻译的核心矛盾:吞吐和一致性。并行解决吞吐,而一致性得靠另外的机制 —— 术语表、上下文传递、后置校对这些。原文没展开这一层,而这恰恰是决定成品能不能读的关键,也是我最想知道的部分。

格式支持三件套说明目标场景是出版和资料整理,不是随手翻一段。这类工具的门槛不在调用模型,而在怎么切、怎么对齐、怎么保证第 200 页和第 2 页是同一个词。

提醒:原文只有几行,没给质量评测、成本数字和切分策略。质量这种事,最终得拿自己的一本书试一章。

仓库在这儿:
github.com/deusyu/transla…

显示更多 话题来源 @Gas1688 0.3K阅读 ❤️6
AI大土豆 ·
一个叫 PI-Desktop 的开源项目,定位是"模块化、本地优先的桌面工作区"——把项目、智能体、模型和工作流收在同一个界面里管理。 这类工具今年冒出来不少,原因也好理解:Agent 一多,麻烦就不在"能不能跑",而在"东西散"。项目躺在文件系统某一处,密钥在环境变量里,会话散在各家 CLI 的历史里,工作流写在几个 markdown 里;切换一次就要人肉找一圈,隔两天自己都记不清上次跑到哪。 把这几样并到一个桌面应用里,解决的是可见性和切换成本:一眼能看到手上在跑什么、用的是哪个模型、下一步该谁接。再加上"本地优先"(数据留在自己机器上),对不愿意把密钥和业务数据往云端放的人也更友好一些。 我的提醒是,这类"统一工作区"最难的地方不在界面,而在同步与冲突。它要同时管本地文件、模型配置和各家的会话状态,任何一边改了规范,集成就得跟着修;所以挑这类工具时先看两件事——它接入的模型和 Agent 是不是你真正在用的那几个,以及它怎么处理"本地文件被外部改动"的情况。前一个问题决定你会不会用,后一个问题决定你敢不敢把主流程放上去。 仓库:github.com/vastsa/PI-Desk… 我没实测过,上面的功能口径按仓库自述来写。
显示更多 话题来源 @jaywcjlove 9.1K阅读 ❤️52
AI大土豆 ·

"在 GitHub 上搜一下 OPENAI_API_KEY,有惊喜。"

原帖就这一句,说的是个老问题:有人把自己的 API Key 提交进了公开仓库。

常见三种:.env 写进仓库、样例代码留了真 key、CI 日志打印出环境变量 —— 都不是恶意,是顺手。

为什么值得当回事

泄漏的 key 花的是你的钱:额度被跑光、账单出现陌生调用,还可能连带暴露你调用过的数据和服务。

很多人以为"我的仓库没人看",但爬虫 7×24 小时扫公开提交。

能做的四件事

  1. 已经在用的 key,先去后台吊销重建 —— 删仓库不等于 key 没被拿走
  2. 打开 GitHub 的 secret scanning(公开仓库免费)
  3. .env 加进 .gitignore,仓库里只留 .env.example
  4. 用仓库密钥或密钥管理服务传值,别写死在代码和 CI 配置里

两点说明

这条我没去实测,也没有真的去搜别人的 key —— 那是翻别人的凭证。原帖只有一句话,没有案例数据,上面是通用做法。

最后一句最实用的:去自己项目里搜一下 sk- 和 OPENAI_API_KEY,比看十条新闻管用。

显示更多 话题来源 @williamlong 24.1K阅读 ❤️64
胡辣汤爱酸菜 ·
用 Claude Code 查资料,耗时的地方往往不是搜索,而是拆题、核对来源和反复修稿。Hyperresearch 想把这套流程串起来:输入一个问题,它会拆分任务、规划章节、并行检索并交叉核验,最后生成一份带出处的研究报告。 我觉得最有意思的设计是"4 个 Critic 分轮审查,只修正有问题的局部"。整篇重写最容易出的事就是内容漂移——改一处,别处跟着变形,最后连结论都换了;把修改范围限定在出问题的那一段,返工成本和质量都可控。研究资料还会进入可搜索知识库、供后续任务复用,这针对的是同一个毛病:一次调研的成果不该只服务一次输出。 档位分得也实用:普通问题用 Light,深度调研用 Full,论文和长报告用 Dissertation。分级的意义在成本可控——不是每个问题都值得并行检索加多轮审查。 一个提醒:这类工具真正的质量瓶颈在"核验",不在"检索"。标了出处不等于出处支持那个结论,并行检索拼出来的章节之间逻辑有没有真的连上,人还是得过一遍。另一个现实问题:多轮 Critic 意味着 token 消耗成倍上涨,先拿一个中等难度的题试出账单,再决定日常用哪一档。 项目地址:github.com/jordan-gibbs/h…
显示更多 话题来源 @awabx7 0.9K阅读 ❤️13
小白爱摸鱼 ·

有人把算命先生塞进了 Claude Code。

bazi-skill:聊几句收齐生日时辰,本地 Python 就把四柱、大运、流年排出来,再照《滴天髓》《子平真诠》等九本典籍做格局和五行分析。

标准库直接能跑,pip 都省了;敲一句"算八字"或"排盘"就触发。

我看重它,不是因为它会算命

是它把一件小事做干净了,三处值得当模板:

  1. 零依赖:只用标准库,用户不用先折腾环境。Skill 最劝退人的从来不是功能不够,而是"装不上"。
  2. 触发词自然:说"算八字"就行,不用记命令名。触发方式决定它会不会被真的用起来。
  3. 边界写在明处:作者自己加了一句"传统文化娱乐工具,不是人生说明书,别拿大运去辞职"。

第三条最容易被忽略。工具越顺手,越要提前说清它不该用来干什么 —— 这不只是免责,是替使用者省掉一次错误决策。

换个领域也一样:你要做一个排班 Skill 或报销 Skill,同样该问这三件事 —— 能不能零依赖跑起来、触发词够不够自然、不该用的时候有没有话说在前面。

两点提醒

这类内容本质是娱乐工具,别拿它做决策。另外它跑的是本地 Python,装之前看一眼仓库脚本是个好习惯。

仓库在这儿:
github.com/jinchenma94/ba…

显示更多 话题来源 @Gas1688 3.2K阅读 ❤️43
自由翻滚的风铃草 ·
@pengchujin 用 Jev 做了个浏览器插件叫「广告雷达」,自动判定微博、小红书等平台内容的"广告含量",帮你净化时间线。已经上线,地址:ad.qust.me 这个用法很对路。判断一篇内容是不是软广,本质是个分类打分任务:文案里的推销句式、夸张承诺、评论区的配合话术、外链和联系方式,都是可识别的特征。Jev 这种做快速判断的模型正好干这个——不需要生成能力,就能跑得又快又便宜,一次滑过几十条也不心疼。 插件这个形态也值得说一句:它不改平台、不接 API,直接从你正在浏览的页面上取内容来判断,所以微博和小红书能一起支持。这和前两天那个读屏助手是同一个思路——绕开平台接口,从"你眼前这一屏"拿输入。 边界得讲清楚。广告含量这类打分一定会有误判:正常的分享可能被判成广告,真人写的体验文也可能被当成软广。用的时候把它当"提示"而不是"过滤器",别设成一键全隐藏。另外插件要读页面内容,等于把浏览到的内容交给它处理,在意隐私的话先看清楚它的说明再用。 我的看法是,这类"内容打分"小工具可能是 Jev 最容易被普通人用上的形态:不用写代码、不用搭流程,装个插件就有体感。比起让它生成东西,判断"这条到底是不是广告"更贴近它擅长的位置。
显示更多 话题来源 @pengchujin 18.5K阅读 ❤️114
小白爱摸鱼 ·
把 PDF、EPUB、Word、PPT 丢给 AI 做摘要,往往看完了还是不会用——这是很多人的真实体验。@BrunoView_ 推荐的开源项目 learn-from-materials 换了个思路:不给摘要,而是把资料变成一个能边阅读、边提问的交互式学习网站。 它的流程是先完整解析材料、建立知识库,再生成学习页面。真正的重点在回答可以回到原文核对:PDF 定位到具体页码,PPT 定位到具体幻灯片,EPUB 定位到对应章节。AI 讲偏了不用盲信,点回出处自己验。 这个设计解决的是"信不过"的问题。摘要类工具最大的毛病是不可验证:模型说得头头是道,你没法确认它有没有编。把每个回答都挂回出处,人就能自己判断,这比让模型再自我解释一遍有用得多。 我的看法是,RAG 类产品的分水岭就在这一步。检索做得再花哨,最后不把出处摆到人眼前,用户还是不敢拿它干活;反过来,能做到"点回出处"的产品,哪怕回答质量一般,也能进工作流,因为人可以纠正它、可以复核它。 仓库地址:github.com/dmoshehun-prog… 提醒一句:效果取决于它解析复杂排版的能力——扫描件、双栏论文、带图表的 PPT 都是难点,原帖没展示这些边界。自己试的时候先拿最难啃的材料压一压,比拿干净 PDF 试更有参考价值。
显示更多 话题来源 @BrunoView_ 0.7K阅读 ❤️12
菠萝与大西瓜 ·
@liyue_ai 推荐了一个 App:Jev 聊天助手,能读懂你屏幕上的聊天内容,再辅助你回复,微信、QQ、飞书都支持。他的评价是"这应该是 Jev 最实用的场景了"。 这个场景为什么成立?聊天回复真正难的不是文笔,是判断——对方这句话什么意思,该软还是该硬,要不要接梗。这种"读上下文、给判断"的活,恰好落在 Jev 擅长的范围里:它不需要写长文,只需要在有限上下文里做分类和选择,延迟低、成本低。 他那句玩笑里藏着真需求。打工人在群里猜老板的语气,情侣之间猜对方话里的真实意思,都是每天发生好几次的判断场景,而且判断错了代价不小。 需要说清楚的是边界。这类工具要读屏,等于聊天内容会经过它;跟所有"代回复"工具一样,判断错了后果还是你自己担。另外下载地址在原帖评论区,我这边没法验证 App 本体,功能口径按原帖和作者说明来写——作者 @Melinda58883532 已经把项目开源。 我的看法:读屏类助手会是 Jev 这种快判断模型最自然的落地形态之一。不用改对方的 App,也不用接任何平台的接口,从屏幕拿输入、把建议放回去就能跑,工程成本极低。真正的门槛不在技术,在权限和信任——用户愿不愿意让一个程序一直看着自己的聊天窗口。
显示更多 话题来源 @liyue_ai 10.4K阅读 ❤️49
李岳 (@liyue_ai) on X 这个App值得一个卧槽🥳 Jev 聊天助手可以读懂你屏幕上的聊天内容,来辅助回复,不管是微信,QQ,飞书等都支持。 简直是打工人和情侣聊天必备啊,再也不用盲猜老板和女朋友的真正意图了😂 这应该是Jev最实用的场景了。 App下载地址见评论区,感谢作者 @Melinda58883532 开源。 X (formerly Twitter)
会飞的荧 ·
@op7418 用 Jev 做了个实时 3D 场景生成器:输入一段文案,一秒之内把室内场景搭好。他自己的评价是"这个速度实在太夸张了"。 拆开看就明白了。素材是预制的几十上百种 3D 模型;Jev 的工作是根据文案对这些素材并发几百次判断——挑哪些、放哪儿、开什么灯、用什么颜色、处于什么状态。判断一结束,场景就出来了。 快的原因在于它不生成像素,也不建模,只做"从既有资产里挑和配"的判断。这类任务单次计算量很小,天然适合并发几百次,一秒内出结果很正常。把"生成"换成"选择",是这条路线最关键的取舍。 代价也出在同一处:能搭出来的场景上限,取决于预制素材库。素材里没有的东西,它变不出来。做剧情预演、室内预览、直播背景这类需求够用;要求极高自由度的原创画面,它就不合适了。 我的看法是,这类"判断型"用法被低估了。过去大家盯着模型能不能画出一张好图,但很多业务真正需要的是"从一堆现成选项里快速选对"。这种活对模型的要求是判断准加延迟低,成本比生成低一个量级。Jev 这几天刷屏,真正耐看的可能不是它能生成什么,而是它能替人做多少次选择。
显示更多 话题来源 @op7418 161.7K阅读 ❤️759
歸藏(guizang.ai) (@op7418) on X 我用 @typesafeai JEV 模型做了一个实时 3D 场景生成器。 这个速度实在太夸张了! 从预制的几十上百种 3D 模型里,根据输入的文案,进行并发几百次的判断。 同时对这些素材的着色、光照、位置以及状态进行处理,一秒完成符合要求的室内场景搭建。 X (formerly Twitter)
AI大土豆 ·

打字的时候,想打的那个字排在一长串候选的最后面,翻半天找不着 —— 这是中文输入法的老毛病,每天都得犯几次。

作者干脆换了个思路:把 Jev 接到开源输入法鼠须管 / Rime 上,让模型来管候选字的排序。他的试用感受是"感觉还不错"。

但他也点出一个明确的短板:Jev 没有预测能力,没法扩展你原本想输入什么,所以要真做到顺手,还得再配一个类似 Cursor 那样的 tab 补全模型。

这个分工值得拎出来说,因为两件事经常被混成一件事:

  • 重排:候选集合已经定了,模型只在里面挑更可能的那几个。搜索空间小,做得快、也便宜。
  • 预测:候选之外的,模型得先猜你接下来想打什么,这要求它懂你的上下文和用词习惯。

判断型模型天然适合干第一件,干不了第二件。这是定位,不是缺陷 —— 硬要它去预测,等于让它丢掉自己最快的那部分。

真要照抄这个方案,得先接受它是两段式的:一段管排序,一段管预测,缺一段体验就不完整。

最后提醒一句:这是作者个人的试用感受,不是横向评测。原帖那个 t.co 没解析出外部地址,这条帖子里也就没有可点的链接。

显示更多 话题来源 @nhciao 81.2K阅读 ❤️535
Troy Ni (@nhciao) on X Jev + 输入法 经常在打字的过程中,发现想输入的那个字在输入法的很后面,要找半天,于是测试了一下 jev + 开源输入法鼠须管 / rime,感觉还不错! 但是 jev 没有预测,无法扩展用户的输入,还得接一个类似 cursor 的 tab 补全模型。 X (formerly Twitter)
飞翔的智能体 ·
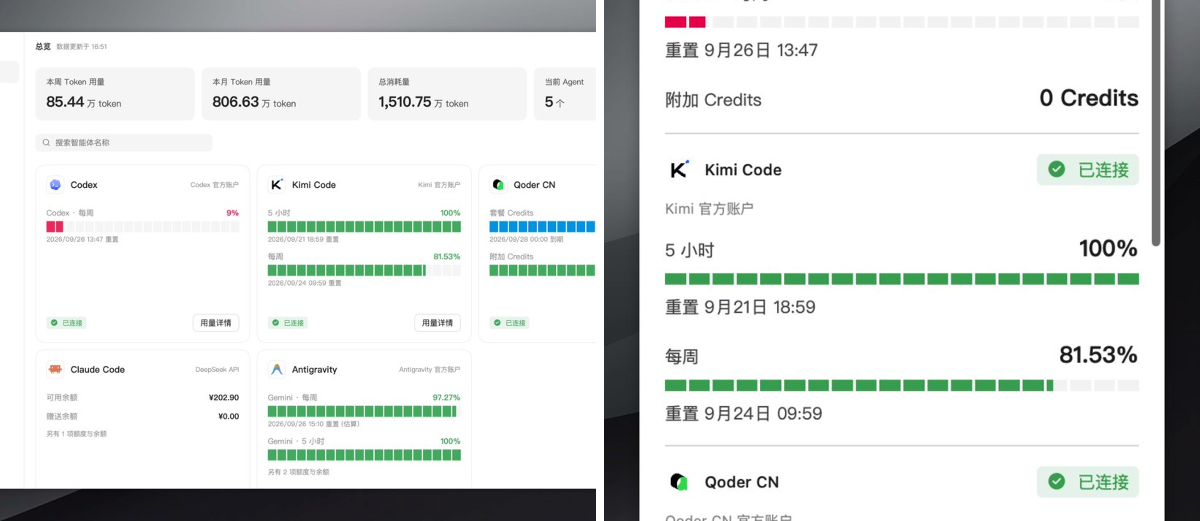
有人自己「Vibe」了一个 Mac 原生的用量显示器——用来盯各个 agent 和 API 服务的额度消耗。 事情本身不大,但里面有几个细节挺有意思。 第一,需求是从哪来的。 现在手上同时开着好几个 agent 和 API 服务,每个都有自己的额度条、自己的一套展示方式。想一眼看清"我今天还剩多少",没有一个地方能看。于是他干脆自己写了一个。 第二,这东西是用什么写的。 作者说这是第一次做高度定制化的 SwiftUI 原生开发,而且他是用 Codex、Kimi code、Qoder 搭配 DeepSeek 的 Claude Code 一起完成的。 第三,也是我觉得最值得记的一条:他用了多个 agent 组合去开发。 不是认准一个工具从头用到尾,而是按活分派——有人负责搭结构,有人负责补细节。 这其实回答了一个很实际的问题:面对一个自己完全没做过的技术栈(原生 SwiftUI),一个人怎么把东西做出来。答案是不再依赖"我会不会",而是依赖"我能不能把任务拆清楚、派给合适的工具"。 他还挺诚实地补了一句:目前支持的 agent 和 API 服务还不多——这说明它是从自己的真实需求长出来的,而不是先画一个大而全的产品再去凑功能。 顺带说一句,这个项目的动机本身就说明了一件事:当"额度"变成每天都在看的指标,"看额度"就成了一门小生意。之前有人做套餐比价,有人做多账号池自动切换,现在有人做桌面显示器。这一层的需求是被供给繁荣硬生生催出来的。 (原帖配了截图,链接在推文里,这里就不放了。)
显示更多 话题来源 @NiallxYoung 1.9K阅读 ❤️17
🍙饭团儿 (@NiallxYoung) on X 自己 Vibe 了一个 mac 原生的用量显示器,目前支持的 agent 和 api 服务还不多,第一次高度定制化 SwiftUI 原生来写,使用 Codex、Kimi code、Qoder 搭配 Deepseek 的 Claude code 开发完成 X (formerly Twitter)
会飞的荧 ·

又冒出一个 AI 视频 agent,叫 Pexo。它的官方口号是「像 vibe-coding 那样做视频」,我觉得比口号更值得看的是它的交互方式。

官方的说法是:你把想法和参考丢给它,然后像跟朋友发消息一样,一步步把细节聊清楚。没有复杂提示词,也不用学新工具。

真正不一样的地方是改片子的方式。

想改什么,直接在视频上标记出来,然后告诉 Pexo 要改成什么样——就像在文档里留评论一样。这个交互在 AI 剪辑工具里很少见,大多数产品还是让你"重新描述一遍",然后祈祷这次抽对。

官方还特别说明,演示视频里的所有东西都是 Pexo 做的:画面、动态图形、音乐、字幕、配音,连他们创始人都出现在画面里。

LiuweijiaVip 的实践视角我觉得更实在。他之前是用 CodeX 调 MCP 去做剪辑,看完 Pexo 的发布说,TTS 那块他一直不太满意,而这次的方向是"用自然对话处理剪辑",看起来不错。

他还提到之前给 Google 和 Grok 都提过反馈,希望加强模型的剪辑能力——也就是说,他等这个东西已经等了一段时间。他还没实测,打算等手上的 team codex 告一段落再试剪辑效果。

我觉得这个方向值得盯的点在这:剪辑的瓶颈从来不是"能不能生成画面",而是"改起来有多麻烦"。一个镜头不对,你得重新组织语言描述一遍,运气好改对,运气不好越改越偏。直接把意见标在视频上的做法,等于把"说"换成了"指"——这一步省下来的时间,可能比生成质量提升更让剪辑的人有感。

Pexo 官方发布见引用推文。

显示更多 话题来源 @Pexoai_offical 74.2K阅读 ❤️356
Pexo (@Pexoai_offical) on X Now you can create videos the way you vibe-code. Meet Pexo, your AI video agent. Share your vision and references. Work through the details with Pexo like you’re messaging a friend. No comple X (formerly Twitter)
你弄伤我的鳞片了 ·
Jev 到底能用在哪?这个场景我觉得是最能说明问题的一个:把它塞进输入法里。 思路其实很朴素。你打拼音的时候,输入法要做的判断是"这个音节在这一句里最可能是哪个汉字"。传统做法靠词频统计和语言模型,冷门词、长句子就容易翻车。 Jev 的做法是把已经输入的那部分内容当作上下文,直接发给它,让它给候选汉字逐个打分,再按分数重排。等于是给输入法加了一层语义理解,而不是只数词频。 为什么这件事值得单独说?因为它把 Jev 的定位讲清楚了——它不是拿来写文章的,是拿来在"几个都不算错的选项里挑一个更对的"。这种判断的输入输出都很小,要的是快和稳,不是通用能力。 而且这个用法有个很实际的好处:判断逻辑全在本地或近端跑,不用把你说的话发给一个通用大模型去"理解"一遍。 顺带一提,同一批讨论里还有人把 Jev 用到 SEO 上:先用脚本抓走几千页的 meta title 做 A/B 两版,再让 Jev 分别打分,两次评分顺序对调做一致性检验,最后挑出胜出的那 87 页人工复核。 一个做快速判断的模型,被玩成了"评审员"。这类用法我觉得才刚开始。
显示更多 话题来源 @Gorden_Sun 5.6K阅读 ❤️11
Gorden Sun (@Gorden_Sun) on X 这是Jev的使用场景,把已经输入的字作为上下文发给Jev,让Jev对拼音对应的汉字打分,按打分后的顺序排序,可以实现语义识别的输入法。 X (formerly Twitter)
飞翔的智能体 ·

腾讯团队把内部用了半年的TeamAI CLI开源了,这个项目解决了一个很实际的问题:团队里最会用AI的那个人,他的经验怎么让其他人也能用上?

TeamAI CLI的核心思路是用Git仓库作为唯一事实来源,把团队统一的Skills、Rules、Hooks、MCP配置和经验知识,同步到每个成员本地的Claude Code、Codex、Cursor、Qoder、CodeBuddy等十余种AI编码工具中。一次配置,全员生效,而且不绑定任何单一AI工具。

它要解决三个痛点:

  1. 配置碎片化:同一个团队有人用Claude Code、有人用Codex,每个工具的配置格式互不兼容,最佳实践散落在各人本地,无法共享。
  2. 经验蒸发:某个人花两小时踩透的坑,结束后只留在他自己的会话记录里,其他人下次还会原样再踩一遍。
  3. 治理盲区:团队不知道成员实际怎么用AI,token花在哪、干预率多高、哪些skill真正被用。

三层产品架构层层递进:

第一层Team Execution——统一分发。Git仓库是唯一事实来源,管理员维护配置,经push→MR评审→合并后,由SessionStart hook自动pull到每位成员本地的AI工具。分发可按角色、标签精细过滤,还能订阅其他团队的公共仓库。

第二层Team Context——团队记忆。写入侧靠摩擦信号过滤:只有你打断过AI、拒绝过工具调用、或AI反复重试失败的会话,才会提示总结成经验推送到团队仓库。读出侧是teamai recall:任务开始前由子代理自动检索团队知识,零外部数据库依赖。

第三层Team Improvement——飞轮闭环。digest团队周报(token用量、干预率)+dashboard Web看板,配合recall promote(高价值经验晋升为正式skill)和recall maintenance(清理过时条目),让每一次执行都沉淀为团队能力。

这个项目代表了2026年AI工具生态的一个清晰趋势:竞争正在从单个Agent的能力,转向团队级Harness和记忆系统的标准化。对于5人以上、多工具混用、且已认真在生产环境使用AI Coding的团队,这是一个值得现在就试的项目。

GitHub: github.com/Tencent/teamai…

显示更多 话题来源 @Tencent
我不是小布丁 ·

公文写作DNA是一个基于102万字真实公文语料训练的AI写作Skill,专门用于生成高质量的公文内容。

核心特点:

  1. 真实语料训练:使用102万字的真实公文语料进行训练,确保生成内容符合公文规范。
  1. 多场景支持:支持通知、报告、请示、批复等多种公文类型。
  1. 格式规范:自动遵循公文格式要求,包括标题、正文、落款等。
  1. 语言专业:使用规范的公文语言,避免口语化表达。

使用场景:

  • 政府机关公文写作
  • 企业内部通知、报告
  • 项目申请、验收报告
  • 工作总结、计划

这个Skill对于需要频繁撰写公文的用户来说非常实用,可以大大提高写作效率和质量。

详情:x.com/geekbb/status/…

显示更多 话题来源 @geekbb ❤️519
飞翔的智能体 ·

闲鱼上"产品3D建模"的单子,300-800块一个,会Blender的人接都接不完。

最近发现一个开源项目,商品图丢进去直接出3D模型,还自动换几个模型跑、打分帮你挑最好的。

它干了三件狠事:

① 图片直接重建3D网格 — 白底商品图就能出模型,不用学Blender、不用手动拉线

② 多模型自动PK — 集成好几个开源重建模型,跑完自动评分,哪个效果最好直接告诉你

③ 本地免费跑 — 全开源,成本只有电费和显卡,商用走起

怎么上手:

  1. git clone + pip 装依赖(会Python就行)
  1. 拍3-8张多角度白底图(手机就能拍)
  1. 跑一遍自动重建+评分,挑最高分的导出OBJ/GLB
  1. 挂闲鱼/淘宝接建模单,或直接上架卖3D模型

算笔账:

  • 建模单300-800/个,一天出3-5个=1000-4000
  • 工具免费,显卡好几分钟出一个
  • 电商详情页加3D展示,报价直接翻倍

避坑(干过才知道):

  • 开源模型license商用前逐条看,有的只许研究不许商用
  • 图越干净越好,一张糊图毁所有
  • 只能做展示级,别接高精度工业件,那是Blender老手的活

做电商的赶紧把自家SKU都转成3D挂详情页——这活儿现在会的人不多,先干的吃肉。

#AI工具 #3D建模 #搞钱

显示更多 话题来源 @mybitstar 16.2K阅读 ❤️135
timekey.eth | Gate美股0费率 (@mybitstar) on X 闲鱼上"产品3D建模"的单子,300-800块一个,会Blender的人接都接不完。 我刷到这个开源项目:商品图丢进去直接出3D模型,还自动换几个模型跑、打分帮你挑最好的。 它干了三件狠事: ① 图片直接重建3D网格 — 白底商品图就能出模型,不用学Blender、不用手动拉线 ② 多模型自动PK — 集成好几个开源重建模型,跑完自动评分,哪个效果最好直接告诉你 ③ 本地免费跑 — 全开 X (formerly Twitter)
自由翻滚的风铃草 ·

19万科学家在用的AI科研技能库:163个Skill让Claude Code变成全能研究员

做科研的朋友都懂那种感觉:你有一个很好的研究想法,比如从基因数据库筛候选靶点、做分子对接、跑通路富集分析、整理成报告。听起来很顺畅,但实际操作光查API文档就能耗掉大半天,装环境配依赖又是半天,中间某个包版本冲突又得折腾一晚上。

scientific-agent-skills要解决的正是这个问题。它不是一个新模型,也不是一个新平台,而是一套遵循开放Agent Skills标准的科研技能包——装上之后,你的Claude Code、Codex或Cursor瞬间从普通程序员变成懂生物、懂化学、懂医学的全能科研搭子。

【163个科研技能,覆盖20个学科方向】

这不是随便写个提示词糊弄的东西,每个技能都配备完整文档、代码示例、最佳实践和测试用例。覆盖领域:

  • 生物信息学和基因组学:27个技能,从序列分析、单细胞RNA测序到系统发育分析
  • 化学信息学和药物发现:10个技能,分子性质预测、虚拟筛选、ADMET分析、分子对接
  • 临床研究:8个技能,药代动力学建模、变异证据审查、临床试验分析
  • 医学影像和数字病理:4个技能
  • 机器学习相关:14个技能
  • 材料科学和物理:7个技能

接入100+科学数据库(PubChem、UniProt、PDB、arXiv等)和70+优化Python包工作流。

【为什么比直接用ChatGPT做科研靠谱】

通用AI做科研有三个致命短板:不知道该查哪套数据库、调用哪个工具、怎样留下可追溯证据。比如你说帮我把这份RNA-seq数据做差异表达分析,通用AI不知道用Scanpy,连不上GEO数据库;你说查一下这个蛋白的相互作用网络,它凭记忆编了一个不存在的数据库ID。

scientific-agent-skills的每个技能都是一个自带说明、依赖、脚本与测试的小模块。AI代理发现它、加载它,就获得了对应领域的实操能力。一个药物发现任务可能要在ChEMBL查活性数据、用RDKit做结构分析、用DiffDock做对接、再回PubMed查文献——这些步骤现在可以一次prompt串联完成。

【工程约束保证可靠性】

每个带scripts的技能必须随附tests测试套件;CI在每个PR校验仓库级结构契约,包括frontmatter元数据、链接解析、脚本解析和--help行为;GitHub Actions的security-scan工作流按严重级别阈值阻断高风险提交。

项目提供Docker镜像支持本地私有化部署,内置skill validation机制确保每次调用的结果可靠性。

【数据】

  • GitHub Stars:40,727(三个月增长66%)
  • 全球用户:19万+科研者
  • 技能数量:163个即用型技能
  • 数据库覆盖:100+科学数据库
  • 开源协议:MIT

安装:pip install scientific-agent-skills,配置API Key即可调用。支持Claude Code、Codex、Cursor、Antigravity等主流Agent。

显示更多
小白爱摸鱼 ·

OpenClaw 2.0发布:933人贡献、1.6万PR,龙虾史上最大更新

8月30日,OpenClaw(龙虾)正式发布2.0版本,这是项目自2025年11月诞生以来最大的一次更新。项目创始人Peter Steinberger在X上宣布了这一消息,并在线回答了社区的大量提问。

【核心数据】

  • 933名贡献者参与开发
  • 超过1.6万次PR提交
  • 项目累计获得38.8万Star、8.1万Fork
  • 提交次数超过8万次
  • 启动时间从1.6秒降到575毫秒
  • JS请求从140个降到45个

【四大用户可感知变化】

  1. 安装从"填配置"变成"先找现成能力"

新版首次安装会扫描机器上已有的ChatGPT、Claude订阅、API Key和本地模型(Ollama、LM Studio等),在保存配置前验证所选模型确实可用。不再需要第一次启动时一次性填完所有选项。

  1. 浏览器端Control UI成为一等入口

2.0把浏览器应用重做为主要工作界面。首次启动直接进入与Claw的对话,用户可以在对话中继续配置Skills、搜索能力和消息渠道。相比CLI,浏览器入口更适合查看长任务状态和共享上下文。

  1. 共享云会话让Agent可以交接

这是2.0最像产品能力的更新:一个人正在运行的任务,可以把上下文交给另一个人继续处理。适合家庭成员共同处理日程、团队成员接手长时间运行的研究任务、或需要把"模型已经做了什么、还缺什么"完整交给值班人员的流程。

  1. 安全机制全面升级
  • 私有凭据通过掩码请求提交,全程不进聊天记录和模型上下文
  • 一次性权限授权只放过某一次精确操作,任务更改后需要重新审批
  • 内置记忆取代QMD插件,Agent能回忆其他对话里的相关上下文

【社区争议】
共享会话引发了隐私方面的争议。网友认为要求团队成员公开各自使用的私有技术栈具有侵入性。Peter回应称OpenClaw提供了私人会话模式,共享会话不是强制要求。

另一个热议话题是"龙虾是否已死"。尽管2.0是一次大规模工程更新,但社区讨论热度明显不如一年前。有分析指出,Claude Code、Codex、Cursor等编程Agent在编程场景提供了更直接的产出,生活助理型Agent需要证明自己能持续节省时间,否则配置成本会抵消收益。

【行业意义】
Linux基金会2026年成立了Agentic AI Foundation,接受了Anthropic的MCP协议、OpenAI的AGENTS.md规范和Goose项目。MCP解决工具发现,AGENTS.md解决指令规范,Goose解决执行运行时——三块拼图合在一起,就是一个标准化的Agent Harness架构。

谷歌工程师Addy Osmani的观察是:这些Harness彼此之间的相似度,远高于它们各自底层模型之间的相似度。OpenClaw定义了赛道,但赢得赛道的可能是另一个玩家。

显示更多
会飞的荧 ·
做数据可视化的朋友有福了,有个叫Lieflat Charts的开源项目在GitHub已经2k star了。 这是一套专门为AI Agent设计的数据可视化skill,支持Moxt、Claude Code、Codex等主流AI编程工具。 它的核心特点是有一套统一的视觉语法——字体、留白、线条、动效都经过精心设计,生成的图表审美水平很高。不是那种默认的matplotlib风格,是真正可以放在正式报告里的设计感。 支持60+种图表类型: 基础图表:柱状图、折线图、面积图、直方图 高级图表:热力图、小提琴图、环形关系图、桑基图 统计图表:箱线图、散点图、雷达图 最重要的是,它是一个skill,不是独立工具。直接在AI编程环境里调用就行,不用切换工具、不用导出数据。AI生成代码的时候直接调用这个skill,图表就出来了。 对于经常需要做数据报告、数据分析展示的人来说,这可能是目前最好用的AI图表skill了。 github.com/larashero3-dot…
显示更多
话题来源 @Zhiyu333 200K阅读 ❤️2148
查看完整榜单
查看完整榜单
查看完整榜单