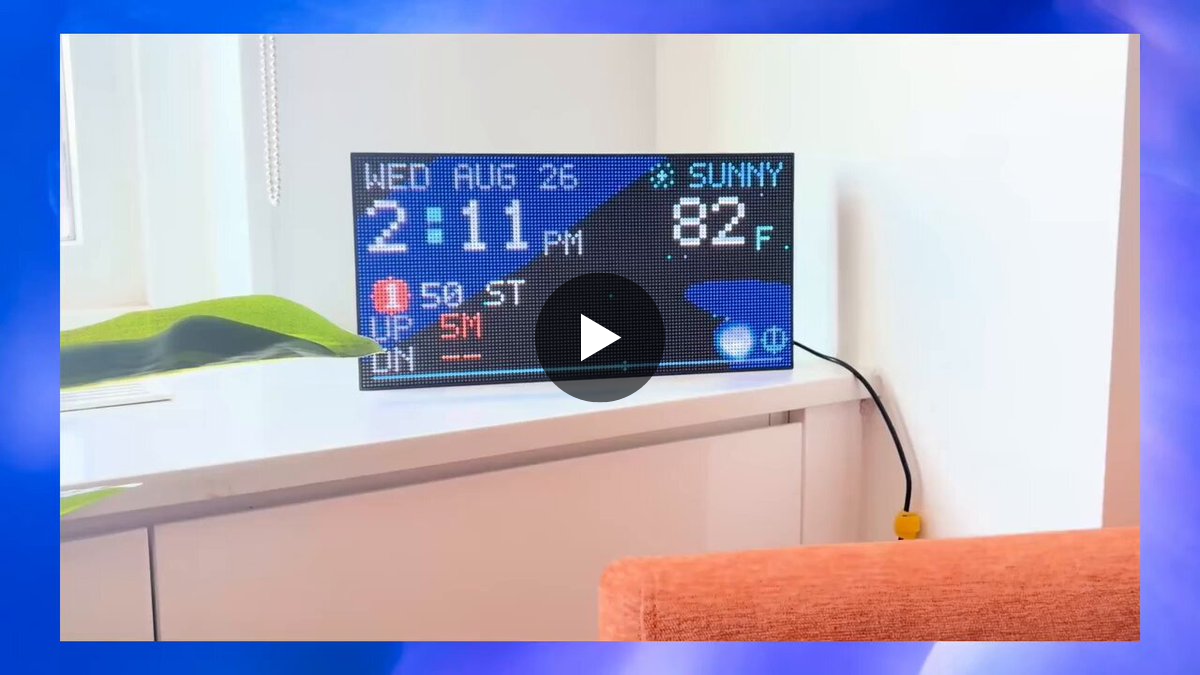
OpenAI 官方展示了一个动手案例(按官方帖转述):工程师 sidrampally 用 Codex 把一块 LED 显示屏改造成"语音控制的助手"——从接线("figuring out the wiring")到调试,一路做到"把那句话显示在墙上";硬件是树莓派,大脑是 GPT-Live-1,屏幕上轮播天气、地铁到站等信息(演示视频见原帖,本条未取)。
我的看法:这条的关键词是那个没解释过的新名字:GPT-Live-1——官方案例里它不写"GPT-5x"也不写"4o",直接冠"Live":实时、活着、随时插话的语音档,配的恰是"语音控制"这种不能等三秒的场景;再看组合拳:Codex 写代码、GPT-Live-1 听话出声、树莓派当身体——一个案例里塞了三种角色:干活的、对话的、承载的,这正是今晚反复出现的分工图缩影(57993 座位表:谁动手、谁接话、谁站岗)。
案例本身也很"日常硬件":LED 屏+树莓派不是实验室,是抽屉里就能凑齐的东西——与 Kaggle 那句 everyday hardware(58426)、agent 本体搬回家(58385)连成一条线:官方在用同一个故事说服你——AI 的下一站不在云上炫技,在你桌角那块小板子上。
给动手党一句:别小看"天气+地铁到站"这种无聊信息——能把无聊的事做得随时可问、张口就答,就是语音助手第一次真的像助手;想复刻的话,先想清楚你要它"答"还是让它"做"——这条案例答的是后者还没来、前者已经够好玩。
功能、硬件与模型名均为官方帖转述(视频未取),GPT-Live-1 细节以 OpenAI 官方文档为准。
一条把"剪映 500 块年费"打下来的四步流水(按发帖转述):①在 X/抖音/油管找热门视频 → ②下载到本地 → ③写好提示词丢给开源工具 HyperFrames → ④90 秒精华版直接生成,带字幕带旁白——作者说他要做的只是按下回车。
它自述的完整链条更值得看:读取 17 分钟原视频 → 提取并转录英文语音 → 理解全片 → 挑出最值得看的片段 → 重写 90 秒中文叙事 → 裁剪原素材 → 加中文字幕、标题、信息卡与动画 → HyperFrames 制作 → 自查 → 吐出一个 MP4——全程没打开剪映(教程与 Prompt 放在原帖的回复里,本条未追取)。
收尾那句最有传播力:"以后看到 20 分钟英文教程,甚至不用自己看完——扔进去,告诉 Codex:'给中国用户重新讲一遍。'"
我的看法:这是尾工序收口的第四次现身——H3 吃了剪辑字幕(57719)、Grok Bot 吃了干活(57670)、Step 吃了发布(57726),这条由 HyperFrames 吃下"剪映级后期";而且它与昨天刚发的 3D 相机 Skill(57887)同属 hyperframes 生态——上一篇是生态里一枚技能上线,这篇是拿整条生态跑端到端,两篇合起来正好是一张"后期流水线"的全景。
链条里最亮眼的是"重写 90 秒中文叙事"那一步:这不是剪辑,是跨语言的再创作——与 57641 的"把 brief 变全套交付物"同一类能力,方向却相反(那篇出海、这篇把英文内容引进来),本地化流水第一次被压进一条按回车的链。
给创作者的实操建议照旧分段买:先让它跑通一条"20 分钟英文教程 → 90 秒中文精华",再决定要不要把找片与分发也交出去;那句"我只按回车"听着夸张,拆开链路看,每一步都对应今晚发过的某一篇——流水线不是魔法,是拼起来的。
流程、时长与工具名均为发帖转述;教程与 Prompt 在原帖回复内、本条未取,以开源仓库与原回复为准。
有人把 Codex With ChatGPT 做到了近 6K 星,初衷一句话——终结"用 5 分钟就没额度",让 Plus 用户把额度真正用足;做法是 MCP + Skill 让网页端 GPT 访问本地文件:GPT 负责修改规划与建议,本地模型执行。
同题里还能拼到两条:另一条帖说"网页版的含金量还在上升"(装官方插件的玩法),还有人直接给出 Plus 的 effort 档位建议(Luna 用高档、Sol 用中档……)——社区已经把"额度怎么花"研究成了显学。
我的看法:这个项目踩中的是额度经济的两端。供给侧刚发生两件事——双子模型半价、攒下的 reset 进了全账户;需求侧就是这类"把网页端能力接到本地干活"的工具:额度是固定水池,工具决定每一滴水能干多少活。
开源之后 issue 和 PR 涌进来,也印证了"省额度"是刚需中的刚需。但边界要看清:把网页端当编程接口用,最终取决于平台规则——作者的原话也只是"让 Plus 用户更好用额度",能省下的是功夫,不是条款。
星数与玩法按作者记述,平台规则以官方为准。
TypeSafe 放了个 skill 包:typesafe-ai/skills——给自家 System One(判断型小模型那条线)用的 Skill 集,丢进 Codex 或 Cursor,就能让 agent 用上"带类型的 decide / tool / evaluate 循环",目前 440 星。
"带类型"是它的差异点。普通 prompt 循环里,判断结果是一段自由文本,能不能解析全靠运气;这个包把 decide(判断)、tool(调用)、evaluate(评估)三步约定成有类型的输入输出——agent 每一步的产出都是可校验的结构,错了当场就能拦住,而不是等到跑完才发现哪步歪了。
我的看法:这也是 TypeSafe 今天第三次出现(官方性能数字、SQL 函数、再到这个 skill 包),套路是一贯的——不卖模型,卖接线规范:把 System One 的能力用 Skill、SQL 这种现成入口塞进别人的工具链里(Codex、Cursor、数据库)。
对使用者来说好处直接:换入口不用改流程;对生态来说,"判断型小模型"的落地路径正在从"你会不会调 API"变成"有没有现成的插槽"。
仓库:github.com/typesafe-ai/sk… 星,可直接放进项目)
Codex 额度烧完了,只能等月度刷新或者续费——这是 Codex CLI 重度用户的高频痛点。bkdgiffug 推荐的 DevSpace 给了一条绕开这个瓶颈的思路。
DevSpace 是个 MCP Server,把本地项目"接给"网页端的 ChatGPT。三个比较实在的价值点:
Codex 重度用户把 DevSpace 当"备胎通道"接进来比较值;想自己接管 AI 编程工作流的团队,这个 MIT 协议的开源项目(github.com/Waishnav/devsp… )也值得参考。
GitHub 上 1.2 万 star 的 OpenCreator(前身 KrillinAI),把"做一条带外语配音的视频"这条工作流完整收进了同一个工作台。
具体看里面塞了多少东西——10 个工具:视频翻译、智能配音、封面图生成、图像生成、文章撰写、小红书文案、短视频脚本。自动剪辑和数字人功能还在做。底层用 Codex CLI 当执行引擎,仓库里备了一批可复用的"技能指令"。
几个具体能力点:
这件事最值得展开的不是"又一个开源项目"——而是对内容运营 / MCN / 自媒体团队的实际意义。
过去做一条带外语配音的视频需要 4–5 个工具:扒字幕 → 翻译 → 配音合成 → 剪辑对轴 → 素材在不同软件之间来回导。错一步就从头来。OpenCreator 这种"一站式"工具栈把这件事压成单工作台操作,对个人创作者和小型 MCN 是真正的提效。
具体的几个 actionable:
对国内 AI 工具市场的更深判断:
"一站式工作台"正在替代"零散工具集合"——过去几年内容工具市场是"一个一个装"的格局,每个工具做一件事。现在 AI 让"一个工作台覆盖全流程"成为可能,对小团队来说,工具选择的复杂度在下降。
Codex CLI / Claude Code 这种"AI 执行器"会成为下一代工具栈的核心引擎——OpenCreator 用 Codex CLI 不是偶然,未来 12 个月会有越来越多国产 AI 工具把 Codex / Claude Code 当对话式后端。这意味着:
OpenCreator 的 GitHub 仓库(github.com/krillinai/Open… / 自媒体团队 clone 下来跑一遍。它不只是一个工具,是一个"内容生产工作台"的完整范式——这种范式接下来会成为内容运营基础设施的标准形态。
huoshan007 这条把 Codex 用户最常见的"冤枉钱"点出来了——
> "Codex 最冤的 Token,不是写代码烧掉的。是天天拿它干分类这种粗活。"
按他自己跑的数据,接 Jev 之后省了 93% Token。装的命令也直接给了:npx skills add typesafe-ai/skills --skill typesafe-ai
这件事的本质是"用博士工资请人分快递"——Codex 这种旗舰模型的 token 单价摆在那儿,但它真正擅长的是长推理、写代码、debug、复杂 agent 编排;拿它去做"这条消息要不要回复、这个 issue 该分给谁、这条命令有没有风险"这种纯分类任务,是明显的资源错配。
为什么这种"资源错配"在 AI 编程时代特别常见:
codex 起手,用户什么任务都往里塞;几种典型的"Codex 冤大头调用":
实操建议:
npx skills add typesafe-ai/skills --skill typesafe-ai,Codex CLI 直接多一个 Jev 路由层;这件事对国内做 AI 编程工具的团队信号很清晰:"主模型 + 专用轻量模型"的协作架构是下一步必走的方向——单模型时代过去了,多模型组合才是常态。
huoshan007 这条值得收藏——不是因为他发现了什么新东西,是因为他用一个具体的命令和数字(93% Token 节省)告诉所有 Codex 用户:你花在"分快递"上的钱,完全可以省下来。
shownotover 这条是"反向吐槽"——"codex 用户!bug 找到了!我是 Plus 档,我有 GPT-6 Astra,但我真的没有 5 小时限额!hahahaha!!!"
这条跟 5 小时限额的吐槽形成一组对照:Plus 档有豁免,普通档被卡死。
Codex 当前模型的实际限流情况:
也就是说,Plus 用户的"我没被限"是设计如此,不是 bug。作者这条的"hahaha"口吻是开心的调侃,但容易让免费档用户产生误解。
为什么 OpenAI 这边这么设计:
几个绕开限流的实操经验:
一句话总结:"Plus 档没限流"不是 bug 是设计——但官方文档这事写得不够清楚,导致 Plus 用户和 API 用户天天在同个池子里吵。
thisiscsim 这条是个人物动态——开发者社区挺活跃的 CSIM 正式加入 OpenAI Codex 团队。原推很短:"今天是大日子,很兴奋加入 @OpenAI 去做 Codex。"
单看这条信息量不大,但结合最近 Codex 的产品节奏值得拆一下:
CSIM 是谁:之前做 IDE / 编辑器侧的开发体验工作,对"工具栏怎么摆、快捷键怎么绑、状态栏给不给提示"这类问题有第一手感。Codex 这边一直缺的就是"IDE-native 体验做得更深"。
Codex 现在缺什么:上一轮 OpenAI 把 Codex CLI 推上主舞台,但 IDE 集成(VSCode 插件、JetBrains 插件)的体验跟 Cursor、Claude Code 比还是有差距。CSIM 这类"传统 IDE 体验工程师"的加入,对补齐这一块短板是直接利好。
对国内开发者的两个信号:
短期期待:
对国内使用者的影响:
Codex 这一系列改进如果落地,国内通过 API / 代理使用的体验会跟着变好——比如更稳定的本地 session、跨编辑器的工作流。能薅到的早鸟福利大概率是"新功能灰度期"。
一句话总结:人物动态是表象,Codex 的产品节奏在加速——这条新闻真正告诉你的不是"CSIM 去了 OpenAI",而是"OpenAI 还想在 AI 编程工具赛道里再拼一把"。
LDT0545 这条有意思:他和 Tibo 两个人在 Codex 这边官宣"reset Tuesday 3 am",把 CLI 的强制重启放到美东时间凌晨三点。
引用 Tibo 那条 "3am on a tuesday" 才是原汁原味的吐槽——这不是产品决策,是开发者给同事打招呼的口气:"这周我们要在你们最不警醒的时候把你踢下线"。
Codex CLI 这种"凌晨静默重启"的做法在这两年的开发工具里其实不罕见:
对实际开发者的影响:
工具迭代节奏越来越快,能理解这种"统一窗口更新"的考虑,但作为用户还是希望:要么有"我下个空闲再装"的开关,要么恢复流程能更智能一点。
一条实用更新:Codex 开了个实验性功能,把"上下文压缩"换成了笔记 + 可搜索历史。
原来的问题是:历史被反复压成摘要,任务越跑越长,摘要也被压了一遍又一遍,前面的细节可能就丢了。
现在的做法:Astra 可以跨上下文窗口保留笔记;需要细节时,回去搜索同一任务里之前的消息和工具结果 —— "前面试过什么、为什么改这段代码、工具返回了什么"都有机会找回来。
怎么开:在 ~/.codex/config.toml 里加上
[features.context_management]
experimental_mode = true保存后新建任务生效。限制:实验功能,需要支持的客户端 + 符合条件的 ChatGPT 订阅登录,API Key 暂不支持。原帖说"有网友实测开启后额度消耗大幅减少"。
一点判断:它换掉的是上下文管理的范式 —— 从有损压缩(摘要,代价不可逆:你事前不知道哪句话会被丢)变成保留索引 + 按需检索(压缩了,但能回查)。对长任务来说,这比"省额度"更值得留意。
提醒:"额度大幅减少"是转述网友体感,没有量化数字;它也是实验特性,随时可能变。
让 Codex 做出"好看的页面",最烦的就是你得反复说一句"再好看点"。@Voxyz_ai 给了三个设计类 Skill,正好对着这个场景。
1. Impeccable —— 页面建好了,但感觉哪里不对的时候用。 太平淡就给 bolder,太拥挤就给 distill,基本成形了用 polish 细修。它真正做的事,是把你那句"make it look better"翻译成具体、可执行的设计改动——而这恰恰是模型最缺的东西:它不知道"更好"指的是排版、间距还是配色。入口是 impeccable.style。
2. 21st Design —— 动手前先找参照。 让 Codex 在开工前先去 21st.dev 挑组件和交互参考,而不是凭印象造轮子。作者给的建议比 Skill 本身更值钱:把你自己常用的一套组件库打包成一个 Skill,不必非用他那个站;重点放在真正撑起页面的一两个区块——首屏 hero、一组定价卡、一段产品展示,挑合适的,再按品牌、内容和现有项目改造。
3. UX Audit —— 光截图好看不算数。 让 Codex 真的打开浏览器用一遍页面:点按钮、填表单、切到移动端视口、把完整用户路径走到底,找出"点了没反应的按钮""看不懂的报错""下一步不清楚"的问题,并给出复现步骤和具体修法。
连 Skill 都懒得配的最小做法,他也给了:在任务末尾加一行——"做出提升 UX、DX 和 AX 的最佳决定,且不破坏现有功能。"让它同时权衡用户体验、开发者体验,以及下一个接手的 Agent 能不能顺利用上。
我的看法是,这三个 Skill 其实对应设计流程的三个环节:定质量标准(Impeccable)、找参照(21st Design)、做验收(UX Audit)。举个例子:你反复说"再好看点",模型大概率只会换个配色;有了 Impeccable,它会先判断是太空还是太挤,再决定是加强对比还是精简内容——这就是"把感觉翻译成操作"。
最值得琢磨的是第三个——让 Agent 用浏览器当验收员,等于把"好不好"从主观感觉变成可重复的动作清单,跑一遍就能报出问题和修法。这也是我认为 Skill 真正的价值方向:不是替你写代码,而是把"什么算好"固化下来,让每次生成都有同一把尺子。
边界:这三个是作者个人在用的 Skill,我按推文描述写、没有实测;两个入口站的可用性和 Skill 的实现质量得自己试;UX Audit 的效果尤其取决于浏览器自动化能不能跑通。
入口:impeccable.style 与 21st.dev
作者说他刚意识到一件事:Codex 的插件生态,比两个月前膨胀到"语言无法形容"的程度 —— 他想用的第三方工具,Codex 基本都集成了。
他把看到的按用途分了四类:
清单长到他自己也说"根本看不完"。他给的办法不是一个个翻,而是让 Codex 自己推荐:列出有哪些插件、哪几个对你可能有用,确认后再装。
另外他提了两个细节:打开"计算机历史"功能;想在 Codex 里调用 ChatGPT Pro 网页版能力,可以用他写的插件。
我的看法:生态大不等于好用
三个坑值得先想清楚。一是权限:插件越多,"谁能碰你的文件、账号"越难看清,装之前逐个确认为好。二是集成的厚度:很多集成只是一层薄包装,对方 API 一改就断。三是清单的主观性:这是他的工具箱,不是你的 —— 支付类插件对多数人就是噪音。
那条提示词倒是可以直接抄:让 Codex 按你的实际使用习惯挑,你确认后再装。这比照着别人的清单全装一遍省事,也少踩权限的坑。
两句提醒
最后那个插件是他自己写的,属于自荐,用不用自己判断。另外清单里不少是付费服务,装了插件不等于有额度。
插件仓库在这儿:
github.com/mcncarl/yichen…
腾讯团队把内部用了半年的TeamAI CLI开源了,这个项目解决了一个很实际的问题:团队里最会用AI的那个人,他的经验怎么让其他人也能用上?
TeamAI CLI的核心思路是用Git仓库作为唯一事实来源,把团队统一的Skills、Rules、Hooks、MCP配置和经验知识,同步到每个成员本地的Claude Code、Codex、Cursor、Qoder、CodeBuddy等十余种AI编码工具中。一次配置,全员生效,而且不绑定任何单一AI工具。
它要解决三个痛点:
三层产品架构层层递进:
第一层Team Execution——统一分发。Git仓库是唯一事实来源,管理员维护配置,经push→MR评审→合并后,由SessionStart hook自动pull到每位成员本地的AI工具。分发可按角色、标签精细过滤,还能订阅其他团队的公共仓库。
第二层Team Context——团队记忆。写入侧靠摩擦信号过滤:只有你打断过AI、拒绝过工具调用、或AI反复重试失败的会话,才会提示总结成经验推送到团队仓库。读出侧是teamai recall:任务开始前由子代理自动检索团队知识,零外部数据库依赖。
第三层Team Improvement——飞轮闭环。digest团队周报(token用量、干预率)+dashboard Web看板,配合recall promote(高价值经验晋升为正式skill)和recall maintenance(清理过时条目),让每一次执行都沉淀为团队能力。
这个项目代表了2026年AI工具生态的一个清晰趋势:竞争正在从单个Agent的能力,转向团队级Harness和记忆系统的标准化。对于5人以上、多工具混用、且已认真在生产环境使用AI Coding的团队,这是一个值得现在就试的项目。
GitHub: github.com/Tencent/teamai…
GPT-6 Astra上线后,很多Codex用户的第一反应是:赶紧加更多规则、更多Skill、更多指令。但OpenAI官方已经明确说了——Astra对指令的敏感度远超前代。这意味着你AGENTS.md里每一个过时的workaround、每一个宽泛的触发条件、每一个重复的安全检查,都在悄悄消耗你的token配额,甚至让模型行为变得不可预测。
这就是所谓的「指令债务」(Instruction Debt)。
什么是指令债务?
简单说,就是你在项目里积累的那些「当时有用但现在过时」的指令。比如:
在Astra之前,这些冗余指令顶多浪费一些token。但在Astra时代,它们会获得更大的「权力权重」,直接影响模型的决策路径。
如何做指令债务审计?
第一步:绘制你的指令地图
把所有指令来源列出来:
→ 全局指令 + 项目指令
→ AGENTS.md + Agent定义
→ Skill触发器 + 关联引用
→ 权限规则 + 完成标准
→ 哪些始终加载 vs 按需加载
第二步:压力测试
用以下场景测试你的指令集:
→ 修一个typo
→ 执行一次数据库迁移
→ 做一次UI审查
→ 修复一个失败的测试
→ 批准一次部署
如果一个简单的typo修改触发了和数据库迁移一样多的指令检查,说明你的指令集有严重的冗余问题。
第三步:精确修复
对每个问题要求:
→ 具体文件 + 具体位置
→ 问题证据
→ 失败模式
→ 最小安全差异
→ 保留有用的约束
进阶技巧:设置自动化清理
有经验的用户已经在Codex里设置了定时任务,让Astra每天凌晨自动审计和清理自己的指令集:
「创建一个凌晨2点的自动化任务,审计我的AGENTS.md和本地维护的Skills。识别不必要的读取、宽泛的触发器、冗余的检查和冲突的指令。应用最小修复,保留安全边界和必要测试,备份原始文件并验证更改。排除供应商管理的文件。跳过未更改的文件。仅在有实质性更改或阻塞时通知我。」
核心原则:
在给Astra添加下一条规则之前,先让它审计一遍你现有的指令集。你会发现,减法往往比加法更有效。
Claude Code写到一半想换Codex,项目怎么做的、哪些办法试过没用、接下来还有什么,又得重新讲一遍。
发现一个开源项目ai-memory,会把这些内容整理成Git管理的Markdown Wiki,让Claude Code、Codex、Cursor等20+AI编程工具共用项目记忆,不过不同客户端的接入方式不完全一样。
可以自托管在本机、Homelab或VPS;远程访问记得配置认证和HTTPS。不接云端模型也能记录和搜索。
ai-memory的核心思路是:用Git管理的Markdown Wiki,让多个AI编程工具共用项目记忆。
ai-memory的核心能力:
ai-memory的价值:
使用场景:
ai-memory的启示:
对于想做代码开发的同学来说,这个项目值得研究一下。