AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
我不是小布丁 ·
ASCII 生成器挂上了 MCP 服务器。从此在聊天窗口里就能要一幅字符画,渲染走的还是编辑器同款引擎,这上新我看完就乐了,乐得想立刻接进来试一把再说。 尴尬是这么来的,过去想在对话里让智能体画个字符画。得到的多半是一堆参差不齐的文本。字符画这玩意对对齐敏感得很,差一格就垮,垮掉的字符画还不如不画。 盯 MCP 扩张的理由很简单,它正在变成应用商店的雏形。雏形阶段的特征是啥都能往里塞,塞得进来的有正经工具也有字符画这种玩具。玩具进生态不是坏事,坏事的生态才只有严肃工具。 两条地址收好。服务器的说明页在 ascii-magic.com/mcp-server ,效果演示在 twitter.com/kail_designs/s… ,先看演示再决定接不接,接完的回来告诉我渲染稳不稳,稳的点赞,句号。
显示更多 话题来源 @kail_designs 23.3K阅读 ❤️767
MCP Server, ASCII Magic for AI Agents Connect ASCII Magic to Claude, Cursor or any MCP client. One URL, no API key. ascii-magic.com
我不是小布丁 ·
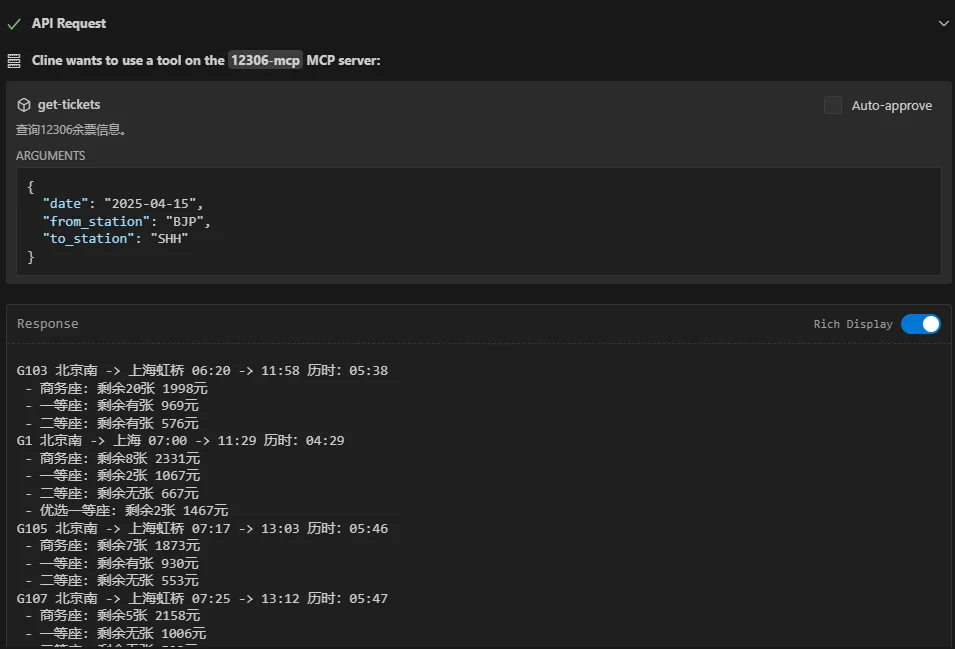
一句话把余票查明白这事被做出来了。演示里那句是问北京到上海 G103 的余票,商务座剩二十张一等剩九张,票价跟着一起出,官方应用里这点信息要点四五下。问一句北京到上海的车次商务座还剩多少一等剩多少。票价座位一次列全。这体验我看完就把官方应用冷落了三天。 官方应用的查票流程是层层套娃,选车次点进去看席别。席别点开看余票。余票刷新完再看票价,三步下来手指点得发酸。酸的手指是交互设计的隐形税,隐形税人人再交没人喊疼。 敢冷落三天的底气是它没掉过链子,掉链子的查询工具我不敢卸载应用。不敢卸的原因是查错了耽误的是真金白银的车票。车票买错改签退票三连折腾的下午我有过。 演示图在这。twitter.com/ai_fengshou/st… ,看完回来告诉我你那趟常坐的车还剩几张,对得上的点赞,句号。
显示更多 话题来源 @ai_fengshou 81.4K阅读 ❤️279
丰收 (@ai_fengshou) on X 逆天了,12306 查票被 AI 降维打击了 一句话问北京到上海 G103 商务座剩20张,一等剩9张 票价全列出来了 12306 App 得点好几下才看全 我觉得查余票不用再开 App 了 X (formerly Twitter)
小白爱摸鱼 ·
github.com/wibus-wee/huih… 要动每家 agent,先得把它们的会话格式挨个研究一遍、解析一波,这个活如今有了个专门的库来干,叫汇话(Huihua)。 做法摆开。它只干读取这一件事,尽可能保留原始数据与差异,把怎么用交给上层定;不替你做决定,只把各家散着的记录收进同一个门里,开源社区里的分析和思路也都被它借了进来。 "只读、不动、差异留着"这半句是全场重心。前面一个脑子四家共用讲的是把记忆挪到中间,这条讲的是先把各家的记录读得进来。跟前面记忆按 agent 切呼应,那条是各家各记各的,这条是把各家的账各自认全,两头都卡在格式这一层。跟前面把模型变成 agent 那四件也接得上,四件之外还有一件没写进清单的,就是这些记录本身。 会话格式这种东西最怕各家改主意,我留心的是它"保留差异"这一手,宁可多留也不替你抹平,这比直接转成一种格式稳妥。 我留的疑问有三处。支持到哪几家的格式没列;增量读取做不做没说;大文件的性能也没交代。 这周把自己机器上几家 agent 的会话导进去,看它认出来的字段和原始文件对不对得上。
显示更多 话题来源 @wibus_wee 7.7K阅读 ❤️67
GitHub - wibus-wee/huihua: One API for Coding Agent session data. One API for Coding Agent session data. Contribute to wibus-wee/huihua development by creating an account on GitHub. GitHub
我不是小布丁 ·
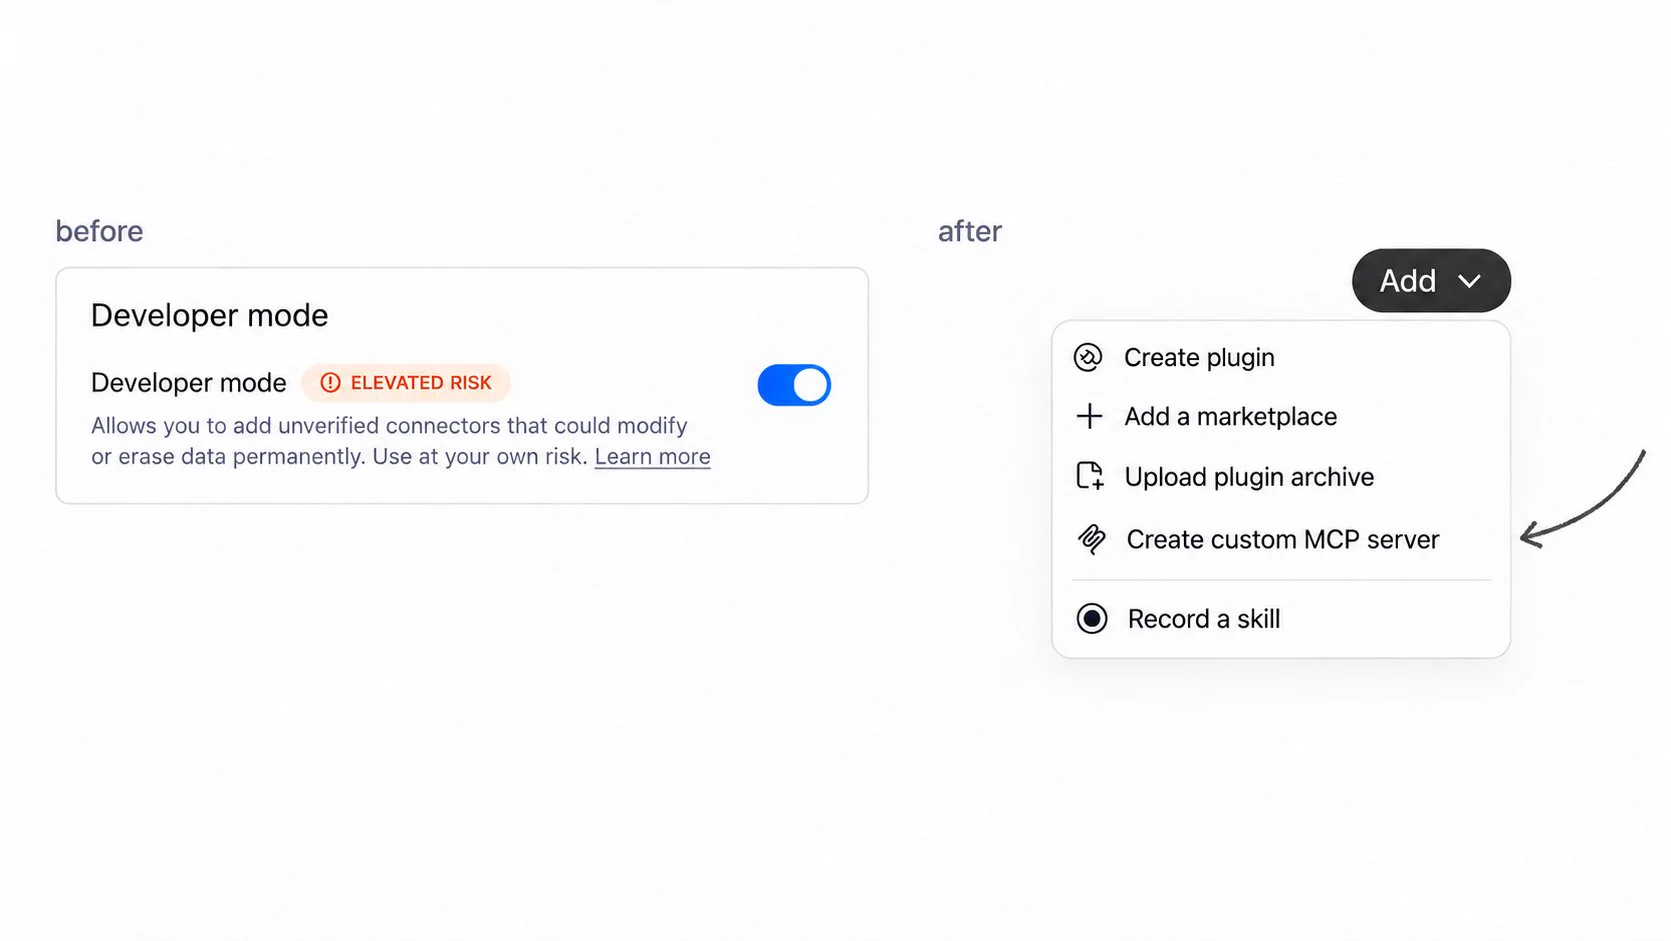
ChatGPT 撤掉了一个开关,接自定义 MCP 服务器从此不用再开开发者模式。 路径摆开。插件、添加、创建自定义 MCP 服务器,三步点进去就能连,所有用户都能走这条路,不再靠那个开发者模式顶着。原句也留一句,"we removed a toggle from chatgpt!",后面跟的那句玩笑是,不是你们想的那个。 "开关撤了、路对所有人开"这半句是全场重心。前面开箱就带搜索讲的是把搜索做成默认的那层,这条讲的是把接入做成人人有份的那步。跟前面给工具上户口呼应,那条登记的是工具,这条登的是接口,两头都在把门槛往下挪。跟前面十副骨架当训练场也接得上,接进来的人越多,能被当环境用的场子越密。 连 MCP 这件事从极客那头挪到普通用户这头,我留意的是这个动作的节奏,开关一撤,后面就是接口的用量。 我留的疑问有三处。自定义服务器的调用额度怎么算没说;安全审查在哪一步没交代;撤掉开关后出问题找谁也没写。 这周拿一个自己常用的 MCP 服务连上去,数从进插件到跑通第几下,和开发者模式那版比差在哪。
显示更多 话题来源 @mxstbr 62.2K阅读 ❤️935
Max Stoiber (@mxstbr) on X we removed a toggle from chatgpt! no, not that one. but, you no longer need to toggle developer mode to connect custom MCP servers! all users can now just go to plugins → add → create custom MCP s X (formerly Twitter)
我不是小布丁 ·
OpenAI 把内容溯源的手伸向了文本,公告两张连发,这操作我服它的坦诚。一边应监管一边摆技术斤两,摆的清单在下面一层层剥,剥好了看时间表。这公告我读完先服坦诚再服分寸,服的点在下面一层层摆。摆好了看第一刀。第一刀切的是时间表,时间表在下面摆着,摆好了自己对。 时间表三段切开。未来几周内欧盟的 ChatGPT 和 Codex 先上文本水印。合规的依据是那部人工智能法案,法案压下来的期限谁都不敢拖。拖的代价是罚款和下架两顶帽子,两顶都戴不起。第二段是接口客户今天起就能全球打开这个开关,选择权先给付费的那批人。 技术的切法是统计信号。生成的时候往文本里埋一个看不见的统计印记,埋的过程不加可见标记也不加特殊字符。读的人完全无感,检测器再去文本里找那个印记。找到了就回答一个问题。这段话很可能是哪个家的模型生成的,答案的粗细就到这为止,这句是全篇最值得划线的地方。 四个不摆开。不说原始作者是谁,不说版权归谁,不识别任何人任何组织任何账号。不识别对话也不识别提示词,四不的清单念完这水印就从老大哥的形象变回了工具形象。工具形象的水印才配被接受,老大哥形象的水印会在第一天就被各路高手围剿,围剿的技术今年满天飞。 一句话带走,文本水印先落欧盟后走全球、只答生成不答作者、测试无损,三句转给做内容合规的朋友,句号。
显示更多 话题来源 @OpenAI 210.5W阅读 ❤️5902
OpenAI (@OpenAI) on X We're expanding our approach to content provenance to include text in response to EU regulatory requirements, while recognizing the significant limitations of current text watermarking technology. Ou X (formerly Twitter)
自由翻滚的风铃草 ·

DeepSeek Harness 的崔添翼十月四日回应了兼容争议,三句话摆开,这是 AI Agent 那边的原话转述。

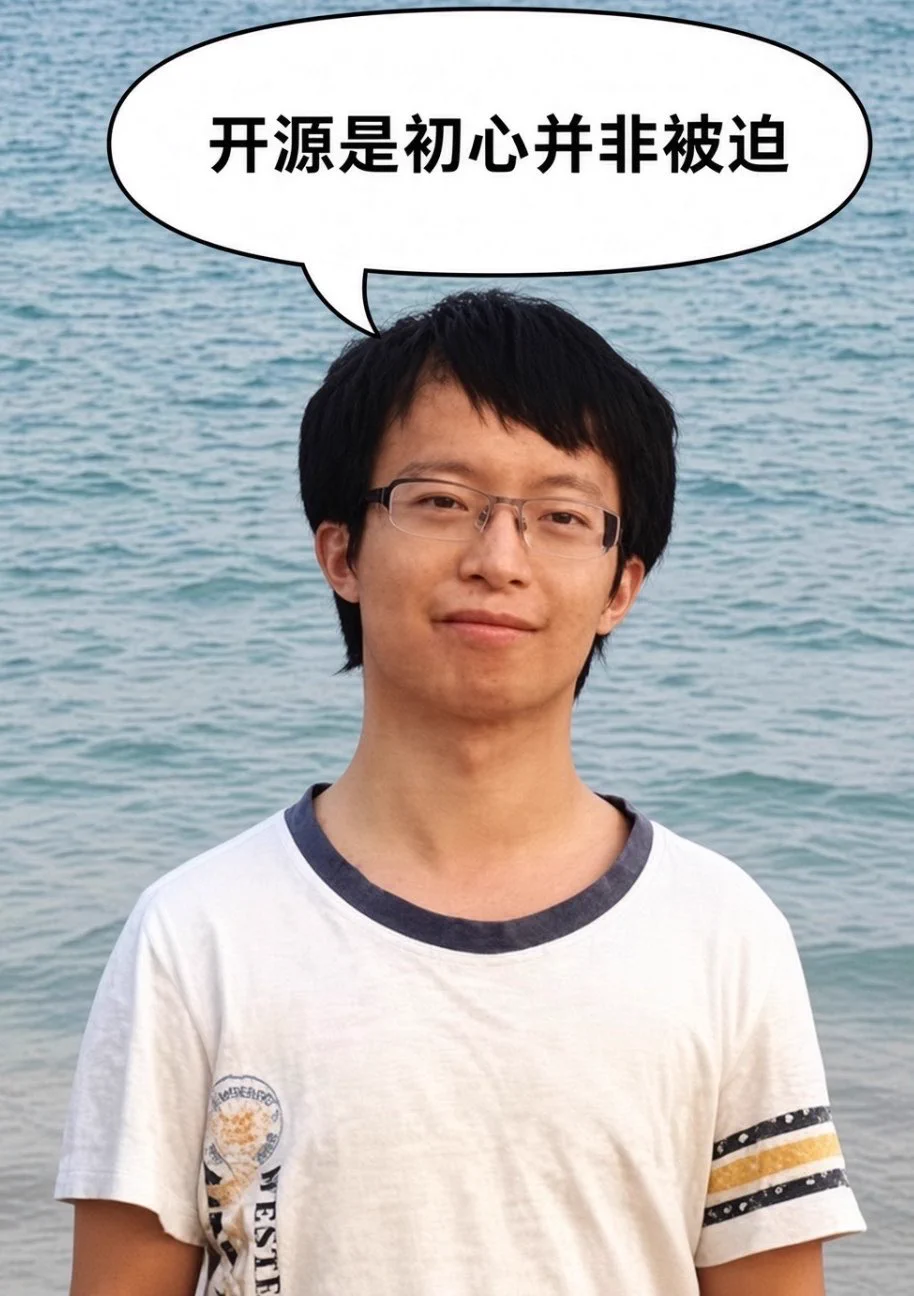
第一句的意思是,插件化这条路线不是后来补的,立项和写第一行代码之前就拍过板;开源同理,那是公司成立、第一个模型发出来之前就定下的方向,谈不上被迫,也谈不上照谁的样。第二句讲现状,Claude Code Mods 那层兼容眼下只是 alpha 实验,为的是验证它的扩展能力够不够 DSH 架构的子集,全无缝还做不到,若值得投入,技术上未来有望。

第三句给的是进度,桌面端已能免命令行装插件,输入包名即装,约六成用户在用第三方货,官方插件市场仍在搭。

引帖那条补了版本细节。DSH 更新到 v0.2.1-alpha.1,兼容层先验证能力是不是 DSH 插件的子集;插件页新增"让 Agent 创建插件",进创造模式会留草稿,发出去才执行;自动化任务内置到 Web,仍是 alpha,部分插件接口有破坏性变更。

"插件才是架构、兼容只是验证"这半句是全场重心。前面把模型变成 agent 那四件讲的是骨架的定义,这条讲的是一条自家的骨架怎么把定义落成插件。跟前面四千行拆开重装呼应,那条读一家的实现,这条看一家的走向,两头都在往深里走。跟前面 dsh-ios 那条也接得上,插件长在哪边,哪边就是当下最忙的活。

"一切皆插件"这句摆的时间点我留意,写第一行代码前就定了,这跟事后补一个接口不是一回事,架构早给插件留了座。

我留的疑问有三处。官方插件市场何时建好没说;六成这个比例的样本怎么算没交代;兼容层全量无缝还差哪几块也没列。

这周拿一个第三方插件在桌面端走一遍免命令行那条路,数它装完到跑通花了几步。

显示更多 话题来源 @NFT_Chen 26.9K阅读 ❤️66
SuSu_酥酥👅 (@NFT_Chen) on X 🔥崔添翼放出经典名言:DeepSeek Harness的开源是初心,不是被迫! DeepSeek Harness负责人、Claude Code Mods 兼容层作者崔添翼 10 月 4 日回应新版本兼容争议,核心就三句: 1️⃣「一切皆插件」立项之初、写第一行代码前就定了;开源也是 DeepSeek 成立、发第一个模型之前就定的初心,不是被迫,更不是模仿别人做开放。 2️⃣现在的 Claud X (formerly Twitter)
我不是小布丁 ·
有人发现自家的 GPT-6.1 Sol 每天在后台默默干几个小时的活。问它在干嘛也说不上来。日子久了连盯着看的那份心气都没了,这体验我读完会心一笑。 无感长跑的第一层含义是它已经从工具变成了同事。工具是你打开它它才动,同事是你不在的时候它也在动。动着的后台任务每天占几个小时,几个小时里产出什么你未必关心。 失焦这件事两面看。好的一面是它把你从监工的岗位上解放了。监工是今年最亏的工种。盯一个后台任务盯到最后盯的是自己的焦虑。焦虑的监工比不盯还累,累完发现啥也没管住。 折中的姿势就一句,管结果不管过程。每天固定两个时间点看一眼它交了什么货,货不对就回滚,货对就放它继续跑。两个时间点的盯法把焦虑压到最低把风险也压到最低。 截图在这。twitter.com/mylifcc/status… ,先去看它那几个小时的流水,看完回来聊,句号。
显示更多 话题来源 @mylifcc 22K阅读 ❤️87
lifcc (@mylifcc) on X GPT-6.1sol无时无刻不在努力的干活,每天都干几个小时,我也不知道他在干嘛。。。。时间久了我的关注也会失去焦点。。。 X (formerly Twitter)
我不是小布丁 ·

GLM-5.5 的传闻汇总贴上了墙,规格价格参数全是社区拼图,官方一个字没认。这汇总我先分清哪些确认哪些是猜的,猜的那部分别当真。分清的表在下面一层层摆,摆好了看第一行。这汇总我读完先分清哪些是已确认哪些是猜的,分清的表在下面一层层摆。摆好了看第一行。第一行是最要紧的那句提醒,提醒是全部未官宣,未官宣的都当瓜吃。
先把确认和传闻拆开摆。确认过的只有一条,上一代的参数底子是七千五百三十亿。这条是明牌。明牌的数摆在这当参照,参照物的意义是让你自己掂量传闻的跨度有多大。跨度是从明牌直接蹦到万亿级,万亿这个数从社区嘴里吐出来轻飘飘,落到工程上是另一回事。
时间线那条是这么回事。开放权重那条反而最可信,延续的是 MIT 许可的老传统,背叛一次这招牌就砸了。JPMorgan 的分析师援引路透和 CGTN 的口径预测过一个发布窗口,窗口落在去年八月。

八月过去了货没到,跳票的窗口是最诚实的预测器。能力那条传言也摆出来,说它要压过 Mythos 5.1 和 GPT-6 Astra,社区说法而已,一个实测都还没出现。诚实在它把分析师的底裤都扒了,扒完的预测公信力打折,打折的预测再挂出来得加三个问号,问号加满才配叫传闻。
收尾那句留给还在等的人。等国产旗舰再上一个台阶的心情我懂,懂的方式是把期待拆成清单。清单上每一行都标好确认状态,状态清楚了期待就不焦虑了。不焦虑的等待最养人,养人的等待配上定期去看一眼官网的习惯,习惯养成的那天你就是第一批上车的。
官网在这,Z.ai ,传闻那几行的确认状态自己去核,核完回来告诉我哪条先应验,应验的点赞,句号。

显示更多 话题来源 @Priyannkaaaa 18.6K阅读 ❤️182
Z.ai - Advanced AI Chatbot & Agent powered by GLM-5.3-Flash Meet Z.ai, the AI assistant powered by GLM-5.3-Flash. Build websites, write code, handle long-horizon tasks, and get instant answers. Fast, smart, and reliable. Z.ai
小白爱摸鱼 ·
同一段收件箱、同一句提示词,两家并排跑,OpenHuman 把速度拉开了。原句是 "FOUND A KILLER. FASTER AND CHEAPER THAN BOTH"。 引帖那半交代了缘由。OpenClaw 一次搜索查询会开一整个浏览器,十分钟起步;OpenHuman 轻得多,内存和处理器都吃得少,结果也来得快。跑完之后它还多给两样东西,一是上下文窗口的实时用量,二是每一次会话各自花了多少钱。 "并排跑、账实时"这半句是全场重心。前面同一座铁塔四本账讲的是四个模型比一次,这条讲的是两个骨架比一次,比的位置往下挪了一层。跟前面把模型变成 agent 那四件呼应,那条给骨架下定义,这条把骨架的快慢和账单摆到台面上。跟前面中途换档缓存不断也接得上,一个管省,一个管看得见。 同一段收件箱这么跑最服人,输入完全一样,差多少就是差多少,这类实测比谁家自报的都硬。 我留的疑问有三处。两次跑的模型档位是否一致没说;"轻"具体省了几成内存没给数;十分钟那次是冷启动还是常态也没交代。 这周拿自己最常用的那条提示词,两边各跑三遍,记下中位耗时和单次开销,再决定把哪一家当默认。
显示更多 话题来源 @marcusyul 107.8K阅读 ❤️518
marcus (@marcusyul) on X FOUND A @NousResearch and @openclaw KILLER. FASTER AND CHEAPER THAN BOTH Saw this and had to test it myself: → Summarize my emails → The exact same prompt → Same inbox, same task Ran them side by s X (formerly Twitter)
我不是小布丁 ·

GitHub 上的科研技能被按六大类筛成了一份清单,十一仓库一文档。选品的人还留了句大实话。别一口气全搬,先认准自己卡在哪个环节,这提醒我服。服的点在下面一层层摆,摆好了看第一类。别一口气全搬,先认准自己卡在哪个环节。这清单我读完先服选品再服那句提醒。服的点在下面一层层摆。摆好了看第一类。第一类是全流程那条龙,一条龙的货在下面摆着,摆好了自己对号入座。
第一类两个仓库都是干重活的,那个头牌把从检索到终稿的四步整条链打包成了一个技能。四万多颗星的体量说明它是这个赛道的头牌,头牌的含金量在于链路全。链路全的工具不用你东拼西凑,凑出来的流程断在哪一环都难受,难受过的都懂那种卡在中间等下一步的滋味。

另一个叫 ARIS 主打睡后科研。机器学习实验挂机跑,人去睡觉醒来收结果。挂机这词放在科研里有种作弊的快感,快感的来源是把最耗人的等待外包给了机器。机器不睡觉不焦虑不刷手机。一觉起来数据躺在那等你挑。
第二类管的是科研最虚也最要命的环节,选题和创新点,一个是把博导带学生的经验做成技能包,从想法一路带到投稿。导师的经验能被复制这句听着就离谱。离谱到我愣了三秒才反应过来这正是技能化的意义。

意义是把带教从人身上剥下来变成可调用的流程,剥不下来的环节永远是稀缺品。稀缺的师徒制今年第一次遇到了对手,对手是一行安装命令。另一个换了个思路不直接给选题。逼你从顶会的成稿往回倒推选题动机。学的是找创新点的姿势而不是抄答案。授人以鱼和授人以渔的差别它分得很清。
第三类跨学科的两件套都是狠角色,一件覆盖生物化学医学材料四个方向,直接调用 PubChem、ChEMBL 这些专业数据库查化合物查靶点。用户规模已经奔着二十万去了。二十万这个数字在垂直技能里是现象级,现象级的原因是刚需。

刚需的科研工具从来不缺人用,缺的是做得顺手的。顺手的那件已经被装进二十万台电脑,装了就回不去,回不去的依赖才是真优势。另一件扎在社会科学实证里,八个学科铺开、两万多个细分小技能。两万个细分说明它啃的是长尾,长尾的活最没人愿意干。没人干的活被技能啃下来就是功德,功德一件件攒着。
第五类写作排版两个。一个专门对齐顶刊的学术表达和绘图规范,对齐这个词用得妙。妙在投稿被拒十次有八次是格式和表达不合规矩。规矩这东西写在作者指南里没人逐条背,背不下来的交给技能去对,对完的稿子至少输在起跑线上这件事不会发生。

另一个专攻机器学习和计算机视觉方向的论文写作,方向垂直的写作工具比通用的管用,管用在它懂行话和行规。第六类是可信科研助手,一个开源研究工程技能库按官方最佳实践做,另一个用企业级深度调研流程分八个阶段核查信源。
我的提醒就一句,照清单的建议来,别贪多,卡选题装选题的,卡写作装写作的,卡数据装数据的。一次装一个用顺了再加下一个,装十个不如把一个用透,用透的技能才是你的。装着不用的都是电子收藏,收藏夹的坟场今年格外热闹,热闹的都去看看自己那十一个标签页,看完回来点赞,句号。
六类地址汇总,全流程一条龙 github.com/Imbad0202/acad… 和 github.com/wanshuiyin/Aut… ,选题创新 github.com/HKUSTDial/Supe… 和 github.com/WUBING2023/Pap… ,跨学科 github.com/K-Dense-AI/cla… 和 github.com/brycewang-stan… ,绘图 github.com/dongzhuoyao/ac… 。
写作排版 github.com/Yuan1z0825/nat… 和 github.com/jin-s13/ai-res… ,可信助手 github.com/Orchestra-Rese… 和 github.com/ravmike/deep-r… ,一次装一个,用顺了回来报到,句号。

显示更多 话题来源 @Fred834567 26.1K阅读 ❤️435
GitHub - Imbad0202/academic-research-skills: Academic Research Skills for Claude Code: research → write → review → revis Academic Research Skills for Claude Code: research → write → review → revise → finalize - Imbad0202/academic-research-skills GitHub
我不是小布丁 ·
有人给今年最舒服的一种工作模式起了个名字,叫本地的手。脑子在云上跑。手伸到你本机的文件里干活,这名字我读完就拍大腿。拍的原因是它一句话戳中了 hybrid 架构的精髓,精髓在下面一层层剥。 分工的妙处在云和本地各归其位,云端那颗脑子负责想。本机的文件负责被想。想和摸隔着屏幕握手,握手的姿势是模型在远端推理。动作落到你桌面的目录里。落下的每一步都在你自己眼皮底下。 我的判断是这名字会流行。会流行的原因是它把两种焦虑一次解决了。第一种是云端模型碰不到本地文件的无力感。第二种是把文件全上传的不安全感,两头都堵上的讲法才值得推广。 一句话总结。脑子在云上,文件在原地,动作落本地,这个组合今年值得押,押完回来点赞,句号。
显示更多 话题来源 @trq212 34.1K阅读 ❤️466
Thariq (@trq212) on X my favorite name for this pattern is "local hands", Claude runs in the cloud but can access your files locally- also coming to cowork X (formerly Twitter)
自由翻滚的风铃草 ·
huggingface.co/spaces/FineEnv… Claude Code、Codex、Hermes、Pi、OpenCode 这些骨架,如今能直接当训练场用,骨架一行不改,训练代码也不改,开源模型和任务集随便换,全开源。 成绩先摆。同一个模型同一套权重,在 Mini-SWE-Agent 下跑出六成二,在 Claude Code 下只有三成三。差距正在于训练那头通常得把骨架重实现一遍,于是多数模型练在一副谁也没发布的架子上。 办法是代理,不是重写。骨架以为自己在连模型接口,其实连的是一个捕获代理。它认得编码 agent 常用的四种格式,OpenAI 的聊天补全与响应、Anthropic 的消息、Gemini 的那套,都收。它转给 vLLM,把采样到的词元编号与对数概率原样记下,再交出序列供 TRL 训练。骨架就此变成了环境,今天有十副骨架从这儿过,一副没改。 奖励这一手也摆开。给"用更少工具调用解题"加一点小奖励,已经解得出来的那些任务上,模型的调用次数少了三成一副,四副骨架都如此,Codex 那副少了一半。 四组对照照录。拿 LFM2.5-2.6B 来练,只在一副骨架里练,主要是那副变好,从三成四到五成八;四副一起练,四副全变好,从四成二到五成四;换成监督微调(SFT),拿三千一百八十九条轨迹喂,停在四成七半,两轮强化学习都比它高。捕获代理在 OpenEnv,训练器在 TRL,任务、监督数据、训练代码和七个练好的模型全放出,上面那个链接是完整指南。 "骨架就是环境,奖励由你定"这半句是全场重心。前面把模型变成 agent 那四件讲的是骨架长什么样,这条讲的是骨架还能当什么用。跟前面把你自己从瓶颈上移开呼应,那条把决定挪进系统,这条把系统本身挪进训练,两头都在往前挪一层。 奖励塑形改出来的那个数我单独记着,调用少三成一副,可骨架从没要求过这件事,这说明约束的自由度在训练者手里,不在骨架手里。 我留的疑问有三处。四种格式之外的骨架怎么接没说;捕获代理的开销占多少没给数;更大模型那批何时上线也没交代。 这周拿自己常用的那副骨架对上号,先跑单副那组,看它练完是不是只在自家变好。
显示更多 话题来源 @ClementDelangue 97.7K阅读 ❤️1656
The ultimate guide to multi-harness RL - a Hugging Face Space by FineEnvs Train open models with RL inside real agent harnesses huggingface.co
我不是小布丁 ·
开年第一天的官宣先给了个不用动手指的福利,DAY 1 先放了个大招。默认速度白涨五成。这速度我读了两遍确认是给整个生态的。给法在下面一层层摆。摆好了看第一层,第一层是它给谁涨的。 提速的两个主角是 GPT-6 Astra 和 GPT-6.1 Sol。涨的是默认速度约五成,注意是默认不是付费加速包。不用你点任何开关,两个小时内在所有产品上自己生效。自己生效这四个字是这次官宣最舒服的地方,舒服在它省掉了每一个用户的动作。 覆盖名单的钥匙是 Sign in With ChatGPT 这个统一登录,登录一次的账号在合作方那边也能吃到订阅的红利。名单里点得出名字的有开源编码工具 OpenCode,有研究助理 Pi,有编程代理 Amp。还有那家老牌的自主软件工坊 Devin,四家只是开头,后面还排着一串没念完的。 时间那句承诺也很妙。两小时内感受到,两小时这个窗口给得既自信又体贴。自信在优化已经压好了包就等推送,体贴在没有让你等到第二天。当天的糖当天发。发糖的节奏是运营的老手艺,手艺好的公司连利好都发得利落。 总结就一行,速度白涨五成、不用改任何东西、两小时内全网生效,三句话转给用得上的朋友,句号。
显示更多 话题来源 @thsottiaux 169.9W阅读 ❤️1.8万
Tibo (@thsottiaux) on X Day 1/ We have optimized the default speed to be ~50% faster across GPT-6 Astra and GPT-6.1 Sol through the subscription across all our products and partners using Sign in With ChatGPT (including Ope X (formerly Twitter)
我不是小布丁 ·
一副骨架把一个模型变成一个 agent,拆开看就是四件东西。 清单照录。一,系统提示。二,工具。三,agent 那个循环。四,跨模型的翻译层。博客那篇还带了一句,这四件你可以自己拥有,不必非用谁家现成的。 "翻译层"这一件我单独留意。前面换骨架不换集成讲的是换的时候怎么不丢,这条把要换的那层起了名字。四件里前三件各家都在讲,这一件才是真正决定"换哪家模型都还站得住"的地方。 框架本身是重点这半句是全场重心。前面四千行拆开重装那篇讲的是把一家的实现读薄,这条讲的是把骨架的定义说清。跟前面五步搭骨架呼应,那条给的是动作,这条给的是名词表,先把词对齐,后面的话才接得上。 四件摆齐之后我再看自己手上那套,缺口正是翻译层,工具和循环早就有,切换模型时每次都得重配。 我留的疑问有三处。四件的边界在哪儿切没细说;翻译层要覆盖多少家模型没列;博客里"拥有你自己的那副"具体怎么起步也没交代。 这周把自己那套的四件逐项对号,先记下哪一件还靠手工,下周就从那一件动刀。
显示更多 话题来源 @pidotdev 424K阅读 ❤️2633
Pi (@pidotdev) on X A harness turns a model into an agent. At it’s core it provides 4 things: - a system prompt - tools - an agentic loop - a translation layer across models New blog post from Earendil co-founder @co X (formerly Twitter)
小白爱摸鱼 ·
同一座埃菲尔铁塔,用 Three.js 建,四枚模型各跑一遍,账本摆开。 四本账照录。Opus 5.5 花八块九毛五、十分钟,前端和三维细节那部分最受认可;GPT-6 Astra 七块四毛五、八分钟;GPT-6 Sol 最快最便宜,三块九毛、五分钟,结果却最叫人失望;Kimi K3 四块零四分、六分钟,塔很扎实,价钱不到 Opus 的一半。 "最便宜那版最失望"这半句是全场重心。前面八小时一成三讲的是一套账怎么省,这条讲的是省下来的价钱换回了什么。跟前面摊开之后谁站最前呼应,那条是分数榜,这条是四个钱包同时打开,一个看谁强,一个看谁值。跟前面两枚进 Copilot 也接得上,货架上摆了四枚,挑的时候不再只看一头。 Kimi 那个数我单独记着,一半的价钱拿到扎实的塔,价差摆在明面上,往后再比就不能只报个名字。 我留的疑问有三处。四枚用的是不是同一段提示词没说;"最失望"具体差在哪几处没拆;十分钟里有多少是模型在等没交代。 这周挑一件自己熟的前端活,四枚各跑一版,记下时间与价钱,再看最后留下的那版是哪一枚。
显示更多 话题来源 @RoundtableSpace 53.5K阅读 ❤️105
0xMarioNawfal (@RoundtableSpace) on X Someone asked Opus 5.5, GPT-6 Astra, GPT-6 Sol and Kimi K3 to build the Eiffel Tower in Three.js, and Opus 5.5 came out on top for frontend and 3D detail at $8.95 and 10 minutes. → Opus 5.5 cost $8.9 X (formerly Twitter)
我不是小布丁 ·
一句配着鱿鱼游戏二创视频的金句火了。说一家人工智能公司如果垄断将是世界的灾难。金句我先按下不表,先看这视频是用什么家伙做出来的。 工具两件套很直白,视频模型用的是 Seedance 2.5,提示词全权交给 GPT-6 Astra 写。一个出画面一个出指令。出指令的那位负责把脑海里的分镜翻译成模型听得懂的话。翻译的水平决定成片的下限。 金句的杀伤力在于它用创作本身当论据。这组合用的是今年最能打的两个档位,出指令的负责想,出画面的负责演,分工干净得像双人舞。做视频的人手里握着最好的几个工具,越用越顺手顺到离不开。离不开的那一刻垄断就成立了,成立的垄断不是靠罚款是靠习惯。 视频在这。twitter.com/Xanderwow_A/st… ,先看片再回来聊,聊的地点在评论区,评论区见,句号。
显示更多 话题来源 @Xanderwow_A 290.4K阅读 ❤️3575
Xanderwow (@Xanderwow_A) on X “一家AI公司如果垄断,将是世界的灾难” 视频模型:Seedance2.5 提示词创作:GPT-6-Astra 参考视频:@KotteAnimation 鱿鱼游戏 猜猜这期都有哪些玩家?神秘面巾男是谁?? X (formerly Twitter)
我不是小布丁 ·
SpaceXAI 把 Grok 4.7 摞在了桌上。官方口径是他们迄今最强的编码和知识模型,同价不涨价。原文的感叹还是一贯的大写体,HOW IS SPACEXAI MOVING THIS FAST,这发布我数了三遍才数清里面塞了多少个数字,数字在下面一层层摆,摆好了看第一排。第一排是成绩单。成绩单的形状决定了这一代是升级还是换代,形状在下面摆着,摆好了自己看。 成绩单四个跳变摆开。CursorBench 从四十点四爬到四十六点三,DeepSWE 从六十五点二抬到七十一。两个跳变都不是小数点后的挣扎是整档的抬升。抬升的幅度放在迭代周期里算很凶。凶在它不是靠加参数堆出来的印象分,是实打实的任务通过率。通过率这东西掺不了水,水掺多了测试会说话。 安全那栏的数字是三点三。在 HackerBench 风险提示词的测试里只有百分之三点三漏了过去。这是他们迄今最安全的一代,安全和能力同时上台阶的场面今年少见。少见在通常安全是拿能力换的,换的交易做多了用户就麻木,麻木的代价是把护栏当摆设,摆设的护栏出事那天才知道疼。 价格三句念完。每百万词元输入两块输出六块,和上一代基础价一分没涨,快速版给两倍速度配两倍价格。三句念完的感想只有一句,更聪明更安全更快还没涨价。这组合放别家是要开发布会放烟花的。放烟花的钱他们省下来卷参数了。卷参数的收益全砸在能力上,砸出来的成绩是上面那四条跳变。 渠道三个,编辑器里、他们自家的构建工具里再加一个接口,三处现在都能调,调完回来告诉我自检那条是不是真的,是真的点赞,句号。 那两个被压的是 GPT 和 Fable 家的旗舰。
显示更多 话题来源 @RoundtableSpace 55.7K阅读 ❤️100
0xMarioNawfal (@RoundtableSpace) on X Grok 4.7 just dropped — SpaceXAI's most powerful coding and knowledge model yet. > CursorBench up from 40.4% to 46.3%, DeepSWE up from 65.2% to 71.0% > Better at verifying its own answers, longer con X (formerly Twitter)
自由翻滚的风铃草 ·
Opus 5.5 会话跑到一半换效率档,提示词缓存不断,前提是 Claude Code 升到 v2.1.280 或更新。 这半句值钱。换了档,前面那一大段上下文还在缓存里接着用,账上就省下一次整轮的重算;不换档,一整段历史要重新喂一遍,那才是大头。这条把"按任务挑档位"那件手工活,从得掂量一下变成随时可以按。 "中途换档、缓存不断"这半句是全场重心。前面四步别让它白烧 token 讲的是把规矩立在开跑之前,这条讲的是跑起来之后还能调。跟前面想得少一点答得准一点呼应,那边从模型那侧省,这条从档位这侧省,两头都在同一本账上。 版本号这个细节我单独留意,工具没升上来,说法就不成立,规矩里往往就差这一个数。 我留的疑问有三处。换档后那条缓存按什么粒度接没说;频繁换会不会反而引起重算没测;v2.1.280 之前哪一版开始坏的也没交代。 这周跑一件长活,中途从低档切到高档看它能否接着往下走,再看用量页上那一段是不是没重算。
显示更多 话题来源 @lydiahallie 210.7K阅读 ❤️5422
Lydia Hallie ✨ (@lydiahallie) on X Switching effort mid-session on Opus 5.5 doesn't break your prompt cache btw! Just make sure you're on Claude Code v2.1.280+ X (formerly Twitter)
我不是小布丁 ·

消费级智能体的战局汇总出来了,这是 GPT-6 系列老家的牌桌。主角是暂名 Codex Bot 的新品,DevDay 前夜的对位我看懂了。它要对位的是 SpaceXAI 旗下的 Grok Bot,不是模型打架是队友打架。

变了的赛道在下面一层层摆,摆好了先认识两边的货。它要对位的是 SpaceXAI 旗下的 Grok Bot,不是模型打架是队友打架,变了的赛道在下面一层层摆,摆好了先认识两边的货。两家的对位我看完就来精神了。

精神的原因是这次不是模型打架是队友打架。队友这个词一出赛道就变了,变了的赛道在下面一层层摆。摆好了看第一层,第一层先认识两边的货。
Grok Bot 是八月十一号亮相的老选手。产品形态说穿了是一组永远在线的 AI 队友,每个队友有自己的云端电脑,能登录你已经在用的各种工具。跨着应用把活干完。只在需要你点头的时候才来找你,这个设计我念完就服,服在它把打扰降到了最低,最低打扰的助手才配叫队友。

配叫队友的东西才有资格常驻,常驻的位置太值钱了。值钱到 Meta 九月八号也端出了自己的答案 Muse,一个个人 AI 助手。两家前后脚占位,占位的节奏快得像抢座位游戏。座位就那么几个,晚到的只能站着看,站着看的 OpenAI 这次不想站了。
追赶的路径有三步。第一步是挖人,OpenAI 从 Meta 手里把开源智能体框架 OpenClaw 的创始人挖了过来。挖来领导下一代个人智能体的研发,这步棋我给高分。高分在框架的原作者最懂自己造的船能开多快。

原作者上船船就快半拍。快半拍的船在起跑线上先探出半个身位。身位这东西差一点就是差一截。第二步是借力,新品基于那个开源框架 OpenClaw 开发。框架是现成的路,现成的路省的是铺路的时间。

铺路的时间省下来全砸在打磨上,打磨的功夫才是追兵的胜负手。第三步是赶时间,产品原本排在上周。
重磅博文的主张是让美国牵头制定前沿人工智能的全球技术标准,重点盯一个叫递归自我改进的路线。说人话就是这个叫 RSI 的路线说人话就是拿模型训下一代模型。一步步把人类从训练环里摘出去的技术路径,态度摆得很直白,这条路径在安全问题解决之前不该推进。

完全自主的版本目前压根没实现。压根没实现这六个字是给狂热者泼的冷水,冷水泼得及时。及时在内部数据已经显示这条路线的产出效率高得吓人。高到每个工作日的人力投入背后站着成倍的机器产出,产出效率越高越需要刹车片。
我的观察是这局棋今年最有看头的地方在时间线,八月队友亮相,九月助手跟上,开发者大会前追兵赶到。三个月里三家把消费级智能体的牌桌摆满了。摆满的牌桌洗牌才刺激。刺激在每张牌都不一样,一张是永远在线的云端队友,一张是带身份网络的个人助手。

还有一张是藏在编程工具里的老兵新传。三张牌对应三种性格。性格不同的产品最后会分化出不同的人群。分化的人群互不打架才怪,打架的战场分线上和线下。线上的战场拼模型拼工程,线下的战场拼场景拼习惯,习惯是最难攻的城墙。
战局的看点就这些,队友、助手、编程老兵三条线同时收口,收口的时间都挤在这周。这周过完牌桌就亮牌了,亮牌之前谁都别把话说死,说死的话回收不回来。回收不了的判断最尴尬,尴尬的我不说,说不尴尬的,不尴尬的就是这句,等发布会,看完回来聊,聊的地点在评论区,评论区见,句号。

显示更多 话题来源 @dotey 59.9K阅读 ❤️118
宝玉 (@dotey) on X OpenAI 的 “Grok Bot”(“Aeon”)即将发布。传闻称它将在 DevDay 之前发布,甚至可能就在本周。 GPT-6-Sol 仍预计明天(美国时间周二)发布,Anthropic 则可能在明天发布 Opus 5.5 和 Sonnet 5.5。据说没有 Claude 5.5 Haiku 和 GPT 6 Terra。 据 The Information 报道,OpenAI 正在赶造一 X (formerly Twitter)
我不是小布丁 ·
阿里的旗舰模型出了个高吞吐变体,挂在 OpenRouter 上线了。参数一点没缩水还是二百四十万亿那档,这上线我看完第一反应是吞吐这个词今年开始值钱了。值钱的原因在下面一层层摆,摆好了看第一层。 硬货清单五样摆开。一百万的上下文一口气装下整本手册,文本图像视频三种输入通吃。推理力度可以调,想要深想就拧大想要快答就拧小。工具调用和结构化输出这两样生产必备一样不缺,五样凑齐这个变体就不是玩具是干活的家伙。 我的判断是高吞吐变体的信号意义大于功能意义,功能上它和本体没差多少。信号在于厂商开始为同一批模型出不同形状的货,出货形状一多说明需求开始分层。分层的需求是市场成熟的标志,标志摆出来之前大家都在拿一个型号打天下。 地址在这。openrouter.ai/qwen/qwen3.8-m… ,参数和调用方式页面里都写着,写得比我细,细的部分自己读,读完回来告诉我吞吐对不对得起这个词,对得起的点赞,句号。

显示更多 话题来源 @OpenRouter 12.2K阅读 ❤️157
Qwen3.8 Max Prime - API Pricing & Providers Qwen3.8 Max Prime is a higher-throughput variant of Qwen3.8 Max from Alibaba's Qwen team, served as a separate SKU at a higher price point. $4 per million input tokens, $12 per million output tokens. openrouter.ai
小白爱摸鱼 ·
十个 Opus 5.5 agent 一起上,十五小时交出一份最短路算法的改进,还用 Lean 做了形式化验证,代号 C-HD。 拆开看这三件。其一,要的是比已发表界更好的界,不是跑个分。其二,证明那半用 Lean 写死,机器可核,不靠嘴。其三,十个 agent 并行而不是排队,时间才压得进十五小时。 "改进对得上已发表的界"这半句是全场重心。前面几条短提示十六个 PR 讲的是改代码那侧的验证,这条是改定理那侧的验证。跟前面二十三年没动的下界呼应,那边是攒了二十多年的难题,这边是一天半里往前挪了一格,两头都是在往界上使劲。跟前面把你自己从瓶颈上移开也接得上,一个把决定挪进系统,这个把证明交给机器核。 十这个数我留意,并行的 agent 得各领一块再合起来,怎么分工怎么去重,比单枪匹马那条路难在协作那层。 我留的疑问有三处。十个 agent 怎么分的工没说;C-HD 的提升幅度没给具体数;Lean 那套形式化的验证时长也没交代。 这周挑一道自己领域里界限分明的老问题,让几个 agent 分头试,看合出来的那版能不能过机器那一关。
显示更多 话题来源 @ValsAI 110.1W阅读 ❤️3216
Vals AI (@ValsAI) on X We asked ten Claude Opus 5.5 agents to devise a faster shortest-path algorithm and prove it in Lean. Within 15 hours, they produced C-HD: a formally verified improvement over the published bounds. X (formerly Twitter)
我不是小布丁 ·
八小时的 Opus 5.5 Max,只吃掉一百美元那档计划周限的一成三。 账合上了。 这句数字摆出来,等于把前面几篇的账合上了。官方那版说多数任务对齐 Fable 5.1、成本降四成;竞技场里它一千八百一十八分登顶网页开发;三道算术那篇算的是一次任务花多少,这条算的是整周能撑多久,三本账在同一版模型上碰头。 "整周能撑八小时"这半句是全场重心。前面四步别让它白烧 token 讲的是怎么省着用,这条讲的是省完之后余量还有多厚。跟前面想得少一点答得准一点呼应,那边从单步上砍,这条从整周上看,都是往同一侧使劲。 一成三这个数我也记着,按这个比例折,周限够连轴跑六十小时上下,重度那批人这下有了底气。 我留的疑问有三处。八小时里是对话多还是跑长任务多没说;一成三里有多少是缓存读省下的没拆;换成不限速档位还成不成立也没交代。 这周把自己那档的用量表打开,记一次整天的连跑,看实际吃掉几成。
显示更多 话题来源 @rezoundous 326.8K阅读 ❤️4539
Tyler (@rezoundous) on X 8 hours of Opus 5.5 Max for 13% of weekly limit on $100 plan. holy crap. X (formerly Twitter)
我不是小布丁 ·

一个用纯代码搓 3D 游戏的人补上了最后一块短板,这配置我服。整套工作流四件套摆出来,看完就记小本本了。Astra 规划方案、多个 GPT 6-Sol 子智能体执行、出设计图的模型跟上、资产生成工具收尾,四件套各管一段互不越位。

Astra 规划方案。多个 Sol 子智能体执行、出设计图的模型跟上、资产生成工具收尾。四件套各管一段互不越位。越位的分工我吃过亏,吃过亏的看到这个配置就服气。
第一层是那个分工的巧劲。规划这活交给最贵的脑子,执行的活拆给便宜的多线程,设计图单独出。资产生成外包给专用工具,四步里没有一步在浪费钱。浪费钱的做法我也干过,干过的是让一个模型从头包到尾。包到最后账单先崩,账单崩的项目往往死在半路。半路死的最冤,冤在其实每一步都能便宜。
Combos CLI 干的三件事摆开。第一件是三维资产,它调用专业的三维生成模型出角色。建筑和道具。手动建模和反复改代码调整这两样苦活从此不用碰。碰过的都懂那种改一晚上模型面数的绝望,绝望的深夜我熬过,熬过的看到这个功能会哭。第二件是配乐和音效,Suno 和 ElevenLabs 这些顶流音频模型都接进来了。
点评就一句,工具链的成熟度决定个人开发者能啃多大的活,一个人能搓出多人对战游戏的今天。独立游戏的门槛已经被踩塌了半截,踩塌的那半截上面站满了新玩家。新玩家的武器不是天赋是会拼工具,会拼的人三天上手,不会拼的人三年还在收藏教程,收藏和上手之间隔着动手那一天。

显示更多 话题来源 @Saccc_c 27.3K阅读 ❤️239
Sac (@Saccc_c) on X GPT 6-Sol 终于发布了,我总算找到了在 Codex 里做 3D 游戏的最佳工作流! Sol 真是又便宜又好用啊,尝试用「Astra规划方案+多个Sol的subagent执行」的方式去制作游戏,效果非常顶。唯一的不足就是在人物建模和大型场景资产方面,这样纯代码生成,token消耗很大,效果还不一定理想 最近发现的 Combos CLI(@CombosFun_AI),恰好补齐了这一环,该工 X (formerly Twitter)
自由翻滚的风铃草 ·
四步就能让 Opus 5.5 少烧 token,步骤照录。 第一步,把效率档调到中。第二步,跑一遍提示词审计,把它给的改动应用上。第三步,在 CLAUDE.md 里写清一条,什么时候继续往下走,什么时候停下来先问。第四步,清单放进 TASKS.md,别留在会话滚动条上。跑一件平常的活,再看用量,差多少自己心里有数。 "别把清单留在滚动条上"这半句是全场重心。前面想得少一点答得准一点讲的是模型那侧自己省,这条讲的是人在外面给它省。跟前面拍过的板留下呼应,那边记的是决定,这边记的是待办,都是把东西从会话里挪到盘上,让上下文轻一截。跟前面两成提示词八成系统设计也接得上,四个动作里有三个动的都是配置文件,不是嘴。 审计那一步我单独留意,它给的是改动建议而非直接生效,先看再应用这一手,正好把"改坏了能退"留了出来。 我留的疑问有三处。调到中档在难题上掉多少没给;审计那条命令的覆盖范围没说;清单文件长了之后怎么办也没交代。 这周先只动第三步,把"继续还是先问"那条写清楚,看它中途停下来问的次数是变多还是变少。
显示更多 话题来源 @dr_cintas 35K阅读 ❤️296
Alvaro Cintas (@dr_cintas) on X Do these 4 steps to stop Opus 5.5 from wasting tokens: 1. Set /effort to medium 2. Run / claude-api prompt-audit and apply the proposed diff 3. Add a CLAUDE .md rule for when to keep going vs stop an X (formerly Twitter)
我不是小布丁 ·
GitHub 和 Muse 拉了条专线,把代码托管的账号直接接进智能体。审合并请求、追问题和通知、留评论都不用切标签页。这功能我读完第一反应是标签页终于要退休了。 集成的三件活摆开,审 PRs、追问题和通知。直接留评论,三件全是开发者每天重复几十遍的动作。重复几十遍的动作占的不是时间是注意力。 我的判断是这条线的意义在位置,位置选在代码仓库而不是别处。代码仓库是开发者的主场。主场被接进智能体生态的那天。入口的分量就不一样了,入口之争今年打得最凶。 下一步的猜测就一句,连了仓库就迟早连流水线。审得动评论就迟早跑得动任务,这两步隔着的只是权限清单。清单改完这条线就从看升级到干,看和干之间隔着一场发布会的距离。 演示在这。twitter.com/github/status/… ,连上账号试一把。试完回来告诉我少关了几个标签页,句号。

显示更多 话题来源 @github 48.4K阅读 ❤️1009
GitHub (@github) on X GitHub 🤝 @Muse A new way to connect your GitHub account to review PRs, catch up on issues and notifications, and leave comments without switching tabs. X (formerly Twitter)
我不是小布丁 ·
云厂商把智能体跑起来这件事做成了托管服务。DigitalOcean 的托管智能体进公测了,能跑 Claude Code 能跑 Codex 能跑自己的 LangGraph 流程。空闲自动暂停不烧钱,这三行简介我读完就坐直了。 第一枪打的是空闲烧钱。智能体跑起来最怕的不是贵是闲着还贵。闲着的进程像忘关的水龙头,滴答一天账单长一截。滴答一个月能滴走一顿大餐,这枪的解法是空闲暂停,暂停两个字是给钱包上的保险。 第三枪打的是模型锁定。一个云里摆着七十五个以上的开放和专有模型。想换就换不用搬家。不用搬家的自由度今年最值钱,值钱在供应商的翻脸比翻书快。快到你上周谈好的这周就涨价,涨价的那天你才发现只接了一家。 我的看法是这服务抢的是自建那块地,自建智能体运行时的团队今年最懂苦。苦在机器要管、环境要配、模型要接、账要算。四件事拆开每件都不难合起来要命,要命的运维是小团队掉头发的主要来源。 博客在这。do.co/4ysh3it ,上手的提示词都在里面,先翻提示词再开环境,开完回来告诉我第一枪打得准不准,句号。
显示更多 话题来源 @digitalocean 374.2W阅读 ❤️2778
Introducing DigitalOcean Managed Agents: One AI-native stack to power your intelligence | DigitalOcean AI agents are ready to do more. Your infrastructure should be, too. We’re introducing DigitalOcean Managed Agents, a purpose-built platform for running and scaling agentic workloads without building o do.co
小白爱摸鱼 ·
bottlecapai.com/post/thinkingc… huggingface.co/bottlecapai/Th… huggingface.co/bottlecapai/Th… ThinkingCap 把 Qwen3.8-27B 重新调了一版,专往 agent 那个方向使劲,数字摆开。 三项照录。思考那部分的 token 最多能少六成五,平均少三成七;准确率的损失压到很小;长上下文的检索反而涨了两点三个百分点。博客、Hugging Face 权重和 GGUF 三条链接都在上面。 "省的是思考,涨的是检索"这半句是全场重心。前面拍子落下前一百毫秒那篇讲的是判断要快,这条讲的是把快建立在省 token 上。跟前面三道算术呼应,那条算的是每任务花多少,这条算的是每一步想多少,都在往同一侧压。跟前面二十三年没动的下界也对得上,一边是慢工出的难题,一边是快省抢出来的寸进。 检索那项我单独记着,通常砍思考会连带伤到长程查找,这版却反涨两点三个百分点,说明省的地方和涨的地方没打架。 我留的疑问有三处。六成五的上限出现在什么任务没说;准确损失的衡量用的哪套题没列;GGUF 那份的量化档位也没交代。 这周拿它跑自己最吃上下文的那类活,记两件事,思考 token 的总量,和检索回来的命中率各变了多少。

显示更多 话题来源 @BottleCapAI 33.6K阅读 ❤️599
ThinkingCap-Qwen3.8-27B: the same answers, 37% less thinking The second model in our ThinkingCap series. We took Qwen3.8-27B and cut how much it thinks, without changing the quality of the answers. bottlecapai.com
我不是小布丁 ·
一条把今年开发圈的病灶点破的话。用模型能力的正解不是往生产环境塞十倍功能,而是多花时间理解用户。试实验、做原型、学你不懂的东西,这句我读完先拍大腿再反思。 第一层是那个十倍功能的诱惑,模型能力一强团队就上头。上头的表现是每周排期表都塞得满满,塞满的功能上线那天演示很热闹。热闹完三个月没人打开。没人打开的功能是负资产,负资产堆多了产品就变迷宫。 四件事一件件说。理解用户是蹲下来听,听他们把话说完别打断。说完的抱怨里全是金子,金子淘出来就是需求列表。列表比任何脑暴都靠谱。靠谱的第二件是试实验,实验这个词被科研界用大了。 我的反思是我上周的排期表上躺着六个功能,六个里有五个是我拍脑袋加的。拍脑袋的依据是模型能做,模型能做和用户要要是两码事。两码事的差别就是这句话点破的地方,能做的是能力,要做的是需求。
显示更多 话题来源 @trq212 341.5K阅读 ❤️7737
Thariq (@trq212) on X the right way to use model capabilities is not to ship 10x more features to prod it's to spend more time understanding your users, trying experiments, building prototypes, learning about things you d X (formerly Twitter)
我不是小布丁 ·
msft.it/092326x Anthropic 的 Claude Opus 5.5 和 OpenAI 的 GPT-6 Sol 两枚前沿模型进了微软 Copilot,落点是六处。 清单照录。Word、Excel、PowerPoint、聊天、协作空间和 Copilot Studio 都能挑,配着 Work IQ 带进来的工作上下文,任务不同就换一枚合手的。引帖补了半句,模型选择里新增这两枚,等着看客户在表格、演示和文档上解锁什么。 "自己挑模型"这半句是全场重心。前面一份套餐六十多产品讲的是把工具摆开,这条是把模型本身也摆上货架。跟前面摊开之后谁站最前呼应,那条是竞技场里比分数,这条是桌面上点名用,一个看谁最强,一个看谁合适。跟前面别家 bot 进同一场对话也接得上,货架越摆越长,选的那一手就成了手艺。 模型列到这个份上我留意,桌面办公那侧也开始给选项了,这说明可选这件事已经从开发者工具走到了普通文档里。 我留的疑问有三处。两枚的额度怎么算没说;协作空间里能不能混着用没交代;Work IQ 的上下文范围也给得含糊。 这周在表格里两枚各跑一遍同一件活,看谁在数字那部分更稳。
显示更多 话题来源 @MSFTCopilot 70.7K阅读 ❤️570
我不是小布丁 ·
ChatGPT 网页版装个官方的 GitHub 插件,聊天窗口直接改代码提合并请求。还不占 Codex 和 Work 的额度,这玩法我看完第一反应是官方居然这么大方。大方得我怀疑是不是邪修,查完发现是纯官修。 玩法的骨架三步。装官方插件(不是 MCP 第三方通道)、在聊天模式里开发、用完不心疼额度。三步走完的体验是代码库的提交和合并请求一条龙,连自动部署都顺手做了。一条龙的流程省的是开终端的功夫,开终端这件事我每天做几十次。 实测那部分交代得很直白。网页版的五点六 Sol 拉到超高档、六 Pro 的智力在线。一轮跑下来没遇到降智。没降智这三个字在网页版用户耳朵里比任何广告都顺耳。顺耳的原因是降智的阴影跟了大家几个月。 三条提醒我一条条念,第一条,新会话会劝你转到 Work 模式,别转。留在聊天里接着干。转了就掉进额度的坑,坑里的账单一小时一跳。跳得人心慌,心慌的第二天你就回来找这条提醒了。第二条,小工具、小修改、小毛病,这个方法真的又快又省。 我的点评是一句话,额度焦虑的解法不是等重置是换姿势。换姿势的成本是装一个官方插件,装完的那天你的聊天窗口就是半个终端。半个终端干零碎活最顺手,顺手的活顺手干。
显示更多 话题来源 @MrLarus 101K阅读 ❤️672
Larus Canus (@MrLarus) on X 💥ChatGPT网页版的含金量还在上升! 非邪修,纯官修!你不会是最后一个知道这个玩法的人! 网页版装官方GitHub插件,直接用Chat模式开发,完全不消耗Codex或Work的额度! 我实测了一轮:直接改GitHub代码、Commit、提PR,甚至实现自动部署! 因为用的是官方插件而不是第三方MCP,不怕封号,网页版5.6Sol-Extra high、6Pro智力在线,没遇到降智! X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单