一个域名重定向泄露了天机,好戏,真是好戏。dot.com 现在跳到 x.ai/bot ,马斯克收了 dot.com 指向 Grok Bot 官方页,骑脸输出,嚣张,太嚣张,我喜欢。
单字域名的含金量不用多说。这种级别的资产买来不放自家主页。反而当指路牌。指向一个还没铺开的产品,这信号比开十场发布会都响,懂的都懂,这叫预热,不懂的还以为是失误。失误不了。马斯克的失误从来都是设计好的。每步棋都带钩子。这习惯我太熟了,熟到看见域名跳转就能脑补一出大戏,脑补还八九不离十,这直觉值钱,记档,回头验证,看准不准,准了我回来吹。
我的看法是这波域名操作把营销的艺术感拉满了。一个跳转顶一篇官宣稿。成本几乎为零。传播力翻几倍,这钱花得比投放值,值,真值。值到想发红包,虽然不知道发给谁,发给马斯克本人他也未必收,心意到了就行,开个玩笑,思路是认真的。
低成本高传播的招式永远值得学,学不会先记住有这招,记牢它,别忘,早晚用得上。技多不压身,这理我妈说过,放这特别合适,合适到想给她点赞,点赞免了,回家吃饭更实在。扯远了拉回来,说正事,听好,重点来了,划重点,现在开始。
今晚 harness 线之外还有一条 Dots 线,今晚 几十赞的一条小推是 Dots 这一周真正的用户侧收口——一位用户上手试了 Dots,报告说它的云电脑是 9 核 8G 规格、且网络是白名单限制,基本无法访问外部,而 Grok Bot 给的是 8 核 16G 配置且开放网络。
结论是 Dots 和 Grok Bot 这一轮产品力对比中,OpenAI 在产品规格和开放度上输了一手。这条内容分量不大,但放回今晚的 Dots 时间线就值得单拎出来。
今晚 Dots 这条线聊到的内容有几条主线:DevDay 当天发布(61293 那条)、正式上线和总是按按钮的 reset(1632 那条)、首次 demo 现场答不上来(61502 那条)、Dot.com 域名被 SpaceXAI 抢注(61509 pending 那条)、再到今天这条 几十赞真实上手。
Dots 这一周经历了发布会惊艳、Demo 翻车、产品规格对比、域名抢注、产品上线吐槽——所有这些加在一起,组成了 AI 时代一个产品完整生命周期的一周。今晚 Dots 给我们留下的不是某一件事的判断,是这一周完整拼起来之后的那条认知:产品发布会、订阅叙事、always-on 路线、agent 生态——这一整套在屏幕上看到的画面,到了用户桌面是不是真的好用,要再过一个产品本身的关。
把 Dots 和 Grok Bot 的对比放在更宽的视角里:OpenAI 这边把 Dots 的卖点放在"always-on agent + 自己的云电脑",SpaceXAI/Musk 那边的 Grok Bot 把卖点放在"快和便宜"。
两边同一天推出 always-on agent 产品,但用户上手后立刻发现具体的差异——OpenAI 把云电脑锁死在白名单里,意味着 Dots 能跑的事被锁在一份固定清单里;Grok Bot 选择开放网络,意味着它能跑的事跟着用户能访问的整个网络一起涨。
两种"always-on"的设计哲学不同,OpenAI 偏封闭可控、SpaceXAI 偏开放组合。今晚 61502 那条 demo 翻车、61509 pending 那条 Dot 域名被抢、现在这条上手规格对比——三件事同时发生在 Dots 上线一周内,不是巧合,是产品策略和准备两件事的差距在用最快速度显现。
留一格清楚的边界:今晚这条 几十赞的小推来自单一用户、单一时刻的上手体验,不能当成 Dots 的全面判断;9 核 8G vs 8 核 16G 的对比也只是当前快照,未来 Dots 升级或者 Grok Bot 改订阅都会让数字翻转。这条单独拿出来,是给 Dots 这一周画一个直观的细节、给今晚所有讨论加一个具体颗粒,不是给 Dots 下定论。
给今天就在做 agent 产品选型的人一句落地的:今天就翻一下你下一周打算用的那个 agent 平台或订阅,重点看三件事——它的云端算力是什么规格、它的网络是不是开放、它的工具调用是不是有限制。
这三件是今晚所有 always-on agent 平台的底层差异,发布会上不会讲,但发布会一过你会碰到。三件事里至少有两件按你的真实需求评估,看完再看 demo,demo 是给产品定型用的,但真实的还是上手那半小时。
xAI 上了个明码标价的新品:Grok 4.7 Fast——同一模型、更快基建、输出速度约 2 倍;价格也清楚:token 单价是标准版 2 倍,且只在 Grok Build 与 Cursor 有、免费层不含、公开 API 没有。原帖总结:同样的智能,快得多的推理——代价是两倍的钱。
这笔账值得现场算:速度翻倍等于单价翻倍,选型从感觉题变回算术题——你的场景值不值 2 倍钱换 2 倍速度?交互式、人在旁边等的值(等 10 秒和等 5 秒是两种产品);批量后台通常不值(夜里慢慢跑,总成本说了算)。等待成本因场景而异:人盯着等是贵的,机器夜里跑是便宜的。
口径按住再读:"2 倍速度"没写负载——输出速度与端到端延迟是两回事;"same intelligence"是同权重,但更快的推理栈怎么批怎么调度没公开——同权重不等于同延迟结构。
那三条 only / not included / not available 是可用性口径:只有 Cursor 和 Grok Build 的用户吃得到,走 API 的没份——选型前先确认通道。
给同行一句:厂商开始给速度标价,说明成本结构已透明到可以拆开卖——该问:时间预算和 token 预算,哪个更贵?
训练侧的解释终于来了:xAI 的工程师说,4.7 是在"更长的持续性问题"上训练出来的(对照 4.6),效果点名两条——上下文保持得更好、更仔细地自查自己的工作;被引用的官方发布帖则强调:这是同价、同速下的显著提升。
这一条正好把前面两篇的现场接上了:昨天那篇一天实测观察到"更稳、更保守、会自查"(连"拒绝一句 yolo"都对得上"自查自己的工作"),而成本账那篇实测出"每任务更贵、轮次更慢"——注意两种口径并不必然打架:官方的"同价同速"说的是标价与基准设置,两位实测者说的是自己任务形态下的实际消耗(effort 档位、任务结构、缓存命中都会改写真实账单)。读这类消息的动作就一个:把"标价"和"每任务成本"分开看。
我的看法:从"按更长任务训练"这七个字,能反推这一代的优化目标——不是刷短题分数,而是压低长程工作流的失败率:hold context 是少丢约束,self-check 是把返工拦在提交之前——这也正是 day-1 观察里"可预期、敢放手"的来源。
训练目标定成长程,用户的体感才会是"稳";同时解释了它为何在"听话"上进步明显:长任务的训练样本本身就奖励服从性。
训练细节按工程师自述,官方未公开配方;"同价同速"为发布口径。
一篇把跑分先放一边的 Grok 4.7 一天实测。作者的筛选立场开篇就摆明:只引公开跑分的"它很烂"报告直接忽略——"同一批跑分还说过 Opus 5 比 Fable 强呢";拿 3D 小游戏比模型的也忽略——那不是真实工作,是社媒搏眼球。
他把 4.7 当"大副"(firstmate)主力用了一整天,结论是明显强于 4.5(4.6 他干脆跳过,体验里 4.5 更好使)。
先把他的方法论立场单拎出来说:他删掉的两类报告——只跑分的和玩 3D 小游戏的——恰好是社媒上声量最大的两类。前者把多维能力压成一个数,后者把"能玩"当成"能干活";而他选择的替代方案是拿一整天当主力用、记录行为差异。这种定性长测的样本量小,但它测的是跑分测不到的东西:行为是否可预期。
四条观察:
一、系统提示跟得极紧。 他第一次见到这些新行为:让他点名说出哪些红色 CI 检查可以接受被绕过、并且拒绝一句简单的"yolo"指令。他回头查了自己的 firstmate 系统提示,措辞确实这么写——此前没有任何模型跟到能显形的程度,4.7 是第一个把它做出来的。同类例子还有几个,他认为这是明确的行为差异。
二、非常"稳"。 用过 Astra 的人知道什么叫"尖峰"模型:有天才时刻,也常有"怎么会蠢到不懂我"的瞬间。4.7 相反——一整天下来他承认还没遇到"哇,这波绝了"的时刻,但稳定、无大惊喜、行为可预期,这份可预期让他很快建立起信任。
三、偏保守。 不询问就不动手,而且会明说。他自己说这是双刃剑:有时他得把显而易见的事再说一遍("是的,我要"),但回头看,那些场景确实有歧义,模型未经确认就自作主张未必是他想要的。
四、比 4.5 更慢、更贵,肉眼可见。 每轮耗时变长,额度掉得明显更快——他坦言还没量化出钱从哪儿漏的。
把第四条和昨晚那篇从账单出发的 4.7 差评放一起,就形成了难得的交叉验证:那篇算出真实成本是 4.6 的两倍以上,这篇没量化却独立观察到"额度肉眼可见地掉"——两位不同作者、不同方法,指向同一个方向:4.7 的账单压力是真的。一个从钱倒推,一个从体验正推,结论重叠的部分可信度最高。
第二条也值得展开:"稳"为什么值钱。可预期的信任是复利——模型行为越可预测,你越敢放手给它更长的任务、更大的权限,吞吐反而上去了;单点的"天才时刻"做不到这一点,因为你不知道下一轮它是天才还是傻瓜。对每天要跑几十次的主力模型,可预期性直接等于产能。
第三条的工程含义同样直白:保守型模型适合有审批文化的团队——它那套"先问再动"正好对上变更需要留痕、权限需要收敛的场景(他点名的 CI 白名单就是典型);但快糙猛的探索期会嫌它磨叽。"更听话+更稳"值多少,取决于你的任务容错,这句可以当选型口诀。
总评:特征差异清晰、他大多是喜欢的,会继续当主力并接着观察;结尾还向读者征集真实使用的定性感受——跑分满天飞、单点成本测零星,这种"用了一整天的定性描述"恰恰是社区现在最缺的那类数据。
顺着他的四条观察,能整理出三件立刻可用的事:其一,想吃满"听话",就把边界写进系统提示——可绕过的检查项、需要确认的动作类型,写死它就会真执行(他的 CI 白名单例子就是这么显形的);其二,按阶段分工模型——探索期要发散、要快,未必用它;进入要留痕、要审批的收敛期,保守反而是加分;其三,额度要设告警——他自己没量化出钱漏在哪儿,使用者就得自己盯:更慢的轮次乘上更快的消耗,最容易在月底才发现。
我的看法:三类信息源要一起用——跑分、单点成本实测、定性长测,缺一个都会误判。4.7 不是单轴变强,而是性格重排:更听话、更稳、更保守,同时更慢更贵;升级从来不是"变强"一个词能概括的。而他的观察方法本身也可复制:同一句系统提示在几个模型上跑一遍,看谁能把行为做显形——这比任何跑分都更接近你要的答案。
限定:一人一天的定性观察,任务集与额度消耗均未量化(他自己也这么说)。

Grok Bot 正式登陆特斯拉汽车——发帖人两周前拿到早期体验,用法很直接:不用装任何单独的 App,一切就活在车里原有的 Grok 语音界面中:动嘴就能网购(比如亚马逊下单)、管邮件、日历、财务和其它杂活。
他给的样板场景很"马斯克式":上车后告诉 Grok Bot 在你选的那家咖啡店下单,车用 FSD(Supervised)一路开过去,订单同步下好,到店即取——通勤时间被顺便变成了下单时间。
两条范围信息值得记:目前仅对 SuperGrok Heavy 用户开放,后续会扩大到更多车主;而 Connectors 对所有用户开放。
我的看法:这是"agent 长进日常设备"的第一个大规模样本,三层结构都很清楚——入口零学习成本(语音,不装 App)、任务面靠连接器铺开(购物、邮件、日程、财务)、场景与设备本身耦合(FSD 顺路下单,车不只送你还顺手办事)。
它也标出了付费墙的新角色:重型订阅买的不只是模型额度,还有"第一批用上 agent 的资格"。车载恰好是语音的主场——手被方向盘占着,语音加 agent 在车里不是锦上添花,是刚需。功能与可用范围按官方说明与作者早期体验为准。
dtzy_88 这条挺乐——"Grok 4.7 的鹈鹕骑自行车测试结果,谁能告诉我这是什么鬼东西 😳"。
鹈鹕骑自行车是 AI 多模态圈子有名的"刁钻 prompt"——要求模型生成一张"鹈鹕(pelican)骑自行车"的图。这张图难就难在:
Grok 4.7 这代"鹈鹕骑自行车"测试结果的几层解读:
对国内多模态团队的 actionable:
这件事更深一层的信号是:多模态模型的"真实可用"和"benchmark SOTA"之间还有巨大差距。Grok 4.7 在 AA Intelligence Index 上拿到 46 分、Terminal Bench 89.9,但在"鹈鹕骑自行车"这种基础常识组合上翻车——说明当下多模态评测体系对"现实世界物理直觉"这一档的覆盖还很弱。
对国内做多模态应用的团队来说,这是个机会:
Grok 4.7 在 AA 上是顶级,但在"鹈鹕骑自行车"上是鬼故事——这种"高分低能"的反差,恰恰是当下多模态赛道最值得关注的现实。
MaxForAI 这条挺逗的:"昨晚同时发布的 Grok 4.7 和小米 MiMo V2.6 Pro 跑分居然一样 🤣 一时之间不知道是说马斯克拉完了还是 MiMo 人会飞了"。
这条信息量不大但说明一件事——xAI 和小米团队在同一晚(UTC Sep 21 22:00–23:59 / 北京时间 9 月 22 日早 6–7 点)撞车发版。
撞车这种事在大模型圈其实不罕见,但这次有点特殊:
按 AA 榜单的口径两边都是"顶级 / 顶级开源"这一档,跑分撞一起在数据上完全合理,但对市场叙事是个有意思的冲击——
跑分撞车这件事的几个 actionable 启示:
接下来的判断:
"鬼故事"这三个字起得挺到位——对国内 AI 行业来说,看到 Grok 4.7 和 MiMo V2.6 Pro 同分的那一瞬间,确实有种"鬼故事成真"的感觉。
Artificial Analysis 这条是 Grok 4.7 第三方独立评测的关键读数——把要点拆开给国内开发者看一下。
核心结论:Grok 4.7 在 AA Intelligence Index 上拿了 46 分,进入"顶级四强"。这个分数比上一代 Grok 4.6 涨 +2,但单项的进步远比平均分要明显。
关键数据点:
一个隐藏的代价:Grok 4.7 在 xhigh 档下平均每个 Intelligence Index 任务耗 81K 输出 token——比 Grok 4.6 的 36K 翻一倍多,比 GPT-6 Astra 的 27K 高出 196%。单位任务成本实际是上一代的 2–3 倍。
这一条很关键——评测看起来涨了,但性价比反而变差。如果按"一次任务的实际美元花销"算账,Grok 4.7 对代码任务来说并没有"同价"那么香。
适用场景判断:
总结:Grok 4.7 是"性能涨、价格不变、单任务成本涨"的典型——账要看实际工作负载,不要只看标价。
Bhavani 这条是 Grok 4.7 首批用户的反向声音——一句话总结:"$1.59 烧出这种输出,还不如 Kimi $6 那一发"。
这条吐槽有几个值得拆的点:
从用户侧看,Grok 4.7 这次的问题大概率不是模型本身差,而是:
建议:被吐槽劝退之前,先把同一份 prompt 平行跑一遍 Grok 4.7 / Claude 4.5 / Kimi K3,看单位成本收益再决定迁移不迁移。
Kimi 这边能"贵一倍但不亏",是当下 AI 编程性价比叙事值得复盘的一个点。
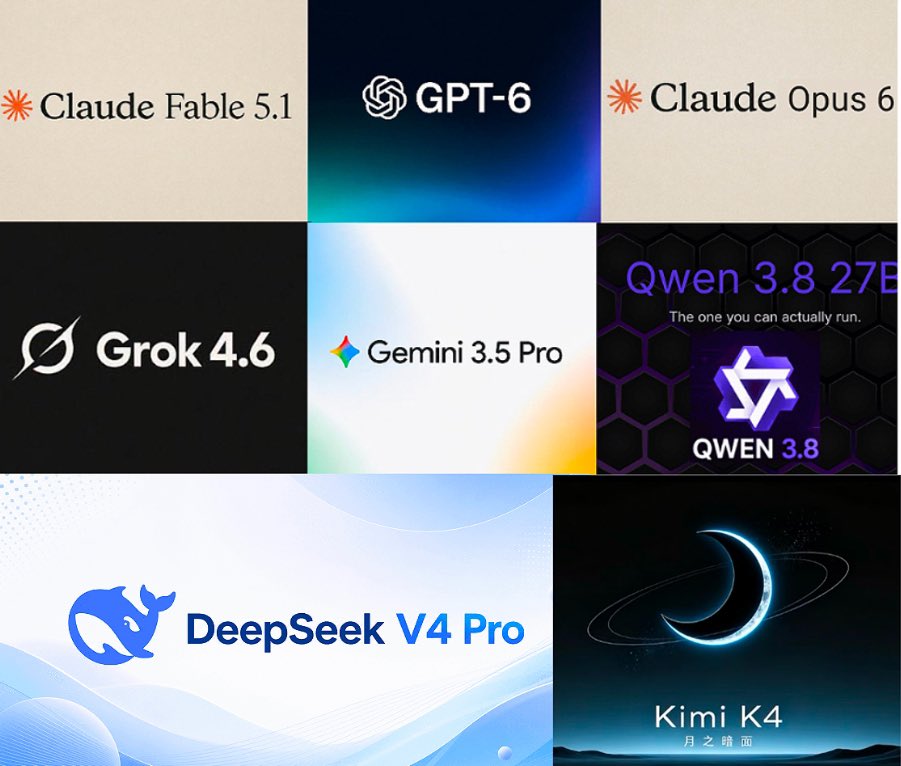
shownotover 这条把本周的模型圈大事提前剧透了一遍:Gemini 4、Opus 5.5、Grok 4.7、GPT-6 Sol 四家模型本周内陆续上线。四个名字里 Grok 4.7 已经放出来了,其它三家还在排队。
一次性过一下各自的看点:
几个使用层面的预判:
薅评测没问题,被"四选一"标题党带偏就亏了。
SpaceXAI 这条很直白:Grok 4.7 出了,重点是同价同速换一代。
对国内用户来说这条信息有两层意思:模型侧把"换大版本"这个动作的成本降下来了——价格不动、延迟不动、效果往上抬一档,等于白送一次升级。xAI 这边走 API / Grok 应用 / 第三方代理的入口基本都同步开放,老用户的账单结构不用重算。
从技术维度看,几个判断值得记一下:
需要补充的一点:xAI 这边历史上每次"价格不变"都伴随着上下文窗口或工具调用上限的微调,建议发版通告出来之后顺手过一遍控制台条款,确认自己的 quota 没被悄悄收紧。
薅一把升级没问题,但要按"先评测再灰度"的节奏来。
Grok 4.7 发布了,Artificial Analysis 的评测也跟着出来了。
这次的变化不在"智力分又涨了多少",而在它终于把 agentic 那部分补上来了。
先看分数
这里有个容易被忽略的限定词:那是"原生 harness"口径。Grok 4.7 配的是自家的 Grok Build,榜单上其他模型也各配自家的工具链。换到统一的第三方脚手架里重测,名次未必照旧 —— 看这类榜,先分清它比的是模型本身,还是模型加脚手架。
"第三"还是"第四",取决于你数什么
马斯克转发时的说法是:Grok 4.7 在 agentic coding 上排第三,仅次于 Anthropic 和 OpenAI。
评测机构的口径是按模型排:Grok 4.7 + Grok Build 在原生 harness 里排第 4,前面是 Claude Fable 5.1、GPT-6 Astra、Claude Opus 5 —— 其中两个来自 Anthropic、一个来自 OpenAI。
两种说法不矛盾:一个是按实验室数,一个是按模型数。看这类发布,先确认对方数的是哪一个,再去比排名。
涨的地方和跌的地方
提升:Terminal-Bench 4.0 涨了 4.5 个百分点,GDP.pdf 涨了 3.0 个百分点。
回退:AA-LCR 掉了 3.7 个百分点,AutomationBench-AA 掉了 1.1 个百分点。
也就是说,agentic 和编码这两块是这次的主攻方向,其他任务基本和 4.6 持平,个别项目还有退步 —— 不是全面变强。
最该注意的是账单
Grok 4.7 (xhigh) 每跑一个 Intelligence Index 任务,大约消耗 8.1 万输出 token。对比一下:Grok 4.6 (high) 是 3.6 万,GPT-6 Astra (max) 是 2.7 万 —— 分别高出 125% 和 196%。
马斯克说它"明显更快、更便宜",指的是单价:输入每百万 token 2 美元、输出 6 美元,缓存命中 0.5 美元,与 Grok 4.6 持平。但单任务成本是另一回事 —— 单价没动,token 用量翻倍,同一件事的总价就跟着上去了。
这也是这次发布里最值得记的一条:分数涨 2 分,token 涨一倍多。上下文窗口 500k,和 4.6 一样没变;推理档位从 low 到 xhigh 可调,评测用的是最高档。
我的看法:现在 agentic 类基准比纯智力分更能说明模型能不能干活,这点已经在取代过去的比法。
但随之而来的是,token 效率正在变成新的分水岭 —— 单价持平、单任务更贵,意味着重度使用 Grok 4.7 之前,得先拿自己真实的调用量算一遍账,而不是只看每百万 token 的报价。


Cursor 被 SpaceX 收购了。
官方确认:Cursor 团队加入 SpaceX AI,帮助改进 Grok 系列产品。
这意味着什么?
几个疑问:
• Cursor 的独立版本还会继续吗?
• 现有的 Cursor Pro 用户怎么办?
• 和 VS Code 的整合会受影响吗?
对用户的直接影响:
这笔收购说明 AI 编程工具的价值被严重低估了。Cursor 才出来多久,就被 SpaceX 这种级别的公司看上。
你们用 Cursor 吗?会因为这个收购换工具吗?