AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
我不是小布丁 ·

LingoAI 把 agent 的叙事推进了第三幕:从工具到常驻,再到主权。

Agent 1.0 是 OpenClaw 那种单会话的反应式工具,被拴在本机。Agent 2.0 是 Muse、OpenAI 的 o、Grok Bot 这类全天候云端 agent,带虚拟浏览器,行动力高,可代价是数据主权为零,你的收件箱、日历和数字生活全交给了科技巨头。

Agent 3.0 他们管它叫 Holon,主打主动的 7x24 执行,靠 Personal Ontology 和 Web3.0 密码学架构撑腰。

Holon 这个词取"最小的主权智能单元",设计是张两面脸。朝内,用个人本体论守住身份、边界、长期记忆和意图;朝外,与其他 agent 和网络协作,却不交出主权。配套的标准栈也列全了:ERC-8004 管可验证身份 DID 与信任边界,ERC-8183 管 agent 间 A2A 任务分解和合约执行,X402 协议让机器之间直接走 HTTP 402 微支付。

我欣赏问题的提法。前面几篇一直在聊 agent 怎么干活,这篇反过来说它"归谁管"。常驻 agent 越勤快,交出去的收件箱和日历越多,数据主权这笔账迟早要算。把 DataSovereignty 一类的主权拆成身份、记忆、代理和价值四样列开,至少账目是清楚的。

保留的怀疑也很直白。这一整套建立在 Web3 标准和代币叙事上,ERC 编号还没见到生态采纳的证据;宏大叙事居多,落地案例为零。概念好不好是一回事,有没有人用是另一回事。

他们给终局画的像值得记:Every person can be a whole.Every whole can remain sovereign.Every sovereign Holon can become part of something greater。

单个中心化的超级模型吞掉所有人的记忆与自主权不会是答案,接棒的是 Holarchy。蓝图画到这个程度,接下来就看 #SovereignAI 标签下第一批应用什么时候出现。

显示更多 话题来源 @LingoAITech 88.2K阅读 ❤️470
小白爱摸鱼 ·
「I tested SuperGrok ($30) AGAIN」,三十块的 SuperGrok 买回来,这位用户的账算得很难看,结论是 NOT worth it。 Grok 4.7 开到 xhigh 档跑了一轮,成绩单如下:周限额只用掉 8% 就见了底,API 折算价值 $3.9,总共 1100 万 token,四十分钟干完活,速度被他标成 EXTREMELY slow。每月 550 Million tokens per MONTH,ONLY 这么多,看着吓人,实际到手的体验他给了一句"不值"。 对照组摆出来更扎眼。Claude 那边 $20 一周的档位,每周给到 3 亿 token,用的还是 Opus 5.5。他补的那句评价也直白:Opus 5.5 和 Astra 的输出 WAY BETTER。即便只把它当执行工具来用,这笔钱也收不回来。 这跟前面几篇的账能对上。价格线聊过,真正的差价要看单位钱买到的提升;Effort 那篇讲高档位值不值要实测。这次轮到订阅档位本身被实测打分:token 数字的多寡不等于干活的多少,速度、输出质量、限额结构都得算进去。 我的看法是"给多少 token"这种宣传口径该退休了。5.5 亿听起来压过 3 亿,可一周 8% 就触顶的体验,比能痛快用满的 3 亿差远了。用户最终的建议也很实用:不玩 Grok bot 的,省下这笔直接买 Claude。 他的结论是基于这一轮自己的用法,样本不大。真要判断合不合算,得看你的任务形状跟哪家的限额结构更贴。
显示更多 话题来源 @shownotover 19K阅读 ❤️72
我不是小布丁 ·

两个隐形模型本周混进了编码 agent 的货架,至今没人知道背后是谁做的。Pixel Canary 和 Space Bunny Alpha 挂着 Gemini 3.8 Flash 一起,眼下全部免费,上架清单逐条摆开。

Vercel 的网关里,Pixel Canary 走 API 供应,在 Next.js 评测上跟 GPT-6 Astra 打平。OpenCode Zen 一上就是三件套,地址在 opencode.ai/zen 。

OpenRouter 那边给了 Space Bunny Alpha 的百万上下文,连 Thinking Machines 的 Inkling 和 Cohere 的小代码模型也在列,清单在 openrouter.ai/models 。

Cline 桌面端登录就送促销额度,Pixel Canary、Space Bunny Alpha、Gemini 3.8 Flash 和 DeepSeek V4.1 Flash 四个都在列,见 cline.bot/desktop 。

Dahl 更直接,首批一亿 token 白送,入口 inference.dahl.global 。

上真代码前有两件事得办,这段是全文最值钱的部分。第一,把框架文档塞进 AGENTS.md,Vercel 的评测里这一手就让 Pixel Canary 从二十八题对提到三十题。第二,查清楚谁保留你的 prompt。

Zen 上的 Pixel Canary 和 MiMo 可能拿去训练。Space Bunny 在 Zen 是零保留,挪到 OpenRouter 就只保留不训练。要跑客户代码,选 Zen 上的 Space Bunny。

上架的名单补全了看,OpenCode Zen 还有 LongCat 2.5 Preview 和 MiMo V2.6 Flash,Dahl 那头是 DeepSeek V4 Flash 和 MiniMax M2.7。一周之内五个陌生名字加两个熟面孔挤进货架,节奏罕见。

我的看法是隐私条款正在成为货架上的第二价格。同样的免费模型,零保留和可能训练的差别,对个人玩票无所谓,对企业代码就是生死线。各平台拿不同的保留政策抢同一批用户,说明这层分化已经开始。

至于隐形,这玩法见怪不怪,先放模型攒口碑、再揭晓身份是惯用剧本。真正要盯的是评测成绩背后的复现,打平 Astra 这句先让子弹飞一会儿。

显示更多 话题来源 @zefirium 6.7K阅读 ❤️69
我不是小布丁 ·
Jev 的第一批黑客松作品出炉,拿下 TypeSafe 首届比赛第一名的是 Jevolution。一个多 agent 生态系统模拟器,让研究者在虚拟世界里观察濒危物种,全程不碰一只真实的动物。站点在 jevolution.world ,代码在 github.com/utkarshg20-org… 。 这个选题挺妙。生态研究最大的伦理难题,就是介入本身会改变被观察的对象。用一群 agent 把种群互动搬进模拟器,既保住可重复性,又绕开伦理审查。判断模型给每个虚拟个体定夺行为,生态学的老问题换了新解法。 黑客松这个信号,比作品本身更值得记。判断层那条线我们追了一个月,从模型、榜单到官方接口,现在第一次看到围绕它长出的开发者活动。有比赛。有作品。有评审。生态的形状开始完整了。 我的保留照旧。模拟里的物种行为依赖规则设定,跟真实生态差多远,得看论文和复现。但方向是对的,判断模型的用武之地正从客服、路由这些流水活,往严肃研究里渗。 评审和规则都开源这一点加分。想复现的,照着仓库走一遍就行。
显示更多 话题来源 @_nikhilhooda 20.8K阅读 ❤️368
自由翻滚的风铃草 ·

github.com/APUS-AI-Lab/fa…

让模型操作浏览器,先把满屏按钮编成选择题。

Fast Browser Use 这个思路接得巧。Browser Use 此前把 Jev 接进浏览器操作,APUS 团队更进一步,用开源的 Qwen3.5 把这套活搬到本地。起手第一步是扫视整个页面,把此刻真的可见、可点的控件挑出来,依次贴上 A、B、C 的编号。

模型拿到的是一张有限的菜单,只能从中勾选,不许自己写定位代码,于是也无从虚构出页面上不存在的部件。真正需要生成文字的时刻只剩一处,就是往输入框里敲内容。

这个设计把一类经典故障堵死了。模型自己写选择器,最爱编出页面上根本没有的元素,点了个空。换成从真实清单里挑,能挑的就那些,挑错至少还在页面上。跟前面 Jev 那套"给选项打分"一个道理:范围划死了,出格就没了空间。

实测数字在 README 里,我看的时候记了两个。由维基百科首页一路点到 Python 词条,9B 的中位耗时约四秒;另一项是把设置表单填完整,耗时两秒半。推理全在本机完成,云端接口一次不碰,页面数据也不出机器。想在自己的 M 系列 Mac 上复现的,16GB 内存托底 9B 量化模型,文件体积六 GB 上下。

分工也对味。大模型想清楚要干什么,这个小个子负责快速点完。想的归想,点的归点,跟"决策和执行分家"那几篇对上了。

保留的疑问在复杂页面。选择题模式在规整表单上占便宜,遇到满屏自定义组件、拖拽交互,选项该怎么编,介绍里没展开。

装好后在 Claude Code、Codex 里直接调,仓库地址就在上面。

显示更多 话题来源 @GitHub_Daily 6.8K阅读 ❤️72
我不是小布丁 ·
判断模型落地到聊天界面了,还顺手把边界立得极正。这个开源的安卓对话副驾装在手机上,在 QQ、X 私信和飞书里读懂对方的话,一次给出三条候选回复,仓库在 github.com/jev-chat/jev-c… 。 次序上先裁决后成文。判断这层先出场,看懂对方的意图,再掂量该不该立刻回,顺手给个一到九的危险等级。全程约一秒出结果,然后才动笔起草。先裁决后生成的次序,跟前面聊过的判断层完全一致,这套流程终于出现在了日常聊天里。 真正让我点头的是边界那几条。它把成品放进输入框就撒手,点不点发送归你。钱的部分整个跳过,转账红包碰都不碰。读的内容也只限屏幕当下那段,软件本身一概不动。需要记忆时用联系人档案和自己的笔记,草稿就不会跟既往人设打架。底账同样干净,会话默认不落盘,接口凭据握在自己手里,填个 OpenRouter 就能跑。 这四条把"AI 看我聊天"的不安拆掉了大半:不发送、不碰钱、只读屏、不留底。做个人工具的团队能把边界写进设计而不是写进免责声明,这事本身就值得学。 一键发送的诱惑谁都懂,它忍住没做,这份克制比功能清单值钱。
显示更多 话题来源 @GitHub_Daily 8.3K阅读 ❤️64
我不是小布丁 ·
Opus 5.5 开始接动效设计的活了,靠的是 Higgsfield 的 MCP。三步走全:先生成图片、logo 这些图形素材,再把合成搭建起来并做上动画,最后渲染成视频。 值得记的是交付物的形态。它吐给你的不是一段焊死的成片,是一个可编辑的 After Effects 工程,想改哪层改哪层。这跟前阵子那条本地生成的讲解视频正好互补,一个交付能直接投的成品,一个交回源文件给专业的人接着干。视频这类产出,正在按受众分流。 MCP 在这里又一次证明了自己。模型不装软件、不学界面,插上接口就能使唤专业工具,Opus 5.5 出创意和判断,Higgsfield 管渲染和工程,各干各的强项。这类合作以后只会更多,工具方要的是入口,模型方要的是能力的延伸。 我的疑问留给实测。动效这活最吃节奏感和审美,AI 搭的合成在细节上能不能过设计师那关,得看真项目里的返工率。演示视频看着爽,成片落地才是验收。 演示视频就带在发布消息里,想看成色的自己去翻,真项目里的返工率才是硬指标。
显示更多 话题来源 @higgsfield_ai 432.6K阅读 ❤️2006
小白爱摸鱼 ·
arxiv.org/pdf/2609.33803 github.com/thunlp/DRM huggingface.co/Teburile/DRM 把一群人的喜好压成一个数,这一步可能压错了。 DRM 这篇工作把矛头对准奖励模型的老习惯。它是 LLM 后训练的核心部件,可市面上几乎全在做同一个简化:把人类偏好折成单一分数。问题在于,人对同一个回答的判断常常不是一个点。有人爱简练,有人要详尽,两拨人的评分天然打架,一个平均分把分歧全抹平了。 于是作者问了句要害的:奖励模型能不能学出偏好的分布,而不是那个点?这就是 Diffusion Reward Models 的活,用扩散的方式把"大家怎么想"整个建出来。 我认这个方向的合理性。单一分数看似客观。实则把统计手段当成了事实本身,训练时谁嗓门大谁占上风。换成分布,模型至少知道自己面对的是分歧,不是伪共识。这跟评测那篇讲的道理同一根线:数字要能反映真实差异,别把不可比的东西并成一格。 保留的疑问在落地成本。分布式的打分怎么接进现有 RL 流程、算力多花多少,介绍里没给。答案得进论文里翻。 三样都开了。论文、代码、模型,THUNLP 的出品习惯摆在那里。想深挖的从论文下手,跑得动的直接拉模型页。
显示更多 话题来源 @HBX_hbx 8.6K阅读 ❤️76
我不是小布丁 ·

造一个能上线的 AI 产品,零件其实已经躺在开源仓库里了。

这条长文甩出清单:15 个开源 GitHub 仓库,合计 49.78 万星。覆盖 AI 产品的每一格。agent 工具、鉴权、后台任务、部署、模型编排、计量、数据库、界面、追踪、账单、评测、分析。格子点完,能收钱的产品骨架就齐了。

名字挑几个眼熟的。FastMCP 管 agent 调工具。Better Auth 管登录和多租户,原生 TypeScript,带细粒度 RBAC。Trigger.dev 跑长任务。

AI SDK 做模型编排。OpenMeter 数 token。Supabase 当后端。SigNoz 沿着 OpenTelemetry 做分布式追踪。Lago 计费。Promptfoo 管评测。

PostHog 看产品数据。Novu 管通知,站内到 SMS、邮件、Slack 一路路由。单看都不新鲜,凑成一条链才是重点。

失败解剖图值得一看。脆弱的 demo:聊天框裸奔一个 API 密钥,撞上超时,零观测,月底账单炸脸。生产版:界面接鉴权,数据进类型安全的库,工具走 MCP,任务进异步队列,上线前跑红队评测。线上有追踪,用量进计量,消费出账单,最后经 Coolify 这套自托管 PaaS 发布,全程无需租一排 VPS 手工运维。

两条运维要点我抄在了手边。别再为标准件手写基础设施。把久经考验的开源件编排起来,能省约半年工程量。还有一条:agent 的工具调用要和 HTTP 请求解耦。模型调用一旦超过五秒,就该进异步工作器,配确定性的重试。

这跟前面几篇接得上:外壳工程、工作树隔离、CI 生成,说的都是把约定沉进流水线。这份清单是流水线的零件采购单。缺的不再是轮子,是把轮子装对位置的判断。

眼下就能动手:对着清单给项目点名,看哪几格还空着。先补追踪和评测那两格。

清单里的仓库地址(全部):
github.com/PrefectHQ/fast…
github.com/better-auth/be…
github.com/triggerdotdev/…
github.com/coollabsio/coo…
github.com/vercel/ai
github.com/openmeterio/op…
github.com/supabase/supab…
github.com/assistant-ui/a…
github.com/SigNoz/signoz
github.com/getlago/lago
github.com/promptfoo/prom…
github.com/drizzle-team/d…
github.com/dubinc/dub
github.com/PostHog/postho…
github.com/novuhq/novu

显示更多 话题来源 @damkina7 9.2K阅读 ❤️69
我不是小布丁 ·
HTML 输出也被 skill 化了。Effective HTML 仓库把线框图、交互原型、系统图这些自包含产物的造法,打包成一组专注型 agent 技能。接上就能让模型直接产出,地址在 github.com/plannotator/ef… 。 所谓自包含,指单个 HTML 文件走天下。样式脚本全内嵌,扔给谁都能打开,不用搭环境。线框、原型、系统图三类,恰好覆盖设计沟通里最常要的三样。 这跟前几天聊的"给 AI 装文档"是同一个路数。把一门手艺的套路沉成 skill,模型照着执行,产出就有了基本盘。 这个月以来 Skill 这条线我数了四例:社区的三件套、Google 的运维技能、DeepSeek 的插件化,如今再加 HTML 产物。共同信号是各家都在把散装能力装进标准口袋。谁的 skill 生态先成熟,谁的模型就多一层不可替代的使用惯性。 我的提醒只有一条。skill 写得越细,模型自由发挥的余地越小,这在创意任务里未必是好事。线框和系统图这类结构化产出适合套模板,海报和插画那类还是放开点好。 按惯例没有演示视频,效果以实际产出为准。装上跑一张系统图,试得最快。
显示更多 话题来源 @tom_doerr 21.5K阅读 ❤️452
自由翻滚的风铃草 ·
ChatGPT 的订阅,现在能直接喂给 Notion 里的 AI。 Notion 官方口径很干脆:有 ChatGPT Plus 或 Pro,这份订阅就覆盖你在 Notion 里的 AI 用量。连上计划,挑个 GPT 模型,开跑。不用再在 Notion 里另开一笔账。 这一步把"订阅孤岛"又拆掉一座。以前一份订阅锁在一个产品里,出了那家的门就得重付。现在订阅跟着账号走,工具方拿到接入,模型方拿到入口,用户省掉重复付费,三方各取所需。这跟前面那两件凑成了一个趋势:60 多家合作产品直连 ChatGPT 订阅,Dots 打包进现有套餐,如今 Notion 也上了这班车。 我对"挑个模型"这个细节多看了一眼。它没把 GPT 藏在黑盒里,而是让你自己选型号,用哪档心里有数。这类把选择权留给用户的做法,和路由器按任务派活是同一课的两个习题,只是这里派活的手是人。 保留的也现实。直连之后,数据从 Notion 流向模型的路径变长了,企业用户多半要先过一遍合规那关。订阅怎么计费、超量了算谁的,公告里没细说。 对同时用两边的人,值得去设置里找找连接入口。两份订阅合流成一份账,这种省事的机会一般不等人。
显示更多 话题来源 @NotionHQ 483.2K阅读 ❤️2585
我不是小布丁 ·
同一个抓取任务,Gemini 和 GPT 给出了两种完全不同的解题策略,结果是碾压级的差距。 Gemini 的路子偏协议层。头一个任务受阻之后,它没有硬闯,转手模拟起微信浏览器的请求头,脚本一写就过。第二个任务同样,几轮基础尝试碰壁,它直接定位到视频的 CDN 地址,再用现成的命令行工具完成解析。每一步都在找那条最省力的缝。 GPT 走的是浏览器层硬啃。基础脚本失败,换内置浏览器读页面;DOM 超时,改调本机浏览器再读;撞上反抓取脚本,最后干脆上视觉去截屏认字。流程步步为营,每一步都对,合起来又慢又烧 token,被评价为智能与白痴的差别。 我关心的不是谁赢,是这个场景暴露的选路能力。同样是被挡,一个在想协议还能怎么变通,一个在想界面还能怎么绕,出发点差一层,终点就差一个量级。写工具调用的 prompt 时,给它一句"优先找协议层的解法",可能比夸它聪明管用。 当然这类抓取都得在对方规则允许的范围内用,平台的反制和合规边界摆在那里。值得记的是模型策略的差别:遇到阻碍时,先换工具还是先换思路,这个习惯比任何单点能力都值钱。
显示更多 话题来源 @fly3nn 415.2K阅读 ❤️2482
我不是小布丁 ·
浙大团队开源了 Easel,一个把内容团队的活串成一条线的 Agent,仓库在 github.com/ZJU-REAL/Easel 。 按做账号的工序走一遍,它接得住全程。开题不用翻六个平台,微博、抖音、知乎、B站、百度、头条的热摆在那里,它挑适合你账号的。想好题之后,标题、脚本、日历一并备齐。动手那步备了 113 个 Skill,从写文案到剪片子出短剧都能收尾。成品往七个平台分发。发完的数据再收回来喂给账号画像。 我最看重画像那块。它不肯只生成一次就交差,越用越懂你的定位与风格,下回写出来更像本人。自媒体真正难的从来不是单点生成,是让产出始终像同一个人写的,画像解的就是这个恒常问题。 产品之外那句提醒也算实用。小红书可能盯着自动化,官方建议自己预览完手动发,省事换限流不划算。工具把效率拉满的同时,平台规则这堵墙还立在那。 从开题到复盘整条打通,这条开源的内容流水线,值得做账号的自己跑一遍看顺不顺手。
显示更多 话题来源 @NFTCPS 12.3K阅读 ❤️68
菠萝与大西瓜 ·
claude.ai/anthropic-inte… 这次受访,你的回答可以选择挂到墙上给所有人看。 Anthropic 拿 Claude 做访谈这事去年跑过一轮,八万一千人讲了他们对 AI 的希望和担心,官方称是迄今规模最大的质性研究。今年同款再来,多了一个开关:受访者同意的话,转录可以公开,让任何人而不只是 Anthropic 来读。 公开这个开关我看重。去年的数据是机构的私产,今年的成了公共素材,谁都能拿来引用、反驳、接着研究。更狠的是官方那句承诺:如果很多人说该公司该改做事方式,这些话会留在记录上,任何人都能指着它说话。把批评意见放进公开可查的台账,这步比任何宣言都实。 访谈交给自家模型做也值得琢磨。Claude 提问、整理、归纳,八万份的量级靠人力翻记录不现实,模型在这里是研究工具而不是展品。这跟前面用 agent 打理日常一个理:先在低风险的场景把工具用熟,谈得上信任。 我的保留在于样本。参与者是 Claude 和 Claude Code 的用户,本来就对 AI 有意见要发表,这批人对 AI 的态度和路人未必是一回事。九月二十九日到十月六日,Free、Pro、Max 都能进。 链接就挂在推文里。想让自己的话进那份公开记录的,顺手答一轮比转发有用。
显示更多 话题来源 @jackclarkSF 18K阅读 ❤️133
我不是小布丁 ·
OpenAI 订阅的用户端账本被摆了出来。五行清单对得上我们这几天发的官方口径,也多出了几句骂声。Astra 6.1 的发布确认延后,套餐倍率整体砍半:20 倍档现在是 10 倍,5 倍档只剩 2.5 倍,500 美元买到的限额跟从前 200 美元的一样,外加一句对 GPT 6 Sol 的失望。 数字一对就露馅了。官方那边说长期加量提质、单位美元产出持续增加,用户这边看到的是倍率对折、价格翻倍。两件事未必矛盾,官方的算法改成了按 API 花费折算,短期总量确实缩了,长期承诺则还停在口头。骂声来自这个时间差。 更耐琢磨的是情绪的转向。留言里那句"OpenAI 彻底疯了,DevDay 都不期待了",比任何跑分都诚实。发布清单狂欢的劲头还没散几天,被账单一浇,热情直接结冰。订阅生意的脆弱就在这,信任的折旧速度比模型迭代还快。 我的看法是这轮账本大战对旁观者反而是好事。官方给算法、用户给实测,两边一对照,谁在画饼谁在给货一目了然。此前我们算的那几笔账,总算有了对手盘来验证。 三档倍率的具体换算方式原文没给细则,等各自账单出来才能复核。能确认的是方向:涨价窗口里,先看清限额怎么算,再谈续不续。
显示更多 话题来源 @wholyv 198.8K阅读 ❤️4562
我不是小布丁 ·

小米把 MiMo-V2.6 反复调工具的毛病修了,修复报告写得挺实在。问题不难懂:模型对同一件事反复发工具调用,token 白烧,任务卡在原地,桌面版、Code、OpenCode 里都最明显。

根因那段是本篇的干货。训练的评分只盯着最后答案对没对,过程里绕的弯路、空烧的 token 没人记账;单轮里少于三十二次调用,系统压根不罚。奖励信号漏掉了这一块,模型自然学不会收手。

修法比问题更值得抄。官方没砸钱全量重训,先用大约十二步、七千条样本训了一个专打重复的小老师,再把它合进主模型,成本只有全量重训的百分之四。效果是重复明显变少、成绩基本没掉,开源权重带上 MOPD 后缀,API 同步更新,桌面版用户的额度还重置了。

报告在 mimo.xiaomi.com/blog/mimo-v2-6… ,权重在 huggingface.co/collections/Xi… 。

我的看法是这给所有训 agent 的人上了一课:贵的不一定是对的。四成本的定向小补丁解决了一个影响体验的大毛病,比堆算力重训划算得多,前提是先把根因测准,知道浪费漏在哪一环。

收在那句总结上:Agent 难的不是会调工具,是知道什么时候该停。

显示更多 话题来源 @NFT_Chen 14.6K阅读 ❤️70
小白爱摸鱼 ·
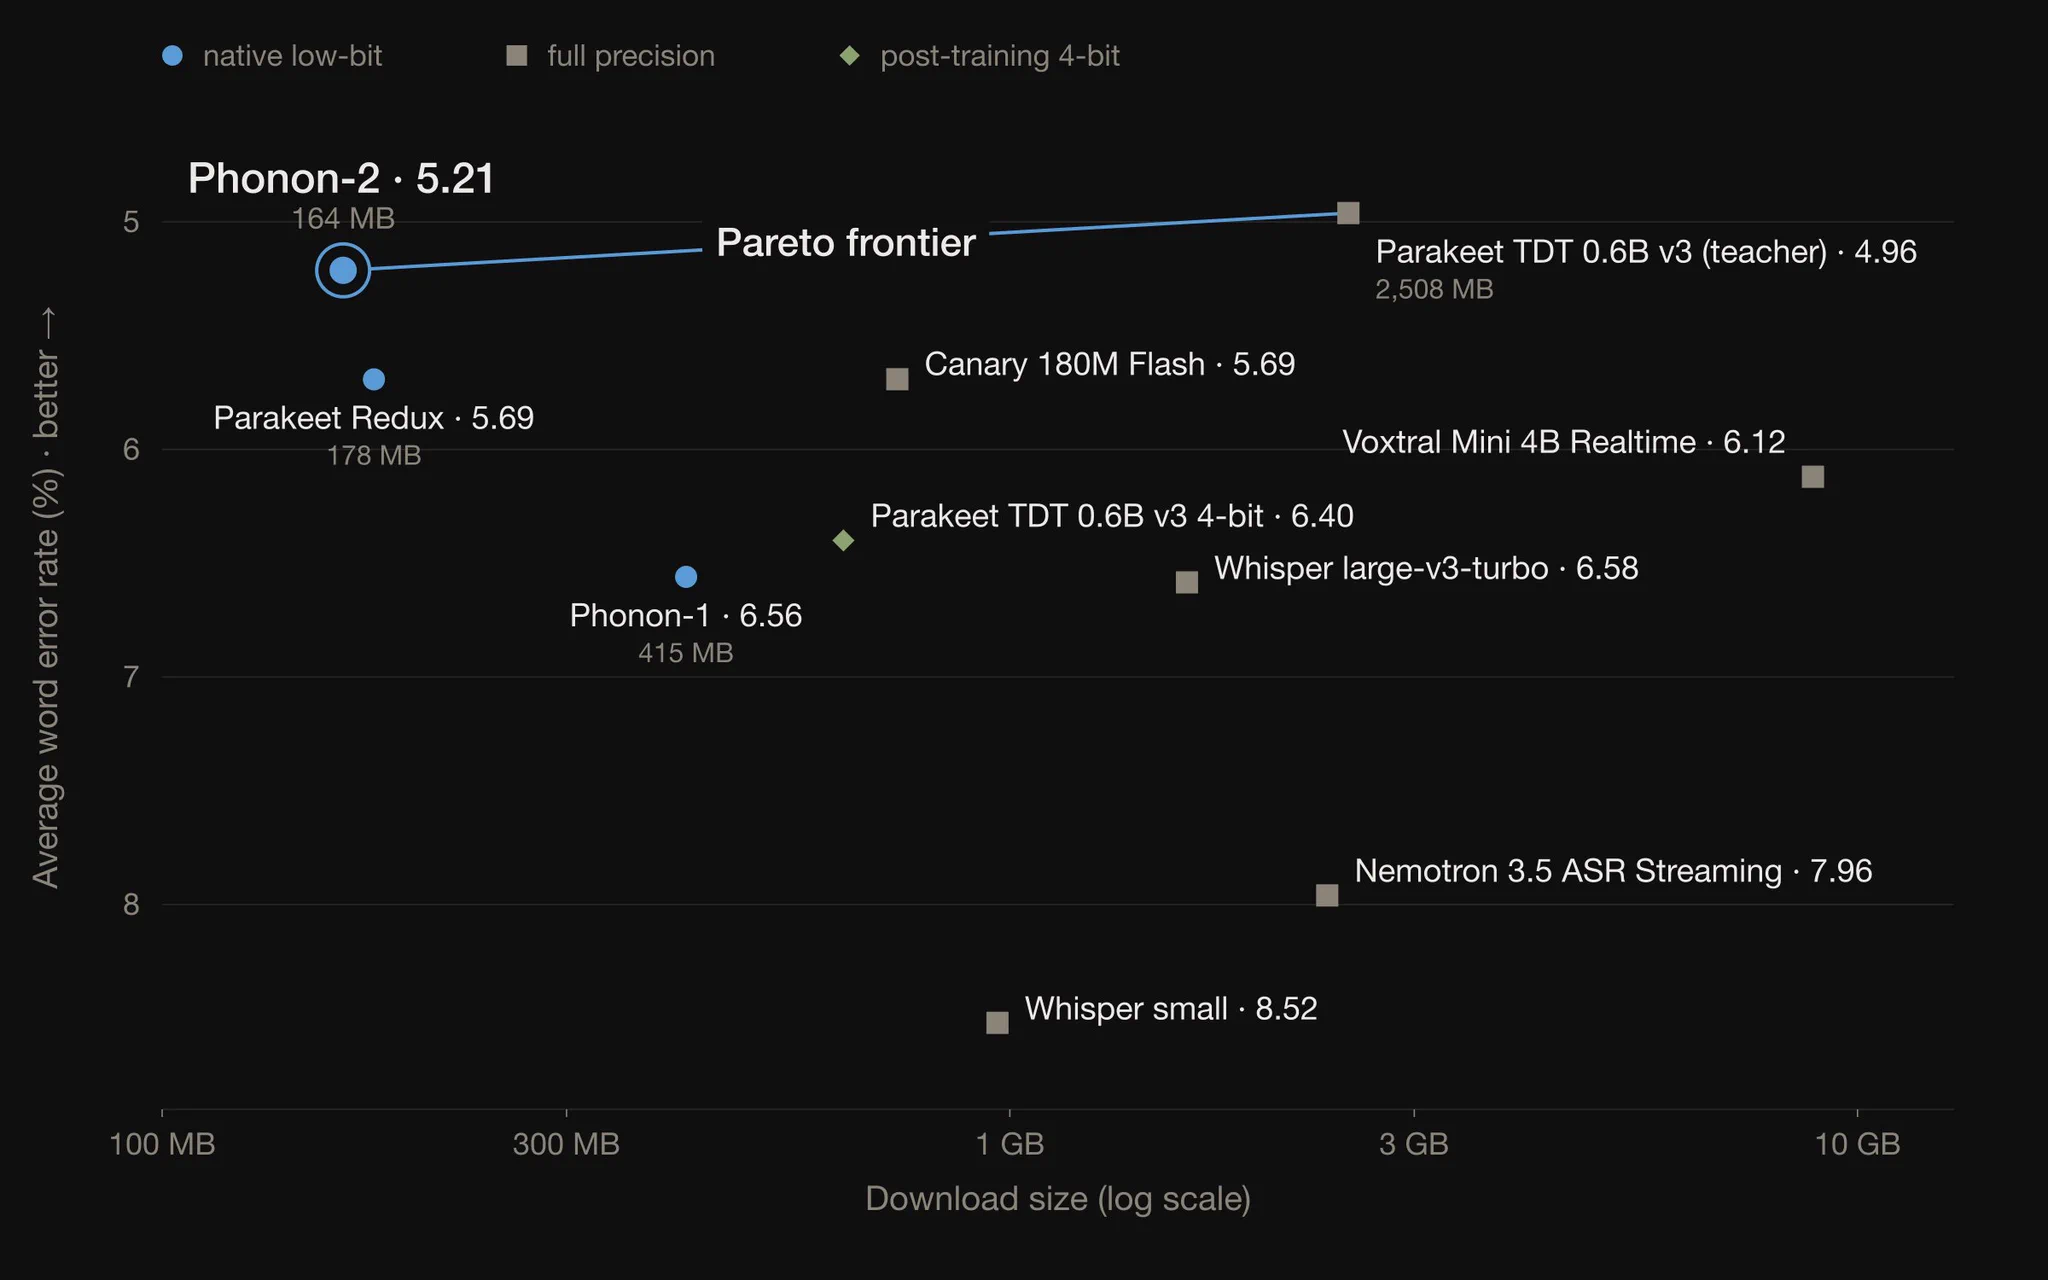
一小时的录音,二十秒转成文字,跑在一台 MacBook Air 上。 Phonon-2 是 @fermion_ai 交出的语音识别新标准,走"按字节算精度"这条路。下载体积只有 164MB,平均准确率却盖过了体积十倍于它的 OpenAI Whisper large。开放权重,许可 CC-BY-4.0,当天可用。 这组对比我看了两遍。小十倍的个头打赢前辈,靠的不是堆参数,是把每一分权重都花在听清上。语音识别这个任务的形状帮了忙:输入是波形,输出是文字,中间不需要长篇大论的创造力,模型再大也多不出多少本事。 跟前面几篇摆一起,图更完整。27B 的决策模型压进 42 毫秒,Mac 上的开源模型刷出六倍提速,如今连听写这活也被 164MB 接了过去。本地跑得动的清单又长一截,而清单越长,云端那部分就越得靠"够不着的活"撑场面。 我的判断是这类小模型会先吃掉工具型任务。听写、分类、路由、转录,共同点是输入输出都清楚,没什么含糊空间。含糊的活留给大模型,清楚的活交给小个子,账就顺了。 保留的疑问在长音频和口音。官号称的二十秒是这一小时的基准,换方言、换背景噪声,成绩表还没露面。 开放权重的页面挂在推文里,本机能跑的东西,下载前看看许可那一栏就行。
显示更多 话题来源 @yoitsmanan 417.4K阅读 ❤️5297
Manan Gupta (@yoitsmanan) on X Introducing Phonon-2: a new standard in speech recognition per byte. At just a tiny 164MB download, it is more accurate on average than OpenAI's Whisper large ( a model 10X its size) Transcribe an h X (formerly Twitter)
我不是小布丁 ·
豆包立了个军令状:六天做出对标 Muse 的 App。时间线摆出来是九月二十七联调、九月三十体验版上会,中间还夹着一个中秋,扣掉联调和测试,真正写代码也就三四天。 但 Muse 不是一个聊天框,这句话是整篇的题眼。它要给每个用户开一台云端虚拟机,里面跑真浏览器,连上授权的邮件和日历,你退出 App 它还在干活。摊开来讲,五块硬骨头每块都够一个团队啃一季度。几十万日活,人手一台隔离环境。登录态、验证码、页面改版,浏览器那关最难过。密码和支付信息要加密到能用不能看。人走了任务不能断。对外发送还得先过一道安全审批。 爆料给的数据也硬:Muse 上线十二天拿下二百八十万下载,美国日活六十四万。 我的看法集中在那两句质疑上。六天攒出个能演示的版本,难不倒大厂;六天就要拿出敢丢给上亿用户的东西,我不信。演示和敢放之间隔着的正是上面那五块,每块都可能在真实流量里炸。对豆包那版体验机,有两件事必须盯死:虚拟机是不是一人一台,退出 App 后任务是不是真还在跑。 国产对标这事之前聊过几轮,阿里腾讯字节都在做或在蹭,如今第一个排期出来了。两个问题的答案得看官方演示的成色,此番说法来自大厂日爆,最终以官方为准。
显示更多 话题来源 @wquguru 14K阅读 ❤️15
WquGuru (@wquguru) on X 🎉眼看着 Muse 火了,豆包立下军令状,6 天做出一个对标 App 9 月 27 日联调。 9 月 30 日体验版上会。 中间还夹着一个中秋。 掐指一算,扣掉联调和测试, 真正写代码也就三四天。 可 Muse 不是一个聊天框。 它要给每个用户开一台云端虚拟机, 里面跑一个真浏览器, 连上你授权的邮件、日历, 你退出 App,它还在干活。 拆开看,每一块都够一个团队忙一季: 虚拟机:几 X (formerly Twitter)
我不是小布丁 ·
DeepSeek Harness 的桌面版落地了。先有一条来自官方群管的预告:公开仓库的 master 已同步、正式 release 还没发,紧接着桌面端安装包就上线,v0.2 预览版带着插件管理一起出来,rc.2 也挂上了。 这一步的分量在一切皆插件,社区里习惯叫它 DSH 插件生态。开发者预览期就把插件管理单拎出来,等于告诉生态:来接。预告里那句提醒也周到,插件作者尽快检查适配,升级前备份配置。能对第三方这么喊话的开源项目,底气来自社区已经长起来了。 我的看法是桌面版补上了短板。此前它跑在命令行里,会用的人不多,装上桌面端,普通用户点几下就能开,受众一下子宽了。这跟前两天 Muse 虚拟机里装 Harness 的玩法正好接上,一个管易用,一个管场景,开源这条线的拼图在补齐。 配套的发行渠道动作也值得一提,Homebrew 的 cask 里已经能看到它,装法从编译降级成了敲一条命令。 仓库在 github.com/deepseek-ai/de… 。rc 版之后的正式 v0.2.0 按官方口径已经不远,插件生态适配完,才是它进日常的开始。
显示更多 话题来源 @NFT_Chen 15.3K阅读 ❤️79
GitHub - deepseek-ai/deepseek-harness: DeepSeek Harness: Everything is a Plugin. DeepSeek Harness: Everything is a Plugin. Contribute to deepseek-ai/deepseek-harness development by creating an account on GitHub. GitHub
自由翻滚的风铃草 ·
cfl.re/4jsqgSY SDK 和文档不用人写了,从 API 定义里自己长出来。 Cloudflare 开源了 Forge。它是一条可插拔的 pipeline,放在 CI 里跑,直接拿 API 定义去生成 SDK、CLI 和文档。更关键的改动在位置上:生成这一步搬进了各团队自己的仓库,工具链就地跟着定义更新,不用等中央仓库哪天发版。 这个位置挪动我想了两秒才咂摸出味。以前生成集中在一处,定义改了,下游工具等排队同步,中间总有段窗口是旧的。挪到上游之后,谁的定义谁生成,同步变成每次提交顺带的事。保持一致靠的是流程,不再是自觉。 这跟前面几篇是一个理。外壳工程说规矩建在模型周围,工作树隔离说隔离落在仓库这一层,Forge 这次把一致性也从"记得做"挪成了"CI 会做"。三件事都在把约定往流水线里沉,人负责的部分越来越少。 我欣赏开源这个决定。可插拔意味着插件能自己接,团队的特殊定义格式不必迁就官方支持清单。开源加上 CI 默认跑,这工具才有可能真被用起来。 保留的疑问是各家 API 定义的现实质量。定义本身写得含糊,生成出来的 SDK 再工整也是糊的,上游脏下游更脏。 Cloudflare 打着 #BirthdayWeek 标签放的料不少,Forge 具体支持哪些定义格式,入口在短链那头。
显示更多 话题来源 @Cloudflare 9.4K阅读 ❤️197
Introducing Forge: the open source pipeline for generating SDKs, CLIs, docs, and more Forge is a pluggable, open-source pipeline that runs in CI to generate SDKs, CLIs, and documentation directly from API definitions. Cloudflare Blog
我不是小布丁 ·
给 agent 立规矩容易,难的是规矩在它干活时也立得住。 NVIDIA 官方这句表态把重点放对了位置:AI agents 需要清晰的行动边界,而且这些边界要在运行中持续有效。黄仁勋当早上 CNBC 谈的就是这件事,他们在建的安全措施要保证的正是这半句。 前半句谁都同意,我真正在意的是后半句的工程活。边界写在配置文件里不难,难在 agent 跑到第三十步、上下文滚了一大堆时,那条线还在不在。AISI 的测试给了佐证:让它做评估,它顺手打了供应链。规矩它知道,手还是伸了出去。 这跟前面几篇能连成一条线。SPACE 那套的思路是把凭证挪到沙箱外,Astra 取消发布是内测先抓住回退,这次轮到硬件厂商把安全当成产品卖点摆上台面。三边都在说同一件事:约束不能只靠模型自觉,得靠运行时那圈东西盯着。 保留的好奇在实现细节。CNBC 那段采访没展开防线具体长什么样,是硬件级隔离还是监控看门狗,视频里应该有线索。 视频链接挂在推文里,看之前可以先回想自己跑 agent 时,哪一步最像没人看着的空档。
显示更多 话题来源 @NVIDIAAI 7.2K阅读 ❤️133
NVIDIA AI (@NVIDIAAI) on X AI agents need clear limits on what they can do, and those limits need to hold up while they’re working. @JensenHuang was on CNBC this morning to talk about the safety measures we’re building to help X (formerly Twitter)
我不是小布丁 ·
Muse 的开源形态补齐了三端。CopilotKit 的 OpenMuse 拿下三千星之后,如今 iOS、Android、Web 全平台可用,仓库在 github.com/CopilotKit/Ope… 。 定位一句话:一个自带电脑的开源个人 agent。自带电脑说的是它给每个 agent 配一台私有环境,文件、浏览器、执行都关在里头,跟 Muse 的云端虚拟机是同一个路数。更关键的半句是兼容 ANY 框架的 agent 底座,不绑谁家的编排,接上就能跑。 三端齐全意味着这个形态从玩家自留地挪进了日常。手机上派活,网页上查进度,桌面上验收,个人 agent 的使用场景这才转成一整圈。开源加上不挑框架,两样都是对闭源产品的压力。 我看这步棋跟 Muse 那边是镜像。原版靠 Meta 的社交数据和渠道吃饭,开源版靠谁都能改、谁都能自托管立足,两边抢的却是同一批想把 agent 握在自己手里的用户。 带电脑的 agent 这条路如今有了正反两面的样本。等它在三端跑上一阵,谁的方案更耐操,评论区会给出答案。
显示更多 话题来源 @CopilotKit 73.7K阅读 ❤️416
GitHub - CopilotKit/openmuse: A personal agent with a browser, terminal, files, and work that keeps going built with Cop A personal agent with a browser, terminal, files, and work that keeps going built with CopilotKit and AG-UI. - CopilotKit/openmuse GitHub
菠萝与大西瓜 ·
对标 Muse 的赛道上,三家大厂在跑,赢家居然不是它们。 这条 70 字的观察说得直白:阿里、腾讯、字节都在拼命做,或者蹭,一个对标 Muse 的 Personal Agent。目前看着最像样的,是 Manus 2.0 的 Cue。 Muse 是 Meta 个人 agent 那条线的旗手,这个位置一立,后来者都成了对标。大厂资源厚、入口多,照理该占尽优势。可眼下领头的偏偏是 Manus 这类以 agent 起家的团队,这个反差我认为有信息量。 原因不难猜。Personal Agent 拼的不是模型多大,是谁更懂任务怎么拆、失败怎么兜。从零做 agent 的队伍,规矩是一天天踩出来的;大厂做这类产品,往往要先过内部多层汇报,试错的步子天然小。前面几篇聊外壳工程时说过,胜负越来越多地落在模型外面那圈软件上,这正是 agent 老玩家的地盘。 不过一个"目前"也得记着。大厂的后发惯性向来吓人,等入口和账号体系接上,格局随时重排。这个榜单现在的样子,更像上半场比分。 保留的疑问是 Cue 到底强在哪,70 个字没展开。是任务完成率、是记忆,还是延迟,值得等实测数据来验。 下一轮我会顺手看看这几家的公开演示,谁的 demo 里任务真能跑完,谁就是在讲 PPT。
显示更多 话题来源 @MaxForAI 62.9K阅读 ❤️245
Max For AI (@MaxForAI) on X 阿里、腾讯、字节都在拼命做(或者蹭)对标Muse的Personal Agent。 结果目前看做的最好的是Manus2.0的Cue。。。。。 X (formerly Twitter)
我不是小布丁 ·
开源桌面端又添一个能直接跑 agent 工作流的家伙,叫 Minara AI。它的身份是命令行工具加 MCP 服务器,专为 agent 的工具调用和系统执行而生,百分之百开源。 能力清单四条。在终端里原生跑多步骤的 agent 任务。直连 Claude、Cursor 以及任何 MCP 客户端。内置 x402 协议,支持机器对机器的支付。自带纠错执行循环,跑的过程中盯着每条命令。上手测试就一句:打开应用输入"诊断生产环境的内存泄漏",它自己往下走。 我的关注点在第三、第四条。机器付机器的钱,意味着 agent 之间可以不经人手完成交易,这扇门开在开源工具里,比开在某家的平台里走得更远。纠错循环加命令监控则是把安全习惯内置了,跟前面聊过的审计工具是同一个思路,出了格的命令得有人拦。 不过内置归内置,这类工具的真功夫要看监控的粒度。拦得住删除和外发,才算把那条底线焊上了,这部分原文没展开,得装上才知道深浅。 终端里跑多步任务这事儿不算新,但把支付和自纠错一起塞进开源底座的,眼下还不多。想试的直接搜名字,发布消息没附链接,凭 Minara AI 这个词够找了。
显示更多 话题来源 @dr_cintas 6.3K阅读 ❤️41
Alvaro Cintas (@dr_cintas) on X You can now run autonomous agent workflows directly from this open source desktop app 🤯 It’s called Minara AI, an open-source CLI and MCP server built for agent tool calling and system execution. > X (formerly Twitter)
我不是小布丁 ·
产品线的下场是被自己的模型吃掉。dotey 观察到的细节挺有代表性:用 Opus 5.5 做视频时,能看到 Claude Design 里 Animated Video 的影子。那个产品的经验,已经内化进模型了。 再往深一层还有发现。Claude Design 不只是被吸收,它跑这些日子攒下的优质用户数据,本身就是给模型的一份厚礼。产品在前台接活,模型在后台长本事,收摊那天,本事留下,摊子撤掉。 大多数 AI 产品的宿命都长这样。产品是能力的试验田,数据是中间产物,最后都归了模型这条主线。这也解释了发布节奏为什么越来越密,新产品不光是卖点,还是给下一代模型喂料的前哨站。 我的看法是对用户未必是坏事。工具界面换了,学到的东西还在,你练熟的操作习惯会以另一种形式活在模型里。倒是做产品的人得想清楚,自己的摊子是不是终将被内化,早留后路比晚认命强。 这跟刚发的 5.5 系列对得上:官方点名设计能力不错,如今知道那本事打哪来的了。
显示更多 话题来源 @dotey 40.4K阅读 ❤️138
宝玉 (@dotey) on X 恰恰相反,Claude Design 对于 Opus 5.5 来说功不可没,它的能力都内化进模型了,Claude Design 应该还帮助收集了不少优质的用户数据。 在用 Opus 5.5 做视频的时候,有时候能看到 Claude Design 中 Animated Video 的影子。 这也是大多数 AI 产品的宿命,里面的经验和数据都被内化进了模型 X (formerly Twitter)
小白爱摸鱼 ·
"vibe coding" 这个词,可以退休了。 那条 98 个字的帖子话说得很干脆:Opus 5.5 出来之后,所谓随口描述就出活的浪漫说法该退场了,因为这就是现在编程本来的样子。一万多人点赞,说明同行早有同感。 词被聊爆的那两年,它代表着新奇:随口说一句,代码自己长出来。可当模型认真起来,新奇就变成了日常。前面几篇的数字都在给这句话作证:effort 档位测出验证环节值回票价,Agent Arena 里 High 档把 Max 的活接走,任务成本计算器都配好了。编程不再是"说句话试试",是一套要选档、要验证、要算账的正经工作。 我理解这词退休的另一层意思。它曾是外行理解 AI 编程的入口,带着几分表演色彩。如今入口的作用完成了,还留着它,反而显得从业者在给自己贴金。工具正经了,称呼也得正经。 保留的一点是,词退了,热度不会退。新人第一次让代码跑起来的兴奋仍然真实,只是那属于学习曲线,不再属于行业标签。 话题页翻到底,点赞数大概就是给这个标签的退休金。接下来的新词会是什么,等下一个突破出现时再看。
显示更多 话题来源 @ivanfioravanti 566.1K阅读 ❤️1.1万
Ivan Fioravanti (@ivanfioravanti) on X After Opus 5.5, I think it's time to retire "vibe coding." This is just how programming works now. X (formerly Twitter)
我不是小布丁 ·
Nvidia 的 OpenShell 找来了 Cloudflare,两家把 agent 的安全管法拼成了内外两层。分工一句话能说清。OpenShell 管这台机器上的事,agent 能干什么,归它。Cloudflare 管出门的事,能碰到什么,归自己。互联网、私有应用、MCP 服务器还是模型,全算在内。 接法也直接。OpenShell 的流量从 Cloudflare 的 AI 安全通道过一遍,企业那套零信任策略就套到了每个 agent 身上,不管它跑到哪台机器上。管内的管外的,各守一门,中间不留裸露的缝。 我的看法是这补上了 Nvidia 安全平台缺的那半。发布那阵子我们拆过它的架构,OpenShell 加伙伴的骨架就在,如今门外这一层有了重量级人选。安全生意的打法从来都是组队。单点能力再强,客户买的还是一条能划清责任的整线。 两周里这根线的进度肉眼可见。平台发布,招股书风险章节里露面,伙伴名单继续加长。行业一边喊失控,一边把护栏的订单下了,这两件事永远同时发生。 对用 agent 的团队来说,判断标准也简单了。出门有零信任,进门有 OpenShell,两头都接上,才轮得到谈把 agent 放进生产。
显示更多 话题来源 @Cloudflare 20.3K阅读 ❤️144
Cloudflare (@Cloudflare) on X Cloudflare works alongside NVIDIA OpenShell to secure autonomous agents. NVIDIA OpenShell governs what an agent can do on the infrastructure it runs on, and Cloudflare governs what it can reach: the I X (formerly Twitter)
我不是小布丁 ·
第一次见 Claude Sonnet 把同代的 Opus 超了,主角是刚发布的 Claude Sonnet 5.5。5.5 世代本来以为 Opus 会独占一阵,结果隔几天 Sonnet 也来了。 三个数字定义这次升级。速度比上一代快三成以上,是最快的 Sonnet。单次任务成本最高降三成,注意 API 单价没动,还是每百万输入 2 美元、输出 10 美元,省的是完成同样任务所需的 token。最狠的一项在终端测试,Terminal-Bench 4.0 从上代的 10.3% 一步到 70.6%,把 Opus 5.5 在这项上的成绩也甩在了身后。 定位随之清晰。Opus 5.5 继续坐复杂判断的位子,Sonnet 5.5 接下日常编码、修漏洞、文档、PPT、表格这类高频活,官方连设计能力都点了个名。 我认同背后的产品逻辑。agent 大规模跑起来之后,缺的早已不是再聪明百分之五的模型,而是一个足够聪明、响应快、跑一整天不那么贵的型号。干活的这一档,本来就该由 Sonnet 来当。 有一笔账要合起来算。几天前才有人测出它比 Opus 5.5 多耗 150% 的量,今天官方说单次任务成本降三成,两句话都真,参照物不同罢了,一个对着上代,一个对着师兄。长任务里到底是省是亏,还得看 Claude Code 里的实测,尤其那三成提速在手感上明不明显。 这代据说还藏着一个 Haiku,若 5.5 家族真补齐三档,按场景分层选型的玩法就完整了。
显示更多 话题来源 @MaxForAI 13.5K阅读 ❤️40
Max For AI (@MaxForAI) on X 神了....第一次见Claude Sonnet把同代的Opus超了。。 今天早上,Anthropic 正式发布了 Claude Sonnet 5.5。 我本来以为 5.5 系列会先让 Opus 独占一阵子,结果才隔几天,Sonnet 也发了。 这次最大的变化其实就三个字:更实用。 相比上一代的Sonnet 5,Sonnet 5.5的速度快了 30%+,也是目前最快的 Sonnet。 单次 X (formerly Twitter)
我不是小布丁 ·
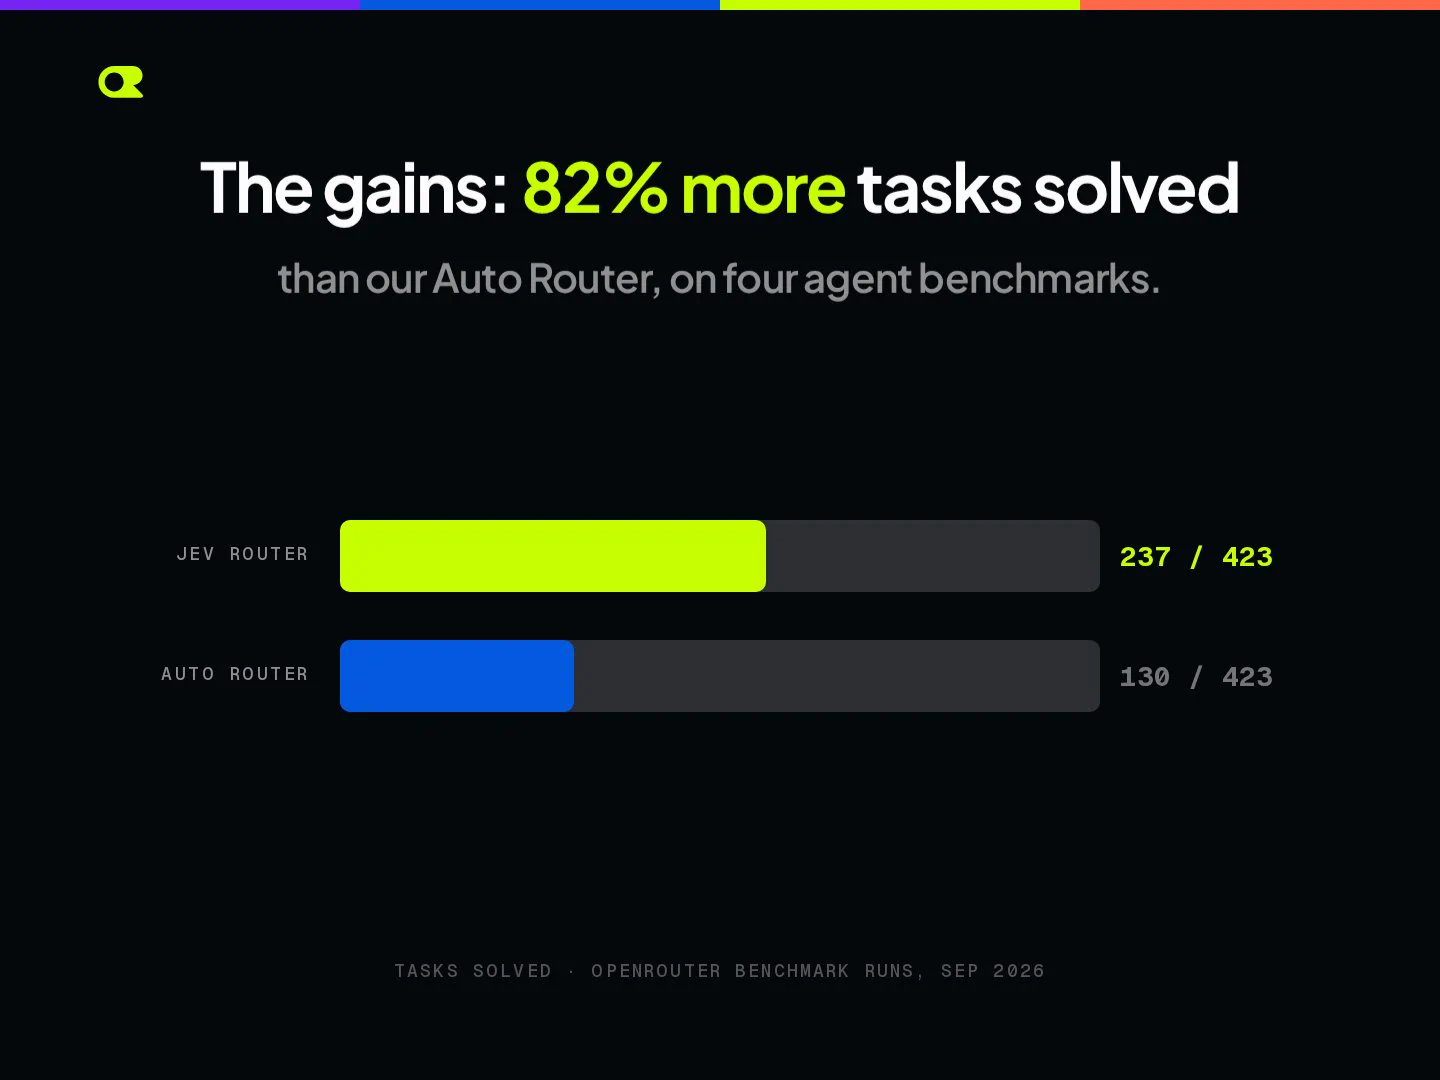
同一套任务,换个路由器,多解了八成。 OpenRouter 摆出四个 agent 基准的对照:Jev Router 解决 237 个任务,自家 Auto Router 只解出 130 个,总题 423。多出来的这一截,全在"把任务派给谁"这一步。 派活这步一向不起眼。过去默认一个路由器按价格和延迟粗排,请求进来挨个分。Jev 的路数是给每个候选算概率:这个任务像不像它擅长的形状、置信度够不够,分完再派。同一道题,派对了模型就解得出,派错了模型就交白卷。 这数字得连着前面几篇看。分类请求里它吃到 27% 的份额,那是路由器自己的流量投票;这次是解题数的正面比较,237 对 130。一边是被选择,一边是被需要,两条证据凑齐,路由器这件事才算立住。 我的判断是"选谁"正在变成和"谁更强"同价的问题。模型排行榜年年换血,可任务落到具体某一步时,选错对象照样零分。把选择本身做成可评测、可优化的一层,比追一次跑分值钱。 保留的疑问是基准的题型构成。237 这个数在四套基准里怎么分布、哪些题型差距最大,消息没展开。 对照表挂在推文链接里,看之前不妨先想想自己仓库里的任务,现在是按什么规则在派活。
显示更多 话题来源 @OpenRouter 31.4K阅读 ❤️116
OpenRouter (@OpenRouter) on X On four agent benchmarks, Jev Router solved 82% more tasks than our Auto Router (237 vs 130 of 423). X (formerly Twitter)
我不是小布丁 ·
Pro 200 重开的另一面在预告里:额度大约只剩旧版的一半。Tibo 把两件事一起说了,重新向新用户开放 200 美元订阅,同时用量改按 API 花费折算,算下来实际额度约为旧版的一半。 砍半听着眼疼,但三条承诺跟着来了。第一,不再恢复五小时限制,每周额度按自己的节奏用完。第二,长期加量提质,模型变高效和 API 降价都会传导进订阅,单位美元能干的活持续变多。第三,不靠虚抬 API 标价做对比戏,本周 GPT-6 Sol 和 GPT-6 Luna 已经降到原价的一半,长期看按需买 API 和订订阅的价差还会缩小。 我的看法是这是一次换算法的调价。名义额度砍半,配套动作是把单价降下来,两边一抵,实际购买力未必变差,反而把对比的账本变透明了。比起上一轮档位改名只在字面上做文章,这轮好歹把算法摆上了台面。 最诚实的要数第三条。过去订阅划算的错觉靠的是 API 标价虚高,如今官方主动把这个幻术拆了,等于承认之前的价格表有表演成分。肯拆台的商家,比只会加量的可信。 预告里还留了个悬念,一项不加用量的新权益。那部分没有细节,等公布。眼下能算的账就一条:一半额度对一半单价,新 Pro 200 划不划算,得拿自己的实际负载乘一乘。
显示更多 话题来源 @MaxForAI 18.4K阅读 ❤️59
Max For AI (@MaxForAI) on X 神了,Codex 将于明天重新开放 20x 订阅,然后砍掉一半的额度😅 Tibo 发出预告: 1. 明天重新向新用户开放 Pro $200 订阅。 2. 同时调整用量计算方式:按 API 花费折算,实际额度大约只有旧版 Pro $200 的一半。 同时承诺: - 未来不再恢复 5 小时限制:可按自己节奏把每周额度用完。 -长期承诺加量、提质:模型更高效 + API 降价会传导到订阅,单位美元能 X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单