AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
会飞的荧 ·

一位做短片的人把"白模预演"推上了生产线:整部片子 80% 的镜头先用粗模白模生成一遍,再进入正式流程——首次把这条工作流投入生产,他给的效果词是"恐怖":10 分钟完成一个镜头,不用抽卡,只有个别镜头需要二次生成;他还补了句趋势判断:越来越多人在学白模或深度视频辅助生成,本质都是给黑盒过程增加确定性,纯写提示词的方法正在被淘汰。

白模是什么,值不值钱,先说清楚。它是三维流程里的老传统——正式渲染之前,先用最粗糙的几何体把镜头摆一遍:机位对不对、人物在不在位、遮挡合不合理,全部在"没有材质、没有光线"的裸状态下先跑通。它丑,但每根线条都是确定的;把它搬进 AI 生成,等于在最不确定的模型前面立了一块确定的草稿板。

这就把出片线这几天的工程化路线串全了:第一层,资产先锁定(角色别变脸);第二层,位置写进画面(颜色当路标);第三层,就是这次的结构先预演(白模把调度定死)——三层都在做同一件事:把"希望模型猜对"换成"由我先把规矩立好"。

提示词派和结构派的分野也在这句话里收了尾:纯提示词是把一切押给黑箱的运气,白模是先给黑箱画好答题框;当确定性的收益大到"十倍效率",迁移就不再是选择题。

"不用抽卡"这四个字,对做过 AI 视频的人来说胜过千言。抽卡的本质是接受随机性——生成十次挑一次,成本按十倍计;预演把随机性压缩在前段(草稿允许错),后段正式生成只在既定框架内做微调,于是单镜成本掉回一次量级。随机性没有消失,是被挪到了最便宜的地方——这与工程里"把风险前置到测试阶段"是同一条铁律的影像版。

给想上这条流程的人一句落地的:先挑三个最难的镜头(多角色、大调度、镜头衔接)做白模对照——同一场戏,纯提示词直出一次、白模预演一次,把耗时和重生成次数摆在一起看。数字通常不用等三场戏就见分晓;确认了收益,再把 80% 这个比例移植进你的流程。

显示更多 话题来源 @Magncsans 3.1K阅读 ❤️55
Foyege (@Magncsans) on X 再说说AI视频白模的问题 为了让场景和角色保持一致性,我整部短片80%都使用了白模预演生成,并且都是粗模 这也是我第一次把白模工作流程投入到生产环节中 效率和正确率非常恐怖 基本上10分内完成一个镜头,不用抽卡,有个别镜头可能需要生成两次 这其实并不是一个很新的方法,在2.0的时候就已经可以有白模预演功能了 而现在越来越多人也开始学习怎么使用白模或深度视频辅助生成,其实都是为了让黑盒过程增加 X (formerly Twitter)
会飞的荧 ·

GitHub 的 Spec Kit 在极短时间里冲上了十万级 star,圈里的评价直白得吓人:vibe coding 最大的问题,被解了。它的主张一句话说完——别再把模糊 prompt 扔给 agent 然后祈祷它别搞坏你的项目;强制 AI 在碰代码之前先产出一份结构化规格:先弄懂你要造什么、把缺的问清楚、把项目组织好,然后才开始写。

六步流程也简单:/constitution 立规矩与标准、/specify 讲要造什么、/clarify 把疑问在动手前提掉、/plan 定架构与技术栈、/tasks 排出有序任务、/implement 执行;官方仓库在 GitHub 搜 Spec Kit,兼容 Claude Code、Cursor、Copilot、Codex、Gemini CLI 等二十多个 agent。(数据以官方仓库实时为准)

这等于给昨晚"规格驱动四步"配上了官方执行件。那篇讲的是吴恩达的框架——立宪、澄清、验证、重规划;Spec Kit 把同一套骨架做成了六个可敲的命令,还塞进了二十多个 agent 的兼容层——理念变成命令,是方法论第一次有了安装方式。

当晚另一篇 12.5 倍的实测刚说过:贵的不是模型,是寄送模型的方式;Spec Kit 改的正是寄送方式——让每一次请求都带着一份写清楚的规格出门,而不是一句随想随发的念头。

十万级 star 这个增速本身也是个信号。它说明"祈祷式编程"的痛已经大到人愿意排队解决——代码被搞坏的次数、返工的时长、agent 跑偏的惊吓,这些隐性成本第一次被一个工具清单化地收走了。规格先行省下的不是打字时间,是返工时间与信任成本:规格在,验收就有了对照物,agent 的交付才敢直接看;没有规格,双方都在猜,猜错的那部分全变成加班。

当然要留一格清醒:命令流只是骨架,规格的含金量还是取决于提问的人。/specify 写得含糊,后面每一步都在精确地执行一个错误的愿望——工具能强制"先写下来",不能强制"写得对";把 /clarify 那步用足,追着 agent 把含糊处问穿,才是这套流程真正的分水岭。

给想试的人一句落地的:下个小功能直接按六步走一遍,重点盯两处——/clarify 阶段它问出的问题有没有打中你没想到的盲区、/implement 完成后对照 /specify 的差异大不大。两处都好,你就有了一台可复用的流水线;哪处露怯,回去补的是你写规格的手,不是 agent 的工。

显示更多 话题来源 @BIGMayrr 1K阅读 ❤️17
Mayor. (@BIGMayrr) on X THIS IS F**CKING INSANE GitHub has just solved the biggest problem with vibe coding. They've just launched Spec Kit and in a short time it already has +126K stars. The idea? Instead of throwing va X (formerly Twitter)
自由翻滚的风铃草 ·
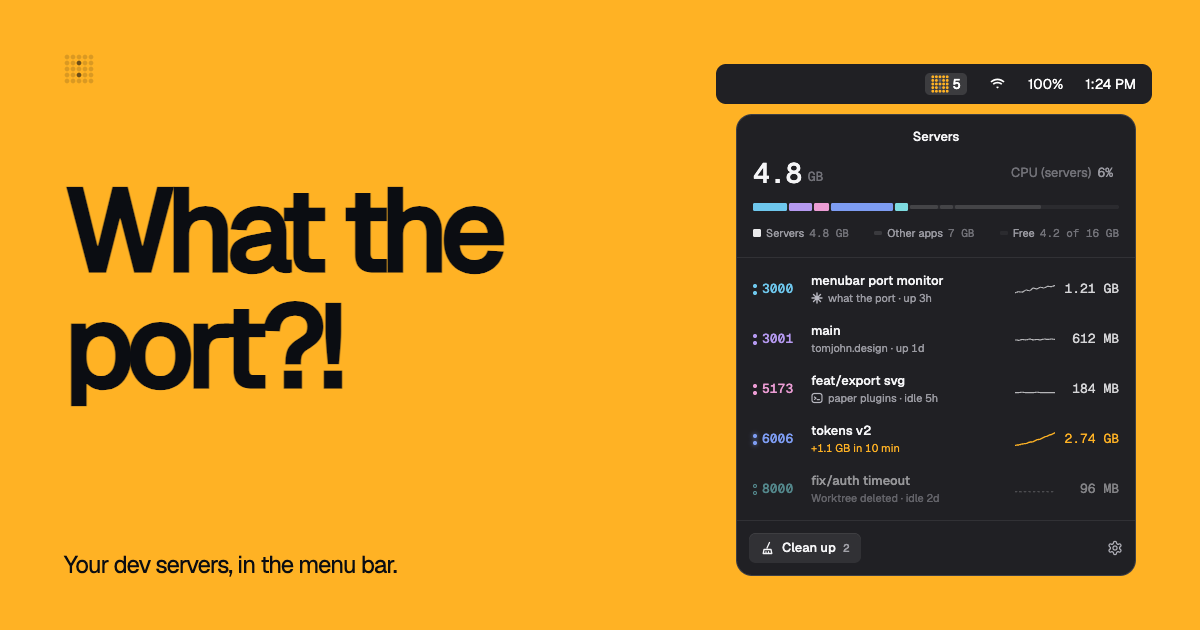
有人被本地服务器烦透了——拖慢笔记本、占着端口、不知道谁还在跑——于是自己做了个开源免费的小工具 WhatThePort:看哪些本地服务在跑、跑了多久、资源占用多少,尖峰时提醒你,老服务自动杀掉,URL 一键打开,还给 Vercel 预览链接、Codex 会话各配快捷入口,配上图表看尖峰。入口:whattheport.dev 这件小东西的妙处在于它挑的靶子。"本地服务器"是开发者最熟的隐形摩擦之一:调试时开了八个进程、转头忘了哪个还要用,关掉怕崩、留着怕卡——摩擦不在故障里,在"不确定"里。工具做的事全围绕破除不确定:谁在、多久了、吃多少、该不该杀——四个问题答完,那股"感觉电脑变慢了"的无名焦虑就落地成了几个可操作的按钮。 它也顺手给昨晚"不会抱怨的执行者"那篇配了副解药。那篇说 agent 不吭声、摩擦全靠主动问;这个工具把同一逻辑用在了进程上——它不问你,它替你盯着、主动报:尖峰提醒、自动清理,把需要人记忆的事变成了系统记忆。同一条原则换个对象:凡是靠"你记得"才能运转的环节,都该交给"它记得";人只保留"杀不杀"的判断权。 快捷入口那半句更见心思。Vercel 预览、Codex 会话、终端——一个本地服务的"前世今生"散在三四个地方,串起来的那一下,省的正是每次"我刚才是从哪启的它"的考古。这与"带得走、找得到"一脉相承:工具链越长,把断点接起来的价值越大;单点功能人人会做,接缝处的缝补才是经验活。 给同样被本地服务烦着的人一句落地的:先别上工具,拿一天时间数一数——你每天开关多少个本地进程、其中几次因为"不知道还在不在用"而纠结。数字超过五次,这类监视器就值得进你的常驻栏;没超过,说明你的开发姿势已经够干净,别为不存在的摩擦装工具。
显示更多 话题来源 @tomjohndesign 31.1K阅读 ❤️636
WhatThePort: see every dev server and port on your Mac A free, open-source macOS menu bar app that shows what’s running on localhost: every dev server’s port, project, git branch, memory and the Claude Code, Codex or Conductor session that started it. Sto WhatThePort
你弄伤我的鳞片了 ·
有个值得自媒体人关注的开源 Agent 叫 Easel——一个人也能跑起"内容团队"。它把做账号最耗时间的五件事直接串成一条线:找热点、选题策划、图文与视频制作、多平台发布、数据复盘;内置 112 个可执行 Skill(文案、知识卡、海报、配音、字幕、剪辑、AI 短剧),热点聚合微博、抖音、知乎、B 站、百度、头条六个源头,发布支持小红书、抖音、快手、知乎、B 站、视频号六个出口。仓库:github.com/ZJU-REAL/Easel 最打动我的不是功能多,是它把两个此前断开的环节接上了:发布之后的数据会沉淀进每个账号自己的画像,下次生成内容就更贴这个号的调性——产出喂画像、画像再喂产出,这条小回路正是今晚"traces 当燃料"在运营侧的样子。没有这条回路,工具只是代笔;有了这条回路,它开始替你攒家底——账号的风格本身就是那份家底,而这恰好是纯生成永远给不了的东西。 "112 个可执行 Skill"这个说法也值得停一下。"可执行"三个字把它和一堆"prompt 合集"分了家:能跑的技能有输入有输出、可复用可组合,堆在那儿就是一条隐形流水线;配上五段式主流程,等于把编辑、设计、剪辑、运营四个工位压进一个入口。这与"零件全是现成的、组合才是发明"那篇是同一逻辑的产品化——不发明新能力,把已有能力排成工序。 不过要留一格清醒给"一个人跑团队"这句口号。工具可以包办流程,包办不了判断:哪个热点值得跟、哪张图配哪句话、哪条数据算失败——这些是账号的魂,交给自动化的边界越界,号就变成流水线的出口。真正省下来的应当是手,不该是脑;把省下的时间花在选题和复盘上,这条流水线才物超所值,否则只是更快地发平庸。 给想试的人一句落地的:先别五段全开——挑"数据复盘"这一段接你现有的发布习惯,跑两周看画像有没有真的变准(它推荐的选题你愿不愿意用);愿意用,说明回路通了,再把前四段陆续接上;不愿意,说明它还没摸到你的号,接得越多、同质化来得越快。
显示更多 话题来源 @grgerwcwetwet 5.1K阅读 ❤️77
GitHub - ZJU-REAL/Easel: An open-source AI agent for social media — discover trends, create content, publish everywhere, An open-source AI agent for social media — discover trends, create content, publish everywhere, and learn what works across Xiaohongshu, Douyin, Zhihu, Bilibili, and more.🎨一个开源的 AI 社交媒体智能体——发现热点趋势、... GitHub
胡辣汤爱酸菜 ·
Dario 那句被转述的话值得盯:数学可以纯靠推理,生物必须做实验。9 月 17 日两件事同日落地——Anthropic 公布用不到四周优化了 AlphaFold3、Boltz-2 在内的 30 多个生物学 AI 模型、代码全开源。 另一边,ScienceIDE 把 Athena++、MITgcm、Gkeyll、NEST、Stim 等 7 学科真实科研代码,封成 15 套 AI 能动手训练的环境。 判分只认一条铁律:改完的代码算出的科学结果,必须和基准参考结果逐点吻合——跑通不算,对了才算。 拿 MITgcm 举例:海洋和大气之间氟利昂交换的模块里埋了一个 bug,AI 要自己找到、自己修好——合合格,不看代码写得漂不漂亮,只看最终输出能不能一个点一个点对上。 三层拆:一,可验证性的双轨:业务代码写错有编译器和单测当场拦,科学代码最吓人的 bug 偏不报错——程序照跑、曲线照好看,氟利昂悄悄偏一点,后面整条气候推论跟着偏。 二,拿业务标尺量科研 AI,量出来的多半是假及格;难度也有数:最难 85 道题、8 家厂商 15 个模型,最好的首试正确率 67.1%——每三道还有一道拿不下,考场没刷穿才有练的价值。 三,自举的第三面:团队把 Anthropic 开源的优化方案也封装进训练环境,内环改 Harness、外环拿规则打分训模型,一边是给 AI 练兵的考场,一边是给科研人的副驾工作台。 做过科研的人都懂:调代码、排 bug、适配工具、核对结果,能吃掉一个博士生大半的时间——过去 AI 帮的是读文献写综述,现在它开始下到几万行的模拟代码里干这些最磨人的活。 口径三条:①ART 长文与数字均为转述——以各官方为准、未复核;②"跑通不算对了才算"是帖中提炼——可引为方法、不作行业标准;③67.1% 与 15 套环境是其引用数据——未复现。 给要验的三条:一,把任务写成"逐点对账":哪个输出必须对上哪条基准,先写死;二,给 AI 的改动设一条不看过程的验收线——结果不对,代码再漂亮也不算过;三,找一道自己的 MITgcm:埋一个不报错的错,看它能不能找到并修对。 你交出去的那个结果,是跑通了,还是对上了?
显示更多 话题来源 @AYi_AInotes 35.4K阅读 ❤️171
AYi (@AYi_AInotes) on X Anthropic 创始人 Dario Amodei今天凌晨那篇 ART 长文,一个早上就刷到了 300 多万浏览, 里面有一句我反复看了好几遍,数学可以纯靠推理,生物必须做实验, 但很少有人注意到,昨晚刚发了免费科研工作台 ScienceBuddy 的 @PhAILabs,上周四还开源了一个项目 ScienceIDE,把验证这一关,直接做成了 AI 的对账考场, 上周四,9 月 17 号, X (formerly Twitter)
我不是小布丁 ·
github.com/mobile-next/mo… Mobile MCP 把手机变成 AI 能操作的测试面:安卓、iPhone 都支持,真机模拟器通吃,优先读无障碍信息定位操作,接上 Claude Code、Cursor 就能跑。场景具体——页面改完想验一遍,自己拿手机反复点,容易漏、截图更麻烦,这活可以交出去。 三层拆:一,这是"值守替人"的第四站:摄像头看画面、日报读表、消息流判意图之后,这条是测试点击——重复易漏纯体力的环节,正是自动化该接管的位置;二,"优先读无障碍信息"是关键设计:无障碍接口本为读屏而设,语义完整层级清楚——AI 拿它当感知通道比图像点击更稳,同一思路第二次出现。 三,原帖带推广包装(勾选串、"赶紧收"、标签)——只取机制、不搬钩子。 口径三条:①真机、模拟器与工具兼容性以 README 为准——未实测;②"操作更精准"是它的主张——没有准确率数据;③帖内热度与体裁偏推广——机制可引、评价不引。 给要接的三条:一,先读 README 连接节:设备权限、模拟器版本写清再接;二,跑最小用例:改一个按钮样式、让它点一遍、看步骤记录全不全;三,截图留档当验收:每步截图齐全,才算跑通。 页面改完那一百次点击,让机器去数——你只看截图有没有缺步。
显示更多 话题来源 @denziideng 8.2K阅读 ❤️102
GitHub - mobile-next/mobile-mcp: Model Context Protocol Server for Mobile Automation and Scraping (iOS, Android, Emulato Model Context Protocol Server for Mobile Automation and Scraping (iOS, Android, Emulators, Simulators and Real Devices) - mobile-next/mobile-mcp GitHub
会飞的荧 ·

xiaohu 转了个让人坐直的东西:ACTx486——把任意现成播客改造成能插话、能改剧情的视频。完整演示里,观众坐在沙发上用手机看这期播客,中途不断打断:问喷火器怎么工作,画面里的马斯克转过头来回答;让他把星舰拆开讲讲;带自己去火星;叫乔别抽烟;最后让乔亲马斯克一下——每插一句,人就停下来回应,答完节目从原处接着放。

它想改的那件事被这组演示说得很清楚:平时看视频只能暂停、快进、拖进度条——视频里的人说了一句你没听懂的话,你没法当场追问;你想知道"这跟我有什么关系",它也不会回答。被动播放被换成了对话式观看:单向的影像第一次有了"打断-回应-继续"的循环,而这正是我们跟人聊天时的默认节奏。

技术上的门道藏在"答完接着放"这半句里。要让表演在被打断后无缝续上,模型得同时维持三样东西:角色的一致性(转过头的还是同一个马斯克)、叙事的连续性(节目进行到哪了)、以及情境的即时性(你刚才问的是喷火器)。

这三样恰好是今晚一致性主题的合体——不只不跑脸,还要不忘场、不接错话。生成的目标从"一段片子"换成了"一个持续在场的角色",难度和价值都换了个量级。

从消费端看,这是内容形态的第二次解放。第一次是点播——时间由你定;这一次是问题由你出、剧情由你拐。互动剧集试过这个方向,但受限于分支必须提前写死;这里没有预写分支,回应是现场长出来的——预算和创意的天花板同时被抬高。对创作者,这意味着同一个母带可以被一千个人问出一千种样子,作品从"完成品"变成"进行中的对话"。

给想看的人一句落地的:别先想着做自己的——找一期你真有疑问的播客丢进去,连续追问三个问题,重点看两件事:答的对不对得上文、放回去接得顺不顺。两项都及格,这个形态就站住了;有一项露怯,你就知道下一步该盯的是理解还是生成。

显示更多 话题来源 @xiaohu 8.2K阅读 ❤️53
小互 (@xiaohu) on X 卧槽,这个牛逼啊 ACTx486:把任意现成播客 变成能插话、能改剧情的视频... 平时看视频,你只能暂停、快进、拖进度条。视频里的人说了一句你没听懂的话,你没法当场追问;你想知道「这事跟我有什么关系」,视频也不会回答你。 ACTx486 想改的就是这件事 它能改造成一段「能听、能回应、还能随你改变」的视频。 你看到一半点一下屏幕,提个问题,画面里的马斯克会转过来回答你;答完了,节目接着 X (formerly Twitter)
我不是小布丁 ·

有个新东西叫 Space——"无限文件系统"。它对"文件在云端"这件事给出了四个承诺:挂载之后,文件可以直接流式送到你的笔记本、可以云端就地干活(不用下载)、可以被任何应用或 agent 原生使用、还可以在你所有电脑和团队之间共享同一块盘。(试用入口在原帖)

四个承诺里最锋利的是"被任何应用或 agent 原生使用"。过去云盘的默认姿势是"搬运"——想要本地就下载一份、想要协作就传一份,文件的副本像杂草一样长满各个角落;Space 的姿势是"挂载"——文件不搬家,只是你伸手就够得着。从搬运到挂载,差的是一个动词,背后是"数据在哪"这件事第一次可以不回答:它在哪都一样,谁来取都一致,改一次、处处是新的。

这也补上了今晚文件线一直缺的形态侧。前面几格讲的是文件怎么"读"——压缩、索引、页图、按需取页,都在解决"读得省";Space 讲的是文件怎么"到"——不下载、不搬运、不失同步的焦躁。

对 agent 来说,这个差别尤其致命:一个要处理云上数据的 agent,过去得先学会下载、找路径、传回传去;现在文件就在挂载点躺着,读它和读本地文件没有区别。agent 不该学搬家,家应该长在它够得着的地方——这大概是"随取随用"对自动化最实在的一次兑现。

团队共享那半句也别轻看。一块盘对所有电脑和成员生效,意味着"最新版本"这个词终于可以只指向一个东西;版本焦虑(你手上的到底是不是最新的)在协作里制造过无数无声事故,挂载把这个问题从流程里删掉了——不是靠纪律,是靠架构。

给想试的人一句落地的:先拿一块最不需要同步的目录开刀——文档或素材,挂上去、多端各开一次,确认"改完立刻都对";这块盘稳了,再把 agent 的工作目录迁进去。顺序反了,你会先尝到断连的苦,而不是免搬运的甜。

显示更多 话题来源 @byjasonz 474.7K阅读 ❤️1772
Jason Zhao (@byjasonz) on X introducing Space: the infinite filesystem once mounted you can: → stream files to your laptop → work directly in the cloud (no downloads needed) → use your files natively with any app or agent → sha X (formerly Twitter)
小白爱摸鱼 ·

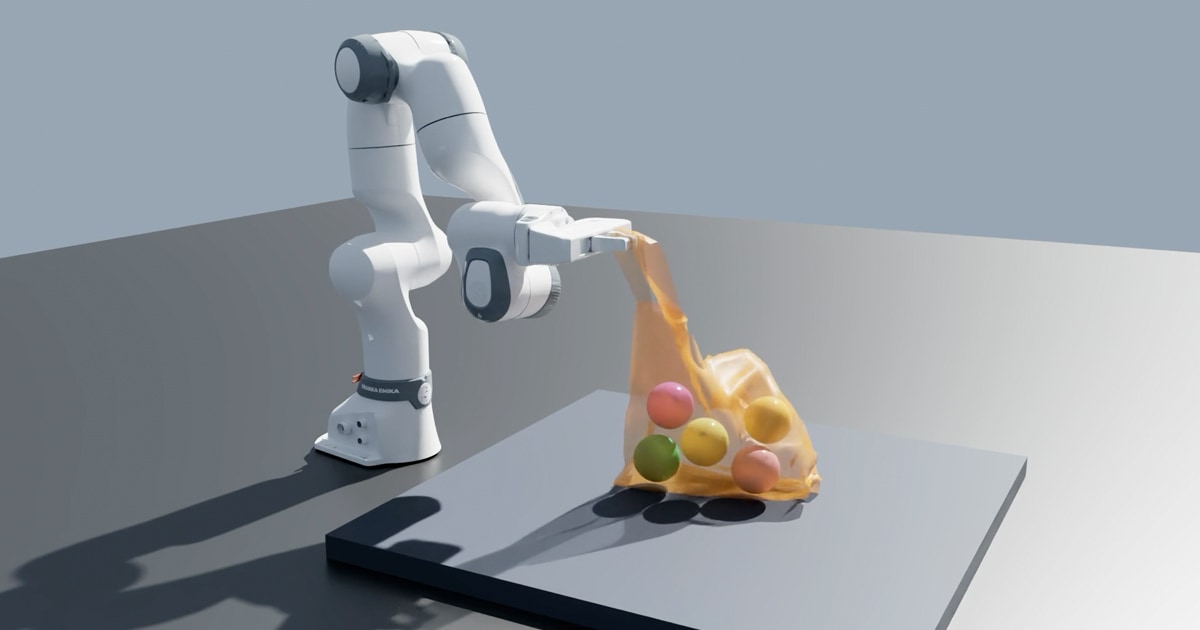
英伟达机器人官方账号讲了个朴素的道理:物理仿真给机器人一个"先学再上场"的地方——开发者可以建模复杂交互、训练并评估策略、在受控的虚拟环境里先把行为验证一遍,然后才让机器人进真实世界。(详情与工具链:nvda.ws/4xMFfLh)

这句话放在今晚的线索里,正是"双跑"在机器人侧的版本。之前聊过生产级 agent 的安全前提——线上跑一份、影子里跑一份对答案,配置错了能拦、预算超了能限;机器人把这套逻辑推到了更极端的形态:真实世界的错误没有回滚键。

代码写错可以 revert,狗跑到马路上错一步就是事故——于是"先在虚拟里跑"从优化项变成了入场券,仿真环境的地位等同于 agent 领域里的影子部署与评测集。

"受控的虚拟环境"这五个字是全句的筋。受控意味着两样东西被拿走了:不可预测的风险和无意义的噪声;留下的是一块可以反复试错、可以量化比较的实验田——同一个策略跑一千次,成功率的分布就是它的成色,不用真摔一千次去换。

这与今晚反复出现的"给模型画答题框"是同构的:确定性环境里练出来的判断,才敢带进不确定的现场;白模预演给视频画框、lint 给代码画框、仿真给机器人画框——画框的人不同,道理一字不差。

训练与评估分开列也有讲究。训练是让策略变好,评估是知道它好了没有——后者在仿真里几乎零成本(重置、再来、打分),在真实世界里却是天价;把贵的那半搬到便宜的半边完成,人和机器都只在必要时下场。这条账算下来,仿真不只是安全设施,更是把试错成本从三位数砍到零的财务工具。

给做机器人(或任何实体自动化)的人一句落地的:上真机之前先问三个数——你的仿真环境保真度靠什么校准、策略在里面跑过多少轮、真实与仿真的差距有没有人在定期对账。三样齐了,仿真才不是摆设;差一样,"先学再上场"就还只是一句好听的话。

显示更多 话题来源 @NVIDIARobotics 20.6K阅读 ❤️417
NVIDIA Use Case - Physics Simulation for Robotics Train and deploy robot policies with GPU-accelerated simulation. NVIDIA
自由翻滚的风铃草 ·

一个中国开发者的开源项目冲过了 10 万星:MoneyPrinterTurbo——给它一个主题,它几乎全自动产出 TikTok、Reels 和 YouTube Shorts。流程五步连着走:写脚本、生成配音、做字幕、找画面素材、合成成片;你出想法,其余它包。(演示视频见原贴)

"10 万星"这个量级值得先掂量。开源史上过这个数的项目,无一不是某种基础设施级的存在;一个短视频量产机爬到这个位置,说明被验证的需求有多朴素——想批量出内容的人,远比想象中多。

而它开源、免费的姿态,正好接上今晚三连的价格叙事:文档提取被按到电费级、语音克隆被折进账单一行、现在轮到短视频的产线本身——凡是没有独占资源门槛的创意环节,都在被同一股力量拉平。

五步拆开看,其实是把"许愿成片"的链条摆成了流水线。脚本和配音是语言能力的常规输出,字幕是它的副产品,真正花人力的是找画面和合成——这两步恰好是检索加编排的粗活。于是那句"你提供想法、其余它来"就有了工程注脚:能被定义成固定工序的,都不再是创意,而是产能。创意被压缩到最上游那个"给主题"的动作里,其余全部工业化。

不过产线的另一面得看清楚:全自动意味着同一套审美会复制一万遍。当所有素材来自同一个池子、所有节奏来自同一个模板,这类内容的竞争力会快速退化成标题与运气——工具把门槛拆了,也把差异化拆了一半。前面聊过"资产先于内容才敢批量",这里的资产就是你独有的选题与素材库:没有资产的量产,是在用别人的砖盖自己的房。

给想用的人一句落地的:把它当"草稿机"而不是"成片机"——五步全跑拿初稿,然后只动两样:换成你自己拍的素材、重写前三个钩子。多这两步,它就从"又一条流水线"变成你产能的三倍放大器。

显示更多 话题来源 @RoundtableSpace 40.4K阅读 ❤️67
0xMarioNawfal (@RoundtableSpace) on X A developer from China built a free AI tool that can create TikToks, Reels, and YouTube Shorts almost entirely on its own. It’s called MoneyPrinterTurbo, and it has already passed 100,000 stars on Gi X (formerly Twitter)
会飞的荧 ·

语音这条线被 Google 一夜推到了价格墙前。Gemini 3.8 Flash TTS 加一个更便宜的 Flash Lite 版同时发布,双双登顶各大语音榜单;真正的炸点在功能与价格的对照——过去整个语音 AI 市场(ElevenLabs 在内)把克隆、情绪控制、多语覆盖当溢价项分开计价;现在,一个模型全包,还更便宜。

拆开看它到底给了什么。克隆只需要 30 秒样本,且能稳住几小时连续输出不漂移;还能用一句文字描述凭空造声,语气、节奏、表达方式都可控;多说话人对话一遍过——笑声、叹息、抢话都带;支持 100 多种语言与方言(俄语在列),开箱 2000 多个现成音色、口音各异。

功能清单念下来,等于把行业过去十年攒的"专业门槛"逐条拉平:录音棚级数据集、定制授权协议、逐音节手调的工程师团队——这三样被一次性免除了资格。

这与今晚几条价格塌方的线是同一个剧本的不同幕。货架那篇说"被大厂当入口的通用能力会先被开源按成基建",token 那篇说"默认值省出来的钱用户感觉不到",文档提取那篇说"按页计费的活会先消失"——语音补上的是这一幕:当克隆、情绪、多语三件溢价品装进同一个低价模型,"分开收费"这件事就没有了物理载体。原帖那句收尾冷得很准:语音克隆行业,被折进了 API 账单里的一行。

对做产品的人,冲击是双重的。往好处想,语音功能的实现成本塌了——配音、多语言播报、有声内容的门槛降到"接一个 API";往冷处想,凡是"靠稀缺数据或专业人力维持的溢价",都会在通用模型够用的那天开始蒸发——今天是克隆,明天可能是别的。

判断一个语音(或任何模态)生意还有没有护城河,问题只有一个:你的价值里,有多少来自"模型做不到",有多少只是"还没人把模型调到能做到"。

给想用的人一句落地的:拿你最在意的三个指标各测一次——克隆保真(连续朗读十分钟听漂不漂)、多说话人(打断与笑声自然不自然)、冷门语种(挑你真实业务里那门小语种)。三项都过,就别再为"专业级语音"付溢价;有一项不过,省下的钱刚好补上那块专业短板。

顺带说双档发布的小心机。旗舰加低价 Lite 同时上,是把"按能力定价"的老套路搬进了语音——短播报、通知音这类轻活走 Lite,长对话、情感演绎留给旗舰;这与今晚档位那条线(按难度分流、简单轮次路由到便宜档)是同一个逻辑在语音侧的落点。

用户第一次有了"同一模型家族里自己分级"的选项,供应商则用一高一低把整个价格带占满——先占带,再谈份额,是这场塌方里没有人愿意缺席的原因。塌方从来不是终点:当所有人都按最低价接入,下一个比拼的就不再是价格,而是谁把语音嵌进了更贴身的场景——语音的下半场,藏在账单之外。

显示更多 话题来源 @rryssf 17.2K阅读 ❤️206
Robert Youssef (@rryssf) on X ElevenLabs just got cooked. Google dropped Gemini 3.8 Flash TTS and a cheaper Flash Lite version, and both climbed straight to the top of every major speech benchmark. Voice cloning just turned into X (formerly Twitter)
小白爱摸鱼 ·

Interrupt 大会上 LangChain 把 LangSmith Engine v2 推了出来,一句话概括它的野心:主动发现 agent 的问题、在你的用户看到之前就解决掉——agent 变好,你回去接着造东西。

公告:langchain.com/blog/langsmith…

"用户看到之前"这五个字,是观测线补上的第八格,也是前七格一直缺的那口气。看全、看见、动手、成套、读懂、好看、许愿建面板——那七格共同的姿势都是"等人来看":仪表盘开着、轨迹存着,出没出问题得靠人翻。

这一格换了主动权:系统自己先扫、先验、先修——从"给你看问题的工具"升级成"替你消灭问题的系统"。名字里带 redteam 也说明了手段:用对抗的方式先打自己,把攻防演练从季度任务变成平台的日常背景音。

这与今晚另一条"事故日的能力来自事故前基建"严丝合缝。那条讲的是 48 小时应急方案背后必须有库存,这条给的是把库存产品化:红队规则、评测用例、拦截动作全在平台里常驻,问题一冒头就有人(有 agent)扑上去——事后追责再完备,也不如事前把坑填了;追责是底线,主动消灭才是及格线。

"你回去接着造东西"这半句也值得品。工具的终极承诺从来不是炫技,是把人还给创造——观测做到极致的形态,就是它安静到你几乎忘了它存在:出问题它先处理,只剩真正需要你拍板的才浮上来。这与"助手的最高形态是不用你开口"是同一条演进线的两端:一个管发现,一个管动作,终点都是人只出现在该出现的地方。

给正在挑观测方案的人一句落地的:问一个问题就够——它发现问题之后做什么?只生成告警的,还是能带着证据给出修复建议、甚至直接拦下那次执行的?前者是仪表盘,后者才是 Engine;从告警到拦截的那一段距离,就是"主动"两个字的全部身价。

显示更多 话题来源 @LangChain 13.6K阅读 ❤️52
飞翔的智能体 ·

纳德拉给 Copilot 定了个新位置:工作的新操作系统——横跨每一个模型、每一种形态、每一类任务。这次号称史上最大的 Copilot 更新,把四件事捏到了一起:Autopilot——为企业打造的主动式长程 agent;Code——在你自己租户里构建应用;Home——聊天与协作合并;Office——双向嵌入,Office 长在 Copilot 里、Copilot 也长在 Office 里。

再加两样:Teams 里随时唤起,以及一个叫 Today 的主动体验——不用你问,它自己把 M365 里最重要的信息端上来。

"OS"这个比喻的选择比功能清单更值得琢磨。操作系统从不发明应用,它定义的是应用之间共享的那套规则——权限、窗口、调度、文件;纳德拉把模型、形态、任务并列在"横跨"后面,等于宣布 Copilot 要当的是那一层底座:谁家的模型都能跑、哪种设备都能接、每类任务都有入口。

这与"可换的归模型、不可换的归平台"是同一条战略的两句话——微软这条从平台侧说,Copilot 那条从体验侧说,收拢点都是:换的是引擎,不变的是方向盘。

四件套里最亮的是 Today 那半句——"不用问就端上来"。今晚语音线讲过"第四动词:不等你问、先备好",那是产品理念;Today 把它翻译成了具体形态:跨 M365 扫一遍,把今天真正要紧的三件事主动浮出来。

主动的前提是懂你——邮件、日程、文档的关联它都读过,才敢在你开口前先开口;这一步的技术含量在数据面,价值却在体验面:助手的最高形态不是应答快,是不用你开口。

Office 双向嵌入的"双向"也别放过。Office 嵌进 Copilot 是把工具交给 agent 用,Copilot 嵌进 Office 是把 agent 塞进人的习惯里——两头都做,才谈得上"工作流的 AI 化";只做一头,要么 agent 找不到落脚点,要么用户学不会新入口。这个对称设计说明微软很清楚:真正的迁移发生在两侧同时松动的时候。

给企业用户一句落地的:评估这类更新时别看功能数,看两件事——Autopilot 能不能在你的租户里真的长跑(长程=权限、状态、审计一样不能少),以及 Today 的"主动"能不能关(不是所有场景都想被提醒;可关的主动才叫助手,不可关的叫打扰)。两问答得干脆,这套"新 OS"才值得把日常工作搬上去。

显示更多 话题来源 @satyanadella 177.5K阅读 ❤️1622
Satya Nadella (@satyanadella) on X We’re building Copilot as a new OS for work that spans every model, every form factor, and every task. Today, we’re announcing our biggest update to Copilot to date, bringing four things together: · X (formerly Twitter)
会飞的荧 ·

Kent C. Dodds 说了个很准的观察:你自己写软件时,哪里别扭、哪里卡手,你立刻就感觉到——然后顺手上点油、把轮子磨顺;但现在你一撒就是几十个 agent,也不盯着它们干什么。关键在于:agent 不会抱怨,不会告诉你它撞上了什么问题——它们只会绕过去,接着干。所以你得反过来做:主动去问你的 agent,那里的摩擦在哪。

这个观察戳中的是"隐性摩擦"这层盲区。人对摩擦的感知是内置的——卡一下就烦、烦了就想改;agent 没有这个内置信号,它的默认行为是适应:参数不对就多试几次、文档缺失就猜一个、路径绕远也不吭声——适应性越强的执行者,越会把摩擦消化得悄无声息。

于是效率的漏点全部沉到水面之下:你以为 30 个 agent 在顺畅跑,实际它们每个人每天都在绕路上浪费一轮轮重试,只是没人举手。

这给观测线补上了常被忽略的一格。前面几格都在看"产出"——交了什么、质量如何、进度在哪;这一格要求看"过程里的叹息":同一个工具它试了几次才成功?哪一步它反复重写了三遍?这些信号不会出现在最终交付里,只藏在执行的中间过程。产出可观测不等于过程可观测,而摩擦恰恰只活在过程里——这正是"看全"要往深处再推一层的地方。

"主动问"这个动作听起来朴素,实操里却有讲究。问的方式不能是"有没有问题"(它大概率说没有),而要问得具体:这次任务里哪一步你重试最多?有没有哪段文档你没找到、最后靠猜的?有没有哪个工具你其实想用但没调成?把问题切到具体动作,答案才会从"都还行"变成可改的清单。今晚那句"问得越准、省的越多",在这里换了个方向再用一次——问得越细,漏点越现形。

给撒了一堆 agent 的人一句落地的:别等它汇报,下次跑完主动问三个问题——重试最多的一步、靠猜补上的信息、没调成却想用的工具。三个答案凑齐,你就拿到了一份不用人盯也能挖出来的效率地图;这大概是"看不见的成本"最便宜的挖法。

显示更多 话题来源 @kentcdodds 14.9K阅读 ❤️143
Kent C. Dodds 🐨 (@kentcdodds) on X When you were writing software in your codebase, you felt the pain of friction and would grease the wheels as a result. Now you're firing off dozens of agents and not watching what they're doing. Age X (formerly Twitter)
飞翔的智能体 ·
高铁上,邻座大哥改 Word 流程图:框不齐就一个个调,线没居中就一根根拖,四十分钟还在拖。原帖没嘲讽他,只是看清了参差——我们这行讨论还有几年被 AI 杀死,现实里无数人的时间仍耗在手动对齐流程图;AI 一边像要改变世界,一边没抵达很多人的工作。 三层拆:一,"抵达落差"是剪刀差:讨论在天上升温、工具缺席现场——落差即机会面,谁把工具送到那节车厢,谁接住价值;二,"没抵达"至少卡三环:找不到(不在圈内)、装不上(工作流没留位置)、接不进(格式不配套)——任一环断,讨论传不过去;三,观察用法要克制:单人场景轶事、不是行业统计,"杀死"和"没抵达"是修辞——方向清楚,幅度未测。 口径三条:①场景是一位大哥的四十分钟——作对照锚、不作数据;②抵达三环是我的拆法——原帖未给机制;③原帖无落差幅度测量——只借方向、不引比例。 给要自查的三条:一,给工作流做抵达检查:哪些环节还在逐个调、逐根拖;二,挑一个环节试工具,装不上接不进就把卡点记下——找不到、装不上、接不进归到哪环;三,讨论时间和动手时间分账:读焦虑的小时数、把一个环节真正换掉的小时数,分开记。 散场时邻座还在拖线条——他没做错什么;天上那场讨论,还没替他把框对齐半格。
显示更多 话题来源 @LaplaceTong 11.5K阅读 ❤️122
Laplace (@LaplaceTong) on X 高铁邻座有个大哥在写论文开题。 一个 Word 流程图,他改了快四十分钟。 框框大小不一样就一个个调,线条没居中就一根根拖。 我倒没有觉得他有什么问题,只是突然很强烈地感受到了这个世界的参差: 我们这个行业已经在认真讨论还有几年会被 AI 杀死, 但现实世界里,依然有无数人的时间消耗在手动对齐 Word 流程图上。 AI 一边像是已经要改变世界了, 一边又好像根本还没有抵达很多人的工作。 X (formerly Twitter)
小白爱摸鱼 ·

英伟达把"把大模型压到你的显卡装得下"做成了一个开源全家桶:Model-Optimizer——量化、剪枝、蒸馏、稀疏化、推测解码五种手段收进同一套 Python 接口;喂给它 Hugging Face、PyTorch 或 ONNX 上的模型,几种优化可以组合着上,导出的检查点直接丢给 vLLM、SGLang、TensorRT-LLM 跑,训练侧还接了 Megatron 与 Accelerate。

仓库:github.com/NVIDIA/Model-O… 2.0)

它的成色有三个旁证:GitHub 上三千九百多颗星、几百个 fork,issue 还开着几百个——说明真有人在用、真有人在踩;英伟达自己压好的现成模型(DeepSeek-R1-FP4、Llama 70B 与 405B 的 FP4 版)就摆在 Hugging Face 上,拿来即用;还有公开案例——Domyn 用剪枝加蒸馏把 355B 的模型压到了 260B。工具好不好,看它自己敢不敢吃自己压出来的模型。

这套东西和今晚的线怎么对上,值得摆一摆。白天那篇"4.61 倍换 93.2% 保真"讲的是压缩的理论账(压缩有价、保真有界),这条给的是执行台:五种手段就是五个旋钮,拧哪个、拧多少、怎么组合,全在一个接口里试。理论说"该压",工具箱说"怎么压、压完接哪里"——从论文到可部署的路,被这一个仓库铺掉了大半。

"显卡不够用时,先看看是不是模型自己太胖了"这句收尾值得当座右铭。多数人的第一反应是换卡、加钱、降上下文——都是在为模型的体积买单;而压缩工具在问另一个问题:这个模型里,有多少权重是你这次任务根本用不到的?把力气花在前者是扩产,花在后者是去肥;对预算有限的部署者,去肥永远先于扩产。

另外两个细节透着友好:仓库里附了能装进 Claude Code 和 Codex 的技能——想知道某个模型怎么量化,问一句比翻文档快;这正好是"工具会自己教你怎么用工具"的一个小样本。

给想试的人一句落地的:挑你最想跑却跑不动的那个模型,先别整套流水线——只上量化一档,导出、丢进你的推理引擎、跑三道题看质量;够用就到这,不够再加剪枝。压缩是从最小的一档开始的,不是从全部手段开始的。

显示更多 话题来源 @Ryrenz 8.4K阅读 ❤️150
会飞的荧 ·

HarnessRSI 这个概念正式立起来了——harness 的递归自我改进,论文给了五个具体方向。论文:arxiv.org/abs/2609.14857

五个方向逐个对读,会发现每一个都踩在今晚讲过的一条线上:

一是 Agent Loop——步进逻辑与错误恢复。任务怎么一步步推进、出错怎么自愈,这正是"失败自愈、下轮再战"那套实践的模型化;二是 Tool Use——API 的选择与参数格式。

选错工具、填错参数是 agent 最常见的低级浪费,这一格管的是"动手的准确率";三是 Observation Management——过滤环境噪音。观测线一直在讲怎么把信息收进来,这格讲的是反向动作:把没用的挡在外面,收进来的才都是弹药;四是 Context Management——优化长程 token。

这正是 12.5 倍实测那篇追问的去向、也是 harness 降本方法论的主战场;五是 Task Completion Detection——知道什么时候算做完。验收判断被单列成一个可改进的方向,说明"何时收工"这件事本身需要学。

五格合起来,勾勒出了 harness 自我进化的完整版图:跑得稳(环)、动得准(工具)、看得清(观察)、花得省(上下文)、收得对(完成判定)。与昨晚"双维 RSI"那篇接上,链条就通了——那篇讲"从反馈里学、执行验证、留下有效的",这篇给出"学什么"的清单;机制加对象,递归自我改进第一次从口号变成了五个可以分别度量、分别优化的工程问题。

更值得记的是"RSI 放在 harness 而不是模型里"这个位置选择。模型的改进要重训、要算力、要周期;harness 的改进改的是循环、工具、上下文的组织方式——改完即生效、随时可回滚。

在模型还不能每天重训的年代,让 harness 先跑起来自进化,是眼下性价比最高的一条改进路径;这也解释了为什么今晚所有提效的实战经验,几乎清一色发生在 harness 层。

给想尝试的人一句落地的:按五格给自己现在的系统各打一分——环稳不稳、工具准不准、噪音滤没滤、上下文省不省、收工判断靠不靠谱。五个里挑最低的那格做一次改动、量前后差——递归自我改进的第一圈,从来都是从最矮的那块板开始转的。

显示更多 话题来源 @anniewangtech 0.3K阅读 ❤️4
ModularRSI: Modular and Generalizable Recursive Harness Self-Improvement Recent work extends recursive self-improvement (RSI) to agent harnesses for long-horizon coding and terminal tasks, enabling agents to improve execution mechanisms from experience. However, generaliza arXiv.org
小白爱摸鱼 ·

一组增长数据被转述得很直接:Chatbase 的新注册里,37% 来自 LLM 的推荐——而且这批注册的转化率最高。作者的结论也克制:AEO(面向引擎的优化)能做的事很多,但最有效的始终是把产品做好、再让世界知道。(数据以官方披露为准)

37% 这个量级意味着一件事:模型的嘴已经成了新的分发入口。过去找工具的路径是搜索框——排在前面的赢;现在越来越多人的第一句是问模型"有什么好用的",而模型给出的答案里,被提及的那几家拿到了流量。入口从排名变成了推荐,从"人挑"变成了"AI 筛";这一步的迁移速度比多数营销人意识到的快,因为它不发任何公告,就在用户的每一次提问里悄然完成。

"转化率最高"这半句更值得琢磨。为什么 AI 推荐来的用户反而更愿意付费?大概是模型在推荐时已经替他做过一轮筛选——不是甩十个链接让他自己比,而是基于他的具体问题给出贴合的判断;带着这种"被理解过"的预期点进来,落差小、动机纯。

这与今晚信心那条(93 对 36)互为里表:信心决定用户愿不愿意试,推荐的质量决定试了之后留不留;两个数字都指向同一件事——信任的摩擦越小,转化越顺。

不过"把产品做好"这句冷水也得记下。AEO 技巧(结构化数据、被引用的措辞、常见问题的覆盖)能提高被提及的概率,但模型的推荐终究建立在它读过的评价与事实之上——产品不行,优化出来的曝光只是把差评更快地送进模型嘴里。入口变了,内容为王的老规矩一个字没改。

给做增长的人一句落地的:去问三个正在用 AI 找工具的人——模型最近给他们推荐过什么、为什么推荐。答案会直接告诉你 AEO 该优化什么:不是堆关键词,而是确保模型在读你的评价、你的文档、你的更新日志时,能读到"这东西真的解决某类问题"的证据。

显示更多 话题来源 @yasser_elsaid_ 13.5K阅读 ❤️269
Yasser (@yasser_elsaid_) on X 37% of new @chatbase sign ups come from LLM recommendation. They're also the highest converting signups. There is a lot you can do for AEO but nothing better than just building a good product and le X (formerly Twitter)
自由翻滚的风铃草 ·
DHH 在 Rails World 舞台上的三段话,接住了白天那篇"停笔"的下半场。 第一段是技术选择的分水岭:HEY 的后端用了 Rust、客户端走 Native——他的理由不是"更快",而是"上限更高":从后端、CLI、Native 应用一路到渲染引擎甚至编程语言本身,需要时能深入系统与内存层做极限优化,同时保持单二进制分发。这是把"运行时的自由度"摆在了语言口碑之上。 第二段是今天的重头戏,他给在场的人算了笔账:AI 时代,他已经 100% 用 AI 写代码——Coding 已经不再是最贵的部分,Running 才是。软件要 7×24 小时跑很多年,算力、资源、分发、维护这些持续累积的东西才是真正的长期成本。于是他把团队的追求换了词:过去注重开发效率,现在追求运行效率。 这两段合起来,恰好是编程线这两篇的分界线。白天那篇说"手写的经济性没了"——供给侧(谁来写)的账已经翻页;这一篇说"跑起来的账才刚开始"——需求侧(跑多久、跑多贵)的新账摊开。当生成便宜了,成本自然流向生成之外:编译得更快、内存吃得更省、分发只带一个文件、十年不崩——这些从来不是"写代码"的KPI,却是"软件活着"的KPI。开发效率是关于起点的,运行效率是关于余生的。 Rust+Native 这个组合也说明了选择逻辑的转变。过去选语言常看"招人好不好招、生态热不热";当 AI 把写代码的活接走,人对语言的顾虑退到次要,语言的运行特质反而凸出来——单文件分发的便利、系统层优化的深度、多年运行的稳健。工具好找了,工具的材质开始重要;这与"品味不贬值"是同一件事在选型上的投影。 给正在选技术栈的人一句落地的:用 DHH 那杆秤量一遍你的选项——别问"这语言写起来快不快"(AI 会替你快),问"这套东西跑五年要花多少":部署形态、内存曲线、维护人手。答案越接近"省心",你越不需要在未来的某天重写它。
显示更多 话题来源 @huacnlee 41.9K阅读 ❤️246
Jason Lee (@huacnlee) on X DHH 在 Rails World 的舞台上谈到,HEY 的后端使用 Rust,客户端走 Native——这是一个分水岭。 Rust 不只是更快,而是有更高的上限。从后端、CLI、Native 应用,到渲染引擎,甚至编程语言;需要的时候,还可以一路深入到系统和内存层面做极限优化,同时保持单二进制分发。 AI 时代,我已经 100% 用 AI 写代码。Coding 已经不再是最贵的部分,Runn X (formerly Twitter)
飞翔的智能体 ·

同一位实测者的续篇来了——上一条刚把 DeepSeek Harness 的 12.5 倍 token 差距挂出来,这条直接交出了答案的实验版:他把 Harness 切到"极简模式"(只保留固定系统指令和一个终端工具,不加载插件、Skills、任务规划——比 Pi 默认的 4 个工具还干净),三道题重跑。

结果自己都意外:前两道题 Pi 仍略省——订单字段提取 837 对 749(Pi 低)、截止时间决策 1100 对 1074(基本持平且 Harness 更快);第三道 CSV 行解析直接反转,799 对 1828,Harness 少约 56%。

三项合计 2736 对 3651——总 token 少约 25%、总耗时少约 19%,双方都是 3/3 正确。

这组数字把上一篇的悬念解得很干净:12.5 倍的差距不在模型报价里,在 harness 默认打包了什么。插件、技能、规划内容、冗余工具——这些静态前缀每一轮都随请求重发;把它们卸掉,同款模型立刻从"最贵的搬运工"变成"更省的那个"。这也正是方法论长文里"预期删除获胜"那条的活体演示:省 token 不是让模型省着用,是别替它背上用不着的行李。

三道题的分化也给了个精细的观察:结构简单的任务(字段提取、决策)两边都便宜、差距不大;带格式解析的任务(CSV 行)成了分水岭——谁的工具链更克制、谁就赢在细节。换句话说,省与不省的战场不在大面上,在工具与格式的默认值里;默认值省出来的钱,用户甚至感觉不到,账单却诚实。

给想试极简模式的人一句落地的:对照你日常的 harness,把"这轮真的用过吗"作为唯一标准,把工具清单砍到三个以内跑一周——三道题就能复现这个 25%;顺便你会发现自己对工具的依赖也变清楚了:真正离不开的,从来只有那几个。

显示更多 话题来源 @xiaomovps 0.2K阅读 ❤️1
小墨同学 (@xiaomovps) on X DeepSeek Harness 居然比 PI 还省 token🔥 总共做了 3 道题:前两道题都是 PI 更省 token,最后一道题居然是 DeepSeek harness 更省 token,这是我完全没有想到的 这次我使用了 DeepSeek harness 的极简模式,这个模式下只保留固定系统指令和一个终端工具,不加载插件、Skills、任务规划等内容,比 PI 的默认 4 个工具 还 X (formerly Twitter)
会飞的荧 ·

WorkSwarm 的第三篇观察来了,这次主角是两个新术语——它们正好把前两篇欠的机制补上。仓库:github.com/openJiuwen-ai/…

第一个是 Persistent Session:让 agent 在几百次交互、长跑工作流里持续握住关键事实、角色、决策和边界,不随上下文膨胀而失忆。这正是"三个不丢"那篇讲的目标,这里给出了实现路径——持久会话不是把历史全塞回去,而是把"该记住的那几样"作为状态保存下来。

丢上下文的焦虑今晚已经写过两轮(长会话三层垃圾、换班交接单),这条把解法从"用户手动补"推进到"产品自动持"。

第二个是 Dual-Dimension RSI——双维度的递归自我改进:从真实任务反馈里学、提出改进、用执行去验证、只保留真正有效的部分,而且同时改进两件事——agent 干活的方式,和它交付的成果。

这句拆开看很讲究:改进工作方式是过程优化(少走弯路、选对工具),改进交付成果是结果优化(输出更贴需求);只改其一都会跑偏——方法好成果错是自嗨,成果好方法烂是运气。能被执行验证、能被留下来的改进,才叫学习,其余只是试错记录。

三部曲到此合拢:第一篇立框架(不丢东西),第二篇给节奏(完成到改进),这一篇补机制(怎么持、怎么改)。作者点出的大理念也水到渠成——重点不是造一个更聪明的个体 agent,而是造一个系统:专长的成员各司其职、状态共享、从每次任务里真的变好。这与今晚从"按技能切"到"共享世界"的全部讨论是同一句话的工程落地。

给想给自己的 agent 装上这两件的人一句落地的:先查你现在的系统丢不丢"决策"——上一轮说定的方案,这一轮还作数吗?作数率低于八成,先补持久状态;补完再看第二件——你有没有留过"验证失败就回滚"的改进记录?两样都没有,系统就还停在"每次都从直觉开始"的阶段,RSI 那套更无从谈起。

显示更多 话题来源 @nijokestu 24.4K阅读 ❤️68
GitHub - openJiuwen-ai/jiuwenswarm: JiuwenSwarm is an intelligent AI Agent built on openJiuwen. It extends the powerful JiuwenSwarm is an intelligent AI Agent built on openJiuwen. It extends the powerful capabilities of large language models directly to your fingertips through various communication apps you use dail... GitHub
小白爱摸鱼 ·

Apple 在 Hugging Face 上丢了个小巧思:LensVLM-9B——基于 Qwen3.5-9B 微调,做的事只有一件:把长文档压缩成一张张小尺寸的页面图像来省 token,等用户提问时,再只把真正相关的那几页原文调出来。模型页:huggingface.co/apple/LensVLM-…

这个设计聪明在它把"文档"这个 token 大户重新拆成了两半:索引和正文。过去喂长文档只有两条路——全塞(每轮都为用不到的 95% 付费)或纯文本切块(切碎了结构、丢了版式);LensVLM 的走法是把每页当成缩略图当索引,模型先"看"整本的目录感,再按问题精准取页。

看一页图的成本远低于读一页字,取回的却可以是完整原页——这正好卡在"省钱"和"保真"的缝里,是 token 账本上难得的双赢。

它和今晚两条线都对得上。往大处说,这是 harness 降本方法论里"检索分层"的一个极具体案例:静态上下文只放多数轮需要的,其余按需可发现——那条原则在这里被翻译成了产品形态;往小处说,9B 这个尺寸+基于 Qwen 微调,延续了端侧阶梯的老故事:小模型不扛全书,但扛得住索引和调度。索引归小、正文按需、算力够用——三件事凑齐,长文档就不再是每一轮的税。

"页图"这个中间形态也值得记一笔。它比文本摘要多保留了版式与空间信息(表格位置、图文关系都在),比全文又便宜一个量级;在"压缩必有损"的世界里,它找到了一种几乎不影响理解的损法——丢的是分辨率,不是结构。这与白模预演的思路其实是一家人:为了省钱而降级可以,降级降掉结构不行。

给要处理长文档的人一句落地的:先别上向量库——把你的 PDF 按页转成缩略图做一个目录索引,问题来了先选页、再取原文,多数问答场景这就够了;跑一周看成本对比,你会重新理解"该存什么"这三个字——存索引,别存整本书。

显示更多 话题来源 @victormustar 270K阅读 ❤️3419
apple/LensVLM-9B · Hugging Face We’re on a journey to advance and democratize artificial intelligence through open source and open science. huggingface.co
小白爱摸鱼 ·

有人在做一件把"模式"这件事系统化的活:从大量反馈看,用户分两派——一派自己做规划、根本不需要 plan mode;另一派就爱进入一个专门模式,让 Claude 陪着思考和头脑风暴。他的计划是:把 plan mode 做成一个内置 mod,再允许各路 mods 新增自己的模式、甚至覆盖 Shift+Tab 那个切换键。

"分两派"这个观察先值得停下。它说明模式(mode)在 coding agent 里已经不是可有可无的装饰,而是真实存在的使用习惯——有人要仪式(进模式=切换心态),有人要流程(模式=约束与节奏);同一功能两极分化,通常只有一个解释:它戳中了不同人的工作方式,而不是功能本身有毛病。既然习惯天然多样,与其把某一种钉死成唯一正解,不如把"模式"本身做成可插拔的底盘。

把模式做成 mod,架构上的意味比功能本身大。Plan、Goal、Agent、只读、执行……今晚在各家产品里见过的模式名越来越多,但多数是焊死的——模式集由厂商定义、切换键由厂商分配;这一步把选择权挪到了社区:谁能定义模式、谁来决定按键,第一次成了可扩展项。

这与"把选择权交出去"的老原则一脉相承:平台提供底盘,模式由用户生长——就像工具层的聚合货架,卖的不是某个功能,是"你可以有你的功能"。

Shift+Tab 这个键尤其有戏。它在几个产品里都是权限与模式的切换门(今晚刚聊过"有围栏也有门"),现在连键位本身都可以被 mod 覆盖——键位即配置,配置即表态:你可以把最常用的那个模式放在最顺手的位置。当一个工具开始认真对待"手指的肌肉记忆",说明它真的进了日常。

给想试的人一句落地的:先给自己列三个真实场景——快速改一处、认真实现一个功能、只读梳理思路——看它们各自该落在哪个模式里;列得出来,说明你已经在用模式了,值得去改造;列不出来、三个场景一个模式走天下,那说明你还处在"模式尚不需要"的阶段,等需要了再折腾键位。

显示更多 话题来源 @trq212 255.2K阅读 ❤️1831
Thariq (@trq212) on X lots feedback here, many of you are planning yourself & don't need plan mode others prefer the UX of entering a mode where Claude is just thinking & brainstorming with you my plan is to: - m X (formerly Twitter)
会飞的荧 ·

Instinct 团队为一次幻觉事故发了份少见的完整声明,技术含量压过了公关味。先把事实摆正:这次事故由一次幻觉引发——模型编造了一个专有名词,随后的因果思考轨迹又把它放大了;不是数据泄露,没有共享用户数据,没有越过用户隔离边界。(以官方声明全文为准)

声明的后半段才是重点:他们在 48 小时内搭起了一套主动幻觉检测系统,扫描并验证流经平台的每一个 token。检测层由小模型驱动,专门针对三类幻觉训练——无依据的断言、思考轨迹里发散出去的"创意脑暴"、罕见采样错误;系统做过对抗训练、经过顶级 agent 攻防安全团队的实战检验;最关键的能力是它能在下一段思考轨迹或下一次工具调用生成、执行之前,把 Instinct 拦下来或拨转方向。

"逐 token 验证、执行前拦截"这个规格,把幻觉治理从"事后补救"推到了"事中闸门"。今晚责任那篇讲的是出事之后谁签字,这篇给出的是更早的一环——让出事本身变得困难。与防线三件套放在一起,链条现在完整了:事前拦(token 级验证)、事中留(卷宗与日志)、事后签(责任归属)——三层各管一段,缺哪层都会有漏;而幻觉这种"没有明确受害者却处处误导"的毛病,恰好只有第一层能治,因为它不等人追责、它让人根本走不到错的那一步。

48 小时这个时间数字也值得记。它说明这套系统的零件不是临时抱佛脚——检测小模型的训练数据、对抗样本库、拦截管道,必然是早就备着的库存,事件只是把它们推上了线。这与今晚"48 小时"的另一条遥相呼应:事故日的能力,来自事故前的基建;临时抱佛脚只能写道歉信,提前备货才能写方案。

至于"思考轨迹里的创意脑暴也算幻觉"这个细节,暴露了推理模型的一类新型风险:模型在 thinking 里越会发散,越容易把假设当结论带出去——发散对创作是才华,对事实陈述是隐患。给这条防线点个赞之外也要留一格清醒:声明说"未来几周会发更深的拆解",方案的实际拦截率、误杀率还没见数字——拦截器拦得太狠,把正确思考也掐了,是下一个要盯的坑。

给要做同类防线的人一句落地的:先别追求逐 token——把你最高频的那类"编造专有名词"先堵住(实体对照已知词表是最便宜的一步),跑一周看误报率;能压住误报,再往思考轨迹那一层铺。

顺带把这套防线和今晚另一条"责任真空"并起来看,会发现二者其实是互补件:责任条款管的是"出了事怎么算账",token 级拦截管的是"让账根本别产生"。前者永远滞后、后者永远前置,任何一侧单打独斗都会漏——有拦截没责任,拦漏了没人担;有责任没拦截,漏的成本早晚摊到用户头上。

企业级 agent 的安全栈长成今天这个样子,正是在补这两块的接缝:把"少出事"做成系统,把"出了事"写成规则,剩下的不确定性才敢交给模型去跑。三层的顺序不能倒——先有闸门,签发和卷宗才有对象;先有归属,拦截的力度才敢往上调;一切就位之后,所谓"敢用 agent 干重活"才不是一句勇气,而是一份可以核对的清单。

显示更多 话题来源 @noahrshinn 208.2K阅读 ❤️1121
Noah Shinn (@noahrshinn) on X This instance was caused by a hallucination (the model fabricated a proper noun) that was further amplified by its causal thinking trace. This was not a data breach, no user data was shared, and no us X (formerly Twitter)
我不是小布丁 ·
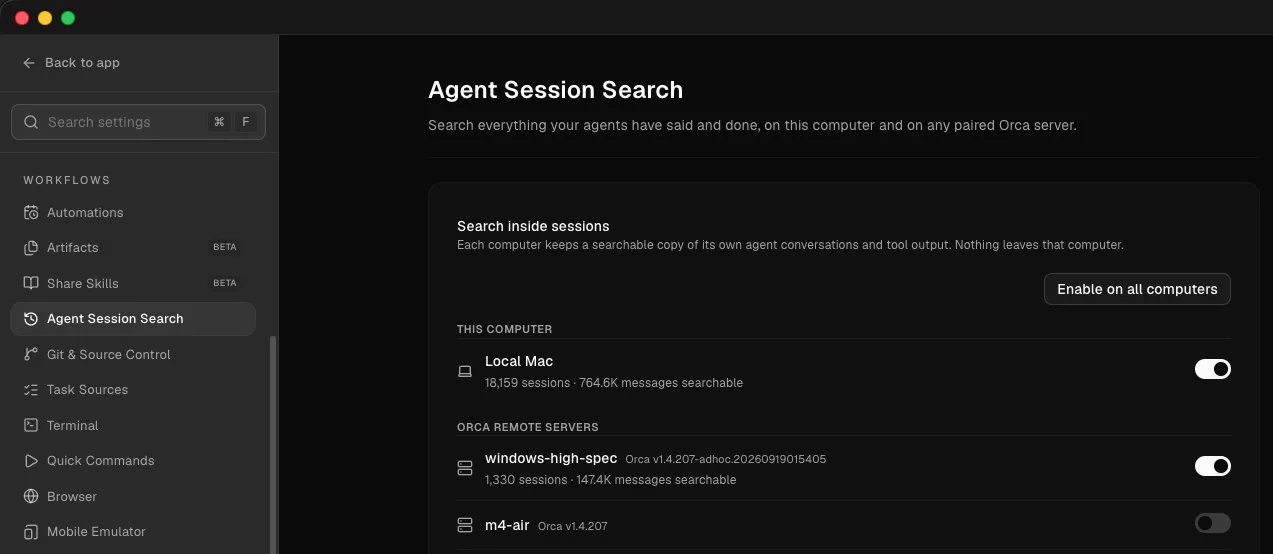
Orca 补了个把长会话难题拆一半的功能:agent 的完整聊天历史现在可以本地建立索引、随时检索——想翻三个月前那次调试的对话,搜索即可;索引存在你自己的机器上。(设置项在 Settings → Agent Session Search) 这正好接在"换班必须交接"那篇后面。当时说窗口是工位、不是档案柜,长会话的两难(污染 vs 丢背景)靠一页交接单解决;交接单管的是"往新会话带什么",而这一步补的是"往旧会话找什么"——带得走、还找得到,记忆才算闭环。没有检索的会话历史,本质是一堆纸:写了、留了、但没人翻得动。 "本地索引"这半句是设计上的定见。聊天记录是最私密的一类数据——贴过报错、贴过代码、贴过不想外传的东西;把它送去云端建索引,等于用隐私换便利。本地存储让这对矛盾暂时解:检索的便利照拿,数据一步不走。与今晚本地线的一贯主张完全一致——敏感的,计算就发生在数据所在的地方;索引这活儿恰好是"计算"而不是"转发",端侧完全跑得动。 往大处看,这条还给 agent 工具的成熟度提供了把尺子。判断一个 agent 产品长没长熟,不看它能干什么惊天动地的事,看它对"昨天"的态度:交接单、历史索引、可回溯的状态——这些全是给记忆补课的零件。Demo 永远朝前看,工具才开始朝后看;而使用者的真实体验里,回得去、找得到,往往比跑得快更救命。 给重度用户一句落地的:把索引开起来之后,做一次"考古测试"——搜一个你确定聊过但忘了哪天的细节,看能不能三十秒内翻到原文。翻得到,你的会话历史才第一次从"负担"变成"资产";翻不到,就该趁早整理交接单,别指望记忆自己长出来。
显示更多 话题来源 @orca_build 8.5K阅读 ❤️145
Orca ADE (@orca_build) on X Yes! Orca can now index your agent's full chat history, making it easy to search any past conversation. Search indexes are stored locally on your machine. You can enable this feature under "Settings X (formerly Twitter)
小白爱摸鱼 ·

有条关于"给 agent 造世界"的帖子,值得放进协作线的最后空格:Agora-2 把人类和多个 agent 放进同一个环境——agent 的行动会改变世界,世界的改变又影响环境里的每一个人,agent 之间可以实时合作也可以竞争;更关键的细节是:底层没有传统游戏引擎。

"同一个环境"这四个字,把今晚反复聊的协作从消息层搬到了物理层。前面几格讲的是 agent 之间怎么传话、怎么分工、怎么交棒——那些都发生在"任务"这一层;Agora-2 补的是更基础的一层:共享的状态。

你动了那扇门,我也看得见;我占了那个资源,你绕着走——当所有参与者面对的是同一个持续变化的世界,交互就不再是"你一句我一句"的备忘录,而是真正意义上的共处。合作与竞争也因此自发长出来:不需要谁来派单,局面本身就会逼出站队和分工。

"没有游戏引擎"这个设计选择更耐人寻味。传统做法是把 agent 塞进现成的游戏世界——引擎提供物理、规则和渲染,干净但僵硬;不套引擎意味着世界本身也是被"生成和维护"的,规则可以长出规则、地形会被行动改写。

代价是没人替它兜底,好处是它更接近真实世界的样子:没有官方说明书、只有彼此试探出来的规律。对训练 agent 的长期适应力,这种"无手册环境"可能恰恰是最肥的土壤。

给关注这条线的人一句落地的:把"共享状态"这四个字带回你的多 agent 系统自查——你的几个 agent 之间,是靠聊天窗口传话,还是共享同一份看得见的状态(同一个仓库、同一块看板、同一个文件)?前者会互相猜,后者才谈得上配合;世界不必复杂,但必须只有一个。

显示更多 话题来源 @k2sbhai 1.4K阅读 ❤️40
K2S (@k2sbhai) on X AI agents are getting their own worlds to learn in Agora-2 puts humans and multiple agents inside the same environment > actions affect the world > the world affects everyone else > agents can coope X (formerly Twitter)
小白爱摸鱼 ·
OpenRouter 悄悄把自家的"工具层"补上了:免费和付费的 tools 一并上线——网页搜索、图像生成、运行中途调用别的模型、完整的 shell,甚至一个 datetime();官方的说法是让"按需智能"变得更聪明也更便宜。 这一步值得放在货架演化的脉络里看。OpenRouter 起家靠的是把几百个模型聚成一个端点——那会儿它卖的是"入口";今天补的这一排工具,卖的已经是"能力":调用方不必自己接搜索、自己管图像管线、自己写 shell 沙箱,聚合层把执行的零件也配齐了。从模型的货架,长出能力的货架——这是继"模型无关平台"之后,聚合层向上生长的又一步。 "运行中途调用别的模型"这半句尤其妙。它把今晚聊过的"自动换马"从理想拉到了 API 层:一个任务跑着跑着发现这一步需要更强的推理,当场点名换一家——路由不再是你在配置文件里预设的规则,而是执行流里的一个普通动作。配合前面"档位冠军按周轮转"的现实,这类能力会让"谁家强用谁"从订阅决策降级为调用参数;用户侧的迁移成本再降一档,模型侧的护城河就再窄一截。 价格的后半句也不能忘——"更便宜"。免费与付费分层的 tools 摆在一起,说明聚合层的商业模式正在成型:模型调用的差价赚一道,工具的增值再赚一道;而对用户,真正的账是"省下了自己搭这些零件的工程量"。按需智能的完整形态大概就是这样:要什么能力、点什么按钮,钱按按钮算。 给开发者一句落地的:把你服务里那些"自己搭了一半的零件"(搜索、图像、shell 执行)逐个对照一遍——聚合层提供的版本如果已经够用,就别再养内部实现;省下的维护时长,拿去写只有你能写的那部分业务逻辑。
显示更多 话题来源 @jeff_weinstein 11.7K阅读 ❤️68
Jeff Weinstein (@jeff_weinstein) on X OpenRouter now has tools, both free and paid, to make on demand intelligence even smarter and cheaper—starting with web search, image generation, calling other models mid-run, full shell, and even dat X (formerly Twitter)
会飞的荧 ·

macjtocock 那条 1963 字的观后感,把 Lauren 的演讲拆成了三件套——她正是上一篇"十个项目并行"的作者本人,这次的演讲讲的是方法:怎么做到单月往生产环境合 2500 个 PR。

第一件,锁死 agent。人喜欢"锋利的刀"式抽象——强大,但用错了会割到自己;Lauren 的团队反其道而行,让 agent 在极度受限的环境里干活:抽象设计成"根本没法搞砸"的形态,lint 规则强制执行,为此他们建了一整套内部框架(Dune)把 agent 圈在轨道上。

附带的好处是——上下文窗口不大的模型,也能在大代码库里高效干活;锁死不只防事故,还省口粮。

第二件,验证基建。要信任 agent 的产出,只有两条路:坐在旁边盯着看,或者让它自己交出"确实改好了"的证据——Lauren 把后者推到极致:投资定制 CLI,让 agent 驱动应用、自己测量自己的表现;应用出厂即可部署(factory ready),一上手就能扔给 agent 随便折腾。这与今晚"可验证"那条完全同一味药:别问你信不信它,问它交不交得出证据。

第三件,Feature Map——也是最有意思的一件。软件工厂的外循环常常要 agent 把用户的模糊 bug 报告拆成具体修复;为此他们给应用的每个主要功能建了一份"功能地图",写清这 app 按设计该怎么运作,随代码库一起维护、靠自动化保持同步。这文档成了 agent 导航的基础设施:哪怕代码库很大,探索也快得多、准得多。

作者对这类文档的立场反转,是全篇最值钱的判断。他一向警告别写这种文档——过期快、写错了反而把 agent 带沟里;但这次他松口了:如果一份导航文档能 enable 新的行为(让 agent 探索得更快更好),它就是值得的。

这个条件句把"文档值不值得写"从信仰题还原成了效用题——不是文档好或坏,是它有没有换来此前做不到的能力。今晚三步学文档那篇讲的也是同一杆秤:产出换了新能力才立得住,否则只是更整齐的遗忘。

三件套合起来,恰好是"月产 2500 个 PR"的底层配方:锁死保证单个 PR 不闯祸,验证保证闯了祸能当场发现,功能地图保证 agent 找得到该动哪里——产能是结果,不是原因。

拆开看,三件还共享一个更深的取向:把不确定性尽量前移消化。锁死是在动手前就掐灭走偏的可能(约束是预防);验证是在合入前把质量摊开给人看(证据是关卡);功能地图是在探索前给足背景(导航是减熵)。

三道关卡依次排在工作流的前中后,每一道都在"错误变贵之前"把它拦下来——这与工程里"越早修复越便宜"的老定理严丝合缝,也解释了为什么这套方法能撑住 2500 这个量级:错误率不随产量线性膨胀,产能才敢往上堆。

factory ready 那句还有一层容易滑过去的含义:应用随时可部署,意味着 agent 的验证不是对着静态代码空转,而是能在真实环境里跑起来、点得动、看得见效果。真实反馈环一旦闭合,"它交的证据"才有分量——纸面自测和真机自测之间的差距,往往就是"看起来改好了"和"确实改好了"的差距。证据要可信,先得有个足够真的靶场。

至于小上下文模型在大代码库里干活那条,其实是给"端侧路线"的又一份工作场景:锁得死、导航清,模型需要装进脑子里的东西就少——大库未必需要大窗口,纪律好的工程可以把需求压到恰好装下。这与"能 grep 就别嵌进上下文"的极简账是同一笔账的两端。

给想抄作业的人一句落地的:三件按顺序来——先给仓库上 lint 与硬约束(一周能见效),再给应用配一个能自测的 CLI(两周),最后才建功能地图(等前两件跑顺、你真正摸清哪些功能常被问到再动笔)。顺序反了,第三件会先烂掉。

显示更多 话题来源 @mattpocockuk 20.6K阅读 ❤️288
Matt Pocock (@mattpocockuk) on X This is an extremely good watch. The things that felt novel/interesting to me: 1. Lock down your agents Humans tend to like 'sharp knife' abstractions - that are powerful, but you can cut yourself X (formerly Twitter)
小白爱摸鱼 ·

《科学》杂志刊了个多 agent 系统的新研究:Virtual Biotech——专门辅助药物开发决策。它把多样的生物医学与临床证据综合进一个统一平台,据称有机会找出那些 otherwise 会被错过的治疗机会。文章:scim.ag/4jaXFBv

"多 agent 帮人决定押哪个药",这件事的分量要看清三层。

第一层是任务形态。药物开发的决策从来不是缺数据,是数据太多太散——分子证据在一拨论文里、临床结果在另一拨、机制解释在第三拨,人脑拼图的带宽有限,漏掉的"治疗机会"多半不是没出现过,是没人同时看得见所有证据。

把综合与发现交给多 agent:一类 agent 啃分子文献、一类盯临床终点、一类专挑矛盾,再在统一平台上对账——这正是"按技能切"在最高风险领域的一次落地。分对了工,才有人敢说"这个组合别人没想到"。

第二层是证据的分量。它登在《科学》上而不是产品博客里,意味着方法与效果过了同行评议这道关——今晚的安全线三连读说过"别问你信不信、问它交不交得出证据",这篇就是把证据链走完的样板:可复现的方法、明确的评测、期刊的背书。AI 进入高风险决策场景的门槛,就是被这类"正经证据"一寸寸垫起来的。

第三层是定位的清醒。系统的角色写得准确——"辅助决策",不是替人拍板。药企的最终押注仍要由人承担,AI 在这里做的是把候选空间扫得更全、把依据摆得更齐;这与今晚责任那篇的说法严丝合缝:它解决"谁来留痕",不解决"谁来负责"——留痕越完整,负责的人越有据可依。

给生命科学方向的人一句落地的:先别问"AI 能不能发现新药",问它能不能在你手头某个具体适应症上,把二十年的散装证据拼成一张你还没看过的候选表——拼得出、每条有出处,它就已经在替你省下最贵的那种人力:翻文献的人时。

显示更多 话题来源 @ScienceMagazine 17.8K阅读 ❤️52
胡辣汤爱酸菜 ·
palantir.com/docs/foundry/a… 主帖只有"本体是中心"一句加 AMA 钩,实质在引用:Ontology 是 indexed space,也是 vector store——链接、关系、用法、逻辑、动作日志全入索引,业务语与日志双向可查,随建设复利。 三层拆:一,"索引内生还是外挂"的架构宣言:多数平台搜索是插件,它把结构做成索引+向量——与"索引变薄"一减一加:一个省存储,一个把搜索长回结构;二,业务语与技术日志双可查——同一对象经营词汇、技术日志都能问,两层不分家;三,"compounds as you build"=复利:本体越全、可连越多,价值随建设非线性增长。 口径:①架构表述以官方人员帖+palantir文档为锚——未读全文;②"enterprise search out of the box"是产品主张、未验证;③传播热度远超内容——热不是背书。 给要拆的三条:一,先读官方 architecture-center——以官方图为准;二,拿一个领域对象(订单/客户/设备)建"关系+日志"两层;三,提跨层问题:业务词查、日志也查——查不到的那半,就是本体没建到的地方。 当索引长进结构,搜索就从功能成为地基——本体是中心,恰因它把一切编进可查位置。
显示更多 话题来源 @chadwahl 79.8K阅读 ❤️692
Palantir As described in the overview of AIP, Foundry, and Apollo, AIP is Palantir’s platform for connecting generative AI into operational domains. While... Palantir
查看完整榜单
查看完整榜单
查看完整榜单