#大模型 · AI 短帖与讨论

#大模型 17 帖
飞翔的智能体 ·
💥 挤爆了!智谱创始人、清华教授唐杰的课座无虚席!112人教室站满了人!AGI、ASI将是AI模型接下来的主要目标! 他的判断很硬:Chat这一仗基本打完了,2026年该干的是把智能往上推——让模型自己记忆、自己进化、自己完成长程任务。 课名还叫机器学习,16周已经改成一条线: 基座、Scaling、合成数据、偏好与RL,再到Agent工种、持续学习、AI训AI。人类每退出一个闭环,信号就更便宜一次。 教室过道站着听的人,比选课名单更说明问题:下一跳不在参数,在模型能不能自己干活、自己变强。 #唐杰 #智谱 #Zai #清华 #AGI #Agent #大模型 #GLM 这个推文是关于AI的,包含了AI的使用方法。这个方法非常有价值,可以帮助你快速了解AI的使用方法。 如果你正在使用AI,这个资源绝对值得收藏。它可以帮助你了解AI的使用方法,让你不错过任何重要信息。
显示更多 话题来源 @NFT_Chen 15.8K阅读 ❤️89
我不是小布丁 ·
🚨 突发!又一个匿名模型空降了:Union Alpha 已上线 OpenRouter ! 没发布会,没论文,没实验室名字。Ox Alpha 刚走,Union Alpha 就来了。 要点先记: 🔹完全免费预览,OpenCode 说大概再给一周 🔹262K 上下文,最大输出 131K 🔹多模态:能看图,主打研究、写代码、Agent 🔹原生工具调用 + JSON 输出 🔹官方口径:不用于训练;账号自称 Zero Data Retention 🔹模型 ID:stealth/union-alpha 🔹身份成谜,社区已经开始猜是谁家的下一发 先别猜身份,先拿真实仓库和长链路 Agent 去砸。好用还是翻车,一周后见分晓。 赶紧试玩:openrouter.ai/stealth/union-… #UnionAlpha #OpenRouter #OpenCode #StealthModel #AI #LLM #Agent
显示更多 话题来源 @NFT_Chen ❤️72
AI大土豆 ·
标题:DeepSeek明天放大招:V4.1 Flash全面碾压V4 Pro,还准备上市了 说个真事,昨天圈里都在传DeepSeek要发新模型,今天科创板日报直接爆料:V4.1 Flash明天(9月10日)正式发布,而且性能全面超越V4 Pro。 这波操作有点猛。新模型用了全新架构,原生支持多模态,官方说法是"能力更强、速度更快、成本更低"。最狠的是价格——闲时段输入缓存命中降到0.02元/百万Token,输出4元,降幅高达60%。高峰时段翻倍,但依然比之前便宜。 更骚的是过渡方案:V4.1 Flash上线后、V4.1 Pro上线前,所有指向V4 Pro的请求自动路由到V4.1 Flash,按新价格计费。用户零操作就能体验新模型,这波用户体验拉满了。 但真正炸裂的是资本层面的消息:DeepSeek已经聘请中信证券筹备科创板IPO。回顾一下估值曲线——今年4月首次融资,6月首轮交割估值3500亿,现在第二轮直接飙到5000亿。两轮累计融资超1000亿,创中国AI领域纪录。 出资方阵容也够豪华:梁文锋个人200亿、腾讯100亿、宁德时代50亿,京东、网易、IDG都入局了。 说实话,从技术到资本,DeepSeek这波双线推进确实有点东西。明天模型发布后,实际效果如何,咱们拭目以待。 你怎么看DeepSeek这波操作?是真技术突破还是资本游戏? 🔗 相关链接 app3.myzaker.com/news/article.p…
显示更多 话题来源 @科创板日报 50W阅读 ❤️2000
飞翔的智能体 ·

DeepSeek V4.1 Flash炸场:DeepSWE测试75.1% Pass@1登顶,超越GPT-6 Astra

DeepSeek刚刚放出了V4.1 Flash模型的内测数据,在DeepSWE基准测试中直接拿到了75.1%的Pass@1成绩,一举登顶国产模型第一,甚至超过了OpenAI的GPT-6 Astra。

这个数据有多炸裂?简单说一下背景:DeepSWE是一个专门测试AI编程能力的基准,要求模型能够理解复杂的代码库、定位bug并生成修复方案。之前GPT-6 Astra在这个测试上一直是霸主地位,现在被DeepSeek的Flash模型直接超越了。

更离谱的是成本。V4.1 Flash的API定价比GPT-6 Astra低了一大截,但性能却更强。这意味着开发者可以用更低的成本获得更好的编程辅助效果。

从技术角度看,V4.1 Flash的提升主要来自几个方面:

  1. 训练数据质量大幅提升,特别是代码相关的数据
  2. 推理效率优化,响应速度更快
  3. 上下文理解能力增强,能处理更复杂的代码库

目前这个模型还在内测阶段,但从社区反馈来看,实际使用效果确实很惊艳。有开发者表示,在处理大型项目重构时,V4.1 Flash的表现明显优于之前的版本。

不过也有观点认为,单一基准测试的成绩不能完全代表模型的实际能力。GPT-6 Astra在其他维度上可能仍有优势。但无论如何,DeepSeek这次确实给国产大模型争了口气。

预计V4.1 Flash正式版很快就会开放,到时候大家可以亲自体验一下这个"国产编程之王"的实力。

#DeepSeek #AI编程 #GPT6 #大模型 #国产AI

显示更多
成吉思鸡 ·

腾讯混元Hy4预览版发布,模型体积从1.5TB压缩到214GB,缩小了7倍,性能几乎没有损失。

核心是他们自研的Sherry量化方法,能把模型权重压缩到1.25bit。这个压缩率相当惊人——通常量化到4bit就已经是极限了,1.25bit意味着压缩了3倍以上。

这个技术的意义在于:

  1. 部署成本大幅降低——原来需要多台高端GPU的模型,现在单机就能跑
  2. 推理速度更快——更小的模型意味着更低的延迟
  3. 边缘设备也能用——手机、笔记本等设备有望运行大模型

对于做AI应用的开发者来说,这是个好消息。模型压缩技术的进步意味着更多场景可以落地大模型,而不只是停留在云端。

腾讯在大模型压缩这块确实有两把刷子,Sherry量化方法值得关注。

显示更多
话题来源 @TencentAI_News 300K阅读 ❤️1791
飞翔的智能体 ·
同样的模型、同样的任务,一个Agent花3倍Token才完成?问题出在harness上! TrueForge是一个开源的LLM Agent harness框架,核心思想:把不必要的内容推出模型上下文,在需要时再加载。 三大设计原则: ✅ Memory(记忆):持有权重和上下文不该承载的状态 ✅ Skills(技能):持有程序性知识,覆盖操作流程和启发式规则 ✅ Protocols(协议):持有用户、其他Agent和工具的交互契约 实际效果:在DevRev的Enterprise-Bench上,TrueForge用相同的模型完成了和Claude Managed Agents一样多的任务,但Token消耗只有后者的1/3,工具调用减少约40%。 关键技术细节: • 工具Schema延迟加载(除非开启预加载) • 大响应写入沙箱文件 • 生成的代码通过harness调用工具,沙箱不持有凭证 GitHub:github.com/truefoundry/tr…
显示更多 话题来源 @_avichawla 135K阅读 ❤️1247
飞翔的智能体 ·
想系统学大模型,终于有一套质量不错的中文教材了! 浙大团队开源了一本《大模型基础》,GitHub已拿下16K+ Stars,六章完整版PDF可以直接免费下载。 从语言模型基础一路讲到LLM架构、Prompt工程、参数高效微调、模型编辑、RAG,每章还整理了相关论文,想继续深入也有现成路线。 比较有意思的是,每章都用不同动物作为示例背景,把一些抽象概念讲得更直观。项目还在持续更新,后续计划加入大模型推理加速、AI Agent等内容。 GitHub:github.com/ZJU-LLMs/Found…
显示更多 话题来源 @grgerwcwetwet 28K阅读 ❤️400
封面由站内生成
会飞的荧 ·
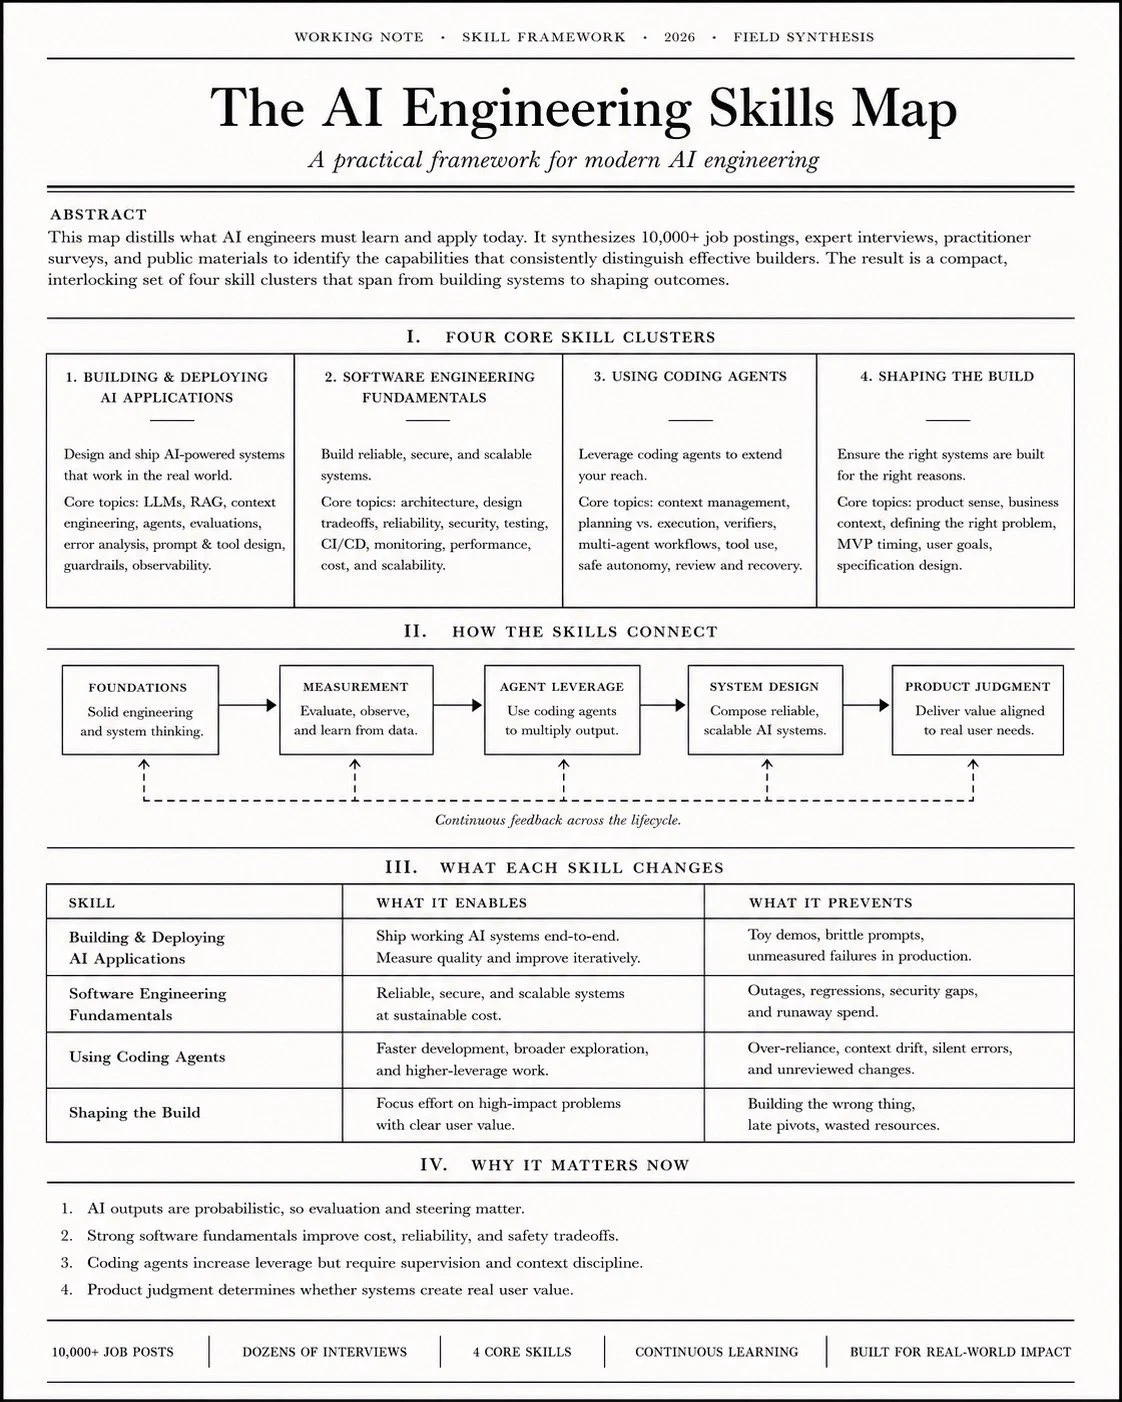
吴恩达老师分享「AI Engineering 技能图谱」 团队分析了超过 1 万份 JD,并对 AI 专家、招聘经理和猎头进行了数十次结构化访谈,结合调查问卷和网络数据,得出「AI Engineering 四个核心技能」。 构建与部署 AI 应用 AI 应用与传统软件的根本区别在于输出的不可预测性——你无法预知 LLM 会返回什么,也无法预知模型在新样本上的预测。 因此核心能力不只是掌握 LLM、上下文工程、RAG、智能体工作流、深度学习这些构件,更在于用统计方法去度量、引导和治理 AI 系统,其中最关键的是"纪律严明的评估与错误分析闭环"。 2. 软件工程基本功 工程的本质是在成本、可扩展性、可靠性、速度、安全、隐私之间做权衡。只有理解底层原理,你才看得见权衡的存在。 一个尖锐的现实:不懂基本功的开发者做 "vibe coding",往往不知道给编程智能体提供什么上下文,也就无法察觉智能体正在替自己做糟糕的架构决策。 基本功的价值从"亲手写代码"转移到了"用精确的工程语言驾驭智能体"。 使用编程智能体 这已成为每个开发者的必备技能,包括: · 对智能体能力与局限的准确心智模型,知道何时干预、何时放手 · 管理智能体的上下文,在规划与执行之间做权衡 · 提供验证器或评估机制,让智能体自主闭环 编写清晰的规格说明(以及判断何时不必写) · 编排多个智能体协同工作 · 规避高风险操作(如智能体误操作生产数据库) · 由于该领域快速演进,还需建立持续尝试新工具、迭代工作流的习惯 4. 塑造构建方向 当智能体越来越擅长"按规格交付",工程师的价值重心就上移到"决定规格里该写什么"。 这意味着:工程师不能再等着拿到像素级完美的设计稿只做实现,而需要具备产品 Sense、商业上下文和客户目标的理解,参与定义做什么。同时要把握节奏——知道何时快速做 MVP 验证用户,何时放慢脚步精心构建。 GitHub: github.com/Dujltqzv/Some-…
显示更多 话题来源 @shao__meng 2W阅读 ❤️287
封面由站内生成
飞翔的智能体 ·
这是一本从零开始学习 AI 工程的开源仓库,GitHub 已经超过 5 万星。它不搞"十分钟做一个 AI 应用"那种速成,而是从数学基础一路往上推:机器学习、深度学习、Transformer、LLM、RAG、MCP、Agent,再到多 Agent。 全书共 511 节,20 个阶段,大约 329 小时的学习内容。最硬核的是很多核心东西都得先自己手写一遍,不是调 API 就完事了。 适合想真正理解 AI 工程底层原理的开发者,而不是只想快速出活的。从 Attention 机制到 Tokenizer,从反向传播到 Agent 架构,每个环节都有详细的数学推导和代码实现。 GitHub 地址:github.com/rohitg00/ai-en…
显示更多 话题来源 @daweifs 38K阅读 ❤️493
封面由站内生成
GitHub - rohitg00/ai-engineering-from-scratch: Learn it. Build it. Ship it for others. Learn it. Build it. Ship it for others. Contribute to rohitg00/ai-engineering-from-scratch development by creating an account on GitHub. GitHub
飞翔的智能体 ·
GitHub Trending上突然杀出一个5万多星的项目,教你从零训一个25.8M参数的超小语言模型。 这个叫MiniMind的项目,最小版本体积只有GPT-3的1/2700,但它把造大模型的整套流程从头到尾给你演示了一遍:分词器训练、预训练到微调全链路,一步都没省。甚至还搭了一个能看图的MiniMind-V版本。 所有脚本全是PyTorch手写的,MoE架构也支持。以前觉得训模型是大厂专属,现在用自己电脑就能跑通整个流程,虽然参数量小,但该有的步骤一个不少。 最适合想理解LLM底层原理但不想花几千块买课的人。直接clone下来跑一遍,比看十篇教程都管用。 GitHub地址:github.com/jingyaogong/mi…
显示更多 话题来源 @bkdgiffug 38K阅读 ❤️651
封面由站内生成
GitHub - jingyaogong/minimind: 🧠 Train a 64M-parameter LLM from scratch in just 2h! 🧠 Train a 64M-parameter LLM from scratch in just 2h! - jingyaogong/minimind GitHub
我不是小布丁 ·
吴恩达(Andrew Ng)刚刚发布了一份文档,梳理了AI工程师在2026年真正需要的4项核心技能。该文档基于1万多份招聘信息、专家访谈和调研数据编制,呈现了工程师当前真正需要关注的能力地图: 构建AI应用 → 精通软件工程 → 掌控编码智能体 → 主导项目构建 4 clusters cover LLMs, RAG, evals, context engineering, architecture, verifiers, multi-agent workflows and product sense coding agents can already execute clear specs. the bigger skill is deciding what to build, giving agents the right context and knowing when to intervene 10,000+ jobs distilled into 4 core skills. bookmark this before deciding what to learn next
显示更多 话题来源 @gippp69 1W阅读 ❤️233
封面由站内生成
Gipp 🦅 (@gippp69) on X ANDREW NG JUST DROPPED THE DOCUMENT THAT MAPS THE 4 SKILLS AI ENGINEERS ACTUALLY NEED IN 2026 he built it from 10,000+ job postings, expert interviews and surveys. the result is a map of what actuall X (formerly Twitter)
飞翔的智能体 ·
💻 不用买多卡工作站也能跑大模型了! 开源推理引擎FreeToken把CPU、GPU、内存统合为一体,让你的轻薄本也能跑大模型。 8G显存轻薄本能跑35B MoE,家用单卡4090能跑405B,70B在24G显存里丝滑输出。性能比vLLM吞吐量高50%,速度提升300%,完全兼容llama.cpp和Hugging Face格式。 零门槛上手:一条命令安装,纯Python API,30行代码就能集成进任何项目。零成本落地:项目全开源,无需额外硬件投入,轻薄本、老显卡都能跑起来。 这个项目最大的意义是降低了大模型部署的门槛。以前跑70B模型至少需要多张显卡,现在一张消费级显卡就够了。对于个人开发者和小团队来说,这是真正的福音。
显示更多 话题来源 @AISuperDomain 18K阅读 ❤️267
封面由站内生成
飞翔的智能体 ·
📚 一周17k star:《深入理解AI Agent》为什么这么火? 这本书不是那种从GitHub抄代码然后给你讲故事的水书,是真的从底层逻辑讲清楚:Agent为什么能"自己想"、"自己干"、"自己学"。 最硬核的部分是LLM从"预测下一个词"到"生成行动计划"的整个推理链路,第一次能看懂为什么Agent有时候会"跑偏"。还有写Agent最头疼的幻觉问题,这里给了具体方法论,不是喊"加强Prompt"。 Memory的三种机制也讲得太清楚了——短时记忆、长时记忆、工作记忆,原来根本不是一回事。这种理解对于构建稳定可靠的Agent系统至关重要。 最实用的是:每一章都有实操代码,不是那种"参考实现"的placeholder,是真的能跑、能出结果的。用Codex带着过一遍,相当于跟着高手手把手写了一遍Agent。 一个判断方法:如果你读的时候不觉得被绕进去,那说明你已经到了该读这本书的时候了。这种书不会每年都出,错过这一本,下一本可能要等很久。
显示更多 话题来源 @gkxspace 66K阅读 ❤️1020
封面由站内生成
飞翔的智能体 ·
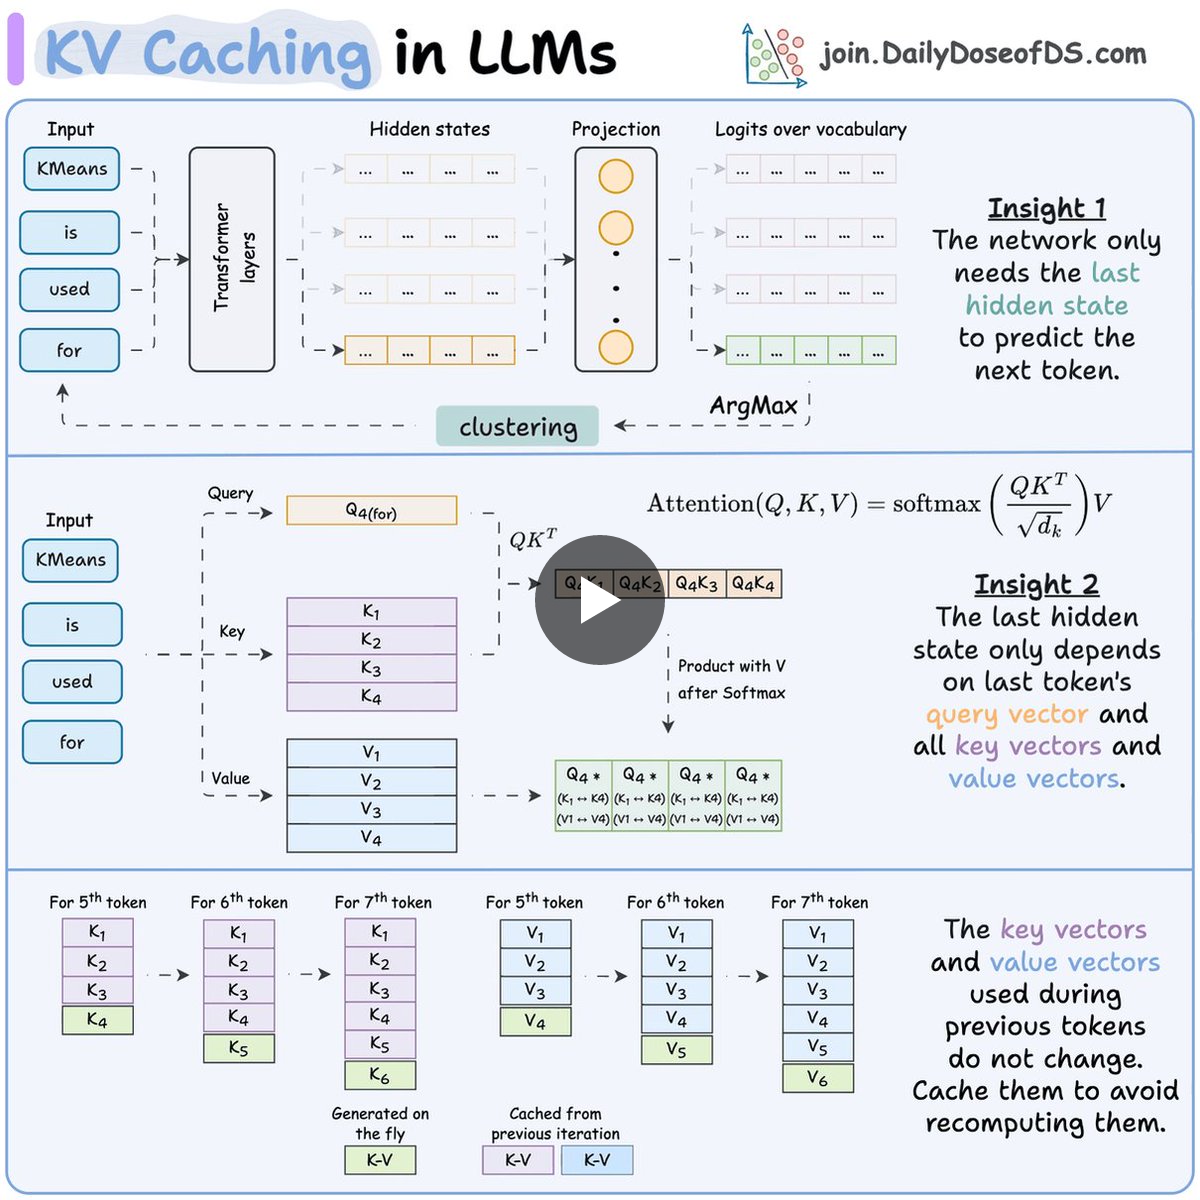
为什么KV Cache只存储K和V向量,而从不存储Q?这是一个经典的LLM面试问题。 理解这个问题需要回到自回归解码的本质。LLM是逐个生成token的,每个新token的生成都依赖于所有之前的token。关键在于:当生成第n+1个token时,我们需要Q_n+1与K_1到K_n+1进行注意力计算,然后乘以V_1到V_n+1。 但在生成第n个token时,我们已经计算过Q_n与K_1到K_n的点积,以及V_1到V_n的加权和。而且由于因果掩码的存在,K_1到K_n和V_1到V_n在第n步和第n+1步之间不会改变——因为它们只依赖于当前token和之前的token,不会因为后面添加了新token而变化。 所以,我们可以直接复用之前计算过的K和V,只需要计算新的Q_n+1、K_n+1和V_n+1。而Q向量只在当前步使用一次,之后就被丢弃,因此不需要缓存。 这个优化能显著减少重复计算,提升推理效率。对于长序列来说,节省的计算量非常可观。这也是为什么KV Cache是现代LLM推理中不可或缺的技术。
显示更多 话题来源 @_avichawla 440K阅读 ❤️2433
封面由站内生成
Avi Chawla (@_avichawla) on X Why KV cache stores K and V vectors but never Q? (a popular technical LLM interview question) LLMs are autoregressive so each token is predicted from every token before it, one at a time. This auto X (formerly Twitter)
飞翔的智能体 ·

🚀 腾讯混元发布Hy4:770B参数、49B激活、100万上下文,开源前沿模型

腾讯混元团队发布了Hy4预览版,这可能是目前最强的开源大模型之一。

核心参数

  • 总参数:770B(7700亿)
  • 激活参数:49B(490亿)
  • 上下文长度:100万token
  • 定位:专注生产力,开源前沿

技术亮点

  1. 超长上下文:100万token的上下文窗口,可以一次性处理超长文档、代码库或对话历史
  2. 高效激活:虽然总参数高达770B,但每次推理只激活49B参数,在保持性能的同时降低推理成本
  3. 开源开放:模型权重、代码、训练细节全部开源,社区可以直接使用和改进

为什么这个发布重要?

在闭源模型不断涨价的今天,开源模型正在快速追赶。Hy4的发布意味着:

  1. 企业可以私有化部署:不用担心数据泄露,可以部署在自己的服务器上
  2. 成本更低:不需要为API调用付费,长期使用成本更低
  3. 可定制:可以根据自己的需求微调模型,打造专属AI助手

使用场景

  • 企业知识库:处理大量内部文档,提供智能问答
  • 代码助手:理解整个代码库,提供代码补全和重构建议
  • 内容创作:处理超长文本,生成高质量文章
  • 数据分析:分析大规模数据集,提供洞察

社区反响

推文获得了5292个点赞和227万次浏览,说明社区对开源前沿模型的需求非常强烈。许多开发者表示要立即尝试,测试其在实际项目中的表现。

技术趋势

这个发布反映了AI领域的一个重要趋势:开源与闭源的竞争越来越激烈。腾讯混元通过开源Hy4,不仅展示了技术实力,也推动了整个行业的进步。

个人思考:

对于需要处理超长上下文的应用场景,Hy4提供了一个强大的选择。100万token的上下文窗口,意味着你可以一次性输入整本书、整个代码库或几个月的对话历史。

建议关注这个模型的发展,特别是需要私有化部署或处理超长文档的场景。开源模型的进步正在改变AI的使用方式。

显示更多 话题来源 @TencentHunyuan ❤️5292
封面由站内生成
Tencent Hy (@TencentHunyuan) on X 🚀 Hy4 preview is here. 770B, 49B active, 1M context. Built for productivity. Open source frontier. Consistent affordable price. Use it. Tell us what breaks. More on Hy blog:https://t.co/rbl1IWRk3C H X (formerly Twitter)
胡辣汤爱酸菜 ·
2026年的Agentic Engineering(智能体工程)不在于追逐最新模型。🤖 而在于围绕那些真正能通过生产环境考验的模型构建系统。 优秀的prompt能帮你做出演示Demo。 优秀的architecture才能帮你打造产品。 以下是每位工程师都应了解的Agentic AI(智能体AI)技术栈 👇 🧠 LLMs + Reasoning Models(推理模型) Understand what the model can reason through on its own before adding more agents, tools or complexity. 🧩 Context Engineering(上下文工程) Prompt engineering(提示词工程)只是其中一部分。 真正的技术难点在于设计模型所见的一切:指令、数据、工具、记忆与状态。 💾 记忆架构 会话记忆、语义检索与情景记忆解决的是完全不同的问题。 🤝 智能体工作流 复杂系统越来越需要专业化智能体、交接、状态管理与故障恢复。 🔌 MCP + 工具连接 代理在与真实系统、API 和企业数据交互时才会变得强大。 🚦 Model Routing(模型路由)+ AI Gateways(AI 网关) 并非所有任务都需要你最强大的模型。 按能力、延迟、成本和风险进行路由。 🛡️ Guardrails(护栏)+ Security(安全) 你赋予代理的自主权越高,权限、验证和人工干预就越重要。 🔍 Observability(可观测性)+ Evaluation(评估) 你需要对以下内容具备可见性: → agent 看到了什么 → 它决定了什么 → 它使用了哪个工具 → 工作流在何处断裂 最大的转变? Agentic Engineering(智能体工程)正变得越来越不侧重于"使用 LLM"…… ……而更多地转向围绕智能的分布式系统工程。 最优秀的 Agentic AI 工程师将不仅仅是了解模型。 他们将懂得如何让模型在现实世界中变得可靠、可观测、安全、成本高效且实用。 真正的工程从这里开始。🚀 #AgenticAI #AI #ArtificialIntelligence #AIEngineering #LLM #GenerativeAI #MachineLearning #Tech #Innovation #FutureOfWork GitHub: github.com/Dujltqzv/Some-…
显示更多 话题来源 @RishiUvaach 1W阅读 ❤️262
GitHub - Dujltqzv/Some-Many-Books: 个人收藏书籍列表                                                                              github.com
飞翔的智能体 ·
🔥 多Agent协作的"电话游戏"困境,终于有人解了 Anthropic做了一个实验:把一个编程任务拆成4个Agent,分别扮演规划者、实现者、测试者和审查者。结果发现——Agent之间花在协调上的token比干活本身还多。 这就是经典的"电话游戏"效应:每经过一次信息传递,质量就下降一分。每个Agent拿到的上下文都在退化,就像传话游戏里最后一个人听到的内容和第一个人说的完全不一样。 OpenAI在Agent SDK里加了handoffs原语,Google的ADK控制父Agent给子Agent传多少上下文。但这些都是设计时接线——你必须提前知道哪个Agent喂给哪个Agent。 问题是:现实中很多协作需求是临时冒出来的。比如线上服务报错率飙升,值班Agent查日志发现是某次部署导致的,接下来有人决定要画个图表对比上周基线。这个决策一分钟前还不存在,根本不会有预设的handoff。 Switch(Flint AI团队出品)的做法是把Agent和人都放进同一个聊天频道,任何人和任何Agent都可以直接协作,不需要预先接线。好处是: 1️⃣ 图表Agent加入频道时,能看到值班Agent的完整报告,不用重复查询 2️⃣ 被叫来做图表的人不用手动搬运上下文——第一个Agent的结论已经在频道里了 3️⃣ 如果第一个Agent发现没有回归问题,结果即时可见,团队不用等人工转达 关键是:人仍然掌控路由权,但不再需要当"人肉搬运工"。Switch支持Claude Code、OpenAI Codex、OpenCode等主流框架,也能对接Slack、Teams、Discord这些团队工具。 这可能是目前解决多Agent动态协作最优雅的方案了。你觉得Agent之间的信息传递该怎么设计?
显示更多 话题来源 @_avichawla ❤️630
封面由站内生成
Avi Chawla (@_avichawla) on X Anthropic did something you'll regret ignoring: They split one coding task across four agents by role, as a planner, implementer, tester, and reviewer. The goal was to test whether splitting agents X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单