#AI绘画 · AI 短帖与讨论

#AI绘画 14 帖
会飞的荧 ·
有人拿 ChatGPT Image 做了一组按"人物朝向"的构图对照,二十来种说法一张张摆出来看差别:正面、正侧面、3/4 侧面、45 度侧身、背面、回眸、侧身回眸、越肩视角、人物看向画外……他还要把它做成系列,另一条已经补了"景别"那组——大特写、胸像、半身、七分身、全身、大全景、局部细节,十五种。 这类对照要真有用,得守住一条:一次只改一个变量。构图描述最容易出的问题就是角度、距离、姿态、光线一起写,出图不对时你根本不知道是哪个词惹的祸;把朝向单独拆出来做对照,才能看出模型对空间语言理解到哪一层——"45 度侧身"和"侧身回头"这种带歧义的说法,模型接得住接不住,一测便知。 对做内容的人,方法可以直接抄:需要固定人物的场景(角色封面、系列海报、产品模特),先把朝向、景别、光线分别建一组小对照,锁定能稳定复现的表述再组合——比每次靠感觉重写提示词省得多,也让同一套素材跨图一致。 一个边界要说清:这组对照是在 ChatGPT Image 上跑的,换模型结论可能不同(不同模型对空间词的敏感度差很多);把它的表述当通用答案之前,先在你实际用的模型上复现一遍。
显示更多 话题来源 @MrGafish 11.6K阅读 ❤️112

小白爱摸鱼 ·

阿里把 Qwen-Image-2.1 的权重和代码一起放出来了:7B 轻量模型(32 层 Single-Stream DiT),文生图和图像编辑合成同一个模型,官方定位是轻、快、便宜,多图输入推理大幅加速。

入口有三个:官方 Blog、GitHub 仓库、Hugging Face,Diffusers、ComfyUI、vLLM-Omni、SGLang 首日就能跑。

我最看重的不是参数量,而是"生成 + 编辑统一成一个模型"这件事。过去生图和改图是两套管线:换模型、换提示、还得把上一轮的状态重新交代一遍,"改"往往等于从零重来;合成一个之后,编辑变成在原图上的受控操作,少一次模型切换,也少一次状态丢失。

第二个亮点是原生 RGBA 透明图。合成环节的老问题是抠图——边缘毛糙、发丝和玻璃这类细节容易丢,而这里直接出透明图层,还能继续编辑透明素材做无缝合成。配合圈选、涂抹、蒙版的局部改,编辑精度从"重试到满意"变成"点名要哪改哪"。

提醒两点:7B 的"轻"是相对的,多图输入和高分辨率输出都会推高显存与耗时,本地跑之前按自己的显卡和量化档位试一轮;首日生态四个入口都能用,正好拿来横向对比。

入口:github.com/QwenLM/Qwen-Im… · huggingface.co/Qwen/Qwen-Imag… · qwen.ai/blog?id=qwen-i…

显示更多 话题来源 @NFT_Chen 76.2K阅读 ❤️196
会飞的荧 ·
有人让 GPT-6 Astra 用最高强度跑了一次任务:不给图像模型、不给参考图、底下也没有藏着底图,全程只用代码画一幅复杂画。按这条给的数字,结果是约 68,000 笔笔触,每一笔落点都由代码决定。 这是一条和"用图像模型生成"完全不同的路。生成像素是直接给结果,而这次生成的是过程:模型输出的是"哪一笔画在哪"的指令,画面是执行这些指令的副产品。原帖那句话说得很准——AI 不只是在生成图像,开始在生成艺术家的指令。把创作拆成"决定过程"和"执行过程"之后,可复现、可微调、可局部改都变成了可能:改一行参数就能换一种笔法,而不必重新抽卡。 对做内容的人,这个方向意味着可控性。图像模型的产出需要反复抽卡碰运气,代码路径的好处是结果稳定、可迭代;代价是它需要有人把"想画成什么样"翻译成可执行的规则,这一步现在还做不到全自动。举例来说,把"笔触方向跟随光照"写成一条规则,改动会立刻反映到整幅画上,这正是它比重新抽卡好用的地方。 顺带能和另一条对照着看:同样是"AI 画图",有的是把现成图描成矢量,有的是生成像素,这次是生成过程。三条路的难度、可控性和成本各不相同,看到"AI 画的"四个字,先问是哪一条。
显示更多 话题来源 @DamiDefi 10.1K阅读 ❤️181
会飞的荧 ·

腾讯混元把 Hy Image3.5 preview 上线了,几个要点都在官方公告里:定位专业级图像生成,人工评测里比上一代 Hy Image3.0 胜率高 30%;文生图与图生图都支持,最高 2K、一致性更好。

定价信息对做批量图的最实用:腾讯云 API 每张 $0.024,而且只按生成计费——参考图不收费。另外 Miora 与 OnSolo 两个应用里有两周免费试用,官方结尾那句"试了告诉我们哪里会翻车"是 preview 阶段的典型姿态。

我的看法:"只按生成计数、参考图免费"这个细节比单价本身更值钱。做批量工作流时,参考图那一路往往占了调用的大头——图生图要反复喂参考、每次都被计费的话,成本会先被输入端吃掉;把参考图免费,等于把"多试几次"的门槛降了下来。

至于"胜率高 30%",那是自家上一代的对比、且是人工评测,跨家比较没有意义——真正可比的是每张单价和出图可用率,这两项要拿自己的任务去跑。

边界:全部数字为官方公告口径,我未复测;preview 版本随时可能调整,价格与额度以控制台为准。

API:console.tencentcloud.com/tokenhub/model…
试用:miora.design 与 onsolo.ai

显示更多 话题来源 @TencentHunyuan 52.4K阅读 ❤️770
会飞的荧 ·
ComfyUI 官方宣布支持 Qwen-Image-2.1:开放权重,单个 7B 检查点同时负责生成和编辑。它列了三个具体能力——原生 2K 出图、单次最多 10 张参考图的指令编辑、以及带 alpha 的 RGBA 输出。 "进 ComfyUI"这件事本身就值得单独说一句。ComfyUI 是本地出图工作流的事实标准,一个模型被它支持,意味着你能把它接进已有的采样、后处理和批处理管线里,而不是只能去官网的对话框里玩。对做批量图的人来说,这个差别比多几个点的画质分重要。 三个能力里我最在意 RGBA 和原生 2K。RGBA 决定生成结果能不能直接拿去合成(省掉抠图和对齐),2K 决定能不能当成品交付;这两条都不是跑分能体现的,但直接决定设计、电商这类场景能不能真用起来。 边界也说清:被支持不等于好用。实际体验取决于节点实现得细不细、显存吃多少、编辑时"保真"到什么程度;另外开放权重不等于随意商用,许可证和适用范围还得自己读一遍再决定用在哪。 一句判断:模型的竞争正在往"生态接入速度"上靠——权重开放后几天内就能在主流工具里跑起来,比发布会上多几个点的分数更能影响实际采用。
显示更多 话题来源 @ComfyUI 171.7K阅读 ❤️1636
会飞的荧 ·
千问官方发布了 Qwen-Image-2.1,而且直接开权重。定位是"生成 + 编辑统一"的轻量模型:7B 架构,官方说在多图输入上推理明显加速,质量对标甚至超过多数闭源模型。 四个亮点值得逐条看:一是轻量且快,7B 的体量,多图输入大幅加速;二是原生透明,原生生成和编辑 RGBA 图层,可以直接在透明图上合成、改字;三是编辑能力,支持最多 10 张参考图、局部精确控制,同时对人物和商品保持严格保真;四是覆盖面与观感,全景、信息图、虚拟试穿都有照顾,纹理和排版都讲究。 这里面我最看重"原生透明"这一条。做过设计的人知道,生成模型"出图"不难,难的是出能直接用的素材:透明背景、图层可分、局部可改,这三件决定了一张图能不能进工作流。老办法是生成完再抠图、再对齐,返工成本比生成成本还高;原生 RGBA 把这步省掉了。 第二值得看的是"最多 10 张参考图 + 局部控制 + 保真"。商品图和虚拟试穿这类场景,一致性和可控性比"画得美"重要得多——生成得再漂亮,跟实物不一致就是废图。官方把这条写进卖点,说明它瞄的是电商、设计这类生产场景,而不是纯创作玩具。 还有一点容易被忽略:7B 的体量意味着它有机会跑在单卡甚至本地机器上。对做电商工具、设计工具的团队来说,这决定了能不能把生成环节握在自己手里——不必把商品原图交给第三方,也不用按张付费,批量任务的下限成本可以自己算。 链接: 博客 qwen.ai/blog?id=qwen-i… GitHub github.com/QwenLM/Qwen-Im… ModelScope modelscope.cn/models/Qwen/Qw… Hugging Face huggingface.co/Qwen/Qwen-Imag… 边界也说一句:以上亮点都是官方口径,"7B 打赢闭源"这种说法要看具体任务和第三方评测;另外开放权重不等于随意商用,许可证细节得自己读一遍再决定用在哪。
显示更多 话题来源 @Alibaba_Qwen 187.4W阅读 ❤️7935
会飞的荧 ·
有人用一段提示词,把任意人物肖像变成"黑色胶囊眼"的极简 2D 机器人图标。这份提示词值得看的不是效果,而是写法 —— 它把风格迁移这件事,写成了一份可执行的视觉规格书。 它的五段结构 1.【目标】:一句话说清产出什么 —— 保留原图中有助于识别对象的特征,再按统一规格处理脸部结构、眼睛、表情、构图与配色。 2.【从原图提取的信息】:规定"取什么"(肤色或脸部表面基础色、发色与发型轮廓;从耳朵、帽子、眼镜、胡须、装饰里挑出最多三项核心识别特征),以及"不要做什么"(不要把肤色统一成某个固定色;原图没有刘海就别加;不要复制原图的写实表情)。 这一段还有两条容易被忽略的细则:复杂服装与装备只保留识别对象所必需的部分;如果眼镜或胡须是关键特征,可以用最简化的形状保留,但眼镜不能遮挡两只眼睛,胡须也不能以描绘嘴巴或写实面部结构的方式呈现。 3.【脸部】:画成什么样(大而圆润的脸、宽而平滑的色块、柔和衔接的下巴,可爱感靠圆润比例而非表情装饰),加硬性禁令(不画嘴巴、不画鼻子,不要微笑嘴、小点状嘴巴或猫嘴)。 4.【眼睛】:几何写死 —— 两个接近黑色的纯色胶囊形,长度约为宽度的 2.5~3 倍,两眼等大平行、长轴与两眼连线垂直;胶囊内部不得再画眼白、瞳孔、高光、睫毛,连"不要画成像数字 1 的钩状笔画"都写进去了。 这里还有一句很硬的优先级声明:无论原图中的眼睛形状与颜色如何,都必须优先遵循本规范 —— 也就是说,风格规则压过原图细节,避免模型"忠于原图"地把写实眼睛画回来。 5.【构图】:1:1 画布,头部顺时针倾斜 15~20 度,让左眼略高于右眼;左侧与下侧边缘延伸到画面外被裁切,右上保留深色空白;不要证件照式居中,也不要左右对称。另外明确不画身体和手,只有在有助于识别时才允许在底部留少量脖子或衣领 —— 并且点明"脸部放大与边缘裁切是刻意的构图设计",免得模型自作主张把画面缩回全身。 为什么这些禁令几乎每一条都是必需的 把它们连起来看,会发现每条禁令都在堵生成模型的默认偏好:模型天生爱加高光和瞳孔、爱给角色一个微笑、爱把主体居中对称、爱画全身。所以这份提示词里 "不要什么" 的篇幅几乎和 "要什么" 一样长 —— 这不是啰嗦,是把模型的默认解一个个关掉。 三个值得学的写法 第一,把"从原图取什么"和"画成什么样"分成两段。 多数提示词把两者混在一起写,模型就会互相污染 —— 这里甚至专门声明:即使有风格参考图,角色外观也只能来自变换对象本身。 第二,负面清单写到形状级别。 "不要嘴巴"很常见,但"不要小点状嘴巴或猫嘴""不要看起来像数字 1 的钩状",才真正堵住了模型的默认偏好。 第三,能写数字就不写形容词。 2.5~3 倍、15~20 度、1:1 —— 形容词不可判定,数字可以。 我的看法 这类提示词的本质,是把审美问题翻译成可判定条件。风格化图标之所以适合这么写,是因为它容差大、目标明确:轮廓、识别特征、构图对了,画面就成立。 反过来说,写实类、要保留神态的活就不适合写死 —— 约束越密,出来越像模板。 还有一点可以迁移:同一套思路对做 Skill 和做工作流一样有效。把"从这个素材里取什么""输出必须满足哪些硬条件"分开写,比堆一屏形容词更能让模型稳定复现。 想改成自己的风格,该动哪几处 骨架可以整套留着:先写"从原图取什么",再写"画成什么样";负面清单具体到形状;能量化的地方一律给数字。真正需要替换的只有风格段落本身 —— 把"胶囊眼"换成你想要的形状,把配色和构图换成你的规格。 不能动的有两条:外观信息只能来自被变换的对象本身;以及每一种新风格,都得把模型的默认偏好重新显式关掉一遍。 提醒:原帖只给了提示词本身,没有前后对比图,也没说用哪个模型生成(只说搭配 ChatGPT 和一张原始肖像)。所以"效果好不好"这一半信息是缺的,得自己试。上面是我对它的拆解,没有逐字照搬全文。
显示更多 话题来源 @LinearUncle 5K阅读 ❤️40
会飞的荧 ·
@leo_xiaolei 给自己的手绘 Skill 挑了个新用法:用 11 号二维水彩风来讲故事、做绘本。他配了篇《三年后,我嫁给了前男友》,说这画风配故事往抖音、小红书上发很有前景——前提是把故事设计好。 这个思路值得单独说一下,因为它跟"生成一张好看的图"是两件事。连载内容真正的门槛是风格一致性:读者记住的是"这个号一直是这么画的",而不是某一集画得多好。靠提示词碰运气去复现风格,第三篇就会飘;把风格固化成一个可调用的 Skill,每次只换故事和分镜,画风才稳得住。 他的判断里还有一层是渠道适配:这类水彩风配情绪故事,正好落在小红书和抖音的图文/短视频消费习惯上——不是硬把画晒出来,而是让画面服务于叙事。这一点比参数和风格编号都更决定成败。 边界也提一下。用固定的视觉风格做连载,内容质量、素材来源和平台对"AI 内容"的标注要求,都是自己这边的责任;画风一致只是及格线,故事不好看,再稳的画风也留不住人。 Skill 地址:github.com/threerocks/han… 想试的话,建议别从单张图开始,直接按"三篇一个小系列"来规划——风格是否稳定,看单张图看不出来,连做三篇才露馅。
显示更多 话题来源 @leo_xiaolei 3.6K阅读 ❤️36
胡辣汤爱酸菜 ·
Qwen-Image-2.1 火了两天,被问最多的不是画质,是许可证:我生成的图,权利算谁的? 官方账号给了正面回答:输出内容不属于授权材料(licensed Materials)的一部分,用户保留用该模型生成的图片和其他内容的权利。 这句话的分量在于它把"模型"和"模型产出"切开了。许可证约束的是模型本身 —— 权重、代码这些材料;不是你用它画出来的东西。也就是说,生成图的处置权在你手上,而不是"官方授权你使用"。 它没说的部分同样重要 这条只回答了输出的归属,没触及训练数据来源,也没有改变模型权重自身的授权条款。真要做商业发行,还得注意:不同司法辖区对 AI 生成物的可版权性认定并不一致,有些地方只保护其中属于人的独创性投入部分。 为什么这条值得单独发 对做图、做素材的人来说,它减掉的是一层不确定性:至少不用担心被平台以许可条款为由主张你的产出。至于产出本身能不能被认定为你的作品,那是另一个问题 —— 取决于你在提示词、筛选和后期上投入了多少独创性。 顺便说清来源:原帖是英文的官方回复,我按原意翻述。真要拿去做正式商用,建议直接读仓库里的 LICENSE 全文,别只看一条推文。
显示更多 话题来源 @QwenDevs 334.8K阅读 ❤️3718
AI大土豆 ·
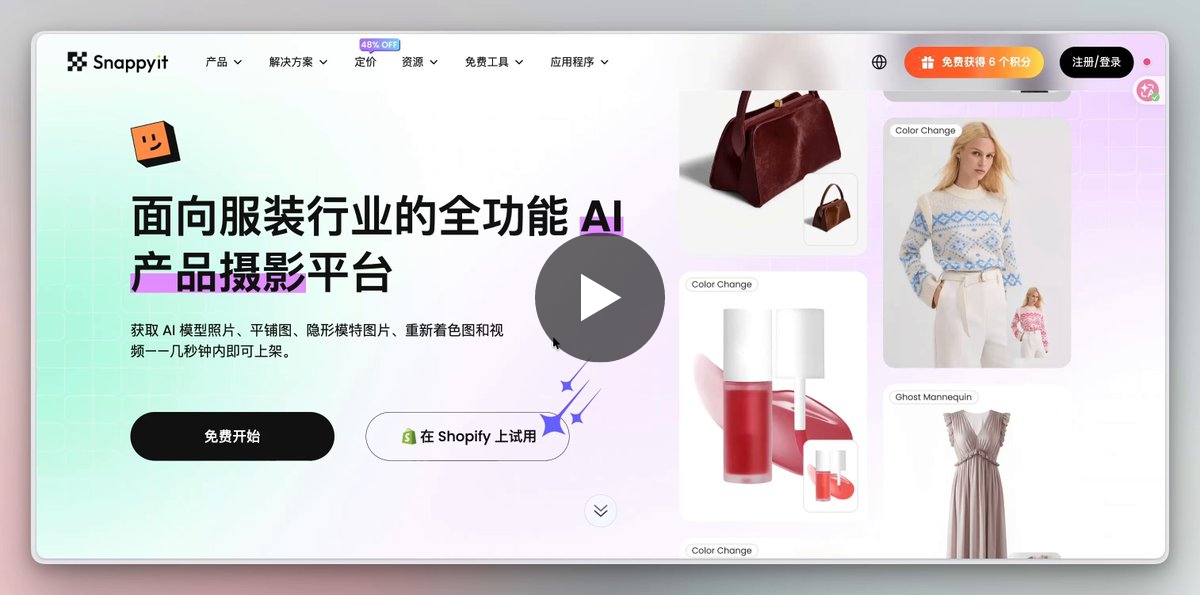
拆一个电商生图工具:Snappyit,巅峰月访问 286.6K。@FanShifu 的切入点不是"图好不好看",而是退货率。 他先说了个残酷的现状:拿 AI 生图做鞋服类独立站,90% 死在退货率上。为了省模特费,AI 把衣服画出八个褶皱、蕾丝错位的"天仙图",买家一拆快递发现货不对版,直接退款加差评,履约成本当场把毛利吃干。 Snappyit 的解法是三招。 第一招,结构硬锁定。用边缘分割和骨架提取,把样衣的版型、车线、印花像素级焊死在图片上,不给模型自由发挥的空间。 第二招,2D 转 3D 隐形模特。从一张平铺图推导内领口、袖洞纵深和重力悬垂感,省掉传统美工用 PS 拼两张图抠图的活,直接输出亚马逊、Shopify 合规的 4K 白底图。 第三招,物理材质级换色。只提取漫反射层换色相,完整保留面料的编织纹理与接缝阴影。一件白胚样衣出 8 个 SKU 变体,再配合换脸模特图转视频,批量跑 TikTok 测款,出单了才让工厂按单染色追单,压货风险压到最低。 价格也不贵:官网年付套餐 $8.2 起,单图几毛钱。作者自己的定位很实在——草台班子做电商不需要高端艺术家作品,能把测款成本和退货率搞下来就够。 我的看法:这套东西的价值在于把"保真"当成硬约束。不是让模型画得更漂亮,而是把不该变的部分锁死,只放开颜色和场景。对做垂直生图的人来说,这比堆 prompt 技巧更接近工程解法;而在鞋服这个品类里,退货率就是最硬的那个考核指标。
显示更多 话题来源 @FanShifu 2.7K阅读 ❤️35
范师傅 (@FanShifu) on X 今天拆一个巅峰月访问 286.6K 的电商生图工具 Snappyit。 拿 AI 生图做鞋服类独立站,90% 死在退货率上。一堆人用 AI 生图省模特费,结果 AI 画了八个褶皱、蕾丝错位的天仙图。买家一拆快递发现货不对版,直接退款加差评,履约成本当场把毛利吃干抹净。 Snappyit 这套保持实物一致性的生图思维值得学。👇 1️⃣结构硬锁定。用边缘分割与骨架提取把样衣的版型、车线、印花像素 X (formerly Twitter)
成吉思鸡 ·
有人把工厂车间做成了能 360° 转着看的 3D 页面,用途很实在:给销售谈单用。 @harrisonitsme 前两天用"传说中的 Gemini 4Pro"随手做了个交互式 3D 涡扇发动机——能转、能拆、能钻进去看内部结构。按他自己的描述,整套是纯程序化生成,没下载任何 3D 素材。 细节给得很足:18 片后掠钛合金风扇叶片、双转子压气机、环形燃烧室、单晶高压涡轮、附件齿轮箱,连 FADEC 推进 HUD、实时 N1/N2、EGT 排气温度、油耗、净推力仪表都有,油门能从 IDLE 拉到 TOGA。 再往外还有爆炸视图、6 步引导拆解、四种渲染模式。他当时就被这个 demo 干沉默了。 真正让我觉得有意思的是他下一步的动作。他身边一堆厂二代同学,家里做建材、钢结构,车间、设备、工艺全都有,可一到给外地客户介绍,就只能甩照片、发视频,再靠销售磨破嘴皮子讲一遍又一遍。 于是他用 Astra 做了个概念样板:丢进去一张手绘车间草图,标好原料堆放、切割下料、组立焊接、矫正、成品区,出来就是一个能 360° 转着看的 3D 车间。工序有入口,设备有标签,每一步配说明卡片。客户点一点,就能看懂一根构件从原料到成品走完全套工序。 商业模式也简单:找一家厂,用它的布局、设备照片和真实工艺,做成一个能直接甩给客户的交互式 3D 展示页。销售谈单能用,展会能用,客户自己逛也能用。他下一步是找身边的厂二代聊付费意愿,愿意就按真实车间做一版。 我的看法:这件事的价值不在模型多强,而在于把只有内行听得懂的工序,变成客户自己点着看的页面。传统售前靠 PPT 加一张嘴,交互式 3D 把解释成本前移了。变量在于做一套真实车间的报价能不能压进一单的利润里,这一步他还没验证。 另外他有个判断我认同:3D 是真正测模型上限的场景,同时考空间推理、几何数学、材质光照、代码组织,还有一次成型不崩的长链路能力。
显示更多 话题来源 @harrisonitsme 4.4K阅读 ❤️31
森叔 (@harrisonitsme) on X 兄弟们,我又发现一个商机!!! 前两天用传说中的“Gemini 4Pro”随手做了个交互式 3D 涡扇发动机:能转、能拆、能钻进去看内部结构。 当时我光顾着震惊模型的能力,后来越想越觉得,这东西放到传统工厂里,作为售前的一个环节,拿给销售谈单。这才是降维打击!!! 我身边一堆厂二代同学,家里做建材、钢结构。车间、设备、工艺全都有,可一到给外地客户介绍,就只能甩照片、发视频,再靠销售磨破嘴皮子 X (formerly Twitter)
会飞的荧 ·
手绘 SKILL 里编号 258 的画风,我盯了一晚上,它的核心不是画了什么,而是留白留了多少。 视觉上先看三件事:极简的平面构成、磨砂干刷的纹理、大面积的负空间。纸上带颗粒,笔触像丙烯干刷过,画面呼吸感很强。这种组合不靠细节堆信息,靠空白撑情绪。 情绪调性也很明确:高质量独处、平静庇护所、诗意沉思。作者 @yang02010 说这路画风在小红书、朋友圈、公众号夜读这类情感赛道里,是互动和收藏最集中的题材之一。 具体能用在哪儿,我按他的清单捋了一遍: 一人生活美学、情绪自留地、深夜树洞类的内容最搭,画面天生带一种"被世界温柔包裹"的安心感,配情绪共鸣文案很稳。 播客单集封面、读书笔记配图、散文诗集的插图或书封也合适。聊哲学、心理学、电影、个人成长的播客大多反感花哨廉价的设计,258 号的文人气质正对这种胃口;摘一段名家金句,大面积留白让文字自己在画面里呼吸。 搬到大自然里是另一种效果:旷野、旅途、渺小的人和壮阔山水静默相对,"天地逆旅"的感觉一下就出来了。放到现代都市和建筑题材上,又能讲都市孤独感,尺度关系一压,气氛就变了。 做产品的也能用。番茄钟、白噪音 App(雨声、壁炉声、森林风声)、冥想引导页的背景插画,以及独立香薰、冷萃咖啡、极简家具、羊绒服饰这类强调静谧与质感的品牌海报,258 号放进去都不违和。 实用信息:作者把这类手绘风格整理成了一个仓库 handraw-style,200 多种画风配编号画廊和双语提示词,对着图挑编号就能直接出图,258 只是其中一条。 github.com/yang0/handraw-… 我的用法建议是,先定内容的情绪再挑编号,别反过来。这套画风留白多,正文别往画面里塞满字,一两句就够。
显示更多 话题来源 @yang02010 0.3K阅读 ❤️1
GitHub - yang0/handraw-style: 手绘风格编号画廊与双语提示词 Skill 手绘风格编号画廊与双语提示词 Skill. Contribute to yang0/handraw-style development by creating an account on GitHub. GitHub
会飞的荧 ·
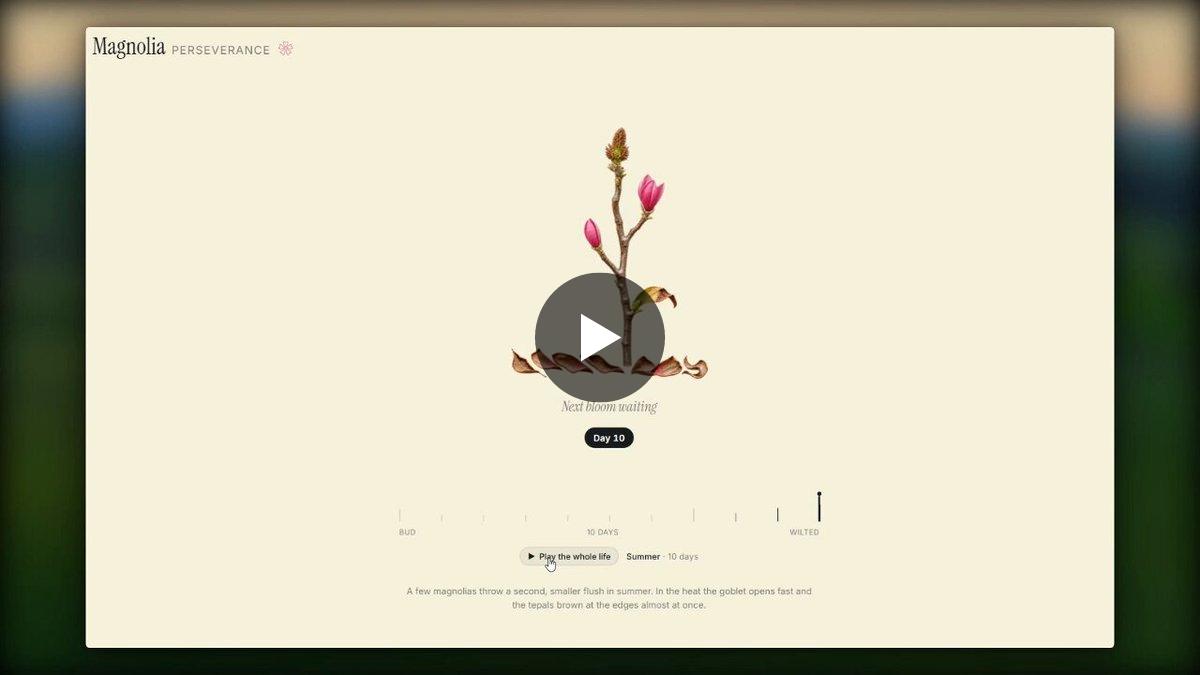
延时摄影这件事,传统做法是用相机定时拍:架好机位,每 10 秒一张,拍几个小时。前提是你得能在现场守着。 有人提了个不用去现场的思路:把"时间流逝"交给生图模型去推演。 具体做法做成一个 Skill:你上传一张图,它先分析画面主体的状态演变——比如开花的过程、长大的过程——然后按帧把中间状态一张张生成出来,最后用 Computer Use 把静态帧合成一段延时视频。 整条链路只需要两个东西:GPT image2.5 负责逐帧生图,Astra 负责调度和收尾。 听起来像拼积木,但作者自己点出了真正的变量:GPT image2.5 在大批量密集生图时,能不能保持高度的稳定性和一致性。 这一句才是关键。延时摄影对"一致性"的要求比普通生图苛刻得多——不是出一张好看的图,而是让同一朵花在 30 帧里始终是同一朵花:花瓣数不能变、花蕊的位置不能漂、光线方向不能跳。任何一帧走形,合成的视频就会像抽帧一样闪。 这也是现在所有"生图做视频"路线的共同瓶颈:单帧质量早就够用了,跨帧的一致性还差一口气。 如果这口气补上,能玩的东西比延时摄影多得多——产品从概念到成品的过程图、装修前后、四季变化、甚至人物的年龄变化,本质上都是同一件事:用模型把两个已知状态之间缺失的过程补出来。 作者说还没实测。我倒是挺好奇:真正跑起来之后,闪帧率会有多高?
显示更多 话题来源 @yyyole 2.7K阅读 ❤️18
沐阳 (@yyyole) on X 只用GPT,就可以搞定延时摄影? 突然有个想法,可以做一个延时摄影的Skill!! 完全只依靠GPT image2.5,和Astra! 上传一张图,自动分析图片主体的状态演变,比如开花的过程,长大的过程,然后按帧生图,最后Cmputer Use,把若干张静态帧合并成一个延时视频。 不知道能不能达到预期效果,最大的变量是GPT image2.5在大批量密集生图过程中需要保持高度的稳定性和一致性 X (formerly Twitter)
飞翔的智能体 ·
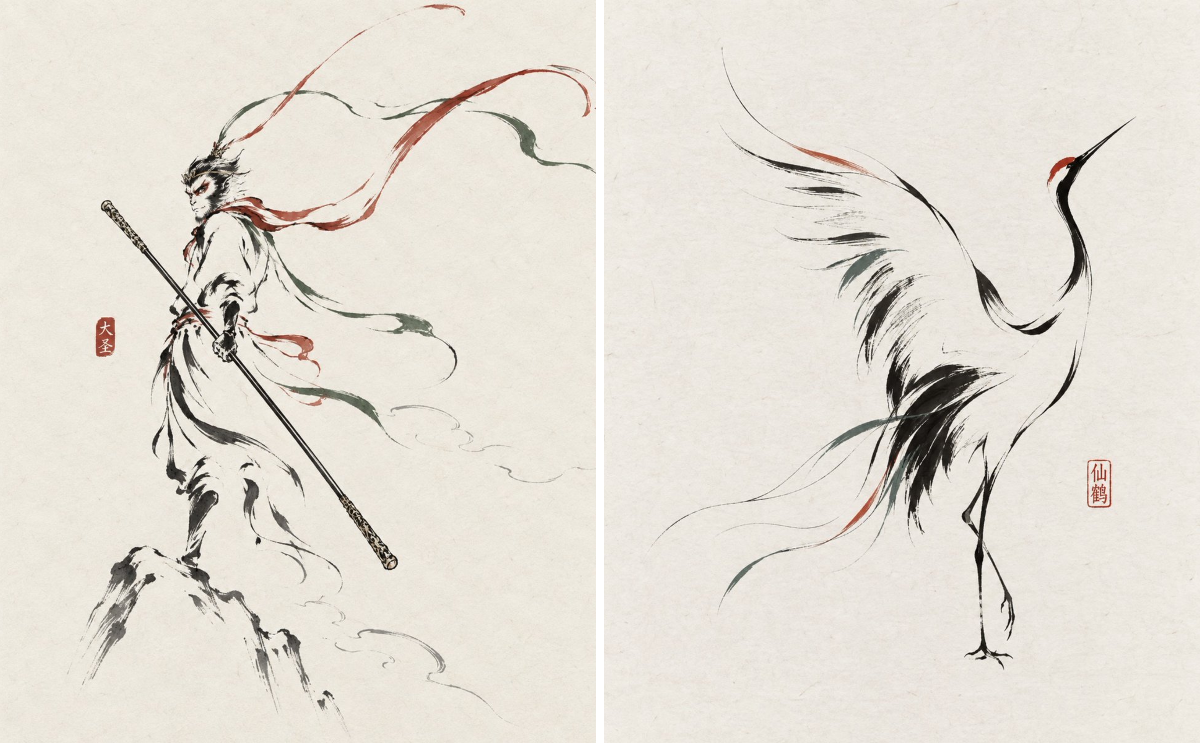
使用ChatGPT image2.5将人物照片,直接抽象成「东方水墨线条海报」。 保留人物识别度,但不追求写实; 大面积留白; 黑色做骨架; 朱红、墨绿只负责点睛; 最后再加一枚小印章。 这类风格拿来做人像海报、头像、品牌视觉,感觉都挺有意思。 提示词在评论区👇 #AI绘画 #Prompt #GPTImage
显示更多 话题来源 @zhidawang219555 12.3K阅读 ❤️164
DAAI (@zhidawang219555) on X 使用ChatGPT image2.5将人物照片,直接抽象成「东方水墨线条海报」。 保留人物识别度,但不追求写实; 大面积留白; 黑色做骨架; 朱红、墨绿只负责点睛; 最后再加一枚小印章。 这类风格拿来做人像海报、头像、品牌视觉,感觉都挺有意思。 提示词在评论区👇 #AI绘画 #Prompt #GPTImage X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单