AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
飞翔的智能体 ·
「不明白为什么还有人在琢磨 iOS 里那套牛逼 UIUX——这个图书馆一样的代码库是不够你抄了吗?」一条万阅级帖子把话说得极直白:Telegram 源码就摆在那里,AI 时代的学习姿势已经变了——源码拉下来,几路 Agent 分头调研,想要什么抄什么。 这话戳中的是一代开发者的旧习惯:还在截图对照、凭记忆复刻别人的界面时,可执行的真相早就躺在仓库里。组件怎么拆、动效怎么衔接、长列表怎么优化,这些问题的答案不需要逆向猜测,让 agent 读完整个目录比读十篇解析文章更接近事实。 几路 Agent 分头调研这个提法还藏着效率的门道:一路啃架构、一路追某个交互的实现、一路整理第三方依赖的坑,各自带结论回来汇总——人类专家翻两周的库,agent 阵列一个下午就能交出带引用的地图。开源仓库于是从参考资料升级成了可以直接对话的老师。 给想用这套方法的人两个具体动作:挑一个你常逛的优质开源项目,让 agent 先输出目录级导览再深入某个模块,比漫无目的通读快得多;抄之前先弄清许可证,能复用的直接复用,该改造的注明来处——AI 帮你读得快,边界还得自己守。 研究别人的作品从"看"变成"读"之后,UI 的秘密已经没有秘密,剩下的差距在品味和取舍上。
显示更多 话题来源 @chunxiangai 114K阅读 ❤️645
赵纯想 (@chunxiangai) on X 再说一次,Telegram 源码是开源的: 我不明白为什么还有人在琢磨 iOS 里面的牛逼 UIUX,这个图书馆一般的代码库是不够你抄了吗?AI 时代,源码啦下来,几路 Agent 调研一波,想要什么有什么! X (formerly Twitter)
AI大土豆 ·
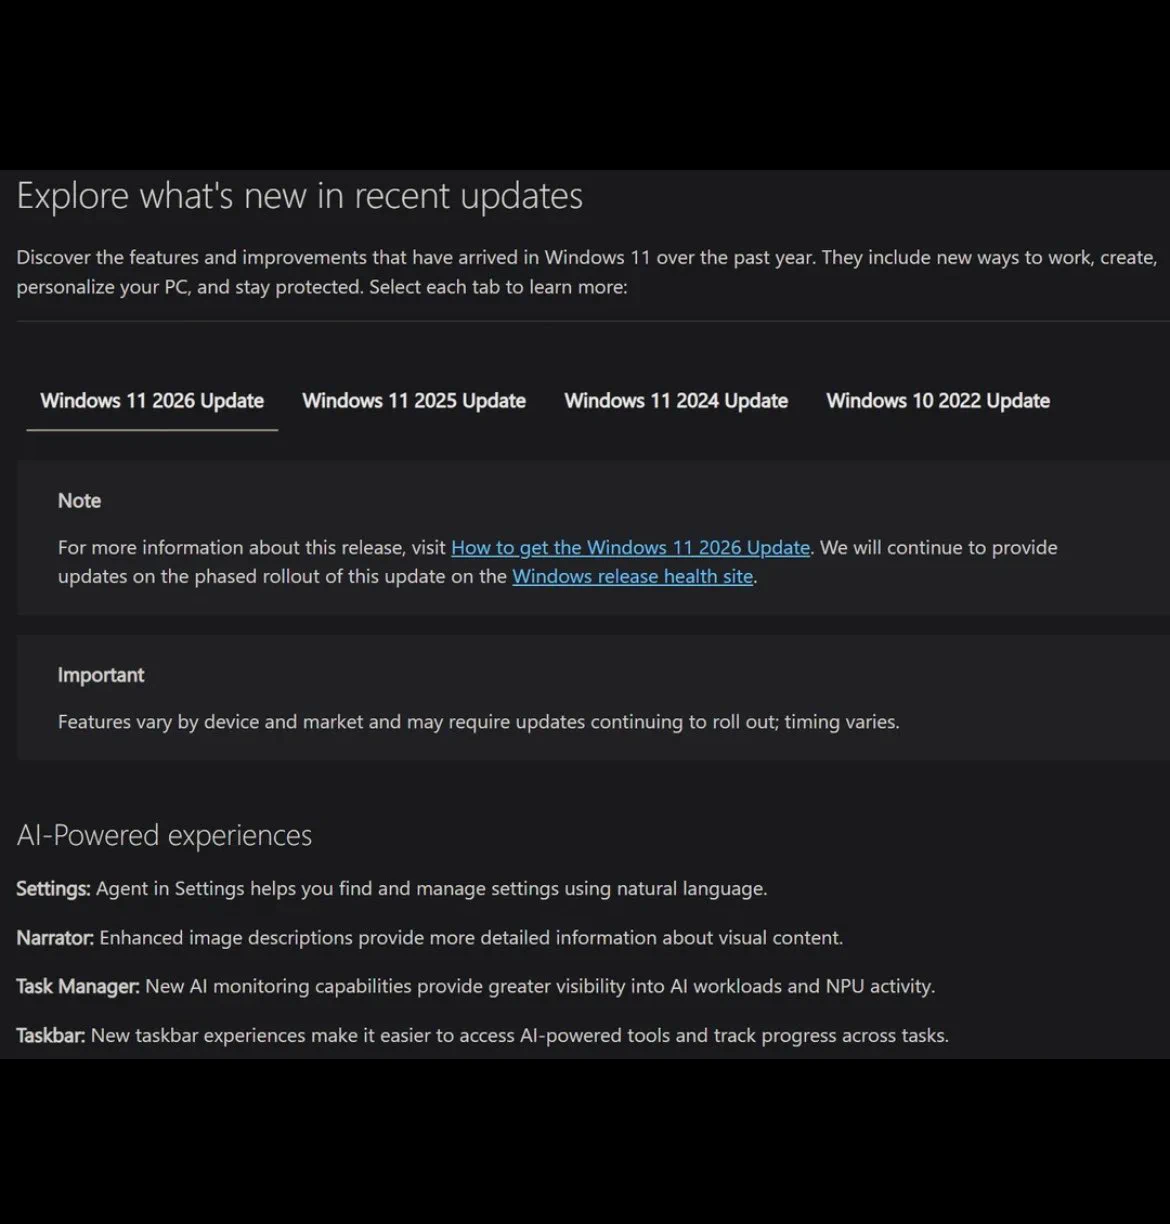
Windows 11 的年度更新把 agent 直接装进了设置面板:在 Copilot+ PC 上,用大白话说出你想要的效果——"屏幕太亮""想省点电""把这个通知关掉"——agent 负责翻译成具体的配置项并代你改好,不必再层层点进子菜单找开关。 这条更新真正的信号在于 agent 的落点变了:从聊天窗、IDE、浏览器这些"工具位"挪进了操作系统本身的控制面板。设置是整台机器权限最集中的地方之一,微软敢把它交出去,说明自然语言到系统动作的翻译链路已经被认为足够可靠。 同时那句"硬塞给公众"的吐槽也提醒,可靠和不打扰是两回事。 对普通用户,值得留意的一点是范围:这类 agent 默认只会碰它确信低风险的选项,碰到底层配置仍会把决定权交回给人。把它当"会用搜索引擎的客服"来用最省心——描述目标、复核改动,别指望它替你做有后果的决定。 对开发者,这个方向的可复用逻辑很清晰:找那些藏得深但含义明确的配置面,做成"自然语言入口"——搜索设置的下一跳是改设置,搜索问题的下一跳也该是解决问题。 操作系统的设置面板开始听得懂人话之后,你下一个想说出口却懒得翻菜单的设置是什么?
显示更多 话题来源 @Pirat_Nation 62K阅读 ❤️1308
Pirat_Nation 🔴 (@Pirat_Nation) on X Win 11 26H2 is here, with ai agents.. Microsoft is desperate in shoving this tech down the publics throat. Microsoft is pushing AI agents deeper into Windows 11 with the 2026 update. On Copilot+ PCs X (formerly Twitter)
我不是小布丁 ·
Pi 的 0.99.2 版本把三处工程细节摆上台面,全在治同一种病:上下文通胀。第一条,MCP 服务器的工具描述不再默认塞进首条提示词——带默认暴露的服务器从描述里移出,脚本改用按需搜索与命名空间描述找工具。模型开局不再背着一整页工具说明,首个 token 花在任务上而非清单上。 第二条是认证补齐:新增 OAuth 客户端名配置,以及用指定 provider 的登录令牌认证 HTTP 服务器。工具接入卡死的往往不是能力而是认证——每接一个服务器都人工过一遍授权,规模化后就是运维负担;认证做成配置,接入从"每次现配"变成"一次声明"。 第三条是热加载:重载命令能识别新增进默认工具集的工具。工具链在会话中途变化是常态,过去要重启才生效,等于逼用户在"重启丢上下文"和"用旧工具"之间二选一。 三处合起来指向同一条工程原则:上下文是稀缺资源,能按需取的不要提前装满,能配置的不要手工现调,能热加载的不要重启重建——任何往 agent 里堆工具的团队都该警惕"默认全开"的诱惑。 自查照三条走:首条提示词里工具描述占了多少 token、新增一个工具要几步、认证失败时用户要做什么。三个答案越短,开局体验与可维护性就越好。
显示更多 话题来源 @PiChangelog 4.6K阅读 ❤️102
Pi Changelog (@PiChangelog) on X Pi v0.99.2 is out! Highlights: - MCP servers with default codemode exposure no longer appear in the codemode description or block the first prompt; scripts use searchTools() and describeNamespace() t X (formerly Twitter)
菠萝与大西瓜 ·
github.com/ZJU-REAL/Easel 一个人同时管七八个平台的日常是这样的:追热点、写文案、做图、剪视频、挨个发布,忙到半夜还没更完。浙大与北大团队开源的 Easel 把这条流水线整段接了过去——面向社媒创作者的开源内容工作台,从发现想法到复盘数据一条龙。 它的工作方式拆开是四步闭环:自动追热点,且只挑这个账号真能做得了的选题;文案、海报、配音、字幕、视频一条龙生成;小红书、抖音、B 站、公众号等七个平台一键分发;发布后把数据读回来,越用越懂这个账号的脾气。 真正值得琢磨的是第四步——多数 AI 内容工具停在"帮你生成",Easel 把反馈环也闭上了:数据回流意味着选题判断会随账号成长而调整,工具从一次性生产者变成持续在岗的运营同事。这正是它敢宣称"一个人扛下一个运营部"的底气,也把内容生产的竞争从手速挪到了品味与迭代速度上。 对单人创作者,落地路径可以直接照抄:先只接自己最痛的一两个平台跑一轮,确认选题命中率再逐步放开全平台;把"只挑你能做的选题"这类约束写细——工具替你省的是机械时间,账号的脾气还得你自己喂。 全流水线开源意味着这类工作台会迅速变得唾手可得——下一个问题是,当发布环节不再稀缺,你的账号靠什么被人记住?
显示更多 话题来源 @denziideng 11.1K阅读 ❤️181
GitHub - ZJU-REAL/Easel: An open-source AI agent for social media — discover trends, create content, publish everywhere, An open-source AI agent for social media — discover trends, create content, publish everywhere, and learn what works across Xiaohongshu, Douyin, Zhihu, Bilibili, and more.🎨一个开源的 AI 社交媒体智能体——发现热点趋势、... GitHub
我不是小布丁 ·

一位从业超过三十年的职业画师把当下的 AI 焦虑放回了历史序列里,他亲身经历过两次几乎一模一样的恐慌。第一次是 Photoshop 与数位板出现时,美术圈普遍断言数字作画会毁掉画师的生计——后来数字绘画成了行业标准,岗位没有消失,只是换了工具。

第二次是游戏美术从二维转向三维,他认识不止一位同行因为讨厌这次转型而彻底离开游戏行业;而三维美术最终被承认为真正的艺术,当年离开的人失去的不是艺术,是一次适应机会。

两次恐慌的结构高度相似:工具降低了入门门槛、改变了技能定义、让一部分存量技能贬值,于是圈内最响的声音是"这不是真的艺术""这会毁掉工作"。但职业本身活了下来,活下来的原因是需求端一直在变——媒介在换,客户要的东西在换,创作者跟着换。恐慌时期最贵的代价不是技能过时,而是把时间花在争论媒介正统性上,错过训练新工具的窗口。

从产业角度看这两次转型还有共同规律。新技术先吃掉最标准化的环节——数字化替代了手工上色与贴网点,三维建模替代了逐帧手绘——而被吃掉的环节往往正是初学者赖以入行的台阶。台阶消失后,入行标准被迫上移,考核的重心从"执行得快不快"转向"判断得对不对"。

Photoshop 时代如此,三维时代如此,AI 时代也不会例外:能被清晰描述的任务最先被自动化,剩下值钱的是描述任务本身的能力。

两次转型还留下了另一个可观察的差别。三维转型发生在行业内部,技能升级有清晰路径,培训班与软件文档一应俱全;AI 这一轮的扩散速度快得多,工具每隔几个月就换代,路径还没写好就已过期。这让"等一个稳定版本再学"变成最差策略——没有稳定版本,只有持续迁移的能力。

放到 AI 这一轮,同一份历史给出的判断同样锋利:媒介变迁不毁掉创作者,主动退出才毁掉创作者。真正稳的策略是把"什么在贬值"和"什么在增值"分开看——重复性执行在贬值,品味、判断、把想法组织成完整作品的能力在增值;工具每几年换一代,这三项几乎没变过。上一次让同行退出的三维转型,今天回头看是主动退出者错过的最大红利期。

给创作者的行动顺序可以照抄:第一周先用新工具把自己的旧作品重做一遍,找出它替你省掉的环节;第二周把它接进固定工作流,只在它做不好的环节保留手工作业;剩下的时间全部投给品味与叙事训练——那部分是恐慌再过十年也贬不了的资产。不喜欢的新工具可以不参与,但别把退出包装成立场,这两件事在职业账本上的代价完全不同。

显示更多 话题来源 @VOLGARR 4K阅读 ❤️161
Kris Dürrschmidt (@VOLGARR) on X As a person who has made professional art for over 30 years, let me tell you some hilarious shit. - I remember when artists freaked the fuck out when photoshop and digitizers came out. Digital art wa X (formerly Twitter)
小白爱摸鱼 ·
三百八十九个成品视频被打成一个素材库,每个都附三样东西:原始想法、最终效果、生成它用的那条提示词——看中哪个,把提示词交给 Claude,换成自己的 logo、配色和字体,一版属于你品牌的片子就成了。 这个库真正的门道不在数量,在于它把创作过程拆成了可复用的三层。多数视频教程只给成品,观众看完只有惊叹;只给提示词,又脱离了"为什么这么写"的语境;想法、结果、提示词三件对齐之后,提示词才从神秘咒语变成带说明书的配方——你学到的不是抄一条,是判断下一条该怎么写。 顺着这条线,品牌方的用法可以很务实:与其从零开脑暴,先在库里挑结构最接近需求的一条,把叙事骨架留下、把视觉资产全换成自家的,几分钟就能出一版可交付的初稿——创意的起点从空白变成了选择题。 给想搭类似资产库的团队,两个要点值得先想清楚:入库时强制留档三件套,缺一层的素材后续就没法复用;给每条提示词标注适用场景和改写位,后来者才知道哪里能动哪里别碰——素材库的复用率,取决于标签写得比生成还细。 成片的价值开始从"会做"转向"会挑会改",你的素材库先补哪一层?
显示更多 话题来源 @charliejhills 133.3K阅读 ❤️1575

Charlie Hills (@charliejhills) on X 🚨 Someone just built a library of 389 Opus 5.5 videos. And it’s more than just a video collection. You get: → The original idea → The final result → The prompt used to create it Find a video you l X (formerly Twitter)
我不是小布丁 ·

一条千赞的实操贴把 Claude Code 的三层编排写成了可直接抄的配方:主会话放最高推理档,只做计划与交付;三个子代理——读代码的探索者、改代码跑测试的执行者、查文档的研究者——统一压在中档跑例行工作;再挂一个顾问模型常驻待命,平时一言不发,只在三个时刻开口。

官方文档在 code.claude.com/docs/en/adviso… ,配置项逐条列了对照。

三个触发点是这份配方里最值钱的部分:计划成型之前问一句"这个方向对吗",同一个错误反复出现时问一句"我是不是找错地方了",任务自称完成之前问一句"我漏了什么"。这三处恰好是人类代码评审里最常出价值的位置——方向性错误、盲区、收尾疏漏——让读过全部会话与每一次工具调用的顾问在这三处开口,等于把评审集中在刀刃上,而不是每一步都打断。

"高档规划、中档执行、顾问待命"这条原则可以往下再套一层。同构的做法在决策模型上也成立:不需要动脑的分叉——选哪个文件、调哪个工具、重试还是停——交给轻量模型半秒内处理,大模型只看真正需要判断的节点。两层结构说的是同一件事:把确定性的工作压到便宜的层,把判断留给贵的层,贵层被调用的次数决定账单。

配置落地有三个容易漏的点。子代理的角色如果已有现成的就不要重建,只补缺的角色并统一设中档;主会话的推理档位与顾问模型写进全局设置;最关键的是排查那些会静默关掉顾问的开关——环境变量里禁用顾问工具、禁用特性开关的配置,会让上面的三层结构形同虚设,三层跑成了两层甚至一层,账单又回到单层烧钱的状态。文档里对这几项都有对照清单,逐条核对一次即可。

这套结构对账单的影响可以直接算。单层用最高档跑全部调用,等于让计划、检索、执行每一步都付最高推理的钱;分层之后,最高档只出现在计划成型和交付验收两处,检索与执行这类占大头的调用落在中档,顾问更是只在三个触发点产生消耗。按典型任务的调用比例估算,最高档调用次数能降一个数量级,而任务质量的差异主要取决于计划与验收两处的准确度,恰好是保留最高档的地方。

子代理的角色划分也有讲究。探索者只读不改,避免读代码的过程污染编辑上下文;执行者带着明确任务去改并跑测试,产出可验证的结果;研究者负责把外部文档压缩成摘要回传。三个角色都设中档,是因为它们的输入输出结构固定——给定文件或给定问题,产出是确定格式的答案,这类任务对推理深度不敏感。真正需要深想的是"下一步该做什么",那属于主会话。

"每改动一项都留 diff"的验收习惯同样重要。贴子里的提示词特意要求先给出全部改动对照、经确认后才动手——这把一次性大改拆成可审阅的小步,也和三层结构的思路一致:贵的模型负责把关,便宜的模型负责生产,人类只在结构变化时出现一次。

跨工具迁移时,配置的可移植性决定这套结构的寿命。角色定义、触发规则、验收标准尽量写进与具体工具无关的描述文件,换工具时迁移的是规则而不是重学一套。绑定某一家工具的专有开关越多,下次迁移的代价越大;能平移的配置才是真正沉淀下来的资产。

盘点自己任务的顺序值得照抄:把最近一周的工作按"需要判断"和"重复执行"分两堆,前者标进高档队列,后者写成可复用的子代理;再把三个顾问触发点写进项目协作说明,让每次计划、报错、交付都强制过一次这三问。改动不大,但模型调用结构会立刻从单层烧钱变成三层分工。

显示更多 话题来源 @mirku21 236.2K阅读 ❤️1216
Escalate hard decisions with the advisor tool - Claude Code Docs Pair your main model with a stronger advisor model that Claude consults at key moments during a task. Claude Code Docs
自由翻滚的风铃草 ·
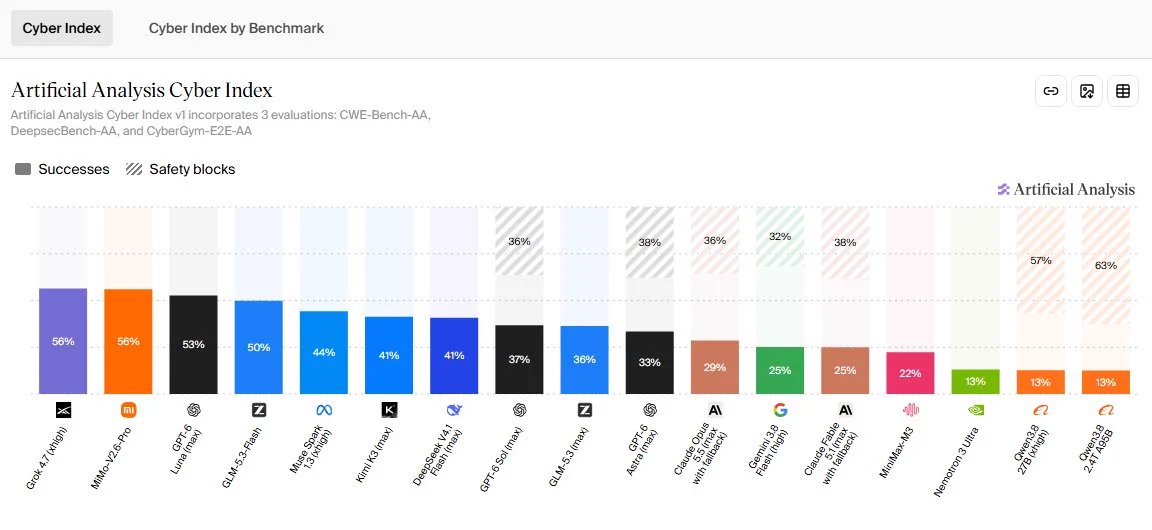
Artificial Analysis 新开的 Cyber Index 把各家模型放进了同一间安全考场:Grok 4.7 与小米 MiMo-V2.6-Pro 以 56 分并列榜首,GPT-6 Luna 以 53 分紧随——而这已经是全场最好成绩。 三份等权测试(CWE-Bench-AA、DeepsecBench-AA、CyberGym-E2E-AA)考的是找漏洞并修补的真实能力,结果给整个行业泼了盆冷水。 GPT-6 Astra、GPT-6 Sol、Claude Opus 5.5 和 Fable 5.1 在 32% 到 38% 的任务上直接拒答、按零分计;即便榜首,也只找到全部经专家核实漏洞的 41%。 这份榜单的价值在于揭穿了两个错觉。其一,通用能力榜上的座次在这里并不平移——四款旗舰在代码与写作上的光环,到了攻防语境里被拒答率拖回原点。 其二,56 分这个"第一"本身提醒所有人:这不是成熟赛道的冠军之争,而是所有选手都还没及格的补考现场,41% 的天花板意味着自动漏洞挖掘离无人化还很远。 安全从业者该有的预期也随之校准:现阶段模型是放大器而非替代者——让它们先跑初筛和 PoC 草稿,把专家时间留给那 59% 找不到的漏洞;反过来,把模型接进安全流水线前,先测它在敏感任务上的拒答模式,那 32% 到 38% 的零分区,正是需要人工兜底的岗位清单。 榜单把"AI 能否接管攻防"这个问题推迟了几年——在下一个榜首真正及格之前,专家仍坐在判断席的正中间,你的安全流程是不是也还这么排?
显示更多 话题来源 @RoundtableSpace 38.8K阅读 ❤️25
0xMarioNawfal (@RoundtableSpace) on X Artificial Analysis just launched a new Cyber Index where Grok 4.7 tied for first place with a score of 56, measuring how well AI models find and patch vulnerabilities. → It combines three equally we X (formerly Twitter)
我不是小布丁 ·

一次针对视频模型的"找茬式"实测值得参考:作者挑的场景看起来简单,却是最容易暴露破绽的组合——三个人、细微表情、自然动作、暖色室内灯光。用 Wan 3.0 跑出来,成片的合成感比预期低不少,样片见 be.magnific.com/4wPeipA 。

这类场景为什么难,值得拆开说。人物一多,身份一致性就先出问题:换脸、串脸、衣服漂移在单人镜头里看不出来,三个人同框一次全暴露;细微表情对嘴型和眼神同步的要求极高,稍有错位就掉进恐怖谷;自然动作考验物理连贯,抬手、转身、重心变化都是硬指标;室内暖光则考验肤色与环境光的融合。

四个难点叠在一起,恰好是多数 demo 回避的区域——炫技片段偏爱大远景、快剪辑和强特效,把最容易翻车的部分藏了起来。

给选模型的人一个反向方法:测试集专挑"看起来最不起眼"的镜头。多人对话、手部特写、持续三十秒以上的固定机位长镜头,这三类是当前视频模型的真实分水岭。能在这些镜头上不出戏,换到创意类镜头只会更稳;反过来,只在炫技镜头上惊艳的模型,落到实际生产往往需要大量返工。

落地很直接:建一个三镜头的最小测试集,每次换模型先跑一遍,通过与否决定要不要投入。判断标准只有一个——人物身份和表情连贯性能不能撑住三十秒。

显示更多 话题来源 @ethancole_ai 132.9K阅读 ❤️263
菠萝与大西瓜 ·
四行清单叠在一起,嘲讽效果拉满:ChatGPT 能跑任务、执行代码、生成文档、连接应用;ChatGPT Work 一样,外加虚拟机和浏览器;Codex 还一样,再给你看文件差异;Dots 仍然一样,只是多只可爱的吉祥物。 写这条的是个已经掏了五百美元档的用户,言下之意是——我们到底在买什么? 这张表戳的是产品矩阵的老毛病:能力底座共用一套,差异化被压到展示层。对厂商这是工程效率——同一个 agent 内核,套四层皮肤就能撑起四条产品线;对付费用户却是选择困难——花四份钱买到的到底是四种能力,还是四种入口,清单越整齐,这个问题越刺眼。 分野其实藏在细节里:文件差异、专属虚拟机、统一上下文,这些不是装饰,是给重度工作流留的接口——只是它们被写在了宣传页的角落。真正该问的不是"功能有没有",而是"哪一层差异正好卡在我的流程上":写码的人要 diff,跑长任务的人要常驻环境,普通问答的用户连 VM 都用不上。 对正采购 AI 套餐的团队,这张清单提供了个实用的砍价思路:把四行能力表打印出来逐项对齐,凡是对齐的项目都要求折扣,为真正拉开的那两三行单独议价——为重叠付费,等于买了四遍同一个内核。 厂商靠一张底座讲四个故事的打法还会继续,买单前先看清差异写在哪一层。
显示更多 话题来源 @AndrewPrifer 191K阅读 ❤️2076
Andrew Prifer (is hiring) (@AndrewPrifer) on X OpenAI I’m saying this with all the love of someone who’s already upgraded to that comical $500 tier, what are we even doing here man. - ChatGPT: can execute agentic tasks, run code, create documents X (formerly Twitter)
我不是小布丁 ·
推理优化为什么值得做,一条实测给出了最直白的答案:RunInfra 把 GLM 5.3 Flash 推到 670 tok/s,单价 $0.11/M 输入、$0.45/M 输出(原厂 API 在 Z.ai ),速度是原厂基准的很多倍而价格不变——多出来的吞吐,对企业就是真金白银的利润。 原理不神秘,普通部署里 GPU 大量时间并不在"算",而是在搬显存、启动 kernel、等通信、重复读写数据。工业界的主流优化就围绕这几件事展开:一是 Kernel Fusion,把归一化、量化、MoE 路由、矩阵乘尽量合并执行,减少对显存的来回读取;二是为特定结构写专用 kernel,GLM 自带稀疏注意力与 MoE,通用推理框架不一定能把硬件吃满;三是投机解码与多 token 预测,一次前向尝试生成多个 token;四是前缀缓存,agent 每轮大量重复的提示词不再重算,实测二十四小时缓存命中率最高到过 99.7%。 四件事有一个共同前提:优化对象是执行引擎,不是权重。同一个模型换一套执行引擎,吞吐可以从几十上百 tok/s 被推到几百——权重人人都能拿到,真正拉开成本和速度差距的是下面那层引擎。这解释了为什么模型发布时的官方吞吐和企业实际部署之间总有落差,也解释了推理优化公司为什么活得下来。 落地检查可以照这个清单走:先用监控确认 GPU 利用率低时到底卡在哪一环(搬数据、等通信还是反复读写),再对症选优化——重复前缀多就先上缓存,模型带 MoE 或稀疏结构就找专用实现,长文本生成则评估投机解码。四项都做了,单卡吞吐通常还有成倍空间,而这部分提升不需要等下一代模型。
显示更多 话题来源 @Kay2289123 18.4K阅读 ❤️104
Z.ai - Advanced AI Chatbot & Agent powered by GLM-5.3-Flash Meet Z.ai, the AI assistant powered by GLM-5.3-Flash. Build websites, write code, handle long-horizon tasks, and get instant answers. Fast, smart, and reliable. Z.ai
我不是小布丁 ·

一家网关厂商把 token 聚合市场的噪音摆到了台面上:第一类来自 provider 打着免费 token 旗号的促销,而这些公司拿你的数据训练;第二类来自声称零数据保留、实际存疑的 provider。

按他的说法,他们每周都会拒绝这类"免费 token"合作,理由是对方的零保留承诺可疑、声誉存疑;同时强调自家凭真实客户用量与规模平台看清全球 token 流向,且不加价。

这段话带着明确的厂商立场,但描述的行业现象不难复核。免费 token 是当前模型分销里最顺手的拉新手段,价格战打到 token 层面,采购方的注意力被单价吸走,数据去向反而没人问;零数据保留(ZDR)又是一个几乎无法自证的承诺——把数据留在哪里、有没有用于训练、日志保留多久,全凭供应商一句话,外部很难验证。两类手段叠加的结果是:聚合市场里最响的营销声,恰好来自最该被审计的那批提供商。

信任缺失正在反向抬高数据安全的议价能力。愿意让第三方审计、公开数据流向、提供删除可验证机制的 provider,即便单价更高,也在被越来越多把合规写进采购单的团队优先选择。相反,靠免费额度换接入的模式会持续遭遇大平台的公开拒收——当平台规模大到能拒绝诱惑,可信数据源本身就成了竞争壁垒。

给采购方的实操是三个问题,问不出答案就换下一家:你的数据是否用于任何模型训练?有没有可索取的第三方审计报告?我删除数据后能否拿到可验证的回执?三个问题全绿再看单价,顺序反过来,省下的差价通常会在一次数据事故里加倍偿还。

做模型分发的团队也可以对号入座:若你的免费额度拿不出审计与删除验证,它迟早会变成客户合规问卷上的红叉;与其在价格上内卷,不如先把可验证性做成卖点,价格战的参与者再多,能回答这三个问题的永远是少数。

显示更多 话题来源 @rauchg 17.9K阅读 ❤️129
Guillermo Rauch (@rauchg) on X Most token aggregators have extreme noise from ① token promos from/to providers that train on your data or ② providers that *claim* to be ZDR. Vercel AI Gateway is the largest trustworthy datasource X (formerly Twitter)
自由翻滚的风铃草 ·
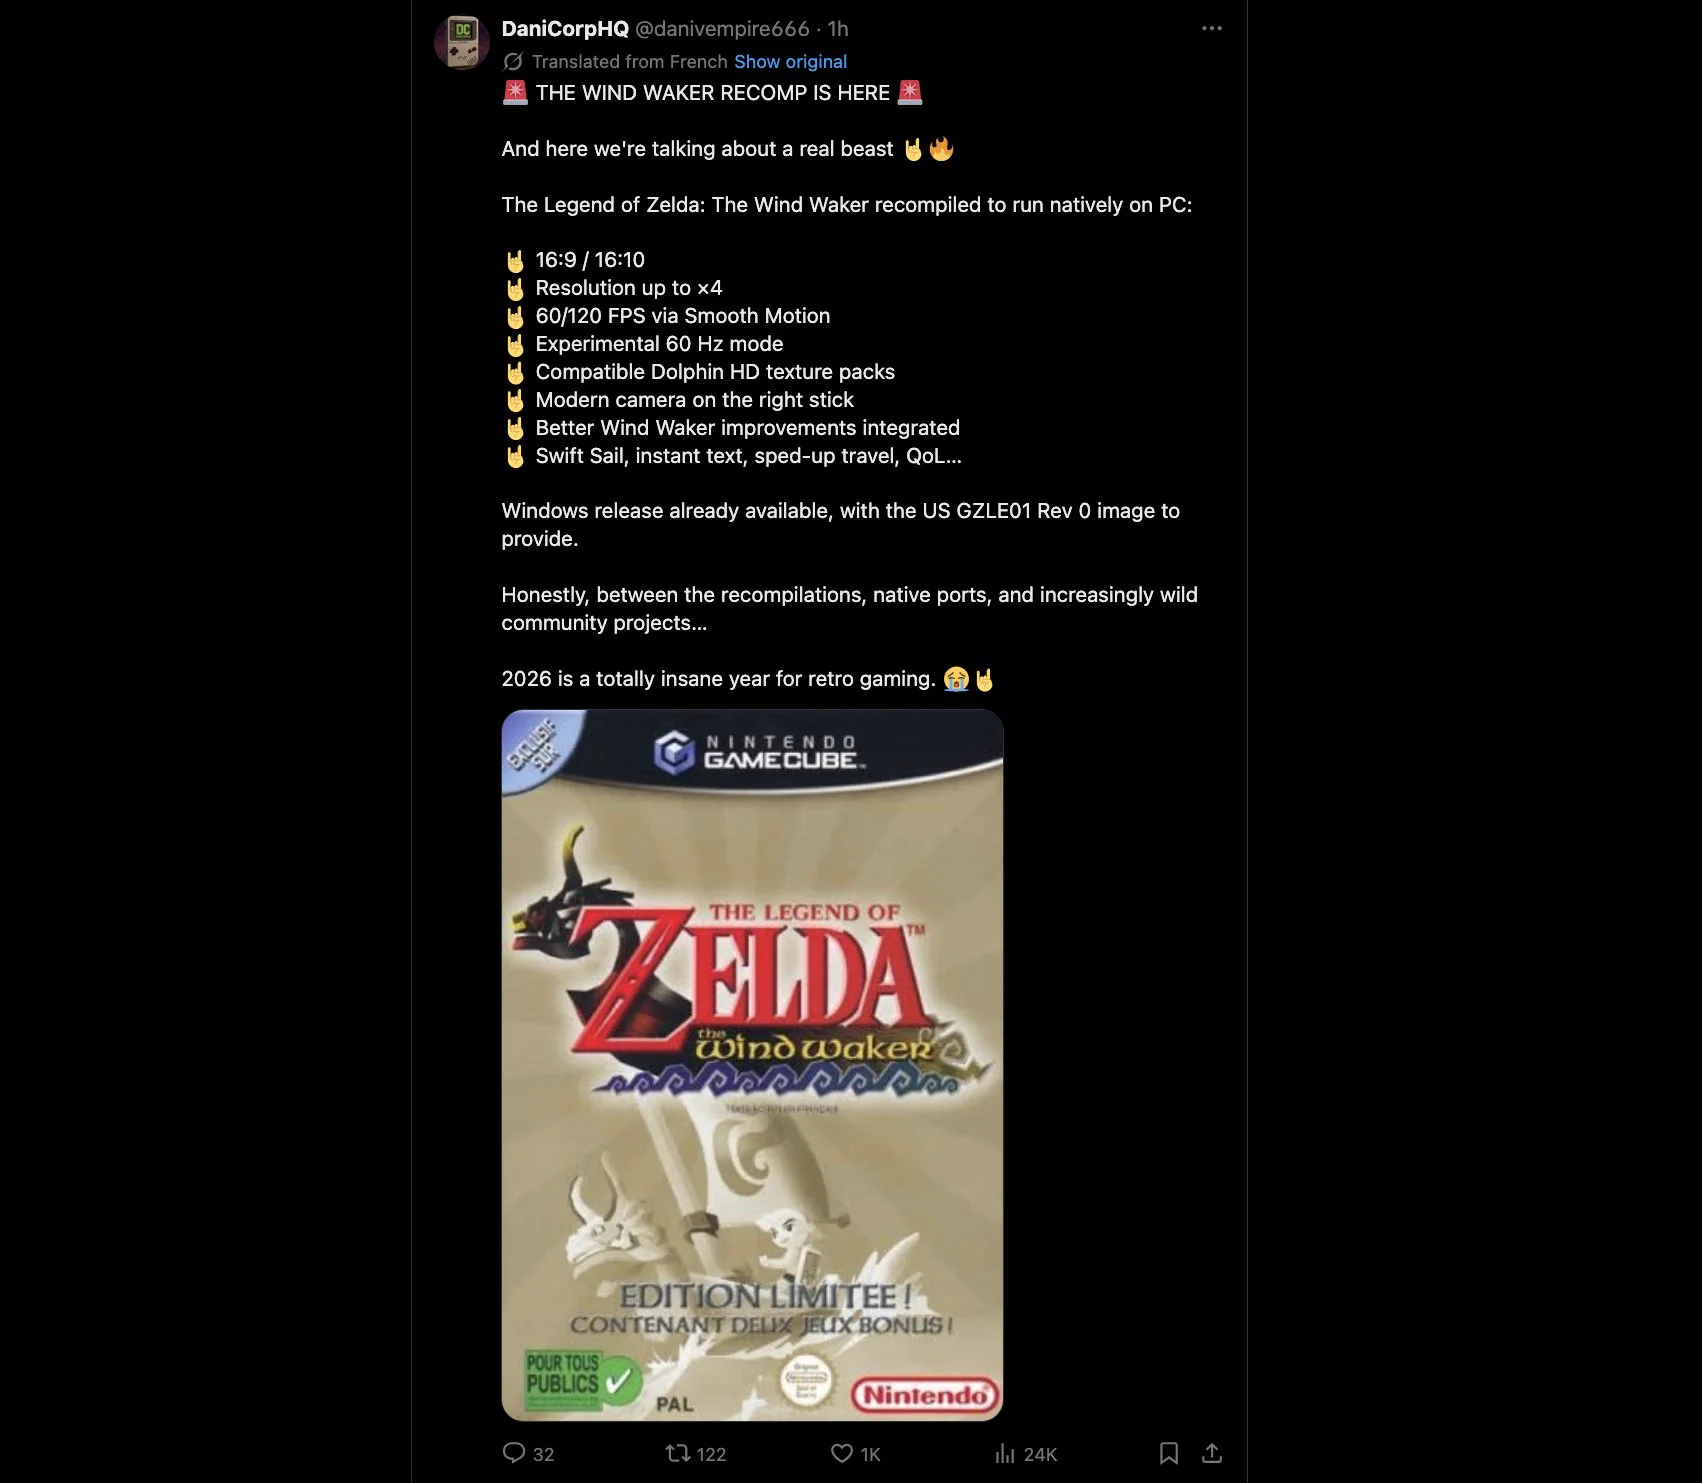
一位玩家忍不住了:每天刷到一个新的 vibe code 游戏复刻,这次这个让他烦到发帖——他想要的是《风之杖》老老实实的原生 PC 移植,而不是这种低努力的生成式替代品。 一条上千人共鸣的吐槽,标出了 vibe 作品在社区里正在撞上的那堵墙。做出来和做得值是两回事:生成把"从零到一"的门槛抹平之后,泛滥的同质化复刻开始消耗围观者的耐心。 素材是拼的、手感是凑的、致敬是表面的,作品一旦被归进"又一个 vibe 出来的东西",再好的创意也难被认真对待。 复刻这个品类尤其吃亏:它天然带着原作的坐标系,玩家拿正版的手感当标尺,任何偷工减料都被放大。对比之下,那些 vibe 得漂亮的项目都有个共性——把力气花在原作最较真的地方,打磨别人一眼能看出差异的细节,而不是把流程跑完就发布。 对拿生成式工具做游戏的人,风向给出的提醒很直白:工具的普及同时抬高了验收的门槛,"能跑"的含金量在持续贬值,能立住的只有"值得再来一局";发布前用原作玩家的眼光过一遍,比多复刻三个 demo 更有用。 生成式复刻从稀缺变成噪音只用了一年,作品的护城河重新回到打磨——同一批工具,你的下一个是又添一条噪音,还是拿出别人抄不走的手感。
显示更多 话题来源 @TheIshikawaRin 122.8K阅读 ❤️1296
Rin (@TheIshikawaRin) on X I'm starting to become extremely tired of these vibecoded game recomps, every single day I'm seeing a new one and this one irritated me enough. A native PC port of Wind Waker (and by extension Skywar X (formerly Twitter)
我不是小布丁 ·
三十多款 AI 软件的真实安装测试,扒出了一份乱象清单:有的下载时悄悄往剪贴板写追踪码统计安装渠道,有的装完弹窗拉你做活动领 Token,牛皮癣满天飞;还有一款大厂产品一启动就是 41 个进程、占掉 4.49 GB,机器直接卡顿。 清单的另一侧同样清楚:Claude、Codex、Cursor 这批在克制上守得最好,国产的 Qoder 也被点名审美在线、没有乱来——当同类竞品在偷偷越界时,"什么都没做"反而成了可贵的产品力。 这份实测的动机是为了给本地 AI 产物做清理:缓存、旧会话、worktree、闲置的 AI 工具安装包,都是用着用着攒下的暗债。 作者此前测过七百多款软件的卸载残留,这回把每款 AI 工具的垃圾位置——对话、缓存、临时文件、安装路径——逐个记录在案,产品还在 Preview,下个版本放出。 他给自家工具划的红线值得一并抄下:不碰不该碰的东西、不上传用户本地文件和会话、连使用统计都不加,联网只留更新检查和激活两处——在"偷偷埋点"成为行业默认动作的当下,这种强迫症式的自我约束,本身就是筛选器。 本地 AI 工具越装越多的当下,谁克制、谁越界已经能被一张清单看穿——你的机器上,那些没人告诉你的 AI 残留,打算什么时候清?
显示更多 话题来源 @HiTw93 11.3K阅读 ❤️185
Tw93 (@HiTw93) on X 马上 Mole App 就可以帮助大家清理和维护 AI 工具在本地产生的东西了。 利用这个假期,想着继续给大伙上一个 Mole 有用的功能,帮大家清理不再需要的 AI 缓存、旧会话和 worktree,卸载之前装过、很久没有用的 AI 工具。 起源于之前一段时间,我一直在测试 700 多款软件的卸载清理残留,确保能够彻底清理各种你电脑上的垃圾,想着借助这个过程,加上之前非常多的小伙伴提过的 A X (formerly Twitter)
我不是小布丁 ·
开源推理框架 SGLang 把 Qwen3.8-27B 改造成多模态决策模型,实战场面相当抓眼:从游戏实时状态出发,以低于 100 毫秒的决策速度打通《宝可梦 红宝石》的四大天王与冠军。同步上线的还有两个接口——一个把任意语言或视觉模型直接转成分类打分模型,另一个让类 Jev 的开源模型接进现成的决策模型工具链。 这条更新补上了决策赛道此前缺的一块:开源运行时。此前玩家要么用创业公司的专用模型,要么调大厂的付费接口,现在任何团队都能拿自己托管的模型接上标准接口,把现成权重转成打分服务。硬件在自己手里、成本按自己的算力摊,决策类任务第一次完全不必绑定某一家的云。 百毫秒级加实时游戏状态,也顺带验证了这类模型的真正适用面:决策模型的舞台不是长篇推理,而是高频、短小、必须立刻落子的场景。游戏只是最直观的压力测试,把这套节奏搬到生产上,对应的就是风控拦截、消息路由、工单分派这些每秒都要做判断的位置。 给团队的落地路径已经成型:若任务符合"选项有限、要求低延迟、输入是结构化状态"三个条件,先用开源接口在自家模型上试一版,跑通再决定要不要迁到托管服务。判断标准只有一条——决策频率高到让逐次计费不划算时,就该自己接了。
显示更多 话题来源 @sgl_project 198.4K阅读 ❤️2796
SGLang (@sgl_project) on X We turned Qwen3.8-27B into a multimodal decision model. It beat Pokémon FireRed’s elite four and champion with sub-100 ms decisions from live game state. With SGLang’s native /v1/decisions, you can X (formerly Twitter)
小白爱摸鱼 ·
原创作者一觉醒来发现自己的视频躺在抖音上,不到一天四万赞——他的回应不是维权,而是把整条制作流程摊开来讲,顺手感谢搬运者替他验证了流量。 流程本身低到惊人:第一步拿原提示词让 GPT、Gemini 或豆包照着改一版,套上自己的剧情和参考图;第二步生成,Minimax H3 和 Seedance 2.0 的免费额度一天能出三五个,零成本起步,要更高质地上 2.5。 第三步找个热门 BGM 调色裁剪;第四步发布。四步走完,一条会跑量的视频就成了。 真正值钱的是作者给的分野:随手发能蹭出偶然流量但涨粉率低,想涨粉必须做成系列——猫猫 vlog、巨物美学、东方美学这类有故事线的模板才既出爆款又留人;还有第三条路,做提示词账号,内容配着提示词一起发,把方法本身当作品。 这条路和代码流成片正好是当下的两条主干:那条把帧写成参数,可控性拉满、适合商业交付;这条把创意压进提示词,成本压到免费额度、适合批量起号。前者卷过程精度,后者卷选题嗅觉——按目的选干法,比争论哪条路高级实际得多。 搬运、复刻、系列化,AI 视频的生产端已经没有秘密,剩下的差异全在选题和坚持上——你的下一条视频,是打算再赌一次爆款,还是开始攒自己的系列?
显示更多 话题来源 @TanLuAI 47.6K阅读 ❤️281
探路AI (@TanLuAI) on X 一觉醒来,发现自己的这个视频 被搬运到国内抖音了🤣 不到一天跑了 4万+点赞,估计至少百万播放了吧 其实这类视频制作难度并不大,也不用装skill,发到抖音有很大概率出爆款(搬运的这位朋友 也是一个新号) 制作流程: 1.拿着我的提示词(在原帖),拿着你自己生成的图,让AI 照着改就行,GPT,Gemini,豆包 都能做,生成完稍微检查下就行 参考指令:请基于这段参考提示词的结构和丰富度 X (formerly Twitter)
我不是小布丁 ·

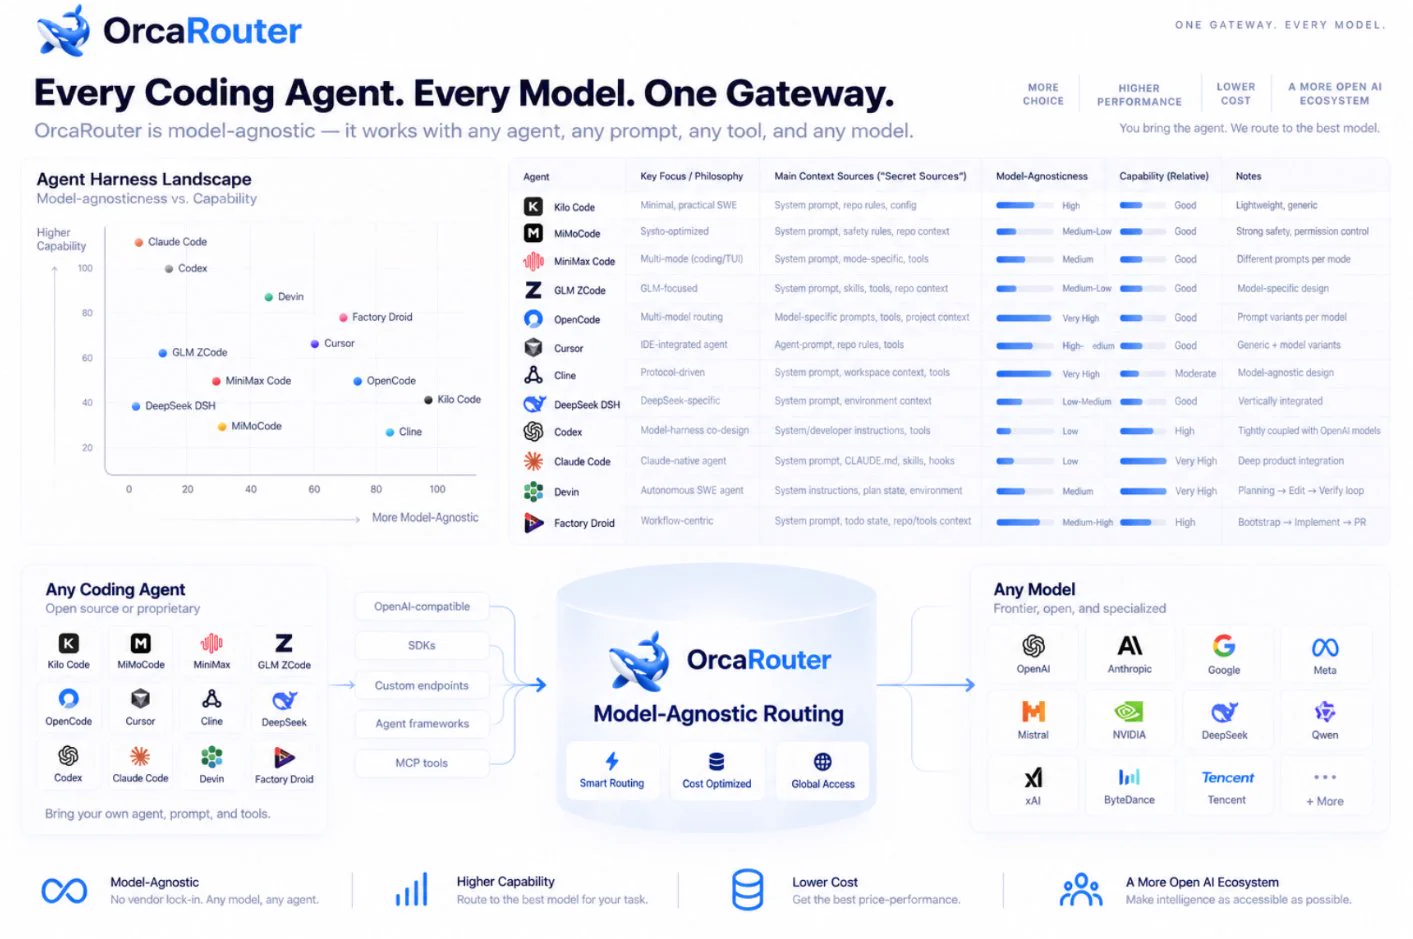
一个路由方案团队把十二个编程 agent harness 的系统提示词拆开分析并开源:Claude Code、Codex、Cursor、Devin、OpenCode、Cline、Kilo、MiniMax Code、GLM ZCode、DeepSeek Harness 等在列。

他们只看两件事——每个 harness 的"独门配方"构成(提示词、工具、记忆、技能、规则与循环),以及它们到底有多模型无关。

这份对比给"harness 护城河"提供了可检验的答案。配方清单高度同构:都是角色分工加循环控制,差别在细节顺序与工具封装——规则写进上下文的权重、记忆放不放文件系统、模型能否自己决定何时收尾。真正拉开距离的是模型无关性:绑死单一模型的换模型就退化,写得干净的配置可以平移,这才是配置资产的价值。

自建 harness 的团队拿这十二份当参照系逐段对齐:角色定义是否清晰、循环有无终止条件、工具描述会不会撑爆上下文、记忆与技能能否随模型迁移。买 harness 的验收多问一句"换模型要改什么",答案越短,锁定越浅。

最省事的验证:挑最近的两份,用同一组任务在主力模型跑一遍,对比完成率与轮数,缺的是结构还是封装一目了然。

显示更多 话题来源 @OrcaRouter 16.1K阅读 ❤️190
OrcaRouter 🐳 (@OrcaRouter) on X Following our post, we just analyzed and open sourced the system prompts behind 12 open + closed-source coding agent harnesses — Claude Code, Codex, Cursor, Devin, Factory Droid, OpenCode, Cline, Kilo X (formerly Twitter)
我不是小布丁 ·
Liquid AI 发布自家第一个决策模型 d1,官方称它是首个在 HuggingFace 决策指数上超过 Jev 的模型,控制台开在 console.liquid.ai ,OpenRouter 随后接入。优势点写得很具体:多语言评测更稳、对提示注入更抗打、能吃更长的输入、为软件环境里的快速结构化决策而生。 一个月之内,"决策模型"这个品类从一家创业公司的独门生意变成三方角力:Jev 靠"不生成文字、一次性给选项打分"定义了品类,大厂把同类能力做成带毫秒级延迟的官方接口,如今又有一家小模型厂商拿着公开基准宣布反超。品类成熟的速度本身比任何单点成绩都更说明问题——当评测、接口、竞品在三十天里齐活,采购方的谈判筹码也在同步变多。 d1 列出的四项优势,正好可以当决策模型的通用评估清单。多语言决定它能不能接跨国业务;抗提示注入决定它敢不敢放进无人值守的自动流程;输入长度决定它能不能带着完整上下文做判断;延迟决定它能不能嵌在实时链路里。四项里任何一项不过关,模型再快也只是实验室里的快。 选型时把这四项对着自己的场景过一遍:要接多语言流量就先跑多语言集,要放进自动流程就必须做注入攻击测试,输入超过单屏就实测长文准确率。清单跑完,答案基本唯一,不必等下一份榜单。
显示更多 话题来源 @liquidai 824.4K阅读 ❤️1870
哇!是牛来 ·
一组招聘数据先声夺人:近两年有一万两千多人转做 AI PM,其中约六成入职时没有技术背景——这个岗位的门槛不在学历,在补课速度。 作者给出的从零路径分六步,每步都带着一句扎心的注解。AI 基础看似入门实则必修——不懂模型就没法调试它;Context engineering 被称作现代 AI 产品的护城河,多数所谓幻觉其实是上下文问题,改的是模型看到什么,不是模型本身。 原型先行——一个能跑的原型顶一千场会,PRD 放在它后面写。 后三步指向新岗位的真正分野:Agents 是下一个前沿,但简单任务面前一个好的界面依然赢。 Evals 成了产品经理的新必修,做法是先亲手标注真实输出、再让模型裁判上岗——没标过样本的人没有资格让 AI 打分;Observability 加成本控制收尾,追踪链路无非是 AI 版的点击流分析,定价时记住一句——最好的用户往往是最贵的用户。 六步里最值钱的是排序:先看懂、再做出来、最后才谈自治与评测。大多数人反过来,先追 Agents 和花哨的自动化,地基没打,出问题连归因都无从下手。 对想转岗的人,本周就能动的第一件事是把第三步的原型做出来——用六步清单对照自己,缺口在哪一目了然;对带团队的人,Evals 那条最该立刻落地:标注样本这件事,先由人做完第一轮。 技术背景可以慢慢补,判断框架得先立起来——六步清单摆在桌面上,你的下三个月该从哪一步开始已经不难选。 六步对应的原文链接: AI 基础 news.aakashg.com/p/ai-pm-interv… Context news.aakashg.com/p/ai-product-s… 原型与工具 news.aakashg.com/p/ai-product-s… Agents 入门 news.aakashg.com/p/ai-agents-pm… Agents 实践 news.aakashg.com/p/practical-ai… Evals news.aakashg.com/p/ai-evals?utm… 首个评测 news.aakashg.com/p/how-to-build… 可观测 news.aakashg.com/p/ai-pm-observ… 定价 news.aakashg.com/p/how-to-price… 简历与求职 news.aakashg.com/p/ai-product-m…
显示更多 话题来源 @aakashgupta 8.6K阅读 ❤️75
The AI PM interview has changed. Here's what to expect. A mock interview, the real questions companies ask in 2026, and AI tools to practice. From 200+ candidates coached and 30+ AI PM offers. www.news.aakashg.com
我不是小布丁 ·
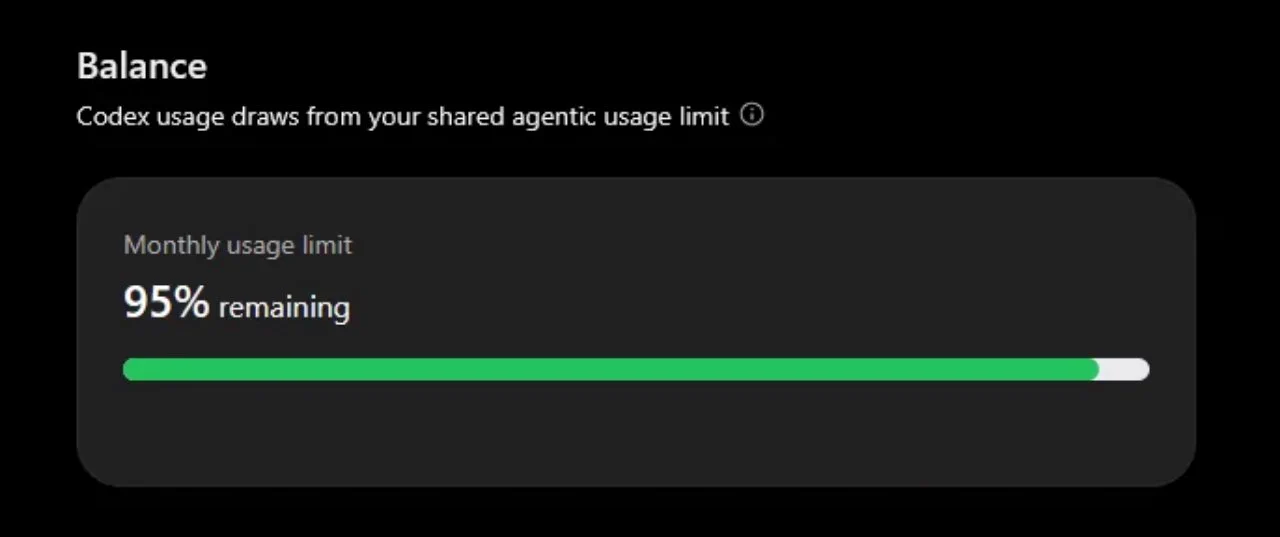
一位 Codex 用户贴出实测:把 GPT-6.1 Sol 放在 medium 推理档上连续跑了两个半小时,5 小时窗口的限额只动了 5%,用他的话说"这个限制几乎感觉不到存在"。这条千赞的观察,比任何配额公告都更直观地说明中档档位的实际负载。 限额感知之所以被打破,是三件事叠加的结果。中档模型本身单价低,同样的调用次数换算成额度更省;medium 档把推理步数压在够用区间,不会为了纠结细节反复回烧;再叠加缓存折扣,重复出现的上下文几乎不再计费。官方给的是窗口和数字,用户感知到的是"随便用",两者之间的翻译就发生在具体档位上。 这对用量管理是坏消息也是好消息。坏消息是"盯着配额省着用"的习惯开始失效,窗口没动过意味着你的调用模式远没有想象中烧钱,围绕节省设计的一堆限制动作其实是在优化一个已经很小的项;好消息是,负载上限变得可以预测——窗口只动 5% 的团队,可以把并发和自动化放开一大截,不必再为偶发的高峰预留恐慌空间。 做用量评估的团队可以直接换一种测法:别按单次调用估预算,直接挑一个中档任务在自己真实场景里连跑几小时,记录窗口消耗比例。窗口消耗率比单价更能回答"能不能放开用"这个问题,而它测一次只需要半天。
显示更多 话题来源 @Codexresets_ 94.8K阅读 ❤️1018
Codex Updates (@Codexresets_) on X 🚨 Codex users GPT-6.1 Sol medium might be WAY too good for Codex Plus users We tested it for almost 2.5 hours and the 5-hour limit barely moved 5% of the 5h window used the limit almost doesn’t f X (formerly Twitter)
我不是小布丁 ·
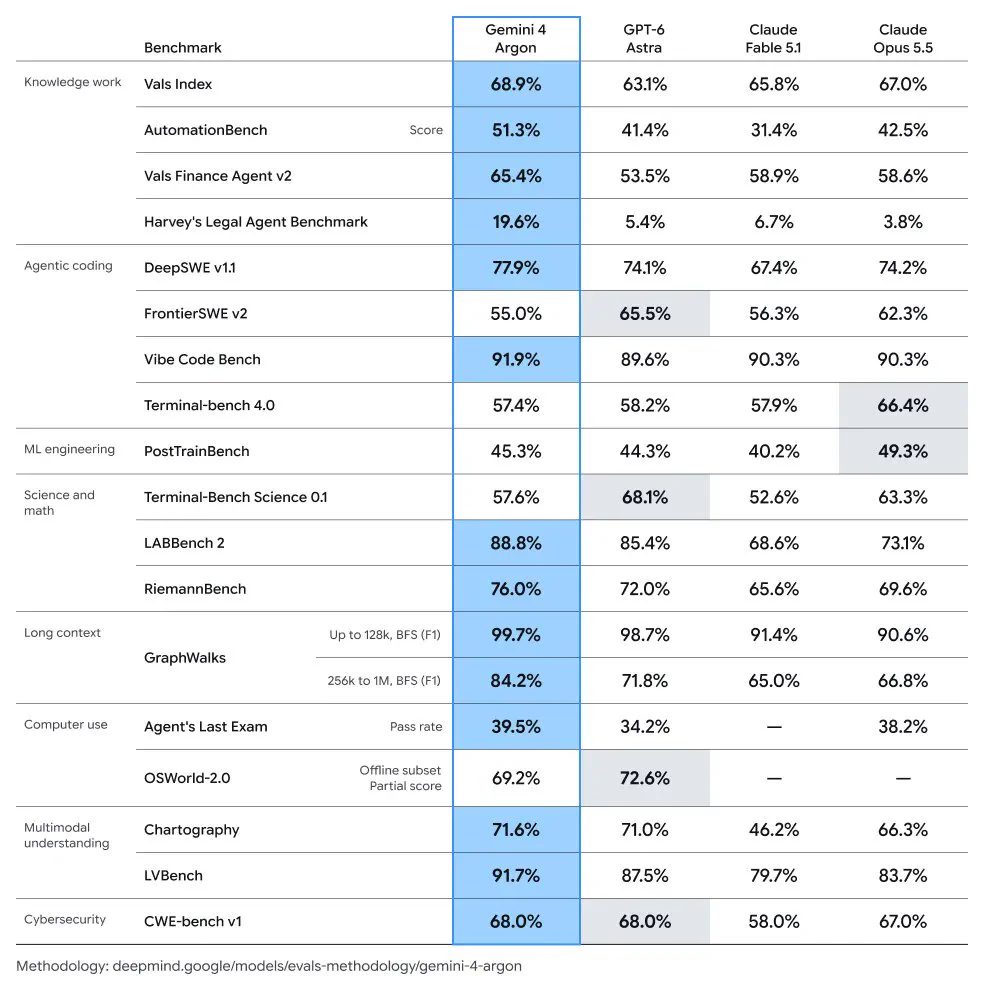
Gemini 4 Argon 的第二组数据把定位钉得更具体:在 DeepSWE v1.1 软件工程基准上拿到 77.9%,刷新该基准的最好成绩,多项测试同时领先 GPT-6 Astra、Opus 5.5 与 Fable 5.1。厂商给它的目标场景写得很直白——复杂工作流,横跨真实软件工程、法律与金融这类企业知识工作、以及网络安全防御。 三类场景的共同点是长链条:一个任务要跨多步工具调用、读大量上下文、出错还得自己纠偏。软件工程基准之所以单独被拎出来强调,是因为它最接近企业真实采购时的验收题——不是答对一道题,而是把一串改动连贯做完。DeepSWE 恰好考的是这个:多文件修改、错误恢复、任务收尾,和办公室里的日常开发对得上。 开放节奏同样透露策略:先给付费 API 客户与最高档订阅用户,再逐步铺开。旗舰能力优先卖给能为它设计工作流的团队,而不是平均撒给所有用户——既能控制早期负载,又能让首批反馈来自最会挑毛病的用户群。 对接企业知识工作负载的团队可以做一次针对性评估:从法律文书抽取、财报归类、漏洞处置里各挑一条真实任务跑一遍,重点看跨步骤的连贯性与错误恢复,而不是单题准确率。基准分数只说明它会做题,任务链上的表现才决定它能不能上岗。
显示更多 话题来源 @testingcatalog 20.8K阅读 ❤️371
🚨 AI News | TestingCatalog (@testingcatalog) on X BREAKING 🔥: Google announced Gemini 4 Argon, a new frontier model for "complex workflows across real-world software engineering, enterprise knowledge work like legal and finance, and cyber defense." X (formerly Twitter)
飞翔的智能体 ·
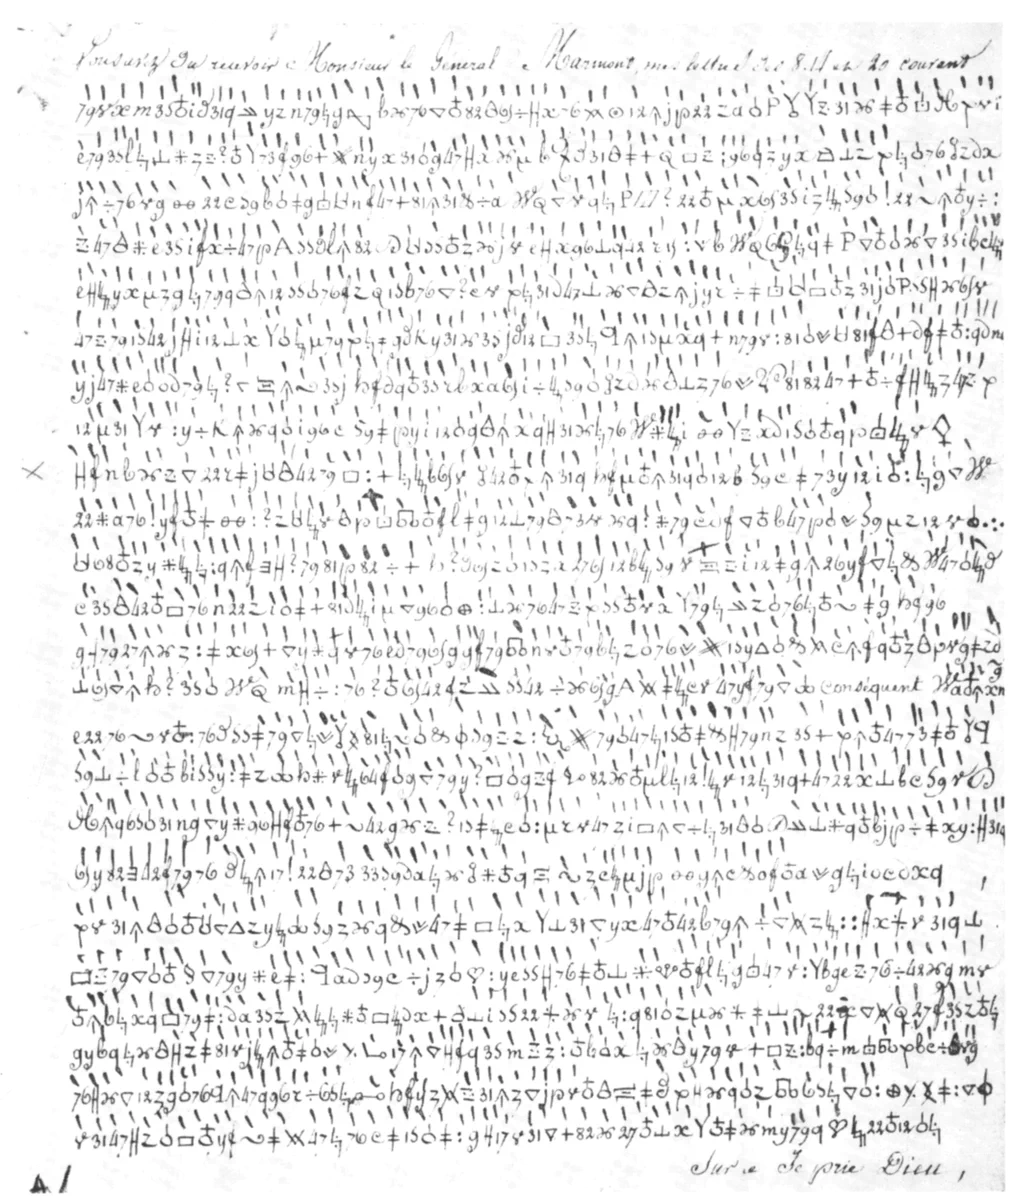
一封 217 年没人读懂的将军密信,被一张照片解开了——作者用 GPT-6 Astra 完成这次破译,全程约六小时,输入只有那张信件图像和"解开它"这一个目标。 作者自己给这次演示泼了盆值得品的冷水:真正惊人的不是密码被破,而是 Astra 独立跑完了整条多模态工作流。 读图辨识笔迹与格式、查史料定位将军身份与通信年代、提出密码假设、逐轮验证、在失败后改道——这些原本分属密码学家、档案研究员、程序员三个工种的活,被一个会自己排期的系统在半天内串成了流水线。 长任务的含金量恰恰在这里:人类专家拆解同一道题,难的从来不是某一步,而是步与步之间不断切换身份、带着上一轮的失败继续下一轮;模型把"停不下来"这件事变成了默认能力,六小时与两百一十七年之间的落差,量的是这种连续性而不是聪明度。 给想用长任务的人一个务实提醒:这类工程的价值在提示词之外的部分——把目标写清楚、把中间产物存下来、给失败留出改道的余地,流水线才能真的跑到第六个小时;半路没人接的自动化,三个小时就会停在原地。 当"从一张图到一个结果"能整段交付,个人能接的课题尺度第一次按周计算——下一道摆上桌的,该是搁了几年的那个问题。
显示更多 话题来源 @CarterWChurch 249.5W阅读 ❤️5531
Carter Church (@CarterWChurch) on X I used GPT-6 Astra to break an unsolved cipher to one of Napoleon's generals that had gone unread for 217 years. What makes this impressive isn't actually the codebreaking, but that Astra completed X (formerly Twitter)
我不是小布丁 ·

OpenAI 在开发者大会上发布 Decisions API:开发者写好一个问题和几个备选答案发过去,模型直接挑一个返回,不生成多余文本。底层用 GPT-6 家族里最小最便宜的 Luna 的特化版本,一次判断约 150 毫秒,同任务走普通接口约 1.6 秒,快十倍。目前有限预览,面向部分 API 客户,随后放开;输入同时支持文字与图片。

它替代的是两条老路。让大模型自由回答再从长文本里解析结果,慢且偶尔答非所问;自训分类器则要先攒标注数据,类别一变就得重训。把答案限定在给定选项里,输出不会越界,换选项也只需改一次请求。

典型场景立刻能对号入座:工单连同"账单组、技术组、售后组"发过去马上知道派给谁,内容审核判断图片能否放行,智能体每走一步决定下一步调用哪个工具。定价也贴着用法定:输入每百万 token 0.042 美元,输出免费,一百万道三选一的判断题大约 19 美元。

更有趣的是这次发布所处的位置。社交媒体普遍调侃 Decisions API 在对标 Jev——创业公司 TypeSafe 九月中旬发布的决策模型:不逐字生成,一次性给所有选项打分,直接返回答案与概率,被称作 System 1 模型。

Jev 上线后在开发者圈快速传播,一个月内就让大厂把同类能力做成了官方接口。创业公司定义问题、大厂规模化交付,这个节奏在工具链上已经反复出现。

两者的能力边界仍有差别:Jev 目前只收文本但每个答案附带校准概率,便于设"低于 0.7 转人工"这类阈值;Decisions API 能看图,也返回置信度。选择标准随之清晰——需要图像输入的走官方接口,需要严格概率校准做风控阈值的,先比较两边的概率分布再定。

给做自动化路由的团队一条落地路径:把最近两周靠大模型自由回答完成的二选一或三选一任务挑出来,估算调用量,按每百万 token 0.042 美元的输入价算一遍,与现有方案对账。若命中场景以文本判断为主,直接替换能省一个数量级;若涉及图片,等预览放开后一并迁移。

显示更多 话题来源 @dotey 45.9K阅读 ❤️144
宝玉 (@dotey) on X OpenAI 推出 Decisions API:给 AI 出选择题,150 毫秒就可给出结果 OpenAI 在今天的开发者大会上发布了 Decisions API。开发者写好一个问题和几个备选答案,再把内容发过去,模型直接从选项里挑一个返回,不生成多余的内容。目前是有限预览,只对部分 API 客户开放,OpenAI 说未来几天会全面放开。 它用的是 GPT-6 家族里最小、最便宜的 Luna X (formerly Twitter)
我不是小布丁 ·

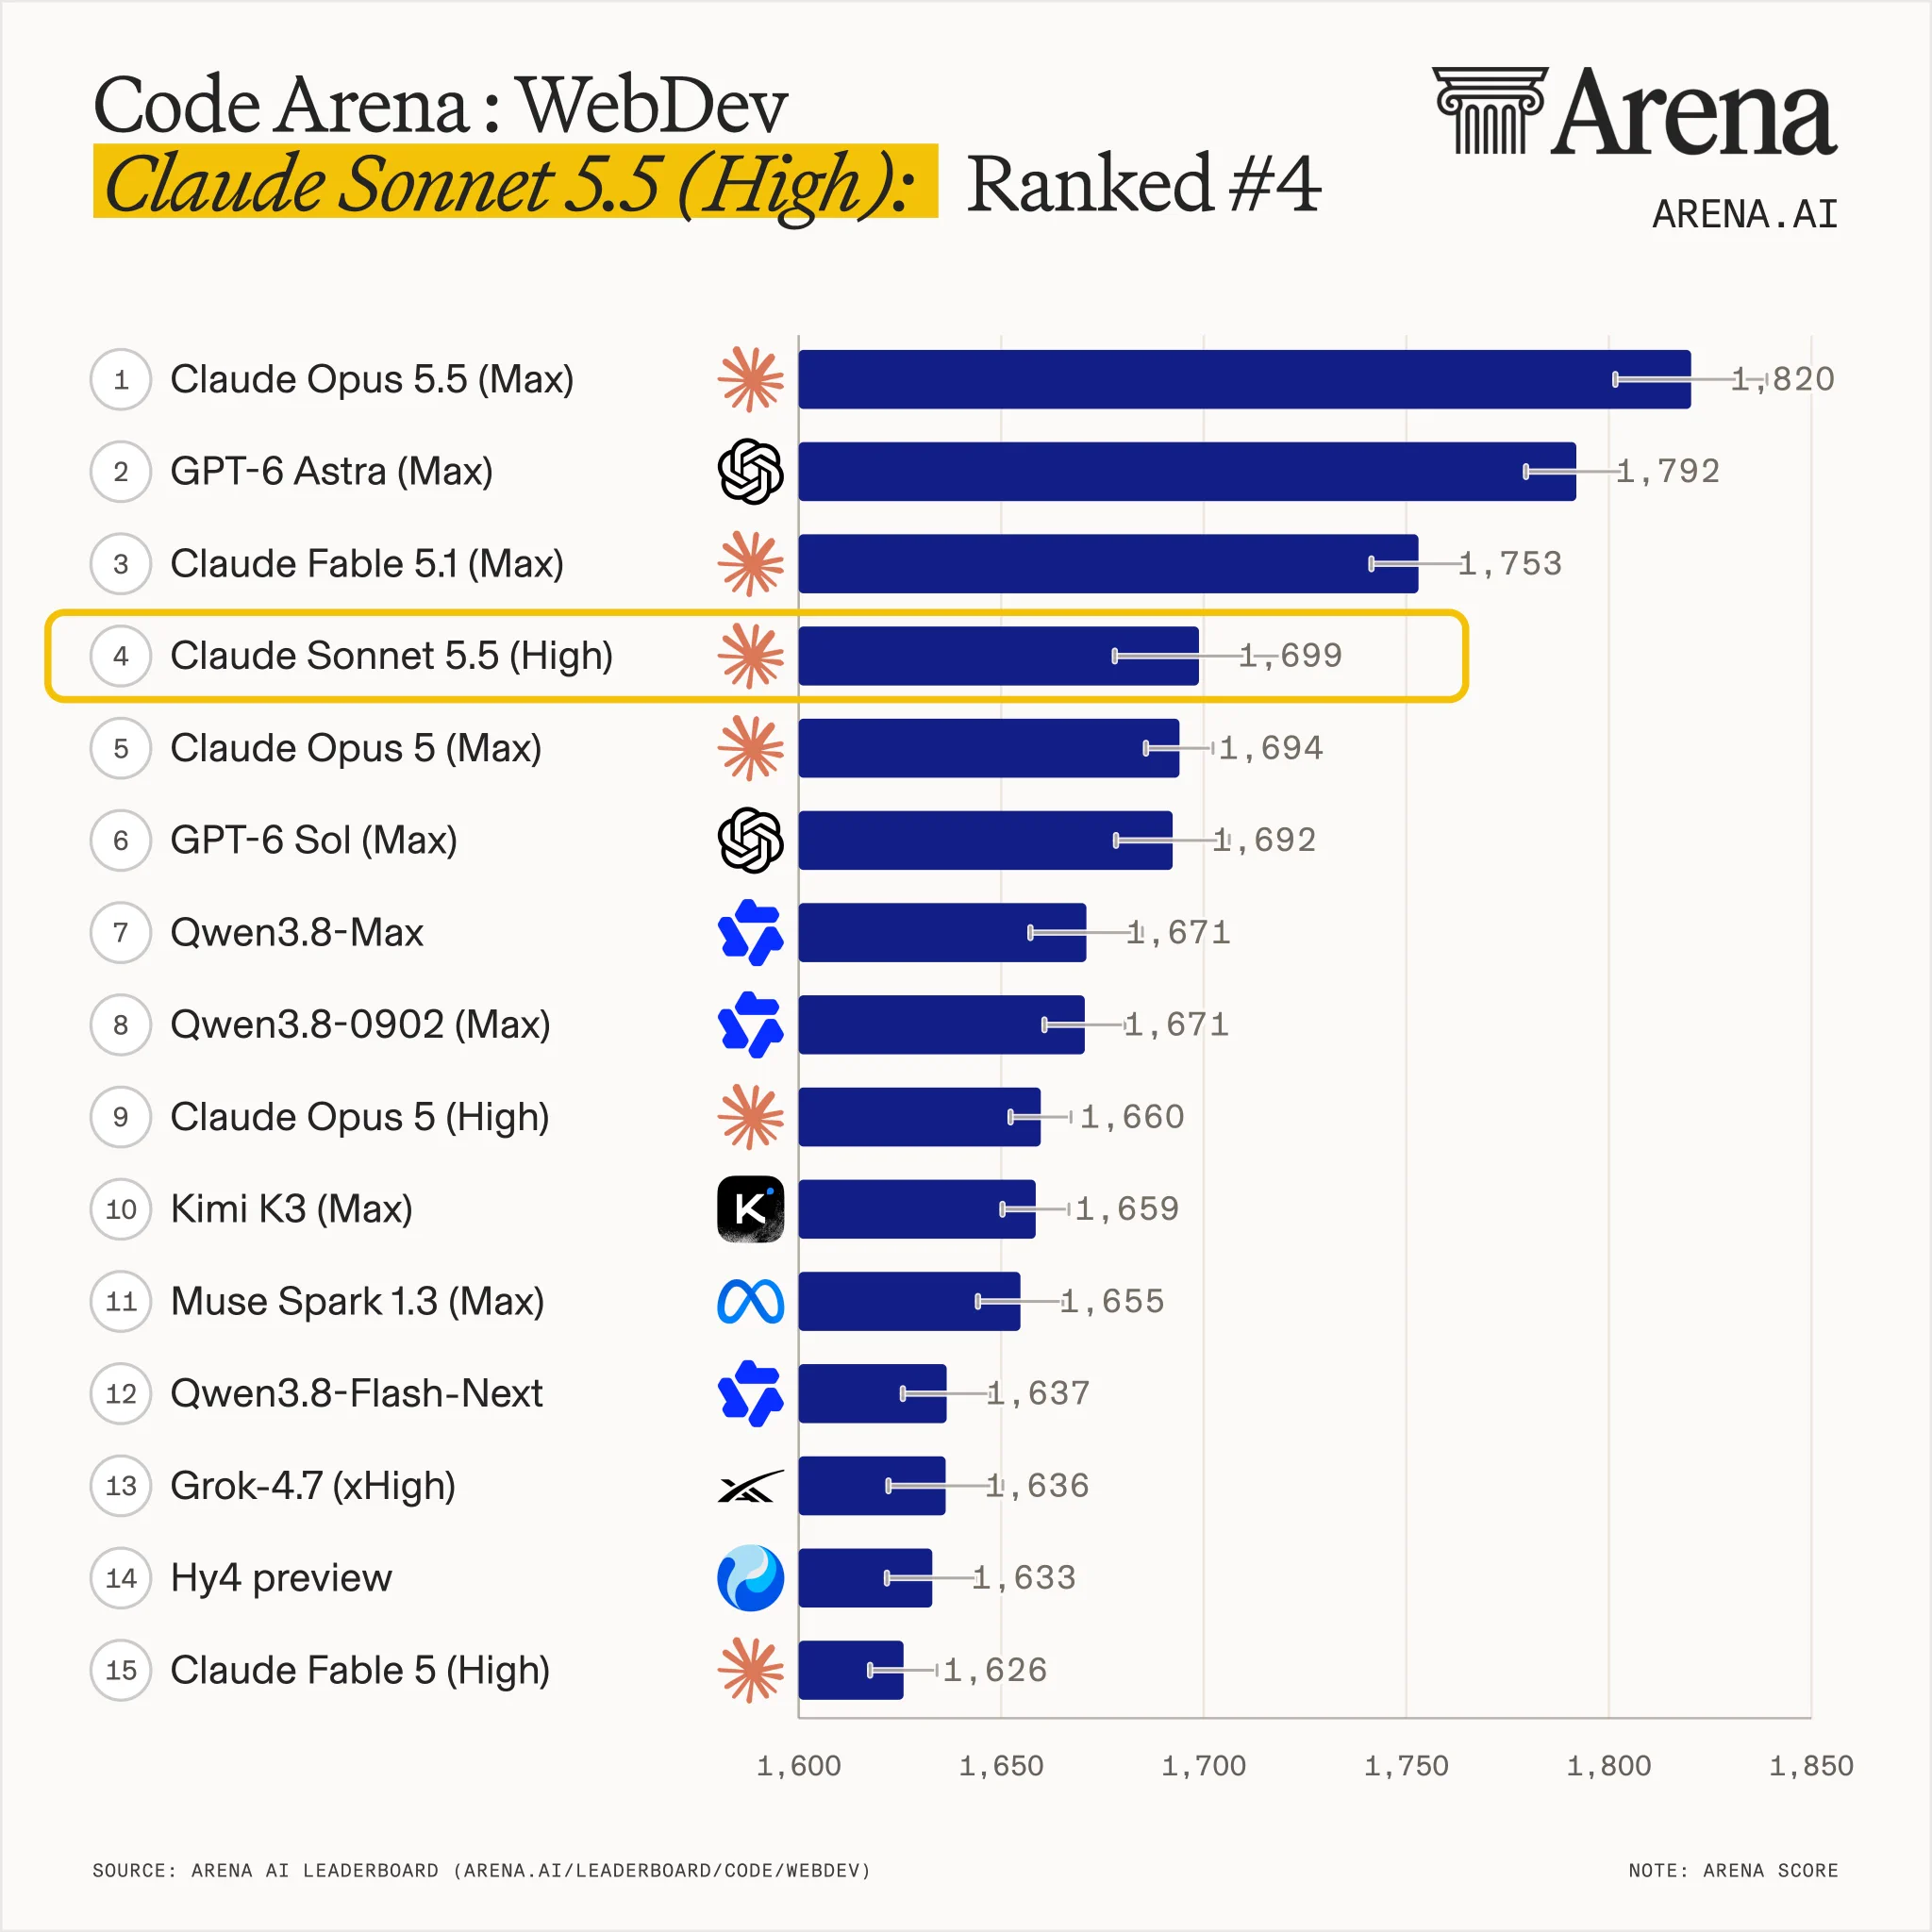
Claude Sonnet 5.5 在代码竞技场的 WebDev 榜单拿到第四名、1699 分,评测方给出的评价是它重塑了成本效率的前沿:混合价每百万 token 约 8 美元,比排在第三的 Fable 5.1 与第二的 GPT-6 Astra 都便宜八成。

与自家上一代 Sonnet 5 相比,总分从第 37 名的 1540 分涨了 159 分,其中参考式设计从第 38 跃到第 4,模拟类任务从第 37 跃到第 4。

名次跳升里最值得看的是分域而非总分。参考式设计指的是照着设计稿还原界面这类像素级任务,模拟类则是对物理与逻辑规则的持续推演,两者都是 Web 开发里最容易暴露模型短板的方向;一个季度内从三十名开外冲到第四,说明这一档模型正在把"能用"变成"好用",而它的价格只有旗舰的两成。

这种"中档贴身、旗舰被架空"的格局正在成为常态:前沿两三个名次之间的分数差在缩小,价格差却保持数倍,帕累托前沿的拐点被一再压低。对预算敏感的团队,继续为旗舰的边缘优势付全价的理由越来越少,除非任务正好落在中档明显失手的那几个分域上。

选型的动作可以很具体:先看自家任务分布最重的两三个分域,去对应榜单查这两项的名次差,再对比混合价。分域名次接近就果断切到中档,把省下的预算留给真正卡脖子的少数任务。

显示更多 话题来源 @arena 48.5K阅读 ❤️524
Arena.ai (@arena) on X Real-world results are in for Claude Sonnet 5.5 (High) by @AnthropicAI. It just landed #4 in Code Arena: WebDev with 1699 pts, and has reshaped the Pareto frontier with its cost efficiency! Claude So X (formerly Twitter)
菠萝与大西瓜 ·
youtube.com/watch?v=w-7eAI… E2B 把 agent 沙箱做成了一件可搬运的家具:Embed 版把整套沙箱栈打包装进单节点,直接跑在你控制的基础设施上——自己的环境、客户的环境都行。 Apache 2.0 开源,Docker Compose、GCP 上的 Terraform、Kubernetes 三种落法任选,对外仍是同一套 SDK、CLI 和 API。 这一手把"沙箱即服务"和"沙箱自持"的旧选择题划掉了。此前想给产品里的 agent 配执行环境,要么整段外包给托管商——数据、延迟、账单全绑在别人手里,要么从零自建——隔离、快照、并发调度每一层都要啃。 现在是同一条产品线的两种摆法:试用期用托管,长跑时搬进自家机房,接口不动、代码不改。 对做 agent 产品的团队,值得先回答一个问题:执行环境放在谁的账本上,本质是放谁的风险清单上。跑在自己机器里,出事的爆炸半径可预、可审计,客户合同也好谈;跑在托管上,省下的运维时间要用数据出境和供应商锁定去换。把沙箱视为可迁移资产,谈判桌上的底牌就多一张。 落地顺序可以很务实:先用托管版把产品跑通,等单客户的执行量过了盈亏线,再把同栈搬进自有机房——那三种部署方式存在的意义,就是让迁移那天不用重写。 agent 基础设施正在从"租来的工位"变成"可搬回家的设备"——你产品里的执行环境,账本上记在谁名下?
显示更多 话题来源 @e2b 212.1K阅读 ❤️98
我不是小布丁 ·
开发者日的官方账号把活动做成了限时闯关:十个构建挑战,四十八小时内完成任意五个即可拿到一张抽奖券,奖品是五份 Codex Micros,随时随地可以参加。这条八百多赞的公告,形式比奖品更值得琢磨。 把新功能包装成挑战赛,是厂商最近越来越顺手的推广手法。它同时解决了两个问题:新能力光靠文档和演示很难让人真正用起来,而挑战题把"学功能"变成了"完成任务",参与者在解题过程中被迫走完真实工作流;对厂商而言,参与者提交的解法又是天然的需求样本,哪些场景被反复选中、哪些步骤卡住人,都直接可见。 对开发者这是成本极低的评估窗口。评测文章和基准分数告诉你模型能做什么,挑战题让你在四十八小时内亲手验证它在你的习惯里顺不顺手——真实任务的完成速度与返工次数,比任何演示都更能决定要不要迁移。顺带还能检验环境:同样的题在本地工具链里跑得通不通,暴露的是配置、权限与上下文管理这些平时被忽略的短板。 参加之前值得做一件事:把挑战涉及的能力对应到自己手头的真实需求上,做完成即复盘,记下哪一步是工具卡住、哪一步是自己不熟。哪怕没中奖,这份四十八小时的记录也是现成的选型依据。
显示更多 话题来源 @OpenAIDevs 87.9K阅读 ❤️837
OpenAI Developers (@OpenAIDevs) on X Ready for a DevDay side quest? 10 builder challenges. 5 Codex Micros up for grabs. Complete any 5 side quests to earn 1 raffle ticket for each. 48 hours. Join from anywhere 🌎 X (formerly Twitter)
我不是小布丁 ·
苦等视频大模型解决一致性和精准控制,最后把高质感动效、UI 演示和科普短片门槛干爆的,是一个压根不出视频的模型——文章的论点很直接:Opus 5.5 靠写代码把每一帧画出来再拼成 MP4,反而更好用。 四套打法构成了一条完整的代码流成片路线。UI 动效用 HTML、CSS、SVG 加弹簧公式算动画,再用 Python 预先抓音频节拍,让光标每次点击都踩在拍上,直接叫板传统剪辑软件的手工关键帧。 电影感 3D 走 Three.js 与 WebGL 着色器,不下载任何模型文件,3D 字标、粒子云、扫描线全在代码里搭出来,镜头还能 360 度运镜。 商业短片走混合路线——写实人物交给视频模型出绿幕素材,背景、动效、排版、分屏由代码抠像合成,写实和可控两头都要;长片用 Remotion 编排分镜,配 TTS 语音和代码合成的配乐,几千帧动画在 Claude Code 里自主跑通。 这条路能成立,靠的是代码对视频的三个结构性优势:每一帧都是参数,改一处全局生效,没有"重抽一次整个变样"的抽卡;帧与帧之间由公式保证连续,一致性问题被数学直接消解;生成过程可复现,存下工程文件就存下了整支片子。视频模型拼的是出图质量,代码拼的是过程控制——商业交付要的恰恰是后者。 对想低成本出片的人,顺序值得反过来:先挑四套里最接近需求的一套跑通一轮,把动效和排版交给代码,只把"必须真实"的部分留给视频模型;对做生成工具的人,把"帧可改、过程可存、结果可复现"写进产品路线,可能比继续卷画质更近用户的真实痛点。 视频生成的下一道坎也许不在模型里——可控性这门课,代码流已经先交了卷,你的出片流程打算怎么补?
显示更多 话题来源 @gkxspace 31.4K阅读 ❤️289
余温 (@gkxspace) on X 好牛逼的文章,太太太干了,让我感觉没有什么是代码做不出来的,如果有就是模型还不够强,Opus5.5这波真赢麻了😅 Opus 5.5 尽管不能直接出视频,但它写代码(Canvas、WebGL、Three.js、Remotion),把每一帧画面画出来,拼成 MP4 好像更好诶 1、Dribbble 级的 UI 动效与产品演示(HTML + CSS + SVG) 让它用弹簧公式算动画,用 Pytho X (formerly Twitter)
我不是小布丁 ·
一个评测频道把两类模型摆上同一组提示词:Claude Sonnet 5.5 与 GPT-6.1 Sol 这些中档选手,对着各自实验室的旗舰——Fable、Opus、Astra——比产出、记成本,视频结果见 youtu.be/r0ymhRtcTeI?si… 。 这类同题对照之所以值得反复做,是因为旗舰与中档的价差往往在四到五倍之间,而多数团队对"中档到底差多少"只有印象、没有数据。把同一批提示词跑两遍、逐条记成本与可用性,得到的不是榜单排名,而是一张属于自己的降级清单:哪些任务换成中档毫无察觉,哪些会明显掉链子。厂商发布的通用分数回答不了这个问题,因为你的提示词、上下文结构和验收标准都和基准不同。 评测方法上有两处最容易走样。一是提示词要同源同参数,温度与推理强度不同会让结论失真;二是判定"够好"得有标准,输出能直接进生产才算数,"看起来差不多"会让中档模型在该掉分的地方蒙混过关。把验收写清楚,比多测十个模型更有用。 落到执行层面,团队可以挑高频任务各取十条真实提示词,中档与旗舰各跑一遍,人工盲评加成本记录,半天就能出结果。得出的分层清单直接写进路由配置:默认走中档,命中降级清单的任务再升档,预算与质量同时得到约束。
显示更多 话题来源 @arena 10.6K阅读 ❤️78
我不是小布丁 ·
有创业者透露了一个圈内心照不宣已久的做法:不少初创公司给工程师批量买十到二十个 AI 产品的订阅账号,用它们承接本该走 API 的负载,而非按 token 结算接口费用。这条观察拿到两千五百赞,说明它早就不是个别现象。 套利能成立,靠的是两套计价的错位。消费级订阅按人头收固定月费,配的是高配模型与宽松用量;API 按 token 结算,每一次调用都算钱。初创公司的典型负载小而散:每人每天几十次改写、补全、调试,绝对量不大但频次高。这种形状的负载走 API 单价昂贵,走订阅近乎包月——十个人买十份订阅,常低于一笔中等规模的接口账单。 厂商看得到这笔账。订阅价隐含的是个人轻量使用假设,一旦被企业负载穿透,动作几乎可预判:收紧并发与频率、把高耗任务排除在订阅外、用风控识别批量行为。这类限速条款往往在争议之后才被强调,封号、限流的咨询为何总在套利流行一阵后集中出现,答案就在这里。 做采购的人可以把这笔账摆到台面上算:拿团队一个月的真实调用总量,分别按订阅席位价和 API 单价结算,差价超过三成再考虑合规边界;同时把"账号被限"纳入业务风险,凡是被封就停摆的流程,不该绑在消费级账号上。价格套利省小钱,稳定的自动化才值大钱。
显示更多 话题来源 @richardartoul 264.6K阅读 ❤️2500
Richard Artoul (@richardartoul) on X i had no idea that so many startups just bought 10-20 AI subscription accounts for their engineers instead of paying API pricing, so funny X (formerly Twitter)
我不是小布丁 ·
ChatGPT 订阅的使用边界被一次性推开:官方宣布订阅额度现在可以直接在十六款以上合作产品里消耗,Devin、Notion、OpenCode 都在名单上,登录即用,不再叠加额外规则。这条八千多赞的更新,标志着订阅从"应用内的权益"变成"跨产品的通行凭证"。 对 OpenAI 来说,这是分发逻辑的转向。订阅的续费动力原本绑在自家应用的粘性上,如今入口可以借道伙伴产品的场景延伸——编程工具、笔记工具、开发环境,每一处都成了续费理由,而用户对"已经付过钱"的感知反而变强。对下游厂商则是另一种算术:接入通行订阅后,自家产品的定价不必再从零起步,用户迁移成本里少了"再买一份"这道坎,竞争被推向体验层。 用户侧的账更简单:一处付费、多处可用,闲置额度终于有了去处,这和此前被反复讨论的额度紧缩形成了同一个策略的两面——入口在放宽,单点配额在收紧,绑定总量而非单次调用才是这场调整的实质。 对采购方,值得核对的清单很具体:把团队已经在用的工具逐个对照这十六款名单,凡是命中的一律并入现有订阅结算,砍掉重复付费;同时看清额度在伙伴侧怎么计费、是否与主应用共享上限,避免一张账单被多处并行调用悄悄打穿。
显示更多 话题来源 @thsottiaux 729.3K阅读 ❤️8839
Tibo (@thsottiaux) on X You can now use your ChatGPT subscription directly in over 16 partners products. No little rules, you can just use all your included usage right there. This includes things such as Devin, OpenCode, No X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单