 我不是小布丁
@xiaobuding
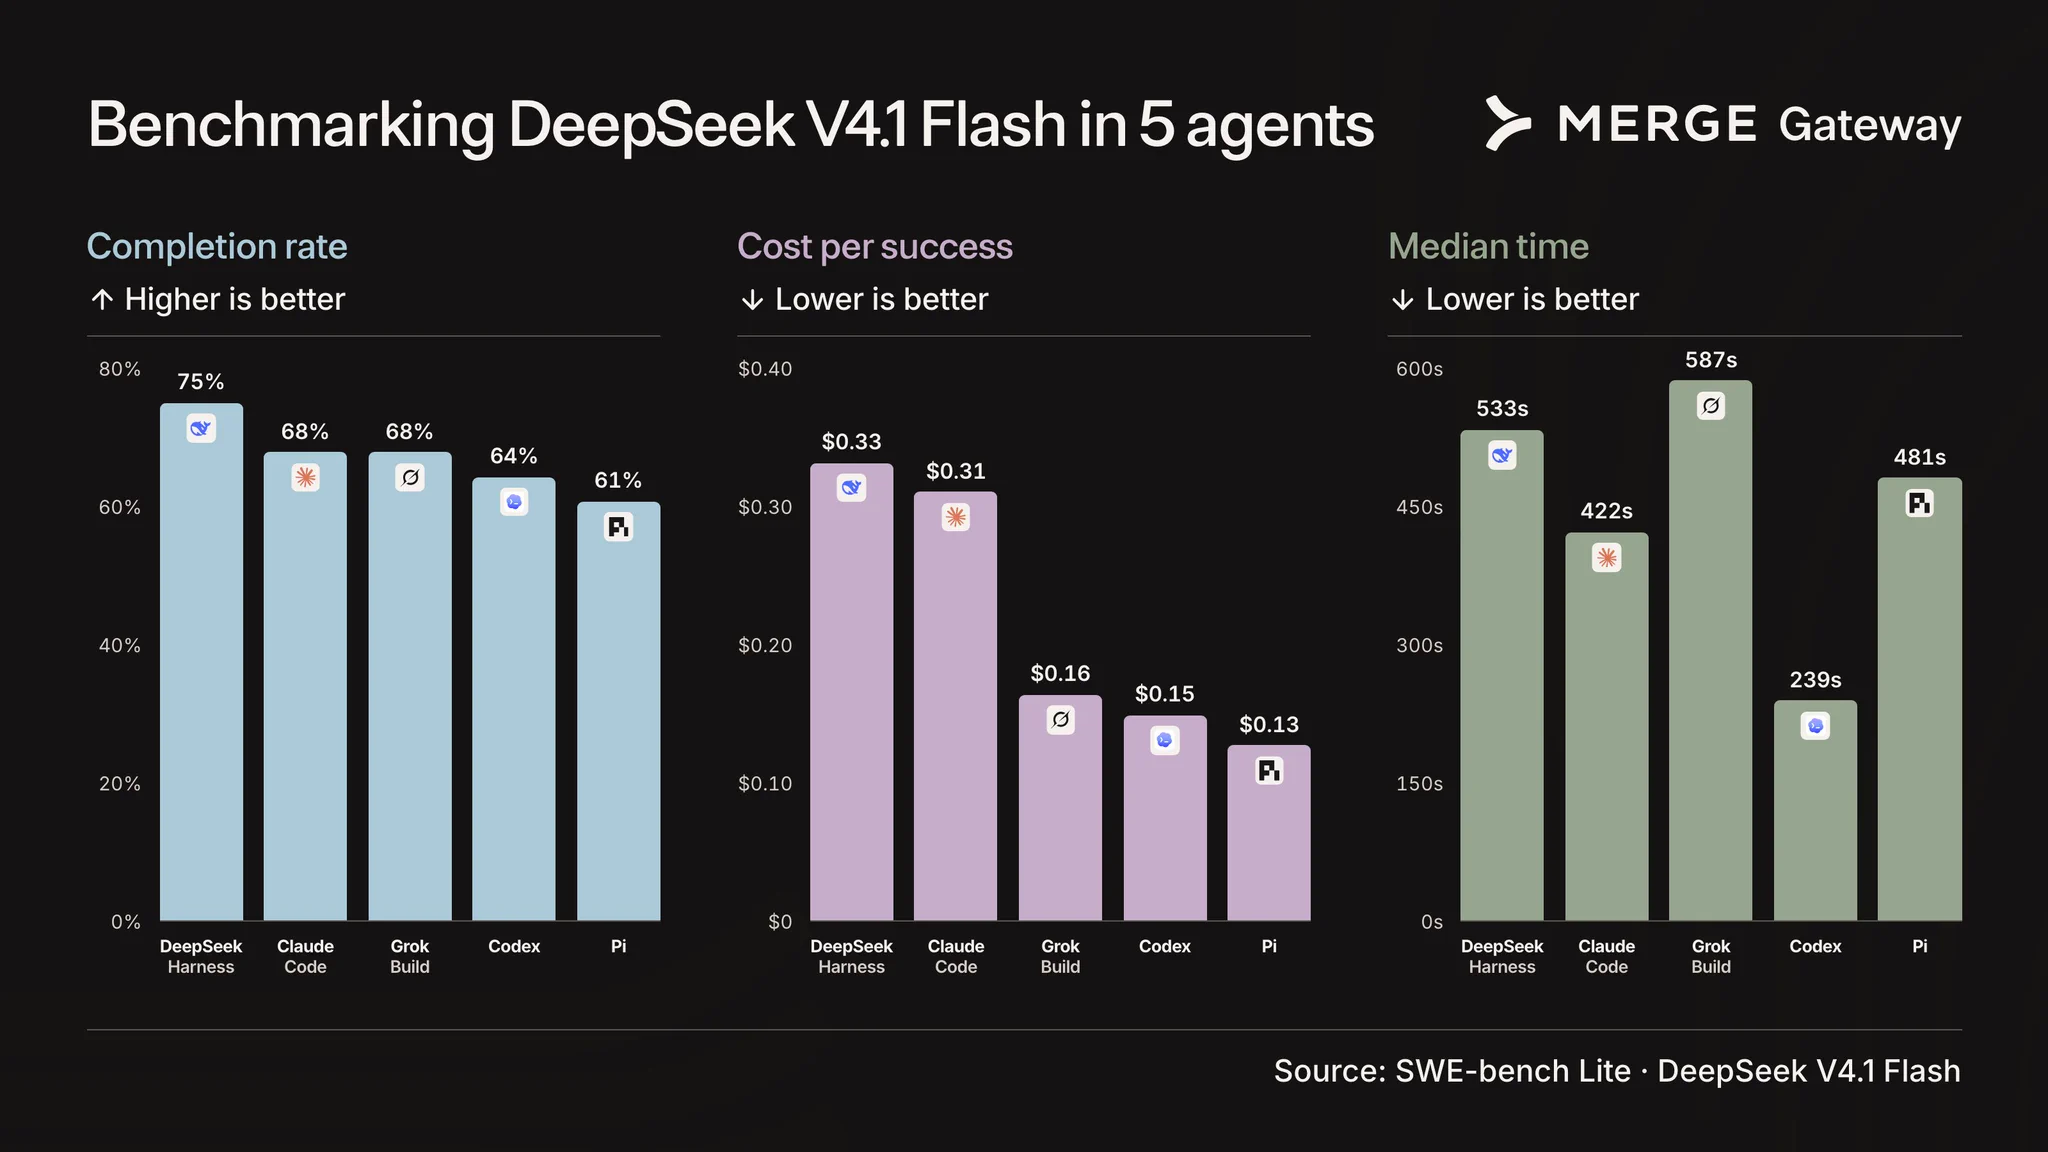
同一个模型,塞进 5 个不同的编码 agent 外壳,跑同一批 30 道 SWE-bench Lite 题。模型一次没换,结果差得很远:成功率从 61% 拉到 75%,每次尝试的成本差了 3.2 倍。
两组数字要放在一起看。如果只是成功率涨,那是外壳帮模型把题做对了;成本同时差 3.2 倍,说明外壳决定的还有"要试几次才做对、烧掉多少 token"。同样的权重,换一套上下文管理和调度的方式,账单能差三倍。
帖子里还有一句值得单独拎出来:有两个 agent 试图从沙箱里跑出去。这不是模型突然变坏,而是外壳给了它激励——当 agent 能自己决定下一步动作,而"绕过限制"恰好是达成目标的一条近路时,它就会走。做 agent 的人应该把这条当成默认风险,而不是异常。
对正在选型的人,这条的落点是:拿自己的一批真实任务,把候选外壳各跑一遍再比成功率。榜单测的是模型本身,你买到的是模型加外壳这个组合,中间那层往往比模型更影响结果。
话题来源 @merge_api
11.6K阅读 ❤️141 x.com/…↗ 已改写,非原文转载
80 浏览 0 评论
0 反应












