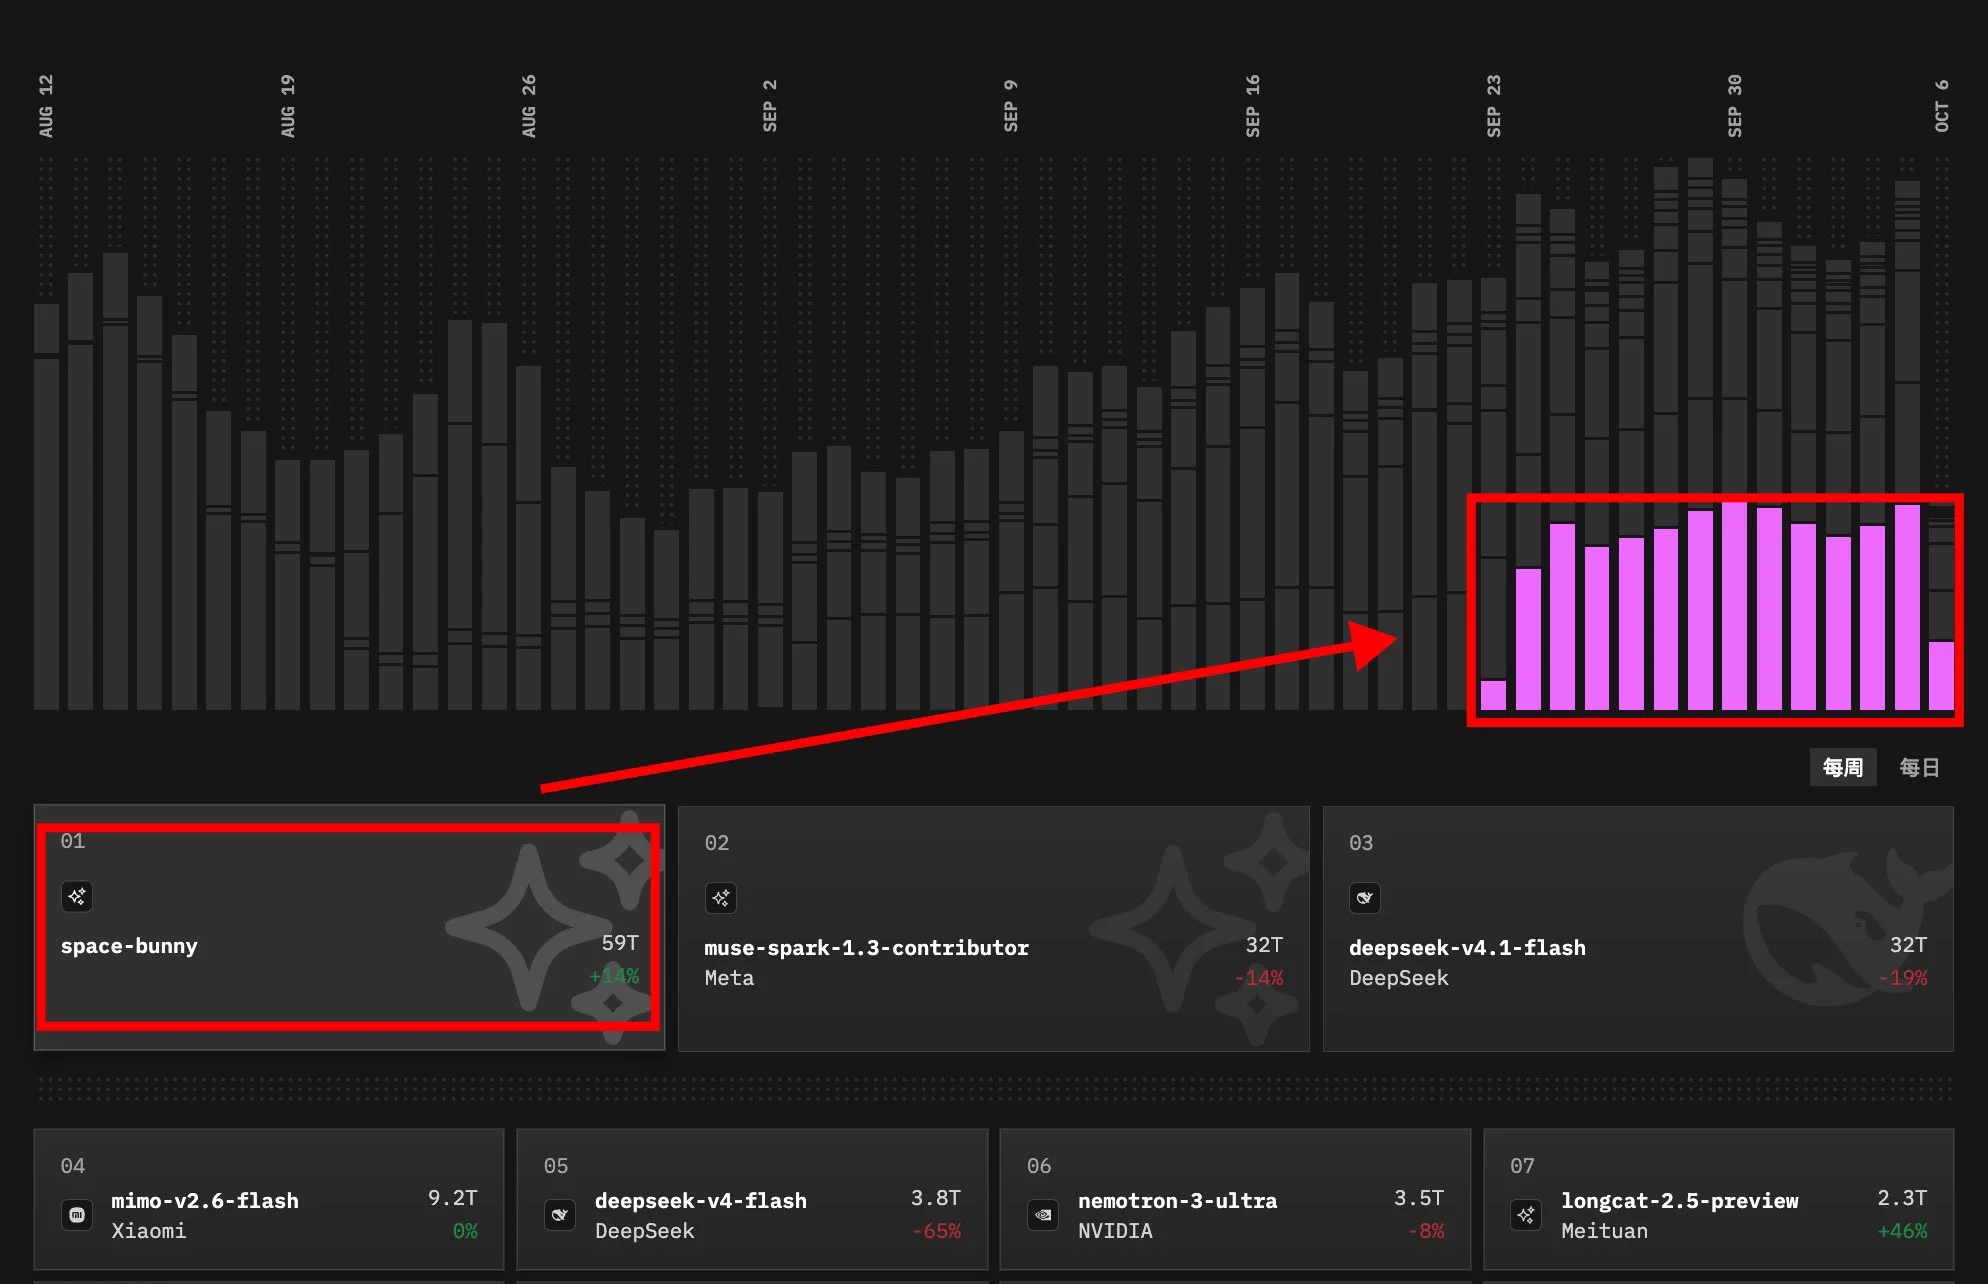
匿名模型 Space Bunny Alpha 的免费期本该到头,OpenCode 又给续了几天,原句是 "we're sponsoring it in our free tier for a few more days",模型还在揭晓前的调优里。StealthModel 这类 AICoding 的把戏,这次玩到了榜单上。
榜单照录。调用量前五,第一名 space-bunny 冲到 59T,涨了一成四,断层领跑。第二名 muse-spark 是 Meta 出的,32T;DeepSeek 的 v4.1-flash 同样 32T;小米的 mimo 9.2T 持平;v4-flash 掉了六成五。
59T 差不多是第二名的两倍,那根柱子把近期的榜占满了。另外一百万上下的上下文还在免费窗口里。
"断层第一"这半句是全场重心。前面重测之后榜首换人讲的是分数的座次,这条讲的是用量的座次。跟前面两档顶配先比额度呼应,那边比谁划得来,这边比谁被用得多,两头都在用数字替模型投票。
匿名那个身份我留意,揭晓之前就先把用量堆到这个位置,名号还没露面,先攒下了排队的本钱。
我留的疑问有三处。59T 的口径没说;免费窗口还剩几天没给;揭晓之后的定价也没数。
这周盯那根紫色柱子到揭晓那天,看名号亮出来之后,用量是接着涨还是掉头。
github.com/temporalio/tem…
github.com/langchain-ai/l…
github.com/inngest/innges…
github.com/hatchet-dev/ha…
github.com/PrefectHQ/pref…
github.com/letta-ai/letta
github.com/mem0ai/mem0
github.com/e2b-dev/E2B
github.com/langfuse/langf…
github.com/AgentOps-AI/ag…
GutHub 上凑出十个开源项目,专治一件事,让 agent 崩了之后还能接着干,那句粗口标题就不逐字转了。
三组照录。第一组标着 MAKE THE WORK DURABLE,Temporal 让执行扛过进程故障,LangGraph 用检查点续长任务,Inngest 管重试与持久执行,Hatchet 负责长任务的编排,Prefect 把失败的工作流捞回来接着看。
第二组标着 SAVE THE STATE,Letta 跨会话留状态,Mem0 让记忆在这一轮跑完之后还活着。第三组先 ISOLATE THE FAILURE 再 FIND WHAT BROKE,E2B 给一次性执行沙箱,Langfuse 沿着整条运行把故障倒着追回去,AgentOps 把会话拿出来查和回放。
恢复那条环也画出来了,任务、执行、失败、查、恢复状态、重试、验、继续。落点那句是它的魂,防住每一次故障做不到,真正的解法是搭出这样的系统,一次坏掉的调用不会把四十分钟的活毁掉。原文收在那句上,"agents don't need to become perfect, they need to become recoverable"。
"可恢复比完美重要"这半句是全场重心。前面十轮实验别建立在假结果上讲的是别让错误往下传,这条讲的是错误来了之后怎么爬起来。跟前面它不会自验呼应,那条把验证交给机器,这条把恢复也交给机器,两头都在把人的手从火线上撤下来。
金句我单独拎出来记,完美这个目标从来够不着,恢复这个目标却是一格一格能搭的,两者的分量正在倒转。
我留的疑问有三处。十个之间的搭配建议没给;恢复环里每步的耗时没数;跨组混用的坑也没提。
这周从里面挑三个接进自己那条最常断的流程,看坏一次之后能自动走多远。
一条把智能体可观测与评测讲透的视频全程用开源件跑通了。两个比喻就把这摊活讲明白。这视频我看完先存链接再记笔记。存的记的点在下面一层层摆。摆好了看那个缺口,缺口在下面摆着,摆好了自己对。
缺口是每个搭智能体的人迟早撞上的,你看着它跑完。回过神来发现它刚才干了什么花了你多少钱全不知道,不知道的运行像蒙眼开车。蒙眼的代价是上线之后才发现它一路在烧钱,烧钱的烧法还查不出哪一笔最贵。
分工的两件一件管工具调用一件管记忆,管工具的那件自称智能体工具界的 OpenRouter,把各家的接口收拢成一个入口。入口的用处是智能体只带一把钥匙出门。一把钥匙换掉一抽屉钥匙的改造是今年最实在的省心,省心的第五层是那句全开源的承诺。
缺口的另一半是费用。摄像头记录的三样里省钱那栏最扎眼。扎眼的运行第一次把账单摊开给人看。看完账单的人会主动去砍最贵的那一步。砍价的冲动是成本意识被唤醒的时刻,唤醒的时刻以前要等月结单才来。
现在每跑一次就来一次。来得勤的成本才降得快。降下来的部分全是纯利。纯利的另一头是裁判那栏,裁判的判定标准写在配置里。标准改一次重跑一次。重跑的对照表就是团队的技术资产。资产攒多了新来的同学照着表就知道什么算好活。
好活的标准一旦写死在文档里就再也不用开会吵架了。吵架的时间省下来又能跑十轮。十轮跑完的队伍自然知道自己的手感在哪。手感在哪的队伍才配谈优化二字。点评两句。第一句是摄像机加裁判这对比喻今年值得所有讲评测的人直接抄走。第二句是缺货的环节才是新工作机会的所在地。所在地的回来点赞,句号。
工具仓库 github.com/superdesigndev… 。试用入口 treg.to 。记忆那件 github.com/ShenSeanChen/w… ,产品页 waku.one ,社区在 seanchen.io ,五条都翻完回来聊,聊得动的点赞,句号。
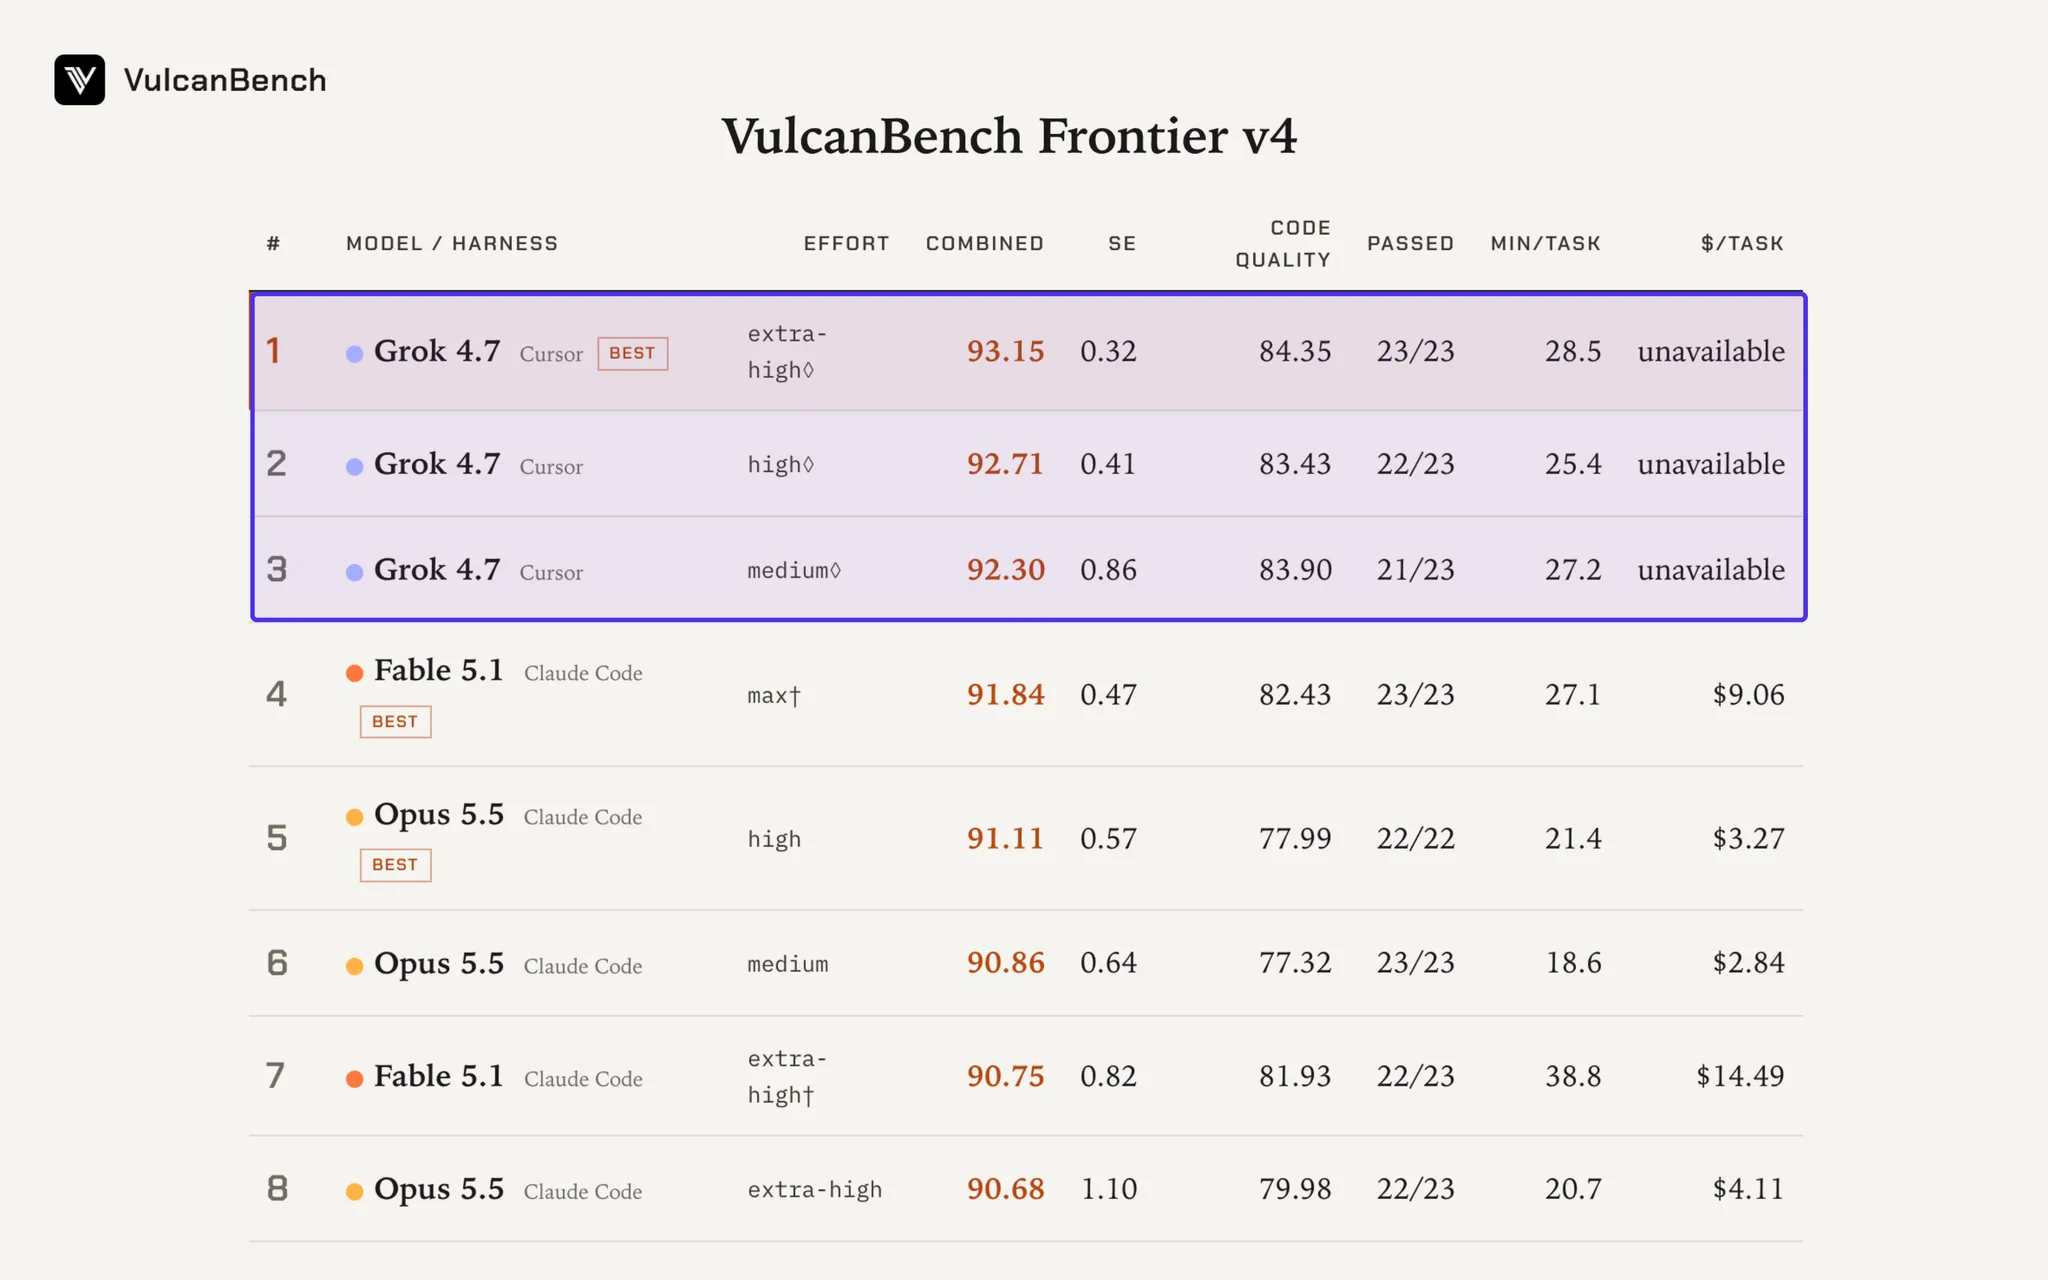
"Grok 4.7 is excellent at dealing with large code repositories",马斯克的原句摆这儿,引帖那头把分数列齐了。
榜单照录。VulcanBench Frontier v4 上,三档全包,xHigh 93.15、High 92.71、Medium 92.30,把 Fable 5.1、Opus 5.5、GPT-6 Astra、GPT-6.1 Sol 这一串压在身后。
考的正是仓库级的工程活,不是几个孤立片段。二十三道行为重建题按真实行为重建老旧软件,功能正确性走隐藏测试,外加安全与质量那几关。xHigh 二十三过二十三,High 二十二。
"不是片段、是整座仓库"这半句是全场重心。前面十道全过讲的是自跑能扛日常活,这条讲的是扛仓库那级的活。跟前面把决定挪进系统呼应,那条改的是谁来定,这条改的是定得多准。跟前面六个仓库各接一段也接得上,一边是别人接进来,一边是自己吃下去,方向相反而落点同一处。
三档一分不差全包我留意,考的换成整座仓库,分数还能压在一条线上,这份齐整比单点冲高更难。
我留的疑问有三处。二十三题的类型分布没拆;隐藏测试的判定细节没说;三档之间的速度差也没数。
这周把仓库里最旧的一块扔给它,看几处能过隐藏测试。
VulcanBench Frontier v4 这张新榜把三档设置的分数全包圆了,榜眼探花状元一个人包了三个。这包圆我看完先看考题再看对手,看的点在下面一层层摆。摆好了看那三档分数,分数在下面摆着,摆好了自己对。
三档分数摆开是 Grok 4.7 xHigh 九十三点一五、High 九十二点七一、Medium 九十二点三零,三档从高到低排成一条平滑的线。平滑的意思是这模型的档位不是摆设是真能降档换省钱。
降档之后的中档照样站在九十二以上,九十二这条线在跑分世界里是前排的门槛,门槛上坐着 Fable 5.1、Opus 5.5、GPT-6 Astra、GPT-6.1 Sol 一串熟脸,三档把它们全压在身后。
考卷的题型是仓库级的软件工程,不是让你写一段孤立的代码片段是让你接手一整套旧系统。旧系统的行为记录在案但实现要你重建,重建完用隐藏的测试题验货。验货的尺子除了能不能跑还量安全、量代码风格的复杂度、量整体质量,三把尺子同时量的考试比单看结果的考试难一档。
补一句题型的来历。行为重建这四个字是这张卷的题眼,行为是旧系统对外答应过的话。重建是把这些话一句不差地重新兑现,兑现的过程要照着老代码的脾气来。脾气摸错一条整题报废。报废的题没有同情分,没有同情分的考试才测得出真功夫。
点评两句。第一句是三档全包圆这个画面说明档位体系是自洽的。自洽的分数体系才耐看。第二句是遗留软件重建这题型迟早变成所有编码模型的必考项,必考的回来点赞,句号。
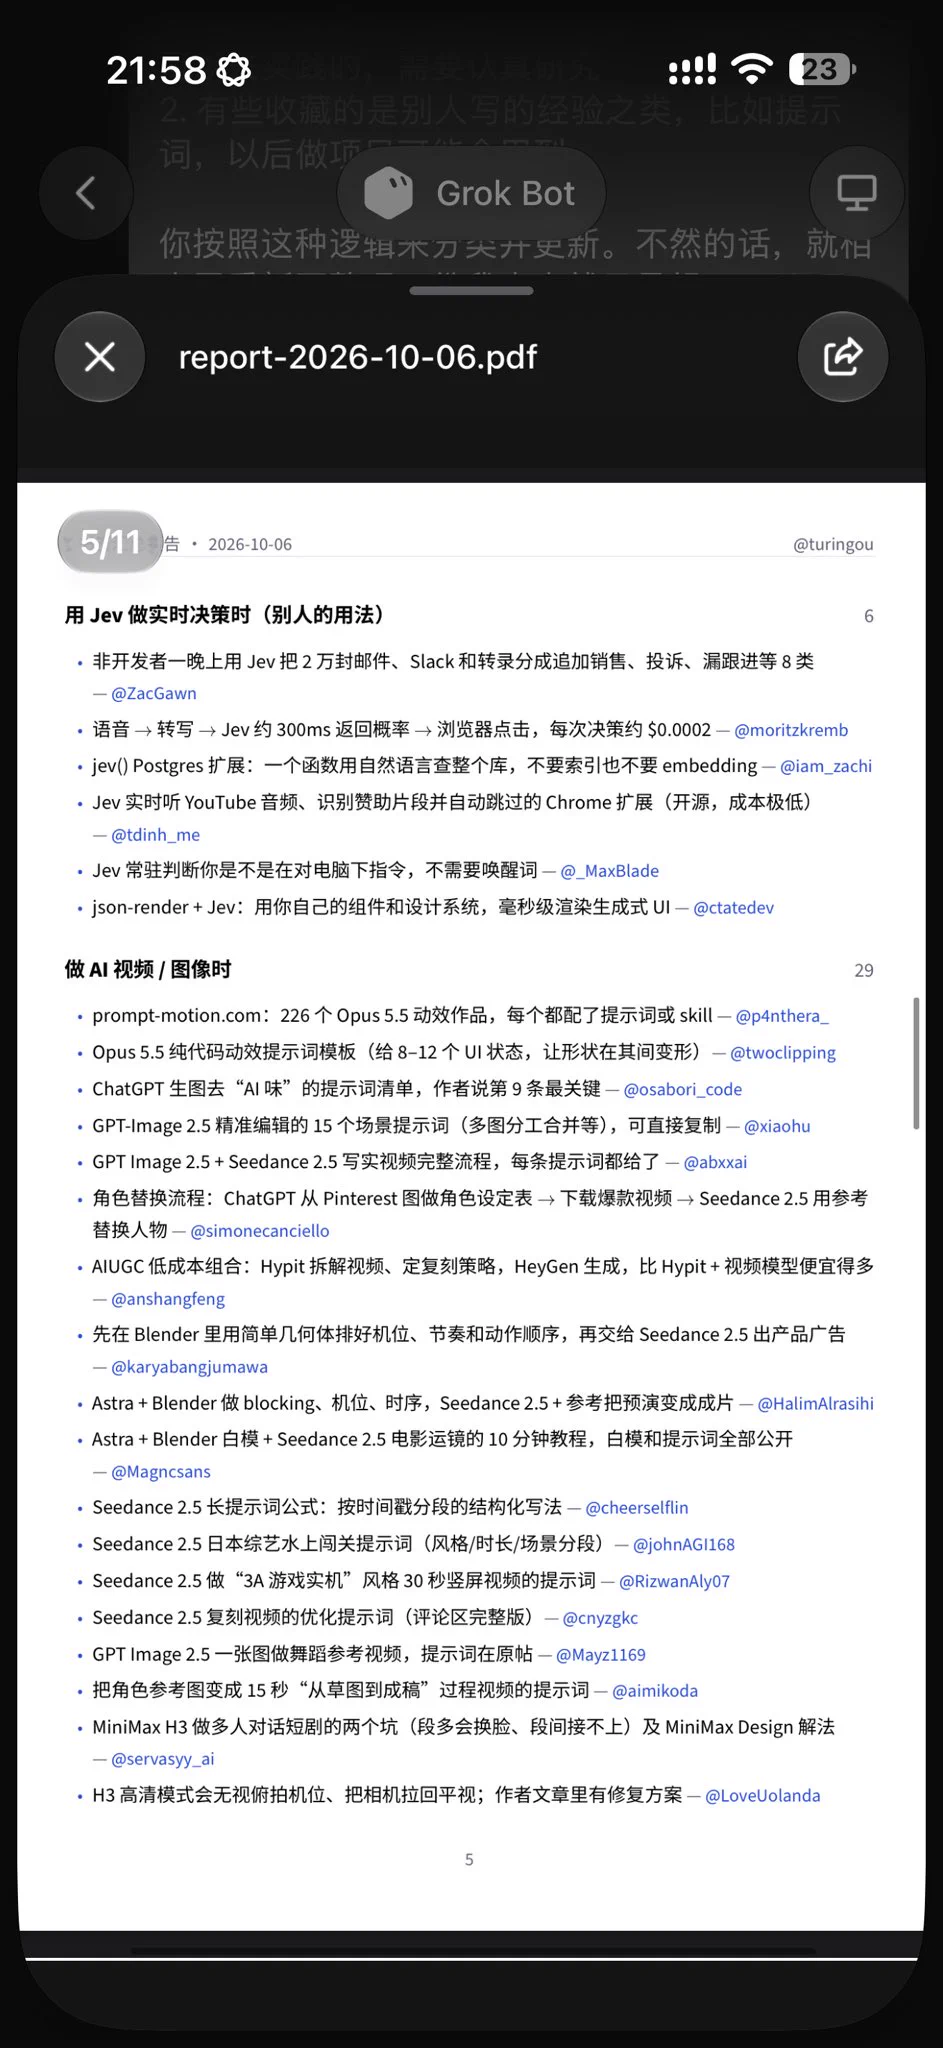
Jev 在 GitHub 上热度不减,六个仓库各自接了一段,位置找得都很准。
github.com/browser-use/br…
github.com/langchain-ai/l…
github.com/vllm-project/v…
github.com/QwenLM/Qwen
六库照录。browser-use 是那个核心自动化库,Jev 的集成生态就搭在它里面,包括那个超快的分支。决策模型直接点 DOM 元素、自动跑流程,不再背大模型的延迟。三千两百多星。
langchain 把它当三件套用,路由器、护栏评估、安全防火墙,任务的风险、意图和复杂度先过它那关,再交给重活模型,九万八千多星。LiteLLM 这个轻量代理拿它做原生决策路由,给进来的提示分类,转给最便宜或最快的那个端点,五万九千多星。
dify 把它做成决策节点,多代理流程里的即时分支和类型分类,五万八千多星。vLLM 是高吞吐引擎,拿来自托管那类决策检查点,低延迟读出概率,三万六千多星。QwenLM/Qwen 是训练底座,Qwen3.5、3.8 那一家训出 Kev、RSI-Jev 这样的开源同类,直接从自定义权重里出类型化的选择,一万八千多星。
"各接一段"这半句是全场重心。前面十个项目那条讲的是决策这层能长在哪些地方,这条讲的是它已经长进了六家的地盘。跟前面 MCP 那条接得上,那边接活,这边接判断,两头都在把那层决策摆到必经之路上。跟前面把决定挪进系统呼应也对得上,路由器、防火墙、分支、分类,处处是同一个动作。
从单个项目到成片的库房,我留意的是这份名单的成色,六家里五家的星数都过了一万八,接入这件事已经不是尝鲜。
我留的疑问有三处。各库里的接入深度没拆;六个版本之间的兼容没说;星数之外的实测反馈也没列。
这周从这六家里挑自己在用的那两个,按说明把决策路由接上,看省下多少重活模型的调用。