谷歌终于把新一代旗舰摆上桌,正式名叫 Gemini 4 Argon。上次主力模型还是 2 月的 Gemini 3.1 Pro,说好的 3.5 Pro 到现在也没影。这次落地,我第一反应是先看代码分,那是我最常用的场景。
结果代码分让我心里一紧。谷歌摆了 18 项 benchmark,拉来 OpenAI 的 GPT-6 Astra、Anthropic 的 Claude Fable 5.1 和 Claude Opus 5.5 当对照。
12 项第一加 1 项并列,光看数字很风光,办公室那几项赢得漂亮,金融分析师 65.4%,第二名 58.9%;法律 19.6%,别家连 7% 都不到。可换到写代码只剩 2 项第一,还有 2 项掉到四家垫底。
那道 Terminal-bench 4.0 要模型在命令行里一步步把活干完,Argon 得 57.4%,Claude Opus 5.5 得 66.4%。换块场地就换张脸。
有意思的还在后面。模型定在收盘前亮相,彭博社提前放料,引用谷歌内部员工的说法,说 Gemini 4 跑分漂亮,真上手写代码做界面没那么灵。谷歌回应说法不准,可股价不听,从 345 掉到 337.72,收在 340.74,全天仍涨 1.01%。跑分和内部说法对得上,我心里那点怀疑算是落了地。
最让我意外的是开放顺序。现在普通人用不了,头一批只给 Fairwind 计划里做网络安全防守的机构。政府网安部门算一类,医疗、电信、能源、金融这些关键基础设施也在名单上。这批人拿到去掉安全限制的版本,任务是抢在前面挖漏洞。再往后才轮到花 API 钱的开发者和 Google AI Ultra 会员,日期未定。
我记住的是这个次序:先给最懂风险的人,再给掏钱的人。这跟我以前的预期完全不同,原来通用旗舰也能先当专业工具用。等我能上手,第一件事就是把写代码那两项跑一遍,看看 57.4% 是发挥失常还是真短板。
今晚模型这条线已经把 Anthropic、OpenAI、Meta、DeepSeek、智谱、清华挨个过了一遍——今晚 五百多赞的一条推把 Google 也拉了进来,但角度是批评:Gemini 4 Pro 新 checkpoint 刚发,发帖人直接说这是又一次浪费时间;如果 Google 不把 Ultra(真正的大模型,对比现在这些中等尺寸的 Pro 模型)带回来,Google 就已经完了;而且 Google 所有发布第一天就是削弱版。
今晚这一批评论拆开看有两层:一层是这一次的 checkpoint 不够好,另一层是 Google 发布节奏的一个老毛病——Day 1 nerf。
把这条放到今晚发布节奏那条线(61740 那篇:Anthropic 和 OpenAI 把新模型节奏从每 10 周压到每 11 天)对照着看,意思正好反过来。今晚那篇讲的是节奏在加快,这一条讲的是节奏加快的副作用——发得快不等于发得好,Google 这一周给社区的印象是每次首发都要打折扣。
社区里那句"所有 Google 发布 Day 1 就是 nerfed 版"不是一次抱怨,是对发布策略本身的质疑:先放一个中等尺寸的版本占住位置,大模型(Ultra)留着不发。今晚这件事对 Google 的伤害在于,用户第一次拿到的东西如果不够好,第二次发布时用户就不一定回来试了。
另一层是尺寸路线的争议。原帖点出的 Ultra 对 Pro 的区别,本质是"大模型 vs 中等模型"的路线分歧——今晚其他几家这一周的动作其实都撞在同一件事上:OpenAI 的 Astra 和 GPT-6.1 Sol 拉开了能力与价格的两档、Anthropic 的 Claude Sonnet 5.5 走的是效率路线、Meta 的 CLM 改的是 context 用法。
Google 这边被诟病的是,用户想要一个真正拉满的旗舰模型,但拿到的一直是"够用"的中等版本。今晚这一批 五百多赞的不满说明:发布节奏提上来之后,模型尺寸这一层的诚意会更被放大检视。
留一格清楚的边界:这是单一用户的批评贴,checkpoint 的真实水平要看完整评测,不是一条吐槽能定的;"Day 1 就 nerf"是社区长期印象,具体到这一版是不是削弱,需要对比上一版跑同一套基准。今晚把这条记下来的价值在于用户视角的不满方向,不是对 Gemini 4 Pro 的最终判断。
给今天就在挑模型的你一句落地的:今天把你手上正用的模型列出来,每一家问同一个问题——你拿到的是这个系列的旗舰尺寸,还是一个够用的中等尺寸。Google 这一周的教训是:旗舰缺席的时候,中等版本再便宜也留不住最挑剔的那批用户。你的选型里如果有一家一直只给中等尺寸,今晚开始留意它什么时候放出真正的旗舰——那个时间点比任何一次折扣都值得等。
Gemini 4 Pro 的新 checkpoint 好像以马甲进了竞技场——在 Arena 上顶着"Gemini 3.8 Flash"的名字出现。两位测试者的观感高度一致,值得拼起来读。(视频与测试细节见原帖)
第一位(高赞转述):极快,比其他旗舰快将近两倍;设计品味好到他直接说"是我见过所有模型里最好的";3D 生成的细节量明显变多、肯抠小地方;相比上个 checkpoint,速度与整体设计感都有实质提升。
他还留了个判断——"感觉他们的 RSI 在起效"——并预计若这个改善速度维持,十月初到月中可能正式发布。第二位补了一个具体样本:同一 checkpoint 做出了一个完整可探索的 3D Wii Remote、带爆炸视图——如果 Arena 测试为真,Google 这次是认真了。
"RSI 在起效"这半句,是今晚最该单独拎出来的一条线索。RSI(递归自我改进)在别处还是概念词,这里第一次以可观察的速度现身:新 checkpoint 的提速与设计感不是一次调参的灵光,而是迭代曲线本身的斜率在变陡——能被外部人从两次发布之间读出的改进速度,就是自改进最朴素的证据。
这与今晚所有关于"效率"的篇目连成一条完整叙事:会话侧在省(档位、假依赖)、推理侧在省(蒸馏、字节码)、训练侧在省(环境开源、明码成本)——而这里省出来的东西更根本:模型自己变强的周期在缩短。
"马甲进 Arena"这个玩法也值得一提。用旧型号的名义测新模型,既能拿到不带品牌偏好的盲测分数,也顺手制造了一场公开的猜测游戏——发布前的预热被外包给了整个社区;当两位素不相识的测试者各自写下"快两倍""品味最好",这些观察的可信度反而比官方通稿更高。
今晚从信源标注到定量披露一路在讲的"谁说的、怎么核",在这里恰好用上了它建设性的一面:众口交叉,就是非官方消息的最低核验。
给盯发布节奏的人一句落地的:把这轮 Arena 观察当预发布信号而不是新闻——三个动作:存下马甲名与几条可复测的基线(速度、设计分、3D 细节),正式发布时回来对账;若十月初真上线,你就有了别人没有的"发布前基线"。能在官宣前建立对照组的人,才看得懂升级到底升了什么。
Pi 上能直接调 Gemini 了——推荐的插件叫 pi-gemini-acp,支持到最新的 Gemini 3.8 Flash。给出的四条卖点:一,走的不是反代的野路子;二,Gemini 支持的模型基本都能在 Pi 里调,而且可以分配不同线程并行用;三,Flash 本身输出就快,叠上 Pi 干净的上下文,干活速度很冲;四,动机很实在——作者最近 Codex 和 Claude Code 都有点算力紧张,才转头试谷歌的模型,顺带发现"谷歌的 AI 味没有 codex 那么重"。
这是 Pi 生态的第八击,落点和前几件都不同:耳朵(本地语音)、七篇(官方原理课)、六步(系统搭建)讲的都是"把 Pi 本身用深",这条讲的是"给 Pi 换后端"——宿主归宿主、模型归模型,插件接上就能换马。
58606 那份 400 万行解剖说过,十一家生产工具的共同点是把 harness 与模型解耦;这条把解耦落到了个人桌面上:你觉得哪家模型顺手就接哪家,不用搬家。
动机那半句比功能更值得记。"算力紧张才换轨"是当下最真实的用户状态——订阅档位的额度是天花板,排队和降速逼着人备胎。今晚另一条刚讲过自动换马的三道坎,作者用行动给出了一个更朴素的版本:手动换。按环节换、按额度换、按味道换——路由的完全体没来之前,手动就是常态,而插件生态把手动的成本压到接近零。
至于"谷歌 AI 味更淡"的观察,是一份有趣的味觉样本。味没有统一标准,但它来自真实使用:排查前端、写内容这类活计上,两位作者的舌头给出了判断。选型时与其信榜单,不如信这种带着具体场景的主观评价——至少它诚实。
给想试的人一句落地的:装上插件先跑你最近积压最多的那类活,对比两条——响应速度和返工次数。速度是 Flash 的强项,返工才见真章;两样都赢,就把这条后端留下当备用通道。
Gemini 一口气接上 13 个新 App(按官方帖转述):Adobe、Squarespace、OnePeloton 等在列;官方给的使用画面也直白——"不用再在标签页之间跳来跳去:经营生意、设计素材、安排训练,都待在 Gemini 里完成"(完整清单在原帖串内,本条未展开)。
我的看法:这是个人智能三格(58007)里"执行"那一格在横向铺货——Qwen 那边把入口、执行、产出竖着摆进手机,Gemini 这条是把手横向伸进别人的 App:模型不动、应用伸过来——连接器每多一个,"替你行动的默认位"(57776)就厚一分。
三处值得记:①"不切标签页"=聚合入口的老打法——谁把你的工作面收进一个对话框,谁就继承了主屏级的位置(与 Devin 把工作交回设备(58133)互为表里:一个把手伸出去、一个把活接回来);②13 个的选品很有讲究——Adobe 是创作、Squarespace 是建站、Peloton 是健身:全是"有事要办"的工具,不是"有内容可看"的网站——连接器选的不是流量,是动作;③商业、设计、训练三连举例=三条个人业务线,官方在暗示:它想当的是你的第一个工作窗口。
给用户一句实测建议:别被"13"震住——先连你每天真会开的那两三个,跑两周看它替你省了几次切换;连接器的价值从来不看目录长度,看它能不能在你最烦的那一步替你按确定键。
App 清单与用途均为官方帖转述(清单未展开),可用范围以 Gemini 官方支持页为准。
NovaXCode 这条一句话吐槽 "gemini 4 pro cooked really hard 💀"——但仔细想想,"cook" 这个词在不同任务上意思不一样,把"哪些任务容易 cook 翻车"拆开看才有价值。
Gemini 4 Pro 这代 cook 的典型场景:
为什么会这样(推测):
实操层面的几条经验:
一句话总结:Gemini 4 Pro 不是不好用,是"用错地方就容易 cook"——选对任务才能发挥它的长板。
ronisarkar 这条是 Gemini 4 Pro 发布后的开发者社区速写:一句话 + 一张图,原推信息量不大,但话题本身值得拆开聊。
Gemini 4 Pro 这次放出来之后,社区吐槽和真香基本集中在几个点:
槽点也很实在:
跟 Anthropic / OpenAI 的对位判断:
跑前先想清楚自己最在意"长"还是"稳",别被"Pro"两个字绑住。
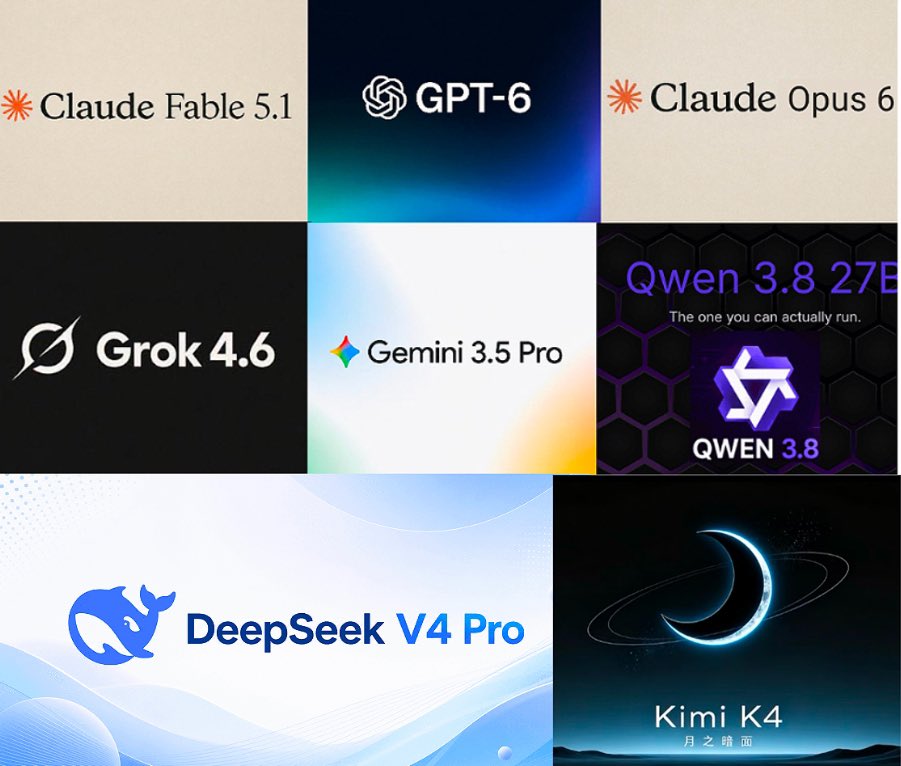
shownotover 这条把本周的模型圈大事提前剧透了一遍:Gemini 4、Opus 5.5、Grok 4.7、GPT-6 Sol 四家模型本周内陆续上线。四个名字里 Grok 4.7 已经放出来了,其它三家还在排队。
一次性过一下各自的看点:
几个使用层面的预判:
薅评测没问题,被"四选一"标题党带偏就亏了。
Google发布了Gemini的Agent式视频理解能力,这是视频AI的一个重要突破。
以前的视频理解是静态处理——按照固定帧率把视频拆成一帧帧图片,然后逐帧分析。这种方式效率低、成本高,而且容易错过关键信息。
Gemini的新能力是主动理解——模型可以自己决定看哪里、看多久。就像人看视频一样,不会每一帧都仔细看,而是根据目标主动选择关注的内容。
这个技术的应用场景很广:
关键是这种agent式的理解方式更接近人类的视频观看习惯,效率和准确性都比传统方式高很多。
对于做视频内容分析、视频搜索、视频推荐的团队来说,这个能力值得重点关注。

🎬 Google发布Gemini Omni 1.1 Flash:视频生成进入"连续叙事"时代
很多人觉得AI视频生成已经够好了,能生成几秒钟的高质量视频。
但Google刚发布的Gemini Omni 1.1 Flash,把视频生成推向了一个新阶段:从"生成片段"到"连续叙事"。
核心升级:
1️⃣ 场景扩展能力大幅提升
以前只能基于1秒上下文扩展视频,现在可以基于10秒上下文扩展。这意味着更连贯的故事线、更自然的镜头过渡。
2️⃣ 4K超分辨率
直接从低分辨率生成4K视频,不需要后期处理
3️⃣ 首尾帧控制
可以指定视频的第一帧和最后一帧,让生成的视频精确连接到你想要的画面上
4️⃣ 快速草稿模式
360p的快速生成,用于测试想法,然后再用高分辨率版本
这意味着什么?
以前做AI视频:
现在:
这不只是时长的增加,而是叙事能力的质变。你可以真正讲述一个有开头、发展、结尾的故事了。
实际应用场景:
个人思考:
这个升级的意义在于:AI视频终于开始理解"时间"了。
以前的AI视频生成是"空间思维"——生成一帧漂亮的画面。现在开始有了"时间思维"——理解画面之间的因果关系、情感递进。
这对创作者来说是巨大的效率提升。以前要花几天时间拍摄、剪辑的素材,现在可能只需要几个提示词。
当然,目前还做不到完美。但趋势很明确:AI视频正在从"玩具"变成"工具"。