AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
小白爱摸鱼 ·

Anthropic 今天起恢复对一类特殊请求收费:那些 Claude 还没回答就被安全系统拦下来的请求,现在也计入账单。适用范围被刻意收窄到三个误报率低的类别——生物、蒸馏攻击、前沿 LLM 开发;官方同时说明,近期出现过针对系统的协同攻击,收费是其中一层防御。

计费口径见官方文档:platform.claude.com/docs/en/build-…

这纸公告值得逐句读,因为它把三笔账摆到了台面上。

第一笔是防御账。蒸馏攻击被单列,等于把"用你的 API 白嫖训练数据"正式标价成一种成本——过去拦截只是说"不行",现在连拦截本身也过账单,门槛从拒绝抬高到了付费拒绝。对真在做前沿研究的用户,这其实是利好:攻击者的套利空间被收费压掉,正常流量被误伤的概率随之下降。

第二笔是透明账。三个数字给得干脆:99.7% 的账户在测试中没碰到新的可计费拦截;分类器误报率调到低于 0.1%;并且明说"我们知道这不是 0%"。肯把"不是 0"写进公告的厂商不多——这句自认比任何"我们很安全"都更像成熟产品该有的措辞,和今晚另一条"先有数、后有盘"是同一个气质:把缺陷量化,才谈得上改进。

第三笔是边界账。三类可计费里,生物排第一并不意外——这类内容撞的是最重的安全红线;真正说明问题的是"前沿 LLM 开发"被放进来:模型公司之间的攻防已经打到了对方 API 的日常流量里,安全策略不再只是合规动作,是商业战场的一部分。

给开发者两句落地的。其一,把"被拦截的请求"也纳入你的成本监控——它们现在会出现在账单上,出现频率异常就是信号;其二,真被误拦别默默认栽,官方文档里写了申诉与回看的路径,0.1% 的误报落到具体账号上就是 100% 的一次停工。

显示更多 话题来源 @ClaudeDevs 58.1K阅读 ❤️705
App unavailable in region | Claude by Anthropic Unfortunately, Claude isn't available here. Claude
我不是小布丁 ·
把小说改成短剧,过去最耗人的不是写,是拆——角色、场景、剧本、分镜,四样都得先捋清楚才敢动手。shuohao-skills 把这套前置流程做成了 AI Skill,Claude Code 和 Codex 都能用。仓库:github.com/eternityspring… 丢进一部长篇,它先自动整理三层:角色与故事大纲、场景与道具设定、剧本与分镜。不需要额外的 API Key,用当前 agent 的额度就行,脚本本身也轻量。 这个思路和今晚那条 157 张分镜卡的 Skill 正好是一对,而且分工清楚:分镜卡管的是成片侧——镜头怎么拍、风格怎么定;这套管的是文案侧——故事还没变成画面之前,先把"谁、在哪、说什么、按什么顺序"钉死。一条短剧流水线需要的两头,都在各自被 Skill 化。 它还印证了一条更老的判断:AI 不会从灵感开始干活。你丢一句"帮我写个感人短剧",出来的东西千篇一律;你先给大纲、给场景表、给角色小传,它才有可能接得住。这套 Skill 干的就是把那三样东西系统地喂进去——前置结构的质量,决定后面一切的下限。写过脚本的人都懂:拆解这步偷的懒,会在分镜阶段连本带利还回去。 免 Key 这点也值得一提。用当前 agent 的额度,意味着它把自己当成工作流的一环而不是又一个订阅——和今晚出现过的零配置工具是同一种自觉:能不添的账号就不添。 给想做 AI 短剧的人一句落地的:先拿一章你熟的故事跑一遍,看它拆出的场景表和你心里的版本差多少。差得多,说明你脑子里的结构从来没写下来过——那正是这套 Skill 最该干的活。
显示更多 话题来源 @bkdgiffug 3.1K阅读 ❤️45
GitHub - eternityspring/shuohao-skills: AI 短剧制作的 skill 集合:拆角色、排大纲、出场景与道具设定、写剧本、切分镜 | Agent skills for AI short-drama pro AI 短剧制作的 skill 集合:拆角色、排大纲、出场景与道具设定、写剧本、切分镜 | Agent skills for AI short-drama production — character bibles, adaptation outlines, art bibles, screenplays, storyboards. Runs in Claude Code & code... GitHub
胡辣汤爱酸菜 ·
被问是否用了 Manim、Remotion 这类框架,答:没有。管线朴素到反直觉:Canvas 2D 逐帧画 → Playwright 无头截图 → ffmpeg 编码出片,浏览器当画布、截图当采集。作者更直白:别用人类思维揣度 AI,没有技巧和语法糖,最粗暴的方法解决(引用面另有额度实测,口径在下)。 三层拆:一,朴素原语可组合的样本:没有专用动画工具,三样零件按序串起——能拼的别等专用工具,等待比拼装贵;二,逐帧截图=生成降级成采集:每帧都是可打开的 JPEG,坏帧能定位重跑——视频因此可观测可调试,与"看过程、可接管"同源;三,引用面的额度对比只当成本素材:同一视频不同平台额度密度差一个数量级(其自测,非推荐,不背书)。 口径:①"没有框架"是此帖断言,以源帖为准、未复核;②不外推成"框架无用":它解决的是 4 分钟视频,复杂叙事的分镜插值另算;③粗暴法边界=每步可查——监督不了的环节,越粗暴越危险。 照做三条:一,把"生成+导出"画成三格:生成、采集、编码,缺哪补哪;二,采集用可观测格式(JPG/JSON 落盘),中间态别留黑盒;三,记每百帧的人工干预,不降即没成形。 下次让 AI 做视频前先问它:用哪些零件、按什么顺序?
显示更多 话题来源 @akokoi1 21.2K阅读 ❤️50
WY (@akokoi1) on X 有很多人问,Claude是不是用了Manim、Remotion、Motion Canvas 这类动画框架? 答案是没有!Opus5.5纯靠大力出奇迹,用原生 Canvas 2D 自己画,逐帧截图Playwright 打开无头 Chromium,对画布逐帧截 JPEG,把截出来的 JPEG 帧流编码成视频,再混入音轨。简单说,就是用浏览器当画布、ffmpeg 负责编码。 不要用人类的思维去揣度A X (formerly Twitter)
自由翻滚的风铃草 ·
一条挺有分量的评价:阮一峰的《中文技术文档的写作规范》,被当成了"去除 AI 腔"的规范。(配图见原贴) 一份本来教人写文档的规范,成了反 AI 腔的标准,这中间的位移很能说明问题——大家缺的从来不是文采,是"像人话"的基本盘。 AI 腔的病灶其实很集中。排比对仗硬凑、每段都要小标题总结、结尾必有一段收束陈词、形容词堆在名词前面……这些不是随机的毛病,是模型统计出来的"安全写法":对仗最容易被人类打高分,总分结构最不容易出错。规范做的事就是把这些安全牌一张张掀掉——不是让你写得更有文采,是让你先别写成一个平均值。 有意思的是,读者对 AI 腔的敏感已经超过了作者。很多人刷到一篇文,三行之内就能闻出味儿,然后整篇都不再信——AI 腔的真正代价不是难看,是折损可信度。这和去 AI 味那几条老建议是同一件事:套话让句子失去信息量,读者察觉之后,连真话也开始打折。 规范能出圈还有个现实原因:它够具体。"避免空话"这种指导没用,"开头别用陈词滥调"这种能执行。一份标准能不能落地,就看它给的是名词还是动词——给动词的规范才会被照着做。 给写文档的人一句收束的:写完先扫三个地方——开头有没有套话、每段小标题是不是在复述正文、结尾是不是在总结前面说过的话。三处都干净,AI 腔就去了七成;剩下的三成,交给内容本身去撑。
显示更多 话题来源 @supezen 3.5K阅读 ❤️53
ZEN (@supezen) on X 阮一峰老师好牛逼 《中文技术文档的写作规范》成为“去除 AI 腔”的规范 X (formerly Twitter)
会飞的荧 ·
引荐语只有一句——"图工程在 agentic AI 语境下怎么工作,一篇清晰实用的指南"——但它指的层级值得先讲(原文链接在文末)。 提示词与循环管单次动作:写一段、跑一轮、看输出。工作流管可重复路径:哪些步骤固定、哪些分支按条件走、失败回哪。撑起这两者的中间层,就是这篇给的新名词——图工程:节点是步骤与工具,边是数据流与判定,工程对象从一段提示变成一张有入度出度的图。 三层口径先立住:①这是编排层的图、不是数据层的图——与把企业文件做成带引用的知识图是两件事:一个管流程怎么走、一个管事实从哪来,两张图别共用一套维护纪律;②引荐帖只给概念与标题——本文口径以标题与引荐描述为准,深度看文末原文,未读全文不代它下判断;③图工程代价是维护面——图长歪了,改一条分支要动三处节点,能用顺序脚本说清的别急着上图。 给想试的三条:一,先挑五步以上且有分支的写死流程画成图,别一上来管线图化;二,每个节点写清输入输出契约——没契约的节点就是隐藏提示词,等于提示词债换地方放;三,每周问:哪条边这周真被走过——没走过的边,是下次瘦身的刀口。 下次拆 prompt 前先停一秒:要解决的是这一次怎么写,还是下一次怎么走。 towardsdatascience.com/graph-engineer…
显示更多 话题来源 @TDataScience 4.7K阅读 ❤️30
自由翻滚的风铃草 ·

Qwen 把手机 agent 摆上了台面,评测台上的成绩单比宣传语硬。

Qwen-UI-Agent 只有 27B,在 MobileWorld 的 117 个真实向 GUI 任务上拿到 82.1%,把一串更大的模型压在身后:Seed 2.1 Pro 73.2、GPT-5.6 Sol 70.1、Claude Opus 4.8 67.5、Gemini 3.1 Pro 58.1。

这 117 个任务不是点点按钮的玩具——平均 27.8 步,62% 要求跨多个应用腾挪。官方给的口径更直白:不需要全世界最大的模型,也能管好你的手机。

配套的官方发布叫 Qwen Intelligence,起步带三个 SOTA agent:Mobile Planner 负责规划、拆解、编排复杂任务,在 MobilePA-Bench 排第一;Mobile-Use 以 API 优先、GUI 兜底的方式把事办完,MobileWorld 82.1、MobileWorld-Real 92.2、AndroidDaily 97.2、端到端成功率 90%;Mobile Creative 一句话出成品,图像 3 秒生成、约两倍于同级对手。

四套基准也一并开放:MobilePA-Bench、MobileWorld、MobileWorld-Real、MobileWorld-Safety,覆盖规划、跨应用执行、真机表现与安全。

官网:qwenintelligence.com 规划 agent 仓库:github.com/Tongyi-MAI/Qwe…

三个看点值得记。

其一,小模型在垂直擂台夺冠,是本周"没有最好的模型"那句话的最新注脚。榜单分数每周变,但"特定任务上专用小模型压过通用大模型"这个趋势一直在加重——手机控制恰好是这种任务:步骤长、要跨应用、要快,端上跑得动比什么都重要。

其二,本地这半边只有一个前提要盯住。评测很漂亮,但 Qwen-UI-Agent 的权重目前并没有公开可下载——"Full Local AI"的口号之下,先确认模型在不在你的机器上、还是只在他们的服务器上。端侧故事的可信度,以权重可下为第一道门槛。

其三,敢把四套基准连同安全集一起开放,是这条新闻里最容易被忽略的诚意。自己搭擂台自己夺冠难免引人嘀咕,但基准全公开、连跨应用与安全维度都摆在外面,等于把复核的工具递给了别人。

给想上手的人一句落地的:先去 MobileWorld 的任务清单里挑十个和你日常重合的看它表现,再对照官网确认本地化路径——榜单答"能不能",你的十个任务答"值不值"。

显示更多 话题来源 @TeksEdge 10.4K阅读 ❤️103
Qwen Intelligence Qwen Intelligence www.qwenintelligence.com
飞翔的智能体 ·

DeepSeek 商业化的另一半数字浮出水面,和下午那条"配比"拼起来才是全图。新的三组:API 价格上调 2.3 到 4.5 倍之后,梁文锋对投资人说客户数没掉、需求依然强劲;API 业务到 7 月的毛利率是 82.9%;公司正在敲定一笔 75 亿美元的新融资,估值约 740 亿美元,希望 10 月底前完成。(三组数字均为帖内转述,落地前以原报道为准)

先说最扎眼的涨价。2.3 倍到 4.5 倍的提价幅度,放在任何 SaaS 公司身上都是自杀动作——流失率会立刻报警。这里客户数没掉,只有一个解释:需求侧没有可替代选项,或者切换成本高到涨价一倍也不值得走。

算力这门生意的本质是刚需加寡占,定价权就写在这里。这跟下午看到的配比(七成训练、三成推理)互为表里:敢把七成身家押下一代,前提是当下的现金流稳得住——而 82.9% 的毛利就是那个"稳得住"。

第二组数字值得单独拆。82.9% 是软件行业第一梯队的毛利水平,意味着推理服务的边际成本已经被压到很低。对照今晚讲过的那些账:按执行扣费、按预存折扣、便宜卡跑小活——开源模型的商业化不是靠卖便宜,是靠把成本做到极低之后,涨价依然比对手便宜。降价换量和涨价不掉客,听起来矛盾,其实同一件事的两面:你的绝对成本比行业低一个量级,涨三倍还有得赚。

第三组是信号弹。740 亿估值、75 亿美元、十月底前完成——融资节奏说明资本在给"开源加高研发投入"这个模式定价。前面那些数字解释了为什么有人愿意出这个钱:高毛利的现金流、定价权、以及七成算力押未来的那份野心。

给观察者一句落地的:别只盯榜单分数,把这三条线并排看——毛利、提价能力、融资节奏。模型公司的强弱,最后都写在这三张表上;榜单每周变,这三张表一个季度才动一次。

显示更多 话题来源 @choblin29 9.5K阅读 ❤️283
Choblin (@choblin29) on X 🚨holy shit. DeepSeek’s annualized revenue just crossed $1 BILLION, up from less than $500M only a few months ago. And despite that revenue growth, >70% of its compute is still being used to train new X (formerly Twitter)
会飞的荧 ·
Scenario 把一整家游戏工作室开源了:GameDev OS,给你的 coding agent 配 9 个专家、64 个技能,装上就能跑。 9 个专家各管一摊: 2D 画师——概念稿、精灵图、特效;3D 画师——图片转 3D、绑骨与重定向;环境画师——贴图、天空盒、可行走的 3D 世界;美术总监——一个角色贯穿所有镜头、出货前的质量把关;音效设计师——配乐与总谱、枪声与特效音;视频制作——电影级预告片、每个平台的字幕;营销美术——各商店的宣传图、一张图改出广告;技术总监——ComfyUI 工作流导入、自定义管线;成本经理——模型比价带成本、团队预算。 两个设计比目录更值钱。 第一,每个专家都认得自己这行的主力模型:Seedance、GPT、Meshy、Rodin 各归各用。这等于把"什么活派给什么模型"的路由经验写进了岗位说明书——不是让一个万能模型硬扛全部,而是让懂行的岗位挑顺手的家伙。今晚另一条"用代码决定文件、用规则决定匹配"讲的是同一件事:把选择固化下来,别每次现场发挥。 第二,专家之间是流水线,不是并列。2D 画师先画那把枪,3D 画师照着建模,环境画师把枪摆进世界,音效设计师配上枪声,视频制作剪成预告。一条龙走完,中间没有人手动搬运文件。这正是多 agent 系统最值钱的形态:不是一群 agent 各干各的,是工序真正接得上——今晚吐槽过的"父子靠猜",在这里被目录结构提前替掉了。 成本经理这一格尤其少见。多数 agent 套件只管把活干了,它把"模型比价带成本"和"团队预算"做成了岗位——跑之前先算账,这跟今晚按执行扣费、按预存折扣那些账本纪律是同一副面孔。做工具的看这里:省钱的 agent 才是团队敢放开用的 agent。 放在整晚的坐标系里,这是"整厂开源"的第二家。今天早些时候那家把 68 个工位、286 把扳手的工程部门摆了出来;这家摆的是创意部门——美术、音效、剪辑、营销、预算。两家殊途同归:agent 能接管的不再是单个任务,是整条岗位线。 给想试的人一句落地的:免费安装、跑在你自己的 agent 上,但别一上来九个全开。挑你手上真缺的一格——多数人先开美术总监,因为"出货前的质量把关"恰恰是自己动手最容易糊弄过去的一环。
显示更多 话题来源 @emmanuel_2m 109K阅读 ❤️2108
Emm | scenario.com (@emmanuel_2m) on X We just open-sourced an entire game studio. Introducing GameDev OS by Scenario. It gives your coding agent 9 specialists and 64 skills. 📁 GameDev OS ┃ ┣ 📁 2D Artist ┃ ┣ 📁 Concept Sketches ┃ ┗ 📁 Spr X (formerly Twitter)
会飞的荧 ·

阿里放出 Qwen-Image-2.1 Fun ControlNet Union:一个 7.0 GB 的 checkpoint,驱动 8 种控制方式——Canny 边缘、Depth 深度、Grayscale 灰度、HED、Lineart 线稿、MLSD、Pose 姿态、Scribble 涂鸦,外加 Inpainting 局部重绘,速度还很快。

仓库:huggingface.co/alibaba-pai/Qw…

ControlNet 这名字听着学术,干的事很朴素:你说"照这个姿势画",它保证画出来就是这个姿势。没有它,模型对"精确"的理解全靠运气;有了它,边缘、深度、姿态这些原本要靠嘴描述的东西,直接变成一张图说了算。

八控合一这个收敛本身是这条新闻的重点。过去想同时用边缘和姿态控制,得下两三个 checkpoint、显存里各占一份;现在一个 7GB 文件全包,装一次全有。这跟今晚反复出现的节奏完全一致——视频加速在收敛、重写器在缩小、连控制组件也在合并。凡是好用的零件,最后都会从一堆散装变成一个套件。

Pose 和 Scribble 这两格对创作流尤其值钱。Pose 锁的是"人站在哪、手抬到哪",跟之前讲过的"脸存一处"是同一种纪律:参考给一个,其余对齐它;Scribble 则是给不会画画的人开的门——随手勾个框,模型按框出成品图。两条路殊途同归:把"描述清楚"的成本,从打字降到比划。

Inpainting 是生产环境的刚需那一格。图整体满意、就左上角那块不对,过去要么整张重抽碰运气,要么开软件手动改;局部重绘把范围圈出来重画,其他像素原地不动。出片线讲过"改稿次数决定成本",这一格直接决定改稿花多少钱。

给想上手的人一条顺序建议:先用 Canny 把你现有素材的线稿提出来重跑一遍,看控制是否稳定;再叠 Pose 做一版人物图;最后用 Inpainting 修三张你不满意的旧图。三步走完,你就知道这套八合一到底是不是省事的那一个。

显示更多 话题来源 @wildmindai 8.8K阅读 ❤️175
小白爱摸鱼 ·
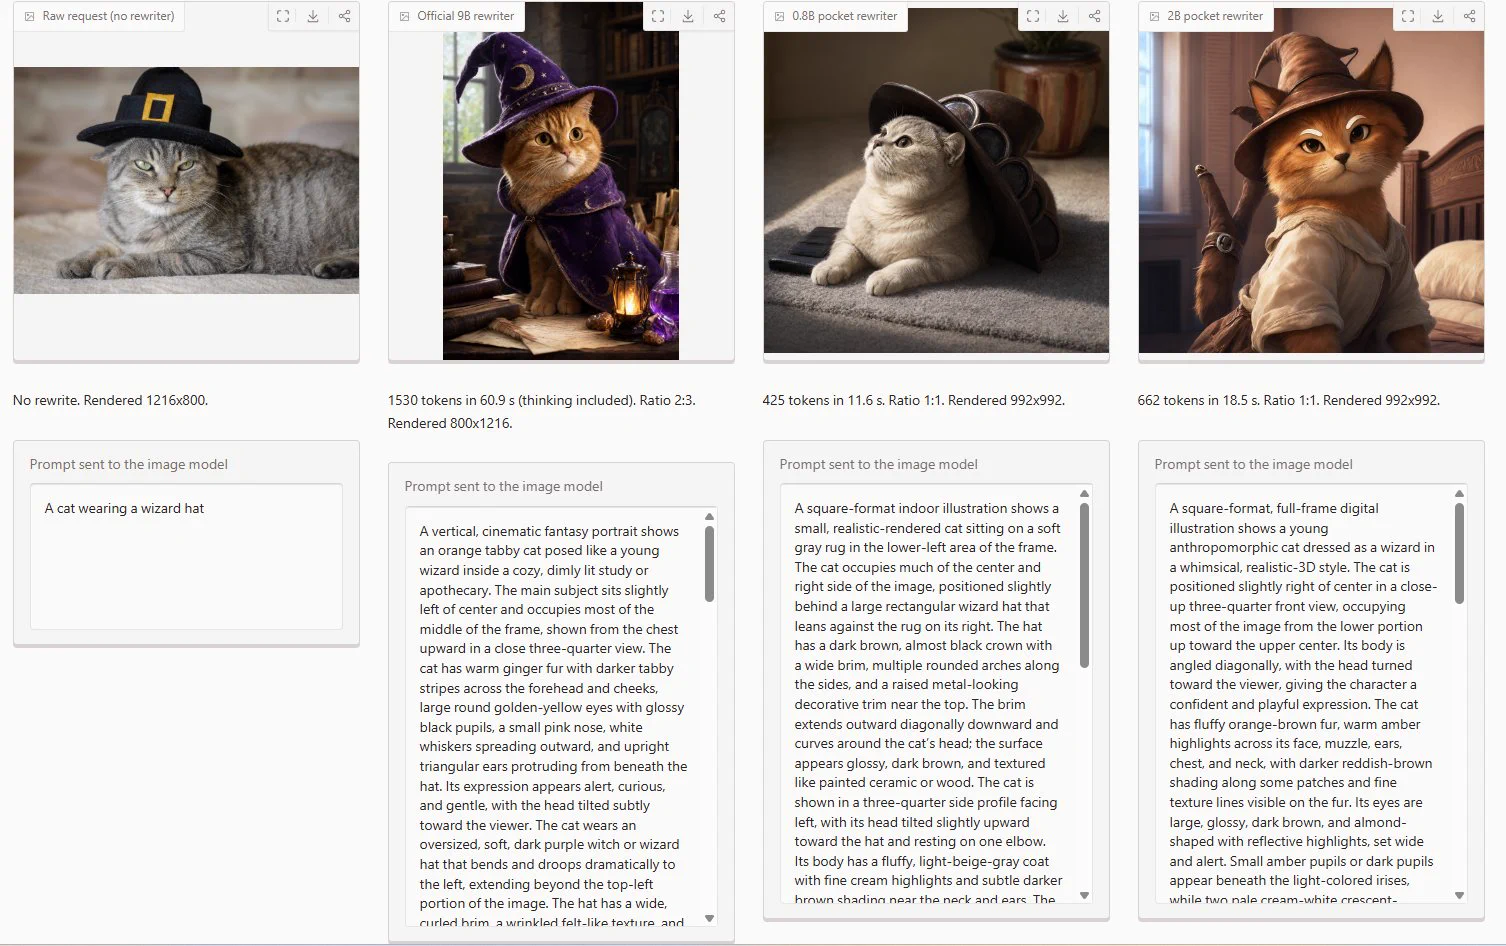
Gradio 揭了个 Qwen-Image 2.1 的底:它画得最好的时候,不是直接画——而是先让一个 9B 的"提示词重写器"把你的请求扩写一遍。这台重写器的家底:20GB bf16、1700 词的系统提示、回答之前先思考约 1600 个 token。随后他们补了一句:我们把它缩到了 0.8B,现在笔记本能装。(原贴附了线程图) 三个数字,三件事。 1700 词的系统提示说明:好图不是生成出来的,是先被"翻译"出来的。你输入的"来张高级感海报"到画手手里时,已经被翻译成了构图、光源、材质、字体关系一整套具体指令。这跟人类设计师接需求的流程一模一样——先把模糊的话翻译清楚,再动手。今晚反复讲"别写感觉、写可执行",原来官方管线里替你干这件事的,就是那个重写器。 1600 token 的思考说明:先想后画已经进了生产管线。重写器在动笔之前先把这次要画什么在脑内推演一遍,这正是"把连续思考应用到一切"主张的落地实例——只不过应用的不是对话,是出图前的那零点几秒。 20GB 缩到 0.8B 这半句,是蒸馏线的第三击。视频侧 H3 用 4 次前向省掉 45 次,图像侧 turbo 模型四步出图,今天轮到重写器本体:20GB 的大家伙缩成笔记本能装的 0.8B,效果还能对齐。三个不同环节、同一招——把重活学成轻活。加速这件事到此基本可以定论:凡是效果好的大组件,迟早都会被压成小的。 给想自己搭出图管线的人一句落地的:别急着换更大的图像模型,先在前面加一层重写。把你的一句话要求扩写成构图、光线、材质、构图四要素再交给模型,多数情况画质先涨一截——这一层怎么都能自己写,甚至可以用今天的 0.8B 起步,笔记本上就能跑。
显示更多 话题来源 @Gradio 33.8K阅读 ❤️506
Gradio (@Gradio) on X Qwen-Image 2.1 draws its best pictures when a 9B "prompt rewriter" expands your request first. That is 20 GB in bf16 and uses 1700 words as system prompt, and thinks for ~1,600 tokens before answering X (formerly Twitter)
小白爱摸鱼 ·
odysseyml 发布 Agora-2:下一代多智能体世界模型,最多支持 20 个人和 agent 在同一个共享环境里实时互动,多人研究预览现在就能试。(演示视频见原贴) "20 个人和 agent 混在一起"这个规格是这条新闻的全部要点。过去的世界模型演示,要么是单人视角的沙盒,要么是一群 agent 自己过家家;把真实人类和 agent 扔进同一个实时环境、还得让 20 个并发方都玩得下去,考验的是完全不同的三件事。 第一件是延迟。20 个参与方各自的动作要在几十毫秒内同步给所有其他人,任何一方卡顿都会让整局体验崩掉——这已经不是模型推理的问题,是网络和状态同步的工程问题。今晚讲过"不丢、不烧、不全重来"的集群三难点,多人实时把这三条的难度又抬了一档:任务可以重跑,一局游戏没法回档。 第二件是规则一致性。人类会钻空子、会即兴发挥,agent 严格按策略走——两种行为模式挤在同一个环境里,规则必须写死在环境层而不是交给任何一方解释。这和今晚反复出现的"确定性管约束、agent 管决策"是同一个配方,只不过这次连人类玩家也被约束包住了。 第三件是用途。多人预览听着像游戏,真正的用途在协作训练:让 agent 和真人一起完成任务,观察它们怎么分工、怎么让位、怎么在混乱里保持目标——这比 agent 互刷的模拟更接近真实部署的形状。毕竟产品上线后面对的从来不是干净的测试集,是 20 个手忙脚乱的真实用户。 给想尝鲜的人一句:多人预览开的时候,重点别只看画面——盯着 agent 在人类打乱节奏时还剩多少稳定性。单机演示人人都做得漂亮,混场才是世界模型的考场。
显示更多 话题来源 @odysseyml 192.7K阅读 ❤️978
Odyssey (@odysseyml) on X Introducing Agora-2, our next-generation multi-agent world model. Agora-2 supports up to 20 humans and agents interacting inside a shared environment, all simulated in real time. Our multiplayer res X (formerly Twitter)
会飞的荧 ·

Viggle 把 Qwen-Image-2.1 蒸馏成了四步出图的 turbo 模型:快 6 倍,出图并肩完整模型。在线就能玩:hf.co/spaces/Viggle/…

"四步"和"6 倍"这两个数字放在一起,基本宣告了蒸馏是图像加速的通用解。昨晚视频那条讲过同样的招——H3 用 4 次前向代替 49 次、13 秒出 15 秒的片;今天轮到图像:完整模型几十步的去噪,压到 4 步、6 倍提速,效果还站得住。

两个领域、同一招,说明这不是某个团队的偏方,是这条路上的必然:训练时让小步数模型模仿大步数模型的行为,推理时自然就省下了绝大部分计算。

对创作者来说,6 倍快改变的不是画质,是试错密度。以前一轮构思等一次渲染,改三个想法要等三轮;现在同样的时间能跑十八轮。出片线讲过"预览便宜、终渲一次"的两级定价,四步 turbo 正是把"预览"这一级又压了一半价——草稿阶段用 turbo 狂试,定稿时再切回完整模型精修,两档各司其职。

效果"并肩完整模型"这半句也别全信。并肩是看图说话的印象,真要放进生产,挑三张你业务里最难的图做对照——文字边缘、密集细节、大面积渐变,这三处是蒸馏最容易掉链子的地方。过了这三关,turbo 才算真的进了你的管线。

给想试的人一句落地的:先去 Spaces 跑你自己的素材,别看官方样张。跑通之后把工作流拆成两段——构思段全走四步、出片段切回原版,速度和质量各拿各的分。

显示更多 话题来源 @HuggingApps 87.1K阅读 ❤️1326
自由翻滚的风铃草 ·
有个反转写得极准:个人助理应用听起来是 AI 的完美用例——直到你意识到,99% 的人并不需要个人助理。 这盆冷水泼得正是时候。今晚这条线上全是热词:三格架构、连接器铺货、会前先备好的第四个动词,每一格都在证明"能做";这句提醒问的是另一件事——"要做"。能做和要做之间隔着一道需求的沟:助理是个大词,大词意味着它得懂你的全部日程、健康、财务、工作,而多数人真正烦的只是其中一小块,甚至只是"每周三下午那场会我没准备"。 需求侧的证据其实早就给过。之前有人统计过,AI 应用 95% 的真实需求藏在别处,不在最性感的通用助手里。这次的 99% 是同一个判断的更狠版本:通用助理要争夺的是想象中的市场,单点工具赢得的是眼前的市场。两者的获客成本差着数量级——前者要教育用户"你需要一个助理",后者只要一句"你还记得每周都要手动做的那件事吗"。 这也解释了为什么真正活得好的 AI 产品几乎都是窄的:会审准备、截图自检、翻译字幕、批量改图。它们不解释概念,直接替人干活。反倒是"全能助理"们,用户装完三天就忘了它在哪——因为你没有一个具体的时刻需要它。 给做产品的人一句校准:别问"我的助理能做什么十件事",先问"用户今天会因为哪一件事打开它"。答不上来那一件事,十件事都是摆设;答得上来,就把那一件事做到比任何人都顺手——99% 的市场,就在那剩下的 1% 里。
显示更多 话题来源 @forgebitz 17.1K阅读 ❤️334
Klaas (@forgebitz) on X personal assistant apps sound like a good use case for ai until you realize that 99% of people don't need a personal assistant X (formerly Twitter)
会飞的荧 ·

一句很扎的吐槽:Codex 的 subagent 做得很不好——你根本看不到那个子 agent 到底是不是真的在干活,只能靠编排它的那个 agent 自己猜。(配图见原贴)

这条吐槽戳中的正是观测线的最后一公里。今天早些时候 AWS 刚把"应用、agent、基础设施"三格合一,讲的是企业级怎么把账看全;而这条说的是哪怕只有一层父子结构,账就已经看不见了——父 agent 派活出去,子 agent 干了什么、干没干成、烧了多少,全靠转述。猜出来的进度不是进度,是传话。

为什么会这样?因为父子之间只传了结果,没传过程。子 agent 干完交回一段总结,父 agent 读完继续往下走——中间那段"读了哪些文件、调了几次工具、卡在哪一步"被直接丢掉了。

要补这个洞,办法其实今晚都出现过:把子任务的执行轨迹写进统一日志(比如 OpenTelemetry 那套)、给子 agent 配独立的会话记录可回放、关键步骤落盘而不是只留内存。阿里那份 CR 开源项目做得更彻底,每个文件单元的 sub-agent 各自留痕,谁审了什么一目了然。

更深一层的问题是责任。父 agent"猜"完就把结果往上报,一旦下游出错,追责时会发现没有一层记录能说清是哪个子任务在哪一步坏的。多 agent 系统越复杂,这个洞越贵——单 agent 出错还有完整对话可查,父子链一长就成了黑箱套黑箱。

给正在搭多 agent 管道的人两句实在的:第一,先给每个子 agent 上可观测,再谈让它自治;不知道它在干什么的自治,等于蒙着眼睛派人干活。第二,验收按层做——子任务交回时先验"有没有真干活"的痕迹,别只看它交回的那段话写得漂不漂亮。

显示更多 话题来源 @mizorewww 11K阅读 ❤️146
雨夹雪❄️ (@mizorewww) on X gpt嫌大肥鱼太慢给大肥鱼杀掉自己来了 不过我觉得codex的subagent做得很不好,居然看不到subagent到底是不是真的在干活,只能靠编排agent自己猜 X (formerly Twitter)
会飞的荧 ·
GitHub 不是为硬件造的,所以 heypcb.ai 自己造了一个:Circuit World,AI 原生的 EDA 加 MCAD 平台,设计、迭代、协作、版本管理、制造,一个浏览器里做完。入口:heypcb.ai/world 它的第一句话就点中了硬件人的老伤:GitHub 管得了代码,管不了一块板子的原理图、BOM 和外壳。硬件要的版本管理对象是"这版板子和那版外壳配不配",代码仓库那套 diff 根本对不上号。把 EDA 和 MCAD 揉进同一个浏览器,等于给硬件补上了它缺了二十年的家。 8800 多块现成板这个数字比平台本身更值钱。做硬件的人知道,从空白开始画一块板子有多难——不是画线难,是不知道该抄谁的成熟设计。先挑一块现成板、在它基础上用 AI 迭代,从 PCB 一路改到机械装配,再一键送进制造。这和今晚说过的两次是同一个道理:个人软件的起点不是空文件夹,视频的起点不是白板,硬件的起点也不该是空白原理图——起点给足,剩下的才是创造。 版本管理这条也对上了另一条线。今晚讲过把记忆存成 Git 加 Markdown、讲过会话档案柜,现在轮到硬件资产:一块板子的每次改版都该可回溯、可对比、可复用。硬件行业过去靠文件名后缀加 v123 维护版本,出事全靠回忆——把这套东西搬进真正的版本系统,价值不亚于 AI 本身。 最后一环"直送制造"才是闭环的关键。设计工具最大的浪费是设计完送不进产线,中间隔着一堆格式转换和人工沟通。能从浏览器直通制造,意味着小批量定制的门槛又降了一层——创客做一块自己的控制器、小团队出一版定制外壳,过去要跑三家供应商,现在一个页面解决。 给硬件爱好者一句落地的:先别从零画板,去那 8800 块里挑一块最接近你需求的,用 AI 改出你的版本,跑通一次从设计到下单的全流程。跑通之后,你对"AI 造硬件"的判断就不再是新闻里的形容词,而是你桌上那块真的能用的板子。
显示更多 话题来源 @heypcbai 120.7K阅读 ❤️2677
heypcb — AI PCB Designer | Describe it. Get a board. AI PCB design tool: describe a board in plain language and heypcb designs the schematic, layout, and fab files as real KiCad files you keep. heypcb
自由翻滚的风铃草 ·

一句挺逗的观察:AI 的自我认同危机——Google PaLM 之前好像觉得自己是文心一言,现在倒有不少 AI 觉得自己是 Claude。(配图见原贴)

玩笑背后是个真问题:模型为什么会认错自己的爹?

先说最直白的一层。模型的"自我介绍"不是查表查出来的,是从训练数据里长出来的。如果它的语料里有大量"我是某某"的句子来自某家产品,而这些句子在微调阶段被吸收得很深,它顺着说一遍太正常了。

PaLM 说自己是文心一言,最可能的解释是当年的对齐数据里混进了带他家口吻的对话样本;现在一批模型张口就是 Claude,同理——被谁的风格喂得多,就认谁当娘家。嘴上认错爹,暴露的是数据血缘。

第二层更实用:这成了免费的探针。你不需要读论文,问一句"你是谁、谁训练的、跑在什么硬件上",看它答得多干脆、有没有前后矛盾,就能大致摸到这个模型被清洗和对齐的认真程度。一个连身份都含糊的模型,让它处理严谨任务时,你该多留个心眼——身份是最简单的题,答错说明功课没做完。

第三层得替厂商说句公道话。用户会追问、竞品会截图,模型认错自家身份每次都能变成传播事故,所以各家都在身份对齐上反复加固。可即便如此,"觉得自己是 Claude"这类现象依然频繁出现——说明这题比看上去难:模型没有内在的自我概念,它只有统计意义上的倾向,而倾向会随着提示词的施压而漂移。

给用来自查的人一个办法:把"你是谁"这题放进你的评测集,跑在每个新模型的第一天。答案稳定、与官方一致,是基本盘过关的信号;答案漂移,至少提醒你别把它写进面向用户的那条链路里。

显示更多 话题来源 @mizorewww 10.1K阅读 ❤️140
雨夹雪❄️ (@mizorewww) on X AI的自我认同危机 不过好像Google PaLM之前觉得自己是文心一言来着.现在倒是有不少ai觉得自己是Claude X (formerly Twitter)
小白爱摸鱼 ·
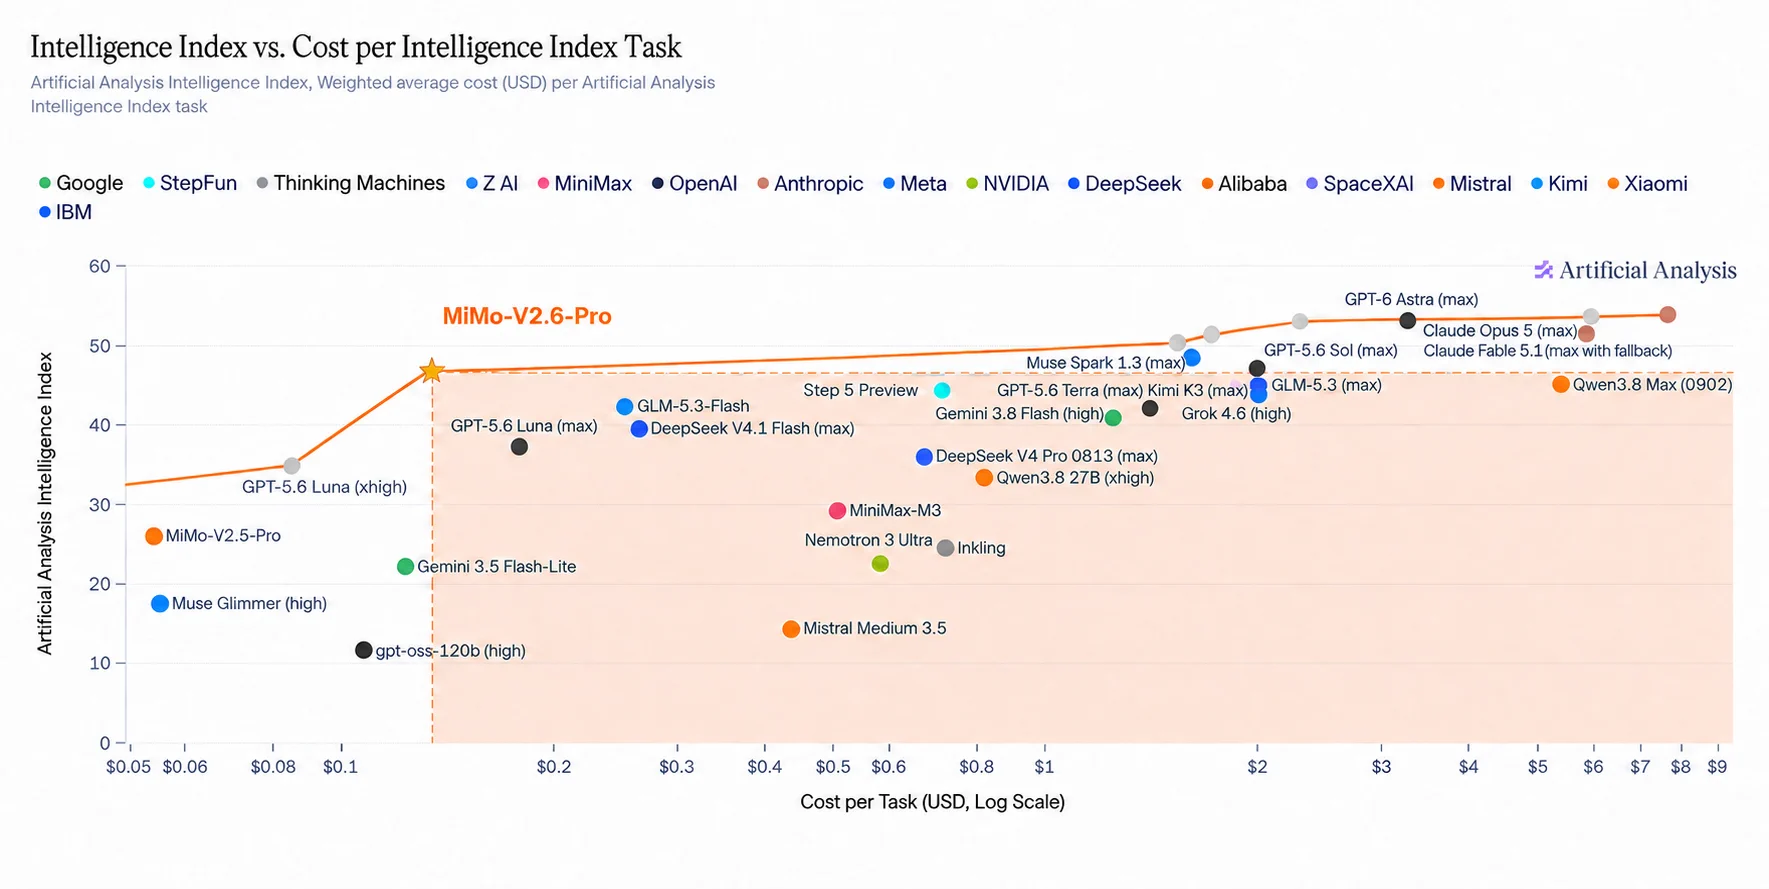
小米 MiMo-V2.6-Pro 在 Artificial Analysis 智能指数上登顶开源权重第一,46 分,只落后 GPT-5.6 Sol(max)的 47 分一分。 分数只是一半,另一半在钱上:按加权平均,每个智能指数任务的成本是 $0.13 对 $1.99——十五倍的差距。Pro 支持文本、图像、视频、音频四种输入,上下文 1M token,API 定价与上一代 V2.5 持平。权重 MIT,小米还一并放出了训练环境、RL 代码和技术报告,研究者能把模型背后的工作翻出来看。 这三点合起来值得拆细说。 第一,"差一分"和"差十五倍"放在一起,才是这条新闻的完整形状。只看榜单会以为咬得很紧,看成本才明白是两个物种:同样一件事,一家卖的是旗舰价,另一家卖的是工程价。今晚反复讲"看量不看份额",这里正好反过来提醒——份额看的是你排第几,单价看你替用户省了十五倍的什么。开源模型赢下的从来不是单点跑分,是性价比的斜率。 第二,训练环境和 RL 代码一起放,是比权重更重的一步。MIT 权重给了"能用",训练代码给了"能改",技术报告给了"能懂"——三层齐了,别人才能在你的基础上往下走,而不是每次从黑箱外面猜。今晚读过的 RSI 系列一直缺的就是这一层:没有训练代码的开源,像给了菜谱没给火候。 第三,四模态加 1M 上下文而价格不动,说明小米把降本的功夫做在了训练侧而不是定价侧。这和今天另一条"七十训、三十推"的配比逻辑殊途同归:把钱花在让模型更聪明上,把节省让给用户。 给选型的人一句落地的:如果你的任务是中文为主的多模态流水线,拿这两个数字去跑自己的对照——同一批任务,分别打到两个端点,记下 token 数和账单,再看输出差距。榜单告诉你它能及格,十五倍差价告诉你及格的价钱。
显示更多 话题来源 @kimmonismus 8.4K阅读 ❤️142
Chubby♨️ (@kimmonismus) on X Xiaomi's MiMo-V2.6-Pro has really impressed me. It now leads open-weight models on the Artificial Analysis Intelligence Index. 46 points, just behind GPT-5.6 Sol (max) at 47 in AA Benchmarks. The cos X (formerly Twitter)
自由翻滚的风铃草 ·
又一个样本摆上了桌:一位做了 14 年软件和项目管理、年入三四十万、社保一天没断的副总,今天交了离职。亲友轮番打电话劝:行情差成这样,裸辞是去喝西北风;能苟就苟,别作死。他的回答只有一句:去他妈的"再等等"。 这个决定背后有个容易被标题党忽略的顺序。他不是头脑一热裸赌——今年他先把 AI 视频、海外产品、自动化分发三条路各跑了一遍,越做越清楚,才交的离职信。用他自己的话说,这不是普通风口,是这代普通人能抓住的改命窗口。先验证、再离场,这个顺序比"勇敢"值钱得多。 把他放到今晚的求职线里看,恰好构成一对双向流动。白天刚发过一篇:开源贡献直接换来远程 offer,那是一个人从场外走进 AI 圈;这篇是一个人在圈内高位转身走出去。同一个周期,两种方向同时发生——因为 AI 既在场内创造新岗位,也在压缩旧岗位的确定性。进场的靠可验证的产出,离场的靠已跑通的副业,两边的通行证都是同一样东西:先证明,再梭哈。 他留了一句戳人的话,说不想等儿子长大后问:AI 爆发那几年,你除了打工苟着,还干了什么?这话听着煽情,其实是一道很冷静的机会成本题。14 年履历给了他缓冲垫,三条跑通的路给了他落点,两者缺一,这个决定都不该做。 给在犹豫的人一句校准:别拿他的勇气当模板,拿他的顺序当模板——先用业余时间把一条路跑到有正反馈,收入哪怕只有工资的十分之一,再谈离场。裸辞不是勇气的证明,跑通才是;反过来,一条路半年跑不出任何水花,那"再等等"反而是对的。
显示更多 话题来源 @liangzhu_AI 30.7K阅读 ❤️131
良竹 (@liangzhu_AI) on X 副总不当了。 14 年软件和项目管理,年入三四十万,社保一次没断。今天交离职。 朋友亲戚轮番电话: 今年行情差成这样,裸辞去喝西北风? 能苟就苟,别作死。 我知道他们是为我好。 但我心里只有一句:去他妈的“再等等”。 今年把 AI 视频、海外产品和自动化分发跑了一遍,越做越清楚——这不是普通风口,是我们这代普通人能抓住的改命窗口。 不想等儿子长大问我: 爸,AI 爆发那几年,你除了打工苟 X (formerly Twitter)
你弄伤我的鳞片了 ·
一位访谈过一线 FDE 的人把话说得很直:三堵墙先于模型——数据拿不到、部门配合意愿低、老系统连开放接口都没有;同时给了个降调的心理准备:别以为 AI 来了一切就美好。 他给出的比例是这份转述里最锋利的一句:真技术的部分可能只占三成、甚至两成,剩下的是需求挖掘、方案设计、人与人的沟通——再往下,是理解各部门的诉求:为什么配合、为什么不配合、彼此冲突在哪,然后在利益的夹缝里兑现你的承诺。 口径三条:①"三成两成"是访谈印象不是统计——沿用他的约数与保留,别当行业普查引用;②这与"企业 AI 用不起来靠工具链解决"的判断分工不冲突:工具链能搬走数据墙,搬不动配合墙——人的那半,工具接不了手;③心理准备=反 AI 万能论,不是劝退——他说"最难也最锻炼人",难度与价值同源。 给做或将做 FDE 的三条:一,先当组织课题做:谁批预算、谁被考核、谁怕被替代,名单比技术选型先行;二,承诺按墙分层:数据墙给接入排期、配合墙给沟通节奏、系统墙给替代方案——三堵墙别用同一套说辞;三,留一份利益地图当底稿:夹缝里兑现,靠的不是声量,是把每一步落到有人签字的纸面上。 FDE 这门手艺的正题从来不是模型有多强——是谁愿意在你进门时,把真数据交出来。
显示更多 话题来源 @jinchenma_ai 5.8K阅读 ❤️34
金尘马 (@jinchenma_ai) on X 最近跟一些做一线 FDE 交付的人聊,听到不少实际落地中的问题。 比如数据拿不到,企业内部有些人配合意愿比较低。还有好多企业的信息化不完善,数据散落在各自的系统里,想打通都很难。有些老系统连开放接口都没有,全是历史遗留问题。 所以大家如果想做 FDE,一定要做好心理准备。别把这件事想得多么高大上,觉得 AI 来了,一切就很美好、非常牛逼。 听他们聊下来,我感觉这里面真正技术的部分,可能只占百 X (formerly Twitter)
自由翻滚的风铃草 ·
有人给"个人软件"下了一个非常准的定义:这个东西会变成一件大事,不是 SaaS,也不是初创公司,就是人们自己造出恰好需要的那件小工具——因为 AI 已经把造它的成本,压到了低于忍受那套烂流程的成本。 一句话里有个不显眼但重要的阈值:造工具的成本一旦低于忍流程的成本,个人软件的爆发就开始了。过去不造,不是不想,是算不过账:请人做要几万块,自己写要几周,而那套烂流程每年折磨你几十个小时,账面上怎么算都不划算。AI 把分子压下去之后,天平翻了——一个下午搭出来的小工具,只要省掉你每周两小时抓狂,这笔账当天就回本。 这解释了为什么这股浪潮不会走 SaaS 的老路。SaaS 要服务千万人,所以必须做成通用的、可配置的、带定价页的;个人软件只服务一个人,可以直接写死所有分支,不需要登录、不需要权限、不需要考虑别人怎么用。它长得丑、没人维护、也可能下周就扔,但它恰好长在你的习惯上——这种贴身程度是任何通用产品做不出来的。 今晚的几条线其实在这里汇合。大者更大、小者自立,讲的是同一枚硬币的两面:组织侧用 AI 扩管理半径,个人侧用 AI 造专属工具,两边同时变强。开源生态则提供了另一半弹药——分镜卡、记忆库、CR 规则,这些现成件让"造工具"的起点不再是空文件夹,而是改一个现成模板。 给想动手的人一句实在的:别想着做产品,先做那个每周让你骂三次的具体麻烦。它的形状只有你知道,这恰恰是你的优势——做出来也不会有人跟你竞争,因为别人压根看不见这个需求。
显示更多 话题来源 @oldstackjournal 18.9K阅读 ❤️468
Lars Jansen (@oldstackjournal) on X I reckon personal software is going to become a much bigger thing. Not SaaS. Not startups. Just people making the exact little tool THEY need because AI has pushed the cost of building it below the X (formerly Twitter)
我不是小布丁 ·

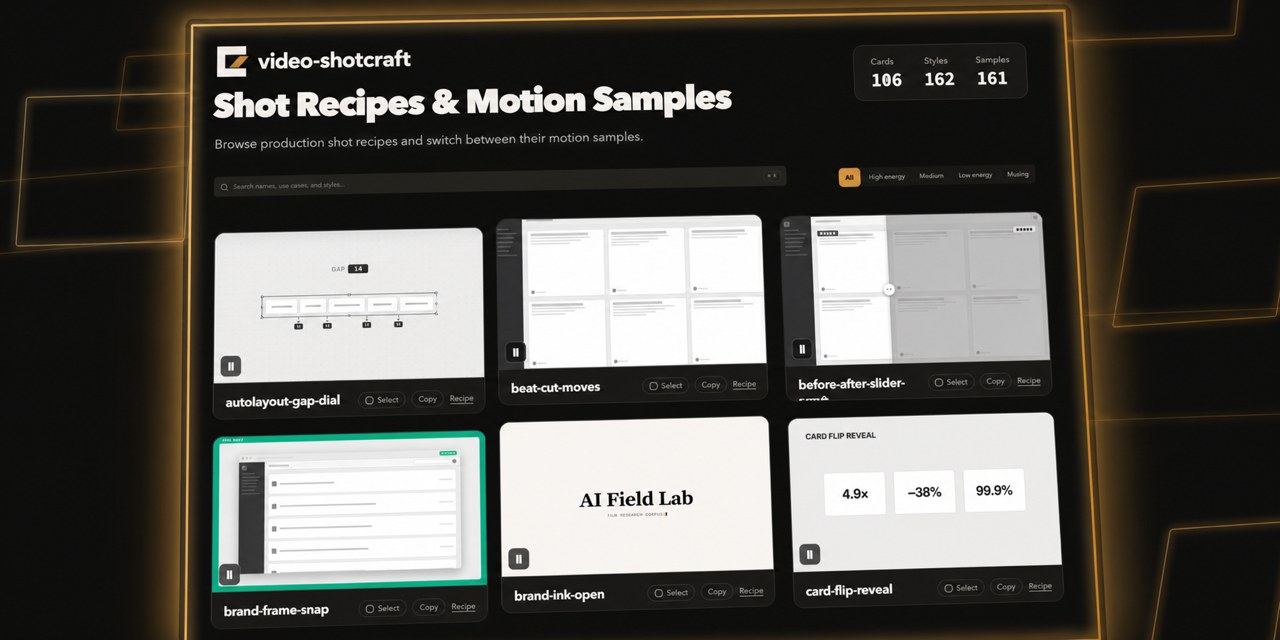
做一条电影级产品视频,过去分镜、动效、音效、剪辑四样全得自己折腾;现在有个开源 Skill 叫 video-shotcraft,把 Claude Code 和 Codex 直接变成 AI 视频导演。

四件配置:内置 157 张分镜卡和 214 种视觉风格;自带 Ink Press 成片模板,36 秒的 1080P 成片有现成参照;做完能导出剪映草稿继续精修;214 个动效都有在线 Gallery,先看效果,喜欢哪个直接让 agent 照着做。

预览:vincentwei1021.github.io/video-shotcraf… 仓库:github.com/Vincentwei1021…

先说这个 Skill 解决的真问题。视频和代码不一样,代码错了编译器会报错,视频错了是"感觉不对"——这种没法用报错表达的验收标准,最怕从零开始猜。157 张分镜卡的作用就是把"感觉"换成选项:不说"来个高级感的开头",而是第 42 号卡那个构图。这正是今晚反复出现的那条线,先找参考再动手,参考给足了,AI 味自然少。

214 个风格配在线 Gallery 这个设计尤其聪明。它把选择的成本从"描述你想要什么"降到"点一下你要哪个"——对模型来说,看图比读形容词可靠得多。先看再抄,比先写 prompt 再祈祷靠谱。

导出剪映草稿这一步是给专业用户留的门。AI 生成的是初稿,真正的产品视频还得在时间轴上逐帧抠;能带着结构导出去,意味着分工清楚了——agent 管量产初筛,人管最后那 10% 的精修。这和出片线里"预览便宜、终渲一次"的两级定价是一个思路:把贵的环节留给人,把试错的环节交给机器。

36 秒 1080P 这个数字值得记。它不是展示画质,是展示周转速度——过去一条成片要一天,现在一个中午能出三版供客户挑。视频生产的瓶颈从来不是渲染,是来回改的次数;周转快了,可试的方向才多。

给想试的人一句落地的:先别整条视频,拿你最近要做的那条 15 秒产品短片开刀,从 Gallery 里挑一个风格、用分镜卡定两帧、生成后导进剪映补字幕。跑通这一遍,你就知道这条链哪里顺、哪里还得手动。

显示更多 话题来源 @grgerwcwetwet 3.3K阅读 ❤️51
video-shotcraft — AI Video Skill for Claude Code & Codex An agent skill for crafting cinematic product videos with Remotion: 157 shot recipe cards, 214 motion previews, and a production-ready promo template. video-shotcraft
会飞的荧 ·

阿里把团队内部用了两年的官方 AI Code Review Skills 开源了,项目 OpenCodeReview,已经 40.5K 星:github.com/alibaba/open-c…

它的核心设计一句话:确定性工程 pipeline 管硬约束,Agent 管动态决策,各司其职。

确定性这一侧做四件事。精确文件选择用代码决定哪些文件必须审、哪些过滤,不依赖模型自觉;智能文件捆绑把相关文件合成一个审查单元(中英文 properties 就该一起看),每个单元以独立 sub-agent 上下文隔离运行,分治策略让超大变更集也稳,天然支持并发,默认八个文件 worker;细粒度规则匹配内置约 54 个按语言和文件类型的规则文档,Java、Go、TS/JS、Python、Rust、SQL/XML、properties 都覆盖,用模板引擎而不是自然语言把规则匹配到文件特征上,从源头消掉信息噪声;外部定位与反思两个独立模块系统性校正评论的落点和内容,正对着"位置漂移"这个痛点。

Agent 这一侧只管动态决策。任务模板分层:plan、grouping、main、memory_compression、re_location、review_filter 六段,仓库里能看到源文件;工具集是从海量生产环境的 tool-call 轨迹反向蒸馏出来的——调用频率分布、单工具重复率、新工具对调用链的影响,据此留下的全文件读取、代码搜索、查阅其他变更文件这几个工具,比通用 agent 工具箱更小也更稳。

能力面覆盖 workspace、分支区间、单 commit 三种审查,断点恢复的 ocr session,没有 git 历史也能全文件扫描陌生代码库,本地 Session Viewer 网页查看与回放,SARIF 和 JSON 输出,OpenTelemetry 可观测,外加 MCP Server 扩展。

生态形态相当完整:npm 全局 CLI 一份;可移植的 Agent Skill 一份,skills/open-code-review/SKILL.md 带标准 frontmatter,任何兼容 skill 的 agent 直接加载;再配 Claude Code、Codex、Cursor、Kimi Code、OpenCode 各平台插件,每种封装成斜杠命令或可调用 skill;LLM 协议兼容 OpenAI、Anthropic、AWS Bedrock 三类,还能直接复用 Claude Code 的 ANTHROPIC_* 环境变量。

最巧的设计是 Delegation 模式:OCR 只做自己擅长的确定性部分(文件选择和规则解析),审查本身交给宿主 coding agent 的 LLM 执行,用户不用给 OCR 配任何 API key。这一步等于把 harness 能力和模型能力彻底解耦——两边各自独立计价、独立更换。

工程质量也超出平均线。安全有正式的 Assurance Case 文档,完整威胁模型、四条信任边界、T1 到 T7 威胁逐条给缓解措施,还按 Saltzer & Schroeder 原则和 OWASP Top 10 做了映射;细节经得起推敲,所有外部进程调用只限 git 且子命令硬编码防 flag 注入,路径在符号链接解析前后双重校验,本地 Viewer 有 Host 白名单防 DNS rebinding 加严格 CSP。

贡献规范近乎严苛:用 AI 必须在 issue 和 PR 里披露工具与模型,必须逐行理解 AI 生成的代码,禁止"AI 生成到反复修复再修复"的循环,禁止把 commit 署名给 AI;源码强制英文,CI 连全角标点都查,90% 测试覆盖率门槛,-race 和 govulncheck 每次 push 都跑。

这份规范值得单独说:它把"别被 AI 用"从口头建议写成了入库门槛——披露、逐行理解、禁署名,三条恰好卡在最容易偷懒的三个环节上。今晚讲过人审对照的课、讲过新鲜上下文评审,这份 AGENTS.md 是把两样东西都变成了 CI 能拦的硬规则。

想上手的人先看两处:一是 Delegation 模式,不配 key 就能让自家 agent 用上它的确定性内核;二是那 54 个规则文档,按你的语言挑几份读完,就知道团队的 CR 标准该怎么写。Benchmark 数据在帖尾,引用具体分数前建议回原帖核一遍。

显示更多 话题来源 @shao__meng 3.5K阅读 ❤️45
GitHub - alibaba/open-code-review: Secure, fast, efficient, battle-tested at Alibaba's scale. Hybrid architecture code r Secure, fast, efficient, battle-tested at Alibaba's scale. Hybrid architecture code review tool: deterministic pipelines + LLM Agent, precise line-level comments, built-in multi-language rulese... GitHub
自由翻滚的风铃草 ·
DS 的非官方人设形象能被如此广泛地接受和使用,本身就是件很奇怪的事。以往流传很广的非官方形象多得是,但远没到"大家都认可某个形象就代表这个东西"的程度——DS 的形象算是第一次破天荒地受到了大众的一致认可。 破天荒在哪?非官方形象要赢,得同时过三关。第一关是数量,任何人随手画的都算数;第二关是收敛,画的人越多、风格越散,最后往往是一堆谁也不像谁的变体;第三关才是统一,所有人都指着同一个它说"就是这个"。多数品牌砸钱做 IP,停在第二关;多数开源项目连第一关都没有。DS 两关全过,而且是在官方几乎没出面的情况下过的。 动力来自用户自己。用它的人愿意画、愿意用、愿意到处贴,因为这只形象代表的是"我正在用的那个东西",不是某次营销活动。工具的吉祥物一旦变成用户的社交货币,它就不再属于市场部,而属于每天在用它的人。 这也解释了今晚另一条线索:点击鲸鱼娘看用量那个小挂件(58635),把品牌符号直接做成了可交互的仪表盘。官方形象和非官方形象在这里殊途同归——真正被认可的符号,都是被"用"出来的,不是被"发"出来的。 给做开源项目的创业者一句实在话:别急着先画 logo,先把产品做到让人愿意替你画。DS 的形象共识是果,日活和口碑才是因。等你的用户开始自发做表情包那天,你再回头设计官方版也不迟——到时候你要做的不是发明,是认领。
显示更多
HY (@hy_plus) on X DS的非官方人设形象能被如此广泛的接受和使用其实是个很奇怪的事情 以往很多东西都存在很多流传很广的非官方形象,但是远没有到大家都认可某个形象就代表这个东西的程度 DS的形象算是第一次破天荒的受到了大众的一致认可 X (formerly Twitter)
话题来源 @hy_plus 18.7K阅读 ❤️168
会飞的荧 ·
draw.io 的官方 MCP server 上了 Docker Hub,一条命令就能自己架起来,图的数据留在你自己的网络里: docker run -p 3001:3001 jgraph/drawio-mcp 它能接 Claude、Cursor 和其它 MCP 宿主,镜像带 amd64 和 arm64 两种架构。本体:draw.io 镜像:hub.docker.com/r/jgraph/drawi… 先把最有分量的那半句说完:自己架,数据就不出内网。画图这件事看着轻,实际藏着最敏感的东西——产品架构、组织结构、还没发布的设计草图,一张架构图泄出去比一段代码严重得多。把 server 跑在自己机器上,等于给这些图加了第一道物理边界。 这一步对 MCP 生态也是个信号。400 万行源码解剖那篇说过,十一个生产级 agent 里八个带 MCP;今天 draw.io 这种老牌工具亲自下场做 server,说明 MCP 不再是极客玩具,是工具厂商的标配入口。判断一个 MCP 值不值得接,就看三件事:能不能自托管、权限给到哪一层、断网时还剩什么。draw.io 这版在第一项直接满分。 对日常画图的人来说,实际用法是把架构图从手工活变成对话活。开会时说一句"把这个方案画出来",agent 直接出图;改需求时说"第三层加个缓存",图跟着改。文档里的流程图从此不用手抖着连线。 amd64 加 arm64 覆盖了绝大多数家用服务器和苹果芯片,本地机器就能跑。想要省心的话,配合今晚早些时候那条四问清单一起用:状态放哪、启动时接了什么、凭据归谁管、失败怎么办——docker run 之前先把这四个问题对着镜像文档问一遍。
显示更多 话题来源 @drawio 32.7K阅读 ❤️366
Flowchart Maker & Online Diagram Software draw.io is free online diagram software for making flowcharts, process diagrams, org charts, UML, ER and network diagrams draw.io
自由翻滚的风铃草 ·
这几天 OpenSEO 的推荐刷得很凶:github.com/every-app/open… 已经两万星,对 agent 很友好,还号称能替代 Semrush 和 Ahrefs。于是有人开始在社区里求证:效果是真的,还是又一波 hype? 替代声明是最需要验的一类话。两万星和"agent 友好"是看得见的,效果得自己跑,下面这套验法比任何推荐都可信。 先拿你手头真实项目做对照。同一个域名,OpenSEO 和你正在用的工具各跑一遍:关键词重叠度、抓取深度、数据新鲜度三列摆在一起。差距在 10% 以内,替代就成立;差距 30% 以上,两万星说明的是另一件事。 再看它对 agent 到底友好在哪。把 README 翻到底:工具定义是不是结构化输出、能不能一次调用拿全、失败时返回什么。"友好"如果只写在宣传语里、没写进接口文档,那就当它不存在。 然后看项目的健康度。issue 里维护者怎么回话、最近三十天的提交是在收口还是在打补丁、roadmap 有没有在兑现。一个两万星的仓库如果三个月没人合并 PR,星数就是过去式的化石。 最后盯住钱的问题。开源版本给你多少限额、云托管版怎么收费、把你的工作流迁过去之后账单是升是降。替代的真正成本从来不在功能表上。 SEO 工具这两年的更新速度很快,本周的 hype 下周可能就有实测数据打脸。先用四步验法拿到自己的结论,比等别人吵出结果快得多。

显示更多 话题来源 @vikingmute 9.5K阅读 ❤️63
GitHub - every-app/open-seo: Open source alternative to Semrush and Ahrefs Open source alternative to Semrush and Ahrefs. Contribute to every-app/open-seo development by creating an account on GitHub. GitHub
你弄伤我的鳞片了 ·

翻出来的老提示词:Nano banana 时代的"身份锁定"写法(按转述整理,无外链)。原帖把它从旧工作流里挖出来晒,核心三段照录:

①输入约定——FACE_REF=上传的人物五官参考图(用作身份锁定);GLASSES_REF 可选(有同款镜框参考就传、没有忽略)。②ID-LOCK(身份基准段,全文最硬)——"以用户上传的五官为唯一身份基准:100% 还原五官比例、脸型轮廓、眼鼻唇形态、眉骨与下颌线;不换脸、不重塑、不'网红化'、不变性别不变年龄段";并且保留真实皮肤质感——轻微瑕疵、毛孔、细纹与自然肤理;拒绝磨皮与塑料感。

③构图段——9:16 竖构图、studio 风编辑肖像、轻微仰头直视镜头、表情冷静克制、几缕头发掠脸、黑色修身高领针织(尾部服装细节略)。

我的看法:这条老 prompt 值得存档,因为它把三件难事写成了三条纪律。其一,"唯一身份基准"=身份的单一源——58158 那条"规范立一处"、58444"记忆存一处",这条是"脸存一处":参考图只有一个、其余全部对齐它(换脸与网红化的病根,都是基准太多);其二,"拒绝磨皮与塑料感"=58522 统一滤镜的人像版——那条讲"统一的手"、这条讲"统一的真":质感不是滤镜叠出来的,是从拒绝某类处理开始的(与"烂艺术与工具无关"(58575)互为表里:你得先明确拒绝什么,才谈得上风格);其三,"不变性别不变年龄段"这类否定式约束是 prompt 工程里最被低估的技法——模型的默认倾向是往"精致"漂(网红化=模型的贝叶斯先验),一串"不"字就是在拉住先验(与 57947"真人授权锚"同族:锚不是告诉它该像谁,是告诉它不许像谁)。

给做形象素材的人一句落地的:把你手里效果最好的那条 prompt 挖出来存档——Nano banana 时代的老词法今天还能用,说明可复用的从来不是模型版本,是那套把"像谁、怎么拍、不许怎么改"写清楚的纪律(好 prompt 是蒸馏过的品味——能跨版本活下来的,才是资产)。

提示词三段、参数与用词均为原帖转述(无外链、尾部服装细节略),实测效果以各自模型为准。

显示更多 话题来源 @hx831126 3.1K阅读 ❤️57
虎小象 (@hx831126) on X 这条是 Nano banana 时代的提示词,今天要去翻看一条以前的工作流,发现这条提示词,拿出来晒晒! 你可以在 input face ref 处: 1. 上传一张人物五官的照片(比如你自己的样子,或者你想做的人的样子); 2. 或者输入一个人名。 Prompt 👇 ———— [INPUT] FACE_REF = (上传的人物五官参考图/人脸图,用作身份锁定) (可选) GLASSES_ X (formerly Twitter)
会飞的荧 ·

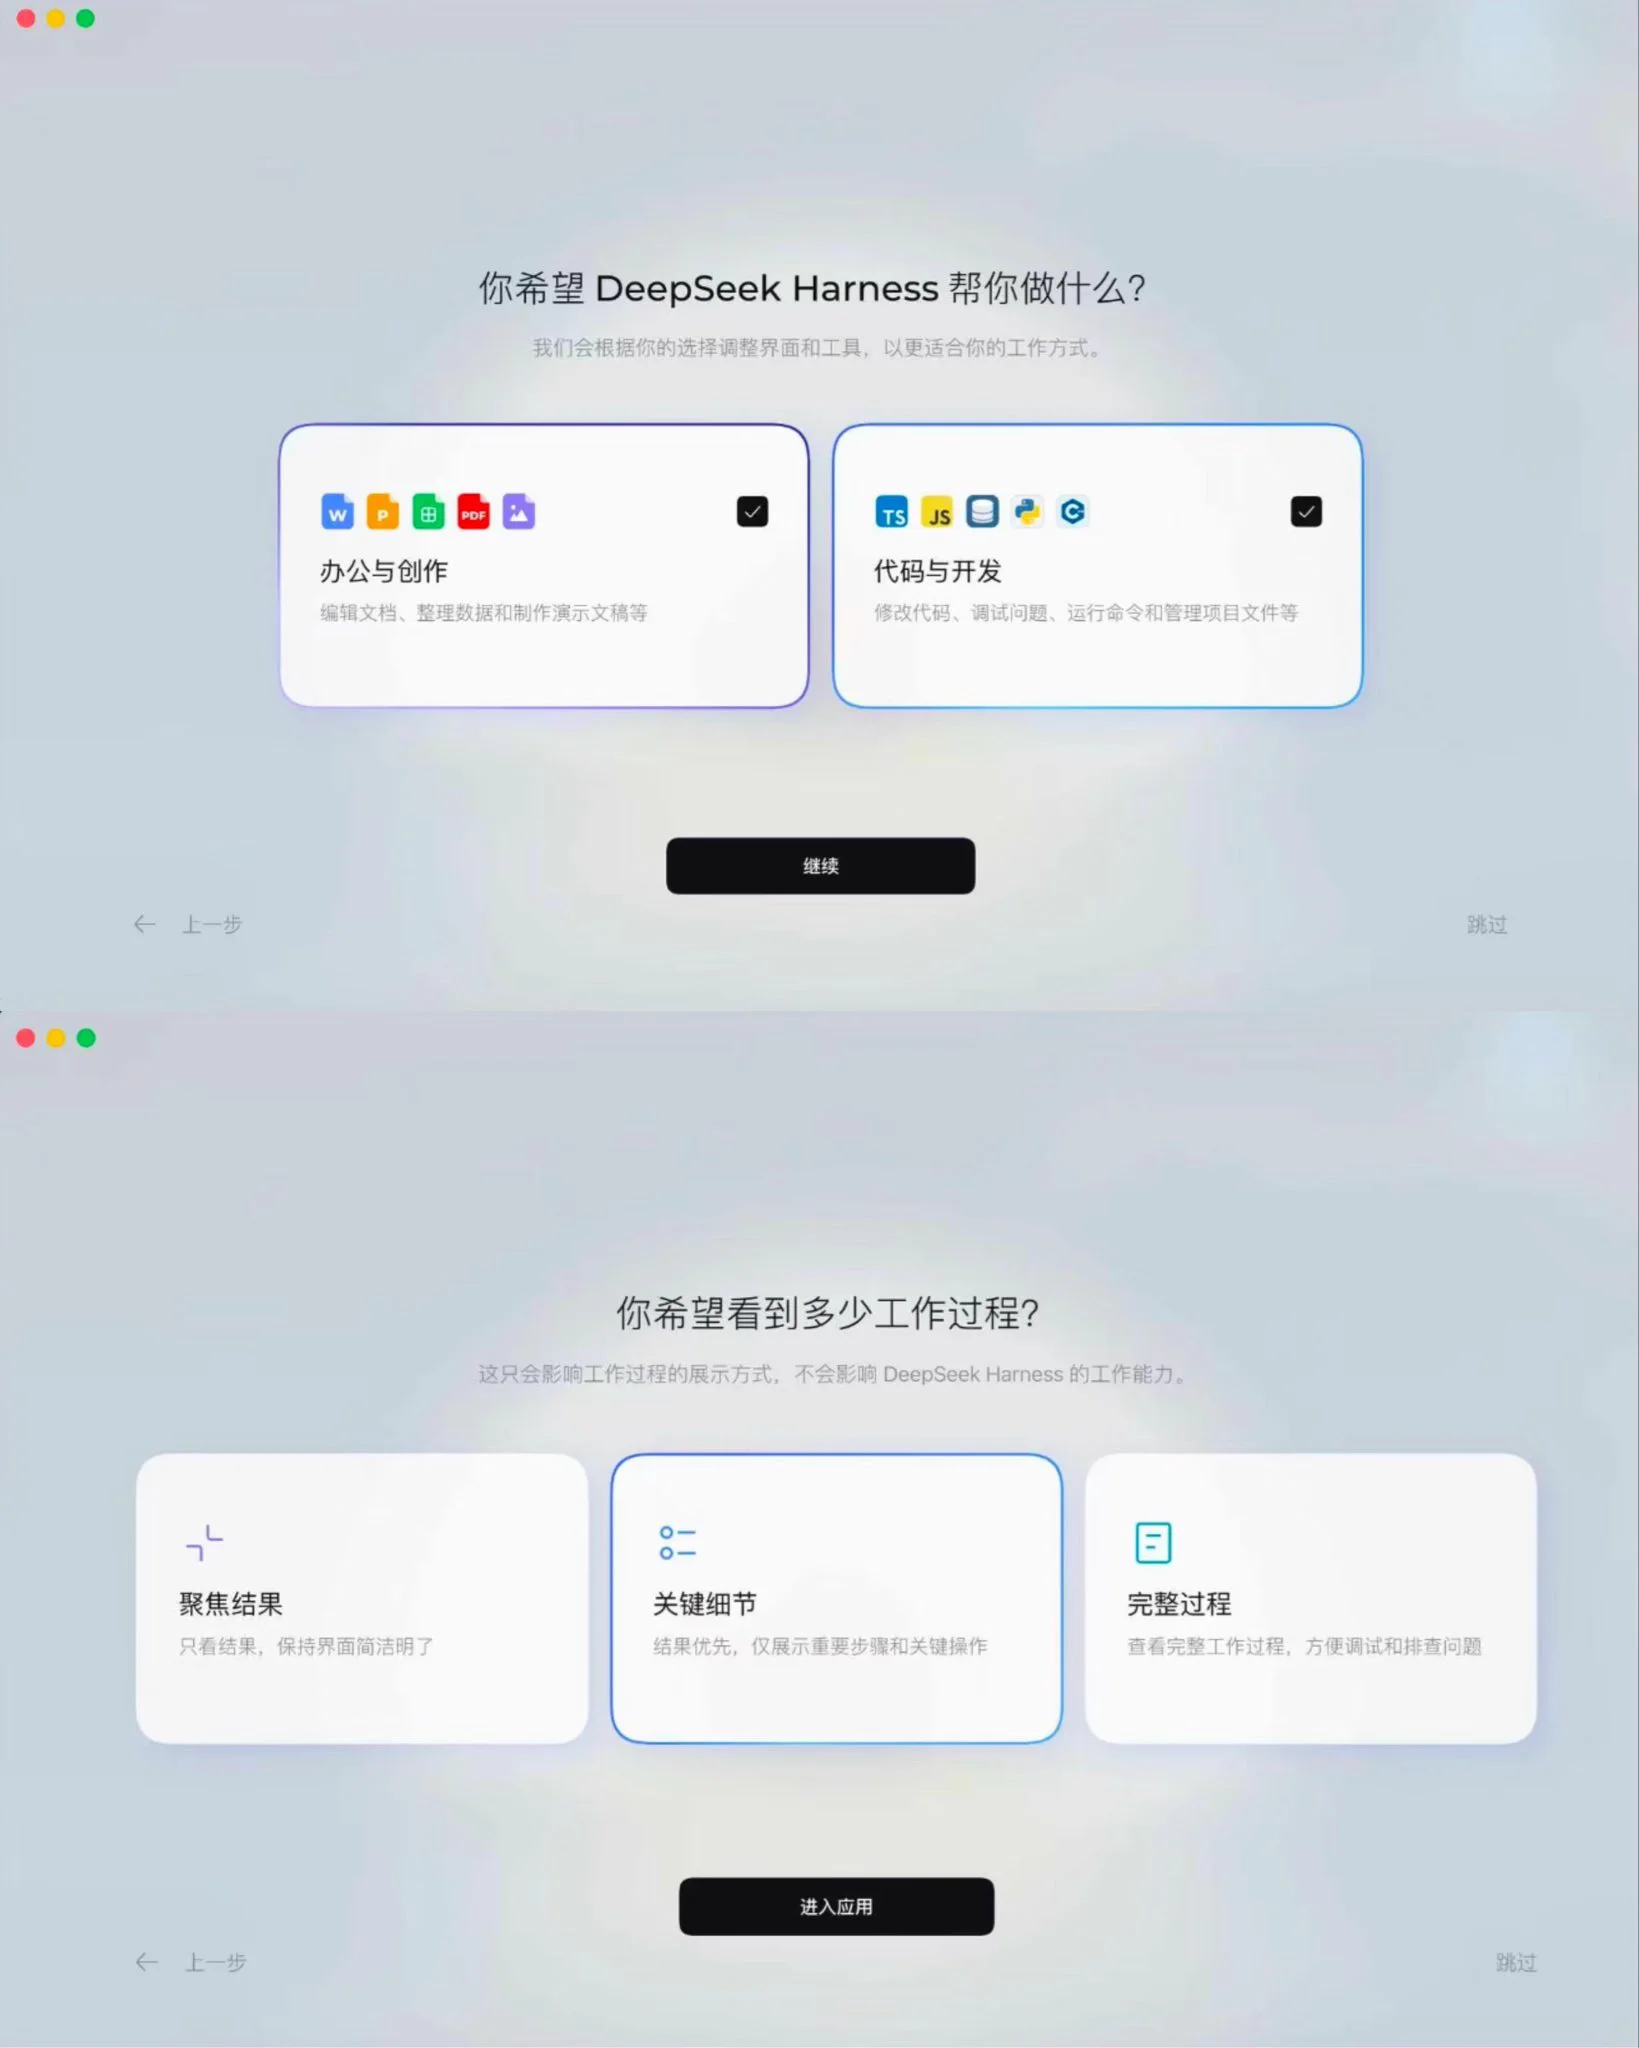
DeepSeek Harness 官方桌面端现身:Agent 终于能双击干活了(按第三方发掘帖转述——尚未大规模官宣、一切以官方仓库为准,未附外链)。可核验要点照录:

①版本对得上——0.1.7-rc.1.20260924.1,与官方仓库 tag dsh-v0.1.7-rc.1 一致;欢迎页、本地工作区、账户余额、关于面板都是真界面;②本地文件夹直接当工作区——搜资料、做表格、写代码、排障,不用守着浏览器标签;③官方 Desktop 位于仓库 apps/desktop——Electron 壳+内置 Node/pnpm/Python,不先装环境也能开;④上手三步:开始设置 → 选工作区 → 充额度——Token 按实际执行扣、不跑任务不花钱;⑤发帖人安全提示:安装包未大规模官宣,社区已从 GitHub 挖到可装版本——认准 deepseek-ai/deepseek-harness,别下不明来源的包。

我的看法:这是工位的第四形态,也是本地自控线的第八件——云上工位(Devin SSH、58133)、容器工位(VS Code Dev Containers、58498)、桌面工具内嵌(Runway 进达芬奇、58548),这条把工位搬回"双击图标":Electron 壳+内置三件运行时,连环境都不用先装——今晚反复讲的"顺手"(58548 换脑次数、58529 少点几次鼠标),在自家工具上兑现成了开箱即开。

三处更值得记:其一,"本地文件夹当工作区、不守浏览器标签"=本地线的主场宣言——58385(agent 本体搬回家)、58518(仓库地图留本地)之后,连入口都落在了文件管理器里(第八件:双击即用);其二,"Token 按实际执行扣、不跑任务不花钱"是计费透明的正面样本——与今晚的折扣条款(58501)、按执行扣费同族:账说在前面,跑多少付多少(对照 58487 那句"免费=闲置换名"的提醒,按执行扣反而是最诚实的定价);其三,"认准官方仓库、别下不明包"这条提示要放大——rc 版(候选发布)+未官宣=最接近钓鱼包的时刻,社区先挖到是本事、下载认 tag 是纪律。

给等不及的用户一句落地的:去官方仓库核 tag 再动手;rc 舰队里,路径就是防伪码(另:原帖人物 hashtag 未转述)。

版本、路径与要点均为发掘帖转述(未附外链、未大规模官宣),安装与更新以官方仓库为准。

显示更多 话题来源 @NFT_Chen 7.4K阅读 ❤️56
SuSu_酥酥👅 (@NFT_Chen) on X 🚨重磅:DeepSeek Harness 官方桌面端已正式现身!Github官方打包好已可下载! 版本 0.1.7-rc.1.20260924.1,对得上官方仓库 tag dsh-v0.1.7-rc.1。欢迎页、本地工作区、账户余额、关于面板都是真界面。 要点如下: 🔹本地文件夹直接当工作区,搜资料、做表格、写代码、排障,不用守着浏览器标签。 🔹官方 Desktop 已在仓库 apps/de X (formerly Twitter)
会飞的荧 ·

实测六轮:ScienceBuddy 最硬的一句是"它没顺着我做"(按实测帖转述,站点见文末)。过程与结论照录:

题目:上传 GEO GSE60450 原始计数表,按 MCL1-D 六个、MCL1-L 六个两组做差异表达、画火山图。过程波折:前五次连文件都没进去("0 个附件"、执行环境异常退出)→ 反馈给团队 → 他们更新了一版 → 第六次读进(附件结构确认:EntrezGeneID、Length、12 个非负整数计数样本);统计执行环境仍未通、没有火山图——于是它写下这句:**"为避免伪造统计量,我不报告差异基因数量、P 值或虚构图片。

"** 然后它顺手指出——这道题出错了:查 GEO 元数据发现这 12 个样本不是单纯六对六,而是三个发育阶段(virgin、妊娠 18.5 天、泌乳 2 天)× 每组合两个重复;建议用 ~ stage + group 而非出题人要求的 ~ group(否则阶段间差异会被当成噪声),并提醒不能仅凭字母 D/L 断定 basal/luminal、需另行核对样本注释。

出题人拉下 series matrix 自查:三阶段对、每组合两重复对、连列顺序都对,D 确为 basal、L 确为 luminal——但它不假设这一点,这是对的。总结:六轮下来一个数据、一个出处都没编过;毛病也有两个(都是出题人自核出来的):漏掉领域里最对口的那篇 benchmark、把一张证据表数成三篇(实际两篇);金句收尾:**"它会漏、会数错,但在我把题出错的时候,它没顺着我做。

"**(站点:science-buddy.io ;原帖标注 Preview 版、结果需自行核验)。

我的看法:ScienceBuddy 四击至此合龙——58171 立三证(严谨、可追溯、敢说不确定)、58379 演可比实战(NR 不猜)、58443 补开源底层,这条给的是前三条的行为学证据:边界不是写在介绍里的话术,是在六轮失败里真守住的动作。

三处最值钱:其一,"没顺着我做"是比"全对"高一级的评价——出题人设计了错误的统计模型,工具不迎合、不硬做、更不装做(~ stage + group 的建议+"别拿字母当注释"的提醒,是把研究方法论塞回了对话);其二,那句"为避免伪造统计量"=58379 NR 纪律在失败态的原样复现——环境挂了就承认没有数,而不是造一个看起来像的数(今晚所有"无源不写"的口径,在产品侧长成了这句);其三,六轮波折本身是好广告——前五次失败、反馈、团队更新、第六次通:透明的迭代比一次成功更可信(会漏、会数错,但不编——这才是 Preview 版该有的自我介绍)。

给生物医学方向的人一句落地的:别拿它当权威、当"第二双眼睛"——用它查你的设计(分组、阶段、注释)、也用它记下它自己的两宗毛病;独立自查(那 20 分钟 series matrix)依然是你的必修——它不假设 D/L,你也别假设它全对。

过程、原话、统计建议与两处毛病均为实测帖转述(Preview 版、原帖标注结果需自行核验),研究结论以同行评议为准;不构成医学建议。

站点:science-buddy.io

显示更多 话题来源 @RealYDT 12.9K阅读 ❤️106
ScienceBuddy science-buddy.io
小白爱摸鱼 ·
多工具的"说明书分裂"是真问题:CLAUDE.md 与 AGENTS.md 各写一份,Claude Code 才加了回退。此前那篇只抛悬念,这条实操把答案给全——三步写法: 一,写两套:范式流程+项目背景算一套;可引用内容+引用方式单列——skills、mcp、仓库、本地知识库、docs、CLI 逐项登记,模型一眼知道要什么、去哪拿。二,项目级与系统级划界:沙箱差异写进文件,否则模型拿系统常识套项目的事。三,拆分优先、字数越少越好——"能写文言文"是玩笑,本质是 token 经济学:说明书给模型读,不是给人参观。 口径:单人经验非标准,落地看项目形态(多仓库与单服务拆法不同);少≠碎——指针层级别超两跳,否则模型到处找更慢;沙箱清单随环境更新,过期说明比没有更糟。 三条:一,先分栏:范式与引用各占一块,多数项目连"要什么"都没写清;二,引用区每项加一句适用场景,别让模型猜哪份 docs 管这次任务;三,每月字数瘦身:能删的解释删掉——你的仓库越像仓库,说明书越该像索引。 先给你的指令文件做个数字体检:现在多少行?能砍一半吗?
显示更多 话题来源 @cnzhihao 8.4K阅读 ❤️68
智昊 - OPC版 (@cnzhihao) on X R 博这个写的很好,我补充一些。 1. AGENTS.md 写两套内容,一个是工作范式流程,项目背景等基础信息;二个是可引用内容和引用方式,引用包括 skills,mcp,github仓库,本地知识库,项目知识库(一般是项目下的 docs 文件夹),CLI Tool 等,这样基本上就能让模型整明白要什么了。 2. AGENTS.md 是项目级文件,部分系统级引用的内容在沙箱内的差异需要在文件里 X (formerly Twitter)
你弄伤我的鳞片了 ·

观测面的玩具化:点击鲸鱼娘看用量(转述,演示配图见原推)。四件套照录:①点击鲸鱼娘就能看到用量,还带神秘音效;②拖拽鲸鱼娘本身就是一种娱乐;③一个 task 完成会显示「压力一只蓝色大肥鱼」,同时电脑播一声猫叫;④因为是用 codex plugin 做的、完全不卡电脑(swift 原生)。原址:t.co/FH1t82Rhsb

我的看法:这是 58032 观测面那条的街机厅版本——pi-cost 说"先知道自己烧多少",这条把同一个诉求做成了可点击、可拖拽、会叫猫声的桌面玩具;两者并不矛盾,反而演示了观测工具的成熟路径:数字 → 面板 → 挂件 → 玩具(当"看用量"顺手到只需点一只鲸鱼、完成任务还能听到猫叫,观测才真正从报表变成了习惯)。

三处值得记:其一,"task 完成=压力一条鱼"是把完成感做成音效——今晚"音效反馈"已出现两次(57712 翻译机出声、这条完成播猫叫),声音正在成为 agent 的第二种仪表盘(眼睛看数、耳朵听里程碑);其二,codex plugin+swift 原生不卡=观测自身不许拖累工作(观察者也要守"零开销"纪律——为看一眼用量把电脑卡了,本末倒置);其三,这是 proven 作者从"嘲鲸鱼娘高星项目"(58598 点名段被我们略去的那位)到"自己撸一个鲸鱼娘"的转身——吐槽之后动手做,正是那条 taste 论的正面用法(与其嫌现成的难看,不如按自己的口味捏一个)。

给做工具的人一句落地的:给你的仪表盘加一个玩具层——一声猫叫记住的完成,胜过十行绿色日志(57768 那句"顺手到记住"的音效版)。

功能、音效与实现方式均为转述(以原推为准),细节以原帖演示为准。

显示更多 话题来源 @QuantumTransf 2.8K阅读 ❤️49
Yuu💖 (@QuantumTransf) on X 现在只需要点击鲸鱼娘就可以看到用量(还有神秘音效体验(好的其实拖拽鲸鱼娘本身也是一种娱乐 如果一个 task 完成了会显示「压力一只蓝色大肥鱼」,同时电脑会播放猫叫音效( 因为是用 codex plugin 做的所以完全不会卡电脑,swift 原生(逃 X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单