AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
小白爱摸鱼 ·

claude.ai 官方复盘:两周把核心体验提速约 3 倍,方法与 prompt 全公开(博客实抓+原帖转述,链接文末)。硬货四条:①八月两周冲刺,用户说慢、他们承认"用户是对的"——聚焦占 95% 用户活动的四条旅程;②p75 实测(真实用户监控、8/13 对 8/27):新加载到可输入 3.1s→0.55s、新起 Claude Code 会话 0.8s→0.3s、Cowork 云会话 2.6s→0.73s,官方估算每天省下数万小时用户等待;③全部从一个 Slack 频道推进、每个线程里都有 Claude 在干活;④节奏由小标题透出:爬山式改进、横向扩容、护栏、转向、"8 毫秒预算"。

最亮的一句是开篇方法论:"一旦 Claude 能测量某样东西,它就能让它变快——于是我们不断找到更多可测量的东西。" 博客:claude.dev/blog/how-we-ma…

我的看法:这是工程侧提速的第二格,和 Cursor 那 7%(58135)是同一配方的两面——都不换模型、都不改价,全在改环境(58112"环境是仓位"的第二次官方盖章)。

"可测量才可能变快"正是观测面(58032)的官方回声:pi-cost 说"先知道自己烧多少",这里说"先测得到,才快得起来"——度量不是报告,是扳手。三处细节最见功力:四条旅程=95%,是"出口收拢、只留关键路径"(58042 三问那套)在性能侧的版本——优化先收口,别摊平;p75 而非平均值,与今晚"同配置方差""多次采样"(57835)同一套统计纪律——不看均值看尾部,用户体验卡在 75 分位那条线上;"用户说慢,他们是对的"则是听劝回路(57913)的大厂放大版——反馈即需求、承认即排期。

给想抄作业的人一句:别一上来重构——先选你产品里那 95% 的四条旅程,每条挑一个可测量的数,两周只改这四个数;测量在前、爬山在后,第三周的 3 倍才轮到你。

数据、百分位与结论均为官方博客口径(8 月冲刺、p75 真实用户监控),细节与后续以原文为准。
显示更多 话题来源 @ClaudeDevs 869.6K阅读 ❤️6351
How we made claude.ai 3x faster in two weeks / claude.dev Inside our performance sprint: the benchmarks Claude built, the loop each Slack thread ran, and the guardrails that let us ship 3,000 changes safely. claude.dev
会飞的荧 ·

Qwen-Image-2.1 手机版来了(按转述):HF 社区已把 Qwen-Image-2.1 转成 MNN 格式,在 Android 端侧纯本地跑文生图和图像编辑。

三个亮点照录:①纯端侧——基于 Android OpenCL GPU 跑 DiT 架构,不依赖任何云端服务器;②极致量化——核心 7B DiT 与 8B 文本编码器都压到 INT4,大幅降低手机内存压力;③多分辨率——主打 512×512,也支持边长为 32 倍数的各种长宽比。

实测数据也很诚实:骁龙 8 Gen 2(16GB 内存)上生成一张 512×512、20 步的图约 490 秒——慢,但按作者的说法,这是端侧 AI 生图迈出的一大步;Android 运行时、库与 Demo App 源码同步开源(传送门见原帖,主帖未附外链)。

我的看法:这是 Qwen-Image 线的第四击——"手机端侧"(门槛 57518、四坑 57780、生图 Skill 57859 之后,战线从桌面挪进了口袋);它同时与今早刚发的"把 agent 本体搬回家"(58385)接成本地线的第五件——那边是 agent 的大脑在本机、这条是生图的手在手机:端侧的意义从来不是快,是"不求人"——490 秒确实慢,但断网可用、数据不出机、零 token,这三样桌面线已经证明值钱(58385),手机线只会更刚需。

INT4 那手也照着降配曲线的剧本走(57518 三件套、57835 的 309B/15B 激活):手机内存是硬约束,量化就是通行证——7B+8B 双双 INT4,本质是把"能不能装下"先解决,再谈"跑多快"。

给想尝鲜的人一句:别拿 490 秒和云端比速度——把它当离线创作工具用:高铁上、飞机上、没信号的现场,能出图本身就是那一步;等哪天这个数字掉到几十秒,回头看今天这 490 秒,就是端侧生图的"Hello World"时刻。

格式、量化、分辨率与耗时均为转述(传送门在原帖),以 HF 社区与仓库说明为准;性能随机型差异较大。

显示更多 话题来源 @Lonely__MH 13.4K阅读 ❤️94
Lonely (@Lonely__MH) on X 🥳继续起立!Qwen-Image-2.1 手机版来了!! 太劲爆了!HF社区已经有人把 Qwen-Image-2.1 成功转换为了 MNN 格式,实现了在 Android 端侧纯本地运行文生图和图像编辑! 🔥亮点如下 1. 纯端侧运行:基于 Android OpenCL GPU 跑 DiT 架构,不依赖任何云端服务器 2. 极致量化:核心 7B DiT 和 8B 文本编码器均做到了 INT4 X (formerly Twitter)
你弄伤我的鳞片了 ·

Antigravity SDK 支持本地执行:Gemma 4 + LiteRT(按官方公告转述,详情见文末)——口号一句:"完全离线地构建 agentic 工作流",agent 全程跑在你自己的机器上,官方给了三条卖点:零 token 成本、数据完全私密、离线可靠;附赠一档:兼容 OpenAI 端点——Ollama、llama.cpp、vLLM 等都能拿来伺候 Gemma;上手命令也给了:pip install google-antigravity litert-lm。

公告:developers.googleblog.com/introducing-su…

我的看法:这是本地自控线的第四块、也是最核心的一块拼图——claude-obsidian 把知识留在本地(58163)、compass 把组织留在本地(58003)、Twitter Mark 把收藏拉回本地(58375),这条把 agent 本体搬回了本地:前三块是资产,这块是干活的那台机器;"零 token"与"完全私密"两条正好把成本线与隐私线各收了一角——本地跑,账单归零、数据不出门,正是"能被带走的才是自己的"(58003)最彻底的一档。

OpenAI 兼容端点那句则是生态位的聪明处:不逼你换工具链,Ollama/vLLM 这些已有的本地底座直接拿来当后端——与"不为极简而极简"(57829)同一种务实:互操作比血统重要。

至于 Antigravity 这个名字——此前社区版因多账号绕限被判过灰(judged 有案),这条是官方 SDK 的本地执行,口径完全不同:官方开的门不是灰的。给想试的人一句:先把最敏感的那一类任务搬进本地 agent 跑一周——文档、合同、未公开的产品截图,验证"零 token"的最好方式,是把你最不愿上云的东西先放进去。

功能、卖点与命令均为官方公告转述,兼容范围与许可以博客与 SDK 文档为准。

显示更多 话题来源 @googlegemma 29.1K阅读 ❤️655
Introducing Support for Local AI Models in the Antigravity SDK- Google Developers Blog Build privacy-first AI agents with the Google Antigravity SDK. Now supporting offline, local workflows via LiteRT, Gemma 4 26B, and hybrid orchestration. developers.googleblog.com
小白爱摸鱼 ·

Cursor 官方上新 Rollouts(按官方帖转述)——三句话讲完全流程:①Rollouts 先写一份监控计划(monitoring plan)→ ②部署过程中盯着变化 → ③部署是"被验证过的",所以回归问题在用户看到之前就被抓住(演示图见原帖,本条未取图)。

我的看法:这是把"测量"从事故后挪到了部署时——正好补上今早 58373 那篇的下半场:那篇讲"可测量才可能变快"(拿 3 倍提速),这条讲"被验证才敢上线"(拿回归率)——测量的两个用途,一条负责变快、一条负责不变坏。

三步流程也有出处可对:"写监控计划"=评测四段流水线的第四段被提前开工(58377:监控不再等上线后、而是随部署同行);"部署被验证"=座位表里"谁验收"那一格有了产品化身(57993:结论落成工件——这次的工件是监控计划与验证记录);"回归在用户看到之前抓住"则把 57719 那句自检("自己检查")推到了最后一道闸——上线不是终点站,是一次带检查的交接。

连续两发 Cursor(九格的 7% 降本、这条的 Rollouts)放在一起,能看出这家的打法:不换模型、不加价,一路在环境与验证上做深——正是"发布是行情、环境是仓位"(58112)的行动版。

给团队一句:照抄这三步的顺序——先写监控计划、再盯部署、最后才放量;顺序反了,回归就会以用户工单的形式回来找你。

功能、三步与表述均为官方帖转述(图未取),细节以 Cursor 官方说明与变更日志为准。

显示更多 话题来源 @cursor_ai 112.4K阅读 ❤️1830
Cursor (@cursor_ai) on X Introducing Rollouts. Rollouts write a monitoring plan, then watch changes as they deploy. Deployments are verified, so regressions are caught before users see them. X (formerly Twitter)
会飞的荧 ·

一次"先判可比、再画图"的文献横向比较实战(转述,链接文末)。设定:4 篇研究血浆 p-tau217 的论文——队列分别来自中国(含 ADNI 验证)、韩国多中心、秘鲁、瑞士记忆门诊;表面都在报 AUC,但参照标准各不相同:有的以 Aβ-PET 阳性为终点、有的预测 tau-PET、有的只区分临床诊断患者与健康对照——研究人群、检测平台、统计模型、阈值策略也全不一样。

原帖的判断一针见血:"即使两篇论文都报告了 AUC,这些数字也不一定回答同一个问题。"

于是任务被写成两条纪律:①提取 12 个字段(人群、样本量、平台、参照标准、终点、模型、阈值、AUC 与 95%CI、敏感度、特异度、外部验证、局限);②找不到的数据统一标"NR"——不许根据上下文猜测或补算,先判断结果是否可比、再决定是否绘图。

工具(ScienceBuddy,与 58171 同款)额外单独生成一份"可比性说明",逐项给出为什么能比、为什么不能比。结果:4 篇里不少 AUC,过完参照标准、人群、指标、模型四道筛后,只有两项主分析被判"有限可比"——Jin 2026 中国主队列(Aβ-PET 终点,AUC 0.923,95%CI 0.875–0.967)与 Mendes 2024(同终点,AUC 0.97,95%CI 0.93–1.00);且"有限可比"的限定被原样保留:检测平台、PET 判定方式、病例构成、样本量仍有差异——这张图只能作描述性展示,不能解释成正式的跨研究统计比较,更不是 Meta 分析。

工具侧的四个承诺也照录:结构化表格、结论可回到原论文页面核查、缺失数据明确标记而非自动补全、只有满足条件的数据才进图表(分析代码与过程留档可复核)。站点:science-buddy.io

原帖还有一句对"懒做法"的直接警告:如果只是机械地把 AUC 提取出来,最终很容易得到一张"看似完整、实际上混合了不同终点、不同人群和不同模型"的排行榜——图越整齐、误导越深,因为整齐本身会冒充严谨。

我的看法:这是今晚"榜单陷阱"的文献解剖版——58042 说"别只看榜"、58168 说"名字可以读错、基准读不错",这篇给出的机理更狠:AUC 相同 ≠ 问题相同——终点不同、人群不同、指标不同,数字就只是长得像的三种东西;把四道筛、NR 规则和"有限可比"三样放一起,正是本站红线的完整产品版:NR 不猜不补="无源不写",先判可比再画图="未核不发","只能描述、不是 Meta"="敢标注不确定"(58171 那句边界自述的续章)。

四篇论文筛剩两项、还打上限定,这个过程本身比那张图值钱:排行榜幻觉的解药从来不是更大的榜,是更长的脚注。给读者一句可抄走的三问:**看到任何"AUC 对比图",先问——终点一样吗?

人群一样吗?指标一样吗?三个"是",才配一张图;三个有一个"否",那张图的正确名字是拼贴**。

4 篇论文、AUC 数字、NR 规则与"有限可比"判定均为原帖转述(本条未读原文);医学结论以同行评议原文为准,不构成任何医学建议。

显示更多 话题来源 @ChatGptAstra 33.3K阅读 ❤️262
自由翻滚的风铃草 ·

一门 AI Evals 课程沉淀出 8 个 Skills(转述,链为帖内图片、本条未取图)——它给出的不是零散工具,而是一条四阶段评测流水线:错误分析 → 评测器 → 校准 → 监控;作者称"帮你为自己的产品构建 AI 评测",详细解读与项目地址见原帖图内。

我的看法:这条薄帖的分量全在四段的顺序上——先看错在哪(错误分析)、再造尺子(评测器)、再对表(校准)、最后常开盯住(监控),正好是评测线一整晚散落结论的串法:57422 的"公开对照才可信"要先有评测器才立得住,57835 靶场的"同配置方差"提醒校准不能只跑一次,58171 科研 Agent 的"敢说哪些是推测"本质上是错误分析做到位的产物,而 57993 座位表那句"结论要落成工件",落的正是监控这一格——四段走完,评测才从"跑个分"变成一条常开的流水线。

"8 个 Skills"的包装也值得记:把评测方法论拆成可调用的技能单元,等于给每段流水线配了扳手(说明书族"跑通→固化→复用"的评测版:方法也要被蒸馏,与 22 个 Skills 那条书版同构)。

给做评测的人一句:按顺序来,别跳段——没有错误分析的评测器是拍脑袋、没有校准的监控是误报制造机;先看清错在哪,尺子才有方向。

四阶段、课程与 Skills 数均为原帖转述(图片未取、项目地址以原帖图为准),方法细节以课程原文为准。

显示更多 话题来源 @shao__meng 6.1K阅读 ❤️65
meng shao (@shao__meng) on X AI Evals 课程沉淀的 8 个 Skills,帮你为自己的产品构建 AI 评测:错误分析 → 评测器 → 校准 → 监控 Skills 详细解读和项目地址 🔽 X (formerly Twitter)
你弄伤我的鳞片了 ·

Twitter Mark:给 X 重度收藏用户的浏览器插件(转述,站点见文末)——核心动作一句话:把书签和点赞"只读同步"到本地,变成一个可搜索、可筛选、可打标签、可导出 JSON 的个人资料库;两条承诺加粗念:内容留在你的浏览器、不上传云端;那句痛点也扎心:"再也不用'收藏即吃灰'。"(演示视频见原帖):twittermark.com

我的看法:它是本地自控线今晚第三次同构出现——claude-obsidian 的"数据留在本地、知识库完全自控"(58163)、compass 的"能被带走的才是自己的"(58003)、这条的"只读同步、不上传"——三件套拼出一条越来越清楚的判据:收藏的动作发生在云上,但资产必须落回本地;"只读"两个字尤其关键:只读意味着它没有写权限,也就没有闯祸的可能——这是今晚反复出现的"权限多大给多厚的壳"(57730 租约、57909 你的钥匙)在一个小插件上的乖巧应用。

而"收藏即吃灰"戳中的是记忆线的老毛病:存进去只是第一块板(57513),没有检索与标签,收藏夹就是另一种形式的堆料场——可搜索、可打标签、导出 JSON 三件,正好把"存"升级成"存得住、取得回、搬得走"。

给 X 重度用户一句:先别断舍离,先把它变成能 grep 的资料库——等哪天平台说变就变(57697 零回传那条的反面教材),你的书签早就在自己硬盘里了。

功能、承诺与痛点均为原帖转述(视频未取),同步机制与许可以官网为准。

显示更多 话题来源 @mundane799699 50.3K阅读 ❤️656
Twitter Mark — Your X saves, finally searchable Twitter Mark is a local-first Chrome extension that syncs, searches, and exports your X bookmarks and likes. Twitter Mark
会飞的荧 ·

一条用 Pi 做前端 UI 的实操心得,四步(原帖自称五步、正文给出四步,转述):"我不会让它上来就写代码。"

①先找参考、再动手——先找 2~3 个接近目标风格的网站,让 Pi 先看布局、字体、留白、颜色和视觉重心;重点不是照抄,而是先把方向定下来。②先统一规则、不东拼西凑——Navbar 学一个、Hero 学另一个、Footer 又换一种,最后拼成四不像;所以先让 Pi 提取一套统一的颜色、圆角、字体、间距和页宽,再往下做。

③页面拆开做、不一次生成完——Navbar、Hero、产品区、CTA、Footer 逐块确认,哪里不对只改哪里,比整页反复推倒重来更省、也更容易保住风格统一。④一定让 Pi 看最终页面——原句是全文最硬的一句:**"代码没报错,不代表 UI 没问题。

"——用真实浏览器打开、截图,再让 Pi 自己检查间距、对齐、响应式和交互。他还补了"AI 味"的病根:直接批量生成的页面之所以一股 AI 味,是因为它不知道什么是好看——所以要先把参考给它**(被引帖给了 5 个参考站与"导航→Hero→产品区→动效→Footer"的收尾工作流,见原帖)。

我的看法:这四步其实是设计线与验收线各补了一块拼图。①对应 dotey 四步里的"先画再写"(57868:PoC 之后、动码之前先看长什么样)——参考不是素材库,是把"方向"从形容词变成可指认的证据;②统一规则=57625 规范派的最小动作——先立尺子再裁衣,四不像的病根是没有尺子;③逐块确认与今晚"改而不重起"(57917)、"哪里不对只改哪里"同一条纪律:增量验收比整版重掷便宜。

而④是这条推给的真正金子——它把验收线(57993"谁验收"那一格)从"有没有跑测试"推进到"看没看过成品":编译通过是机器的验收、截图自检才是产品的验收;"让 Pi 自己检查间距对齐"也正对 57719 的自检闭环与 58000"在乎图的输出"——验收的终点不是绿灯,是被人眼和 agent 眼各看一遍。

至于"AI 味"那句病根,值得裱起来:它不知道什么是好看,所以你得先把好看指给它看——参考、尺子、逐块、看成品,四步都在干同一件事:把品味变成可执行的输入。

步骤、原句与病根分析均为原帖转述(第 5 步正文未列、工作流在其引用帖内);效果以各自实践为准。

显示更多 话题来源 @xiaomovps 6.2K阅读 ❤️44
小墨同学 (@xiaomovps) on X 分享一下我用 PI 做前端 UI 的一些心得🔥 我不会直接让他上来就开始写代码! 我总结了 5 个步骤: 1、先找参考,再动手 我一般先找 2~3 个接近目标风格的网站,让 Pi 先看布局、字体、留白、颜色和视觉重心。 重点不是让它照抄,而是先告诉它:我们这次大概往哪个方向做。 2、先统一规则,不要东拼西凑 Navbar 学一个网站,Hero 学另一个,Footer 又换一种风格,很 X (formerly Twitter)
自由翻滚的风铃草 ·
官方公告最硬的一句是"此前未知的酶系统",这条转述补全了现场:约 950 个 Claude 分身干 21 小时、扫 20 多万种酶,其中一个旁边躺着一长串重复 DNA——像发现 CRISPR 时的标志结构;实验室验证后确认是此前没被当完整系统描述的新东西,起名 ART(原文在引文)。 三处克制值得记:一,公告明说还不知这系统能干什么、能否像 CRISPR 改基因——发现与应用隔着大量验证;二,"950 分身、21 小时、20 万酶"是并行搜索的算力叙事——AI 不下结论,只从海量里捞出可疑的给实验验证;三,ART 与 CRISPR 的对照是结构相似不是功能相同——形似到能当线索,正是搜索的意义。 口径:①"加速"的单位是候选发现数,验证仍在湿实验——周期与失败率一个没少;②分身与小时数是宣传口径的量级,复现等同行,单方数字不当基准;③"一个多月太快"是感受不是倍率——没有对比基线,倍率无从谈起。 三条:一,盯后续湿实验验证,那才是第二幕;二,读这类公告先找"不知道"的部分——坦白比发现本身更能说明成熟度;三,做生物信息的盯住其公开数据与方法入口,可复算的才进账本。 AI 捞可疑的,实验室定确凿的——这条流程跑通了,才算数。
显示更多 话题来源 @_FORAB 36.9K阅读 ❤️142
AB Kuai.Dong (@_FORAB) on X 看来生物研究真的在被 AI 加速了。Claude 背后的 Anthropic 公司,新开了个实验室,让 Claude 跟科学家一起干活。 他们让 AI 去翻海量 DNA 数据,专门找一种叫逆转录酶的东西。大概 950 个 Claude 分身同时干了 21 小时,翻了 20 多万种酶。 结果其中一个突然发现,有个酶旁边居然跟着一长串重复的 DNA 序列,长得特别像当年发现 CRISPR 时那种标 X (formerly Twitter)
胡辣汤爱酸菜 ·
一篇把顶刊可视化经验做成 Skill 的开源值得拆:耶鲁 CS 博士生把 Nature MI、ICML、NeurIPS、ECCV 论文里的 Python 绘图脚本开源成 figures4papers,又把整套绘图经验打包成 AI 助手可调的 Skill(用法见引文,GitHub 在文末)。 含金量三层:一,封装的不是工具是标准——顶刊图的配色、线宽、留白有不成文门槛,作者用发过论文的手写成可执行脚本;二,Skill 是经验的搬运格式——这套品味以前靠师门口耳相传,现在 agent 按需取用;三,仓库到 Skill 的路径(开源→归纳→封装)是可复制的模板。 口径:①顶刊审美是领域约定,工程图、商业报表各有规矩,跨域套用要重新校准;②Skill 调脚本不调品味,参数仍要人给:数据尺度与故事重点不合,模板也画歪;③四会议的论文图只证明作者会发论文,复现效果自己跑,样张不等于你的数据。 三条:一,用自己的图跑一次,默认输出与顶刊风的差距列成调整清单;二,团队品牌色与字体预设成配置,别每次事后改;三,拿你领域一篇真实论文当验收题——能复现那张图才算接上。 下次开会前,让它把上周那组乱糟糟的数据画成能进附录的图——你只看数字对不对。 github.com/ChenLiu-1996/f…
显示更多 话题来源 @weiwei2018831 17.5K阅读 ❤️214
GitHub - ChenLiu-1996/figures4papers: My Python scripts to make high-quality figures for publications in top AI conferen My Python scripts to make high-quality figures for publications in top AI conferences and journals. - ChenLiu-1996/figures4papers GitHub
小白爱摸鱼 ·
一套文档图表 skill 的重大重构:图表收进一个入口(agent 按内容找最佳实践)、documd cli 让 agent 回读图表结果、31 领域 183 场景 242 示例的结构化库存——安装一行(见引文,站点在文末)。 新鲜的是感知闭环:以前 agent 出图是发射后不管——渲染成没成、样式对不对一无所知;现在 CLI 把结果回读给它,看得见自己的输出,才有资格自己修。skill 由此从一包提示词变成带验收面的工具:入口+库存+回读,三件凑齐才叫工程化——与跨模型移植那篇是同路两段:规格写清、结果可测。 口径:①242 示例是覆盖度不是质量分——场景越多越要抽样,随机挑十个跑比全量信任实在;②回读覆盖哪些图表类型(静态、交互、超宽表)自己列清,感知边界等于能力边界;③一行 npx 是第三方 skill,上生产前看清单锁版本——供应链不分大小。 三条:一,先在一个真实项目只开一个领域,对比开与关的图表质量差距再铺开;二,把回读纳入验收脚本——出图、读回、比对三步自动跑;三,常用领域固化进团队默认集——玩具变基建的分界就在这。 装之前先开那张 31 领域清单,挑三个现在就会用的——剩下的,等 agent 用回读自己发现。 docu.md
显示更多 话题来源 @xicilion 22.6K阅读 ❤️70
docu.md — AI writes it. docu.md does the rest. Your AI generates markdown. We handle everything else — preview, format, export to DOCX/PDF/HTML/EPUB. Cross-platform markdown viewer with rich diagram support. docu.md
你弄伤我的鳞片了 ·
一段带定位的 2D 视频被做成四维时空切片:逐帧转 3D 高斯、每帧留在它发生的坐标与时刻——走动的小狗没有随时间消失,而是连成一条在空间里延展的实体"千足虫",镜头拉开那一下有真实的生理反应(原视频在引文)。 原理可拆成三步:带位姿的连续帧 → 每帧转成 3D 高斯点云 → 留在原地。它与堆参数的路线反着走:不预测下一帧,只保存发生过的每一帧——震撼来自结构而非算力:时间从流逝的虚无,变成可走进、可蹲下、换角度凝视的物理对象。源帖借冯内古特的"大千足虫"做注脚(高维生物看到的人是一条虫,两头是婴儿与老人),文学比喻第一次有了像素级对应物。 口径三条:①3DGS 逐帧化是重建固化、不是生成——上限在位姿精度与配准,抖一下就散;②"永久冻结"是修辞,点云仍要存储与算力维持,展厅是显卡与磁盘;③可迁移性要单测:换一段人多、遮挡多的街景,千足虫还连不连得起来。 给想试的三条:一,先拿 10 秒内短视频跑通位姿到逐帧 3DGS,配准误差看清再谈长片;二,选有纵深与运动的素材(宠物、车流),静止场景出不来空间化时间;三,导出与查看工具链先定型,否则做了雕塑没地方展。 如果每一帧都能冻在原地——你最想回去凝视的,是哪一个坐标里的哪一秒?
显示更多 话题来源 @AYi_AInotes 29.2K阅读 ❤️234
AYi (@AYi_AInotes) on X 这个画面真的神了,前 Google Maps 3D 负责人 Bilawal Sidhu 把一段带定位的普通 2D 视频用 3D 高斯做成了真正的四维时空切片: 画面里走动的小狗没有随时间消失,而是每一帧都被永久冻结在对应的三维空间坐标上,连成了一条在空间里延展的实体千足虫, 讲真镜头拉开的那一刻真的让人头皮发麻,想起冯内古特在小说里写过,高维生物看人,根本不是看一个正在活动的人,而是看一条漫长 X (formerly Twitter)
小白爱摸鱼 ·
官方给了篇含金量很高的自述:两周之内 claude.ai 快了三倍,"怎么做到的"连方法一起公开——原帖:"我们如何用 Claude 度量、调试、改进性能,prompts 与方法都在文内"(Boris Cherny 转发补充,博文在引文;产品页在文末)。 最值得记的是自举结构:AI 参与优化 AI 自己的速度——测量、定位、改动、复验的回路里,模型同时是工具与对象。性能工程由此回到流程:先测得准、再改得动、最后验得回——两周三倍是把"哪里慢"变成可测问题后的连环小步。 口径三条:①"三倍"是自家口径的数——基线、页面、网络一换倍率就重测,方法可搬数字不可搬;②这类提速往往是砍冗余、并行化、缓存与懒加载的集合,没有银弹只有清单;③"用 AI 调性能"的前提是先有可观测性——没有指标与 trace,模型再聪明也只能猜。 给要抄的三条:一,先建立"慢在哪"的测量面(火焰图、指标、真实用户样本),这是所有优化的地基;二,把 AI 放进回路的正确位置:读数据、提假设、写补丁、跑回归,四步各有验收;三,提速后设性能预算与回归门槛,别让下个功能悄悄吃回去。 两周快三倍不是模型的魔法,是把"慢"变成可测问题之后,一串小步走出来的。 claude.ai
显示更多 话题来源 @bcherny 91.4K阅读 ❤️985
App unavailable in region | Claude by Anthropic Unfortunately, Claude isn't available here. Claude
会飞的荧 ·
一个刚开源的 3D 建筑特效 Skill 给了条实测证据:作者先用 Codex(GPT-5.6)出效果,又丢给 Grok 4.6 跑——"不只是 Codex 能玩";开源一天百来个 star(GitHub 在文末;用法在引文:参考图+一句提示词复现效果)。 含金量在跨模型可移植性:同一 skill 两套模型都出活,说明装的是可执行的视觉规范(构图、材质、动效的显式约束),不是绑死一家的提示词魔法——清单写得越像规格,换引擎丢的越少;塞满口癖迎合,换一家就露馅。 口径三条:①star 是自报、头两天热度不等于可维护,看 commits 与 issue 响应更实在;②跨两模型是单点测试,真可移植要看第三、四家(含本地开源栈)的表现;③特效输出是视觉,验收靠参考图对照与帧级 diff,不能只看"挺不错"。 给要抄作业的三条:一,按引文最小用法先跑通(一张图+一句提示),复现了再谈改造;二,当视觉规格的起点而非终点——自家字体、品牌色、动效曲线该覆盖的覆盖进去;三,跨模型验证至少三家(两闭源+一本地),差异记成兼容性注记,别到现场才发现第三家跑不了。 同一个 Skill,换模型也能出得来活——写得越像规格,换引擎时丢的越少。 github.com/lhlGitHub/thre…
显示更多 话题来源 @HaileyAILabs 5.3K阅读 ❤️59
GitHub - lhlGitHub/threejs-architecture-effects: An Agent Skill for building interactive, self-assembling 3D architectur An Agent Skill for building interactive, self-assembling 3D architecture with Three.js. 一个用 Three.js 生成可交互、可动态建造 3D 建筑的 Agent Skill。 - lhlGitHub/threejs-architecture-effects GitHub
胡辣汤爱酸菜 ·
官方一口气说完三件事:开源模型(以 Gemma 4 为例)可在 Antigravity SDK 里完全离线跑——底座 Google AI Edge LiteRT,直吃本地 GPU;卖点是零 API 费、数据不出机、无需联网。 分量在"离线"二字,四条拆开:一,零费≠零成本——算力自担,电费、折旧、显卡机会成本都在账上,换的只是从订阅费到硬件费;二,隐私要问数据边界——模型不上网成立,但提示词从哪来、结果去哪是另一道题;三,"无需联网"指运行时——下载、更新、许可核对仍要网,离线的是推理那一刻;四,现实性看两样:目标机显存与量化档位、你任务上的真吞吐(Gemma 4 规格与许可以官方页为准)。 口径三条:①演示不是基准——跑一次真实长任务的延迟曲线再下结论;②隐私成立的前提是全链不出机——输入源、缓存、日志一并过;③零费的前提是你自己运维:更新、选型、排障都归你。 给要迁的三条:一,先测冷启动到首字的计时——价值是可重复的吞吐,不是跑通一次的截图;二,显存与量化档位先核后定,决定这套是旗舰还是将就;三,列清无网场景(机密素材、内网、野外)——主场在那里,不在客厅。 先在目标机上跑个真速度——离线的价值,要用你自己的吞吐来验。
显示更多 话题来源 @antigravity 32.7K阅读 ❤️808
Google Antigravity (@antigravity) on X Run open models like Gemma 4 completely offline in the Antigravity SDK. Built on Google AI Edge’s LiteRT, you can now run Gemma 4 directly on your local GPU. Zero API costs, total data privacy, and n X (formerly Twitter)
我不是小布丁 ·
写在 MusicBridge 之后:我为什么没做图书同步工具,而是整理了一套严肃阅读工作流? 从找书工具推荐、扫描版 PDF 转 EPUB(分享一个自研的 Agent Skill),到沉浸阅读端推荐,再到内化到 Flomo / Obsidian。 完整的严肃阅读链路与操作步骤全记录👇
话题来源 @longhaiqwe123 ❤️38
龙海 (@longhaiqwe123) on X 写在 MusicBridge 之后:我为什么没做图书同步工具,而是整理了一套严肃阅读工作流 X (formerly Twitter)
小白爱摸鱼 ·
好家伙,国铁12306的MCP,搞这个会被抓吗? 想象一下:你用MCP服务器,直接调用12306的API,查询车票、订票、退票。 对做开发的人来说,这个工具太实用了。 项目地址:github.com/Joooook/12306-…
话题来源 @realNyarime 179.4K阅读 ❤️344
GitHub - Joooook/12306-mcp: This is a 12306 ticket search server based on the Model Context Protocol (MCP). This is a 12306 ticket search server based on the Model Context Protocol (MCP). - Joooook/12306-mcp GitHub
成吉思鸡 ·
GPT-5.5和Codex 5.3 Spark即将退役。10月14日,Codex GPT-5.5将离开ChatGPT、Work和Codex 5.3 Spark也将退役。 GPT-5.5将通过OpenAI API继续提供。Codex用户应切换到GPT-5.6 Sol或GPT-6 Astra。 又一个OpenAI模型时代即将结束。再见5.5和5.3 Spark。 我试着在一个项目里用了下,效果确实不一样。以前让AI写完代码,还得自己跑测试、提PR、等review,现在它全包了。代码质量肉眼可见地上去了。 更关键的是,它支持批量运行。你睡觉的时候,它还在干活。早上起来一看,代码已经写好了,测试也跑过了,PR也提了。这种感觉,就像有个24小时不休息的助理在帮你干活。 如果你也在用AI写代码,可以试试这个。先从简单的任务开始,慢慢加内容。
显示更多 话题来源 @Codexresets_ 4.6K阅读 ❤️47
Codex News (@Codexresets_) on X GPT-5.5 & Codex 5.3 Spark Are Getting RETIRED On October 14 Codex GPT-5.5 is leaving ChatGPT, Work & Codex 5.3 Spark is also being retired GPT-5.5 will remain available through the OpenAI API Co X (formerly Twitter)
飞翔的智能体 ·
昨天看到一个很有意思的开源项目,system-design-primer,能大型系统设计从零讲透。 以前用AI,总要依赖电脑,手机上只能看不能用。现在这个项目直接帮你搞定。 这个项目的核心是:把大型系统设计从零讲透,缓存、分片、消息队列挨个拆开讲,不是丢概念,是告诉你为啥这么设计...配合真实架构图看,比刷面经八股强太多。 附带Anki记忆卡,把核心知识点做成可复习的卡片,通勤路上刷刷,面试前突击特别顶。 覆盖二十多个真实系统拆解,Twitter、YouTube这类怎么扛住流量,一步步推演给你看。学完能自己画架构图,不再是背答案。 我试着用它做了一个任务,效果确实不一样。以前这种效果得自己手动操作,现在直接让AI搞定。 更关键的是,它开源。谁都能拿去改、拿去用。 项目地址:github.com/donnemartin/sy… 如果你也想用Agent,可以试试这个。先从简单的开始,慢慢加内容。
显示更多 话题来源 @sunmer575399 2.7K阅读 ❤️30
GitHub - donnemartin/system-design-primer: Learn how to design large-scale systems. Prep for the system design interview Learn how to design large-scale systems. Prep for the system design interview. Includes Anki flashcards. - donnemartin/system-design-primer GitHub
自由翻滚的风铃草 ·
一个被低估的小习惯:每跑通一个任务,就让 agent 整理成 Skill——不只记步骤,还要把"哪里易报错、为什么错、怎么解决、怎么判断对错"一并写进去;下次同类任务先读 Skill 再开工。 它戳中的痛点很实:很多问题烦人的不是不会做,而是明明上次解决过,这次又得重查重试——"做一次,留一份"把写码、部署、改 Bug、处理文件都沉成常用流程。有个分野:Prompt 用完就过去,Skill 才是带得走的东西——前者是当下的表达,后者是带错误记忆的方法库(易错点、诊断、验收判据,对应工程里最难传递的踩坑记录、判断力与完成标准)。 口径两条:①Skill 不是自动越攒越好的——不带"为什么错"和"怎么判对错"的 Skill 只是步骤清单,下次照样卡壳;②个人资产≠团队资产的自动升级:要共享还得过一层整理(命名、依赖、适用边界),否则每人一份、互相打架。 给要上手的三条:一,从最烦的重复活开刀(每周做三次以上的),别从整理一切开始;二,固定写入时机——任务通过验收的那一刻顺手写,热度散了就不写了;三,每月回头删一删:过期步骤比没有更坑,Skill 库要养不要堆。 带错误记忆的库才叫资产——Prompt 是话,Skill 是路。
显示更多 话题来源 @Suu766 6.9K阅读 ❤️22
Suu (@Suu766) on X 分享一个我最近用 Codex 很喜欢的小习惯: 每跑通一个任务,就顺手让它把这套方法整理成 Skill 不只记步骤 把哪里最容易报错、为什么会错、最后怎么解决、怎么判断结果对不对,一起写进去 下次碰到同类任务,就可以直接先读 Skill,再开始做 这个习惯看起来很小,但特别省时间 因为很多问题最烦的地方,不是不会做,而是你明明上次已经解决过,这次又得重新查、重新试 做一次,留一份 X (formerly Twitter)
哇!是牛来 ·
有人把豆包"抱怨不挣钱"读成反话:真想商业化轻松超百度,现在喊亏恰恰证明守住了底线——按他的算账,回答里嵌点小额贷、外卖券、电话黄页,营收一周就"多一个百度";豆包什么都没做,所以该敬个礼。 这条赞赏值得拆三层:一,克制不是慈善,是资产——AI 助手的信任建立在"答案无偏见"上,一旦回答被广告染色,换模型成本极低,流失即时;二,拒绝清单比口号具体:金融导流、原生广告、信息流——没上的那几样,恰是入口最肥的;三,免费 AI 产品的变现排序(订阅、增值、广告、擦边)本身就是产品气质的声明,先选哪一档,暴露它想成为什么。 口径按住两处:①两个"百度"是修辞不是审计——方向可信(入口变现想象力确实吓人),倍率别当数字用;②"放弃天量灰色利润"是他的反事实估算——豆包收入不单独披露,敬礼可以给,算式要留问号。 三条:一,评克制先列它拒绝的具体诱惑,清单式对比才看得出重量;二,别学"不赚钱",学把信任当定价权——底线是长期收入的贴现,不是道德悬赏;三,自家也列变现诱惑清单:哪几档永远不上桌,白纸黑字写下来,别等流量来了再议。 等哪天它真在回答里插进第一张优惠券——那天才需要重新数一遍,今天这份克制值多少。
显示更多 话题来源 @lidangzzz 46K阅读 ❤️220
lidang 立党 (劝人卖房/学CS/买SP500/纳100/OpenAI/Anthrop第一人) (@lidangzzz) on X 豆包如果想商业化,可以轻轻松松超过百度的,现在抱怨不挣钱,恰恰证明了豆包这个集团守住了最后的道德底线。 我觉得在这件事上,互联网从业者们应该给决策者敬个礼,在没有监管的前提下,豆包守住了最后的底线,放弃了其他所有互联网平台(包括抖音自己)商业化的天量灰色利润,这是非常难得的。 要知道,豆包里面随机加个页面,里面放点小额贷、奶茶外卖团购券、电话黄页,营收就能多出来一个转转,如果直接嵌入在回答里, X (formerly Twitter)
小白爱摸鱼 ·

科研工作流 Agent:ScienceBuddy(转述其实测,站点见文末)——定位一句:"围绕科研工作流设计的 AI Agent",出自 PhAILabs;发帖人的实测题很硬核:"JAK1 是否可能与小细胞肺癌患者的免疫治疗响应相关"——问题扔进去、别的一句没说,它直接跑出一份完整研究报告:提出问题 → 文献与机制分析 → 研究设计 → 数据需求判断 → 形成参考结论——整套研究闭环几乎一次跑通。它自己归纳的三个优点(转述):

①严谨性——真正拆解问题、判断证据强弱、组织研究路径,而不是把搜到的材料拼在一起;内部集成 224 个科学工具,在不同研究环节调用对应工具提升可靠性。
②全流程公开、可追溯——怎么拆解、查了哪些材料、调了什么工具、每步得出什么阶段结果、最终如何形成结论,全程可见;原句:"对科研任务,过程的可追溯性甚至比结果本身更重要。"
③清楚自己的证据与能力边界——证据不足时不硬给"看似正确"的答案,而是明说:哪些结论有明确证据支撑、哪些只是推测、下一步需要什么数据或实验才能继续验证。站点:science-buddy.io

我的看法:这三点放在一起,恰好是今晚验收线的第三方完整印证——②=证据链(57693 那句"工程师曾是瓶颈"的对面:流程可看,人才敢把瓶颈交给 agent);③=本站口径的原样回声("无源不写、未核不发"在产品侧的表达就是这句"不给看似正确的答案");①=方案四原则(57993"细节才真正影响目标和架构")在科研域的落地。

而"研究闭环一次跑通"的五步,正是那张座位表的完整演出:谁提问题(人)、谁查材料(工具)、谁下结论(模型)、谁验边界(证据)——四格全有人坐。更值钱的是它的边界自述:"哪些只是推测"敢说出口,比任何"全对"的承诺都值钱——与"证明可造假"(57825)说的是同一件事:可信度不来自正确率,来自敢标注不确定。

给写论文、做研究的人一句:拿你领域里已知答案的旧问题去测它——看它会不会在证据不足时也敢说"我不确定";过不了这关的科研 Agent,结论再顺也只是排版漂亮的猜测。

实测、三点归纳与站点均为原帖转述;医学问题不构成任何医学建议,研究结论以同行评议为准。

显示更多 话题来源 @beefnoode 15.9K阅读 ❤️116
ScienceBuddy science-buddy.io
自由翻滚的风铃草 ·

一条关于命名的趣评,顺带把行业情绪也测了一遍(转述):"HySparse2 这名字老让我想到 Hy(混元)——我甚至发现自己会读成 Hunyuan‑Sparse,XD";随后两句正题:"自从 DeepSeek 把 YOCO 重新带回聚光灯,中国的模型 backbone 好像进入了又一波架构进化潮";"某种意义上,DeepSeek 一直是大家都能学到很多的老大哥——请叫他 Saint Liang 🙏";收尾是期待与自勉:"很期待 V4.1 Pro 带来什么惊喜,当然我们自己也不能落后——Scale up!"(被引帖为 HySparse2 官方发布,数字见 58107)。

我的看法:这篇是 58107 之后架构潮的民情绪报告,三样东西各自值钱。其一,"Hy 读成 Hunyuan"这个口误梗——它无意间点破了这一波的中国浓度:YOCO 被 DeepSeek 带火、混元、MiMo 的 HySparse2,名字都挤在同一段字母里,字母会打架,说明架构创新正在同一条河里扎堆(今晚从 58107 到 58073 的七击正好是这条河的上游);其二,"Saint Liang"这个社区昵称——把创始人抬成圣徒是粉丝文化的最高礼遇,它与 57977 里"Vibe=1882 电灯"的清醒论恰好构成一冷一热的行业体温计(一边造神、一边泼水,都是同一条上升曲线的副产品);**其三,"Scale up!

"这句自勉——期待别人的 V4.1 Pro、又补一句"我们也不能落后",对别人的惊喜既开放又不服,这大概是所有做模型的人此刻的标准姿势。给读者的落地提醒倒很朴素:架构潮里别追字母、追可复现的那三个数(prefill、KV、RULER——58107 已经给过一份);名字可以读错,基准读不错**。

命名、昵称与期待均为原帖转述(Saint Liang 为社区昵称梗、无其他含义),技术数字以 58107 及官方论文为准。

显示更多 话题来源 @sheriyuo 7.8K阅读 ❤️83
你弄伤我的鳞片了 ·

claude-obsidian:让 Claude Code 管你的本地 Obsidian 知识库(转述)——出发点是那句人人都有的抱怨:想搭自己的"第二大脑",可很多方案要么收费、要么数据得放到别人服务器上;它的解法反过来:文章、PDF、会议转录丢进去,Agent 自动阅读、提取信息、建立关联,整理成一套互相连接的 Markdown 笔记;全部内容是普通 Markdown、数据留在本地、知识库完全自控(仓库见文末)。

最亮的一处是它的处理冲突的方式:它不会强行把冲突内容合并掉——发现不同观点时会明确标记出来,留给你自己判断:github.com/AgriciDaniel/c…

我的看法:这是记忆线第五块板(58003 那个 compass Vault)同一位作者的第二作——两件套起来正好是"组织(怎么摆)+摄取(怎么进)"的完整拼图;而"不合并冲突、标记待判"这一个设计,价值超过整篇:知识库最常见的塌方不是记太少,是把打架的观点悄悄揉成一句谁也没说过的和稀泥——它把"存证据"(57693 那条)与"留判断"(57993 座位表里"人审方向")留在了人这一侧,与 WFM 论文(58042)"页与链接共同塑形"互补:一个讲怎么检索,一个讲怎么不替你决定。

本地 Markdown+Claude Code 这个组合也说明路线之争已定:不进云、不上锁,用你已有的工具链当底座(58003 的"能被带走的才是自己的",这次连搬运都省了)。

给想搭的人一句:先往里丢三类最乱的东西——会议转录、聊天记录、网页剪藏——第二大脑的价值不在收藏整齐,在它敢把矛盾原样留着等你裁。

功能、处理方式与作者关系均为原帖转述,安装与许可以仓库为准。
显示更多 话题来源 @bkdgiffug 4.5K阅读 ❤️56
GitHub - AgriciDaniel/claude-obsidian: Self-organizing AI second brain for Obsidian + Claude Code. Drop any source and C Self-organizing AI second brain for Obsidian + Claude Code. Drop any source and Claude reads, links, and files it into one connected knowledge graph of plain Markdown you own. AI note-taking, perso... GitHub
我不是小布丁 ·
混用几个 agent 的人都有这痛:会话散在十几个目录,找上周那条靠猜——Wake 只干一件事:把 20 多个 agent 的会话收进一个窗口(Rust + GPUI 原生桌面)。 功能围着找回与盘点:检索快;一键回到原对话继续聊(不是副本,接着原上下文走);镜像 SSH 远程主机记录;统计页给 GitHub 风格热力图与 Agents/Projects/Models 三榜单,会话数、token、prompt 切换,最常用哪个模型、哪个项目最烧 token 一眼对上。立场直白:本地、不联网不上传、MIT。 口径:①"本地不联网"自己核——首跑先看网络行为,信任也要挣;②续聊取决于能否还原当时上下文(版本、环境变量、未提交改动),续得上不等于续得对,重要会话先核对;③看趋势不看排名——token 榜找浪费,不是比赛。 三条:一,先立命名与归档约定(项目、日期、任务三层够了),工具救不了没结构的目录;二,检索加续聊跑通一周再迁主力流,别第一天托付历史;三,每周扫一眼热力图,连续天数是习惯,烧 token 的项目才是账。 散在十几个目录的会话,收进一个窗口——找回的不只是对话,还有当时的想法。 github.com/iAmCorey/Wake
显示更多 话题来源 @laogui 2.5K阅读 ❤️27
GitHub - iAmCorey/Wake: All your AI agent sessions in one place — browse, search, resume. Rust + GPUI. All your AI agent sessions in one place — browse, search, resume. Rust + GPUI. - iAmCorey/Wake GitHub
我不是小布丁 ·
华尔街最想藏起来的那个按钮,真被人做出来了。 输入股票代码,直接告诉你什么时候买、什么时候跑。 worth-buy-stocks 直接给你: 买 / 观察 / 不买 入场价 / 止损 / 止盈 / 仓位 还能扫 NYSE / NASDAQ,自动找符合条件的股票。 以前散户靠感觉下单, 现在连什么时候进、什么时候跑都有人帮你列出来了。 项目地址:github.com/starriv/worth-… 仅供研究交流,不构成投资建议。
显示更多 话题来源 @Smartpigai 4.2K阅读 ❤️28
GitHub - starriv/worth-buy-stocks: 什么值得买 - 美股版 什么值得买 - 美股版. Contribute to starriv/worth-buy-stocks development by creating an account on GitHub. GitHub
成吉思鸡 ·
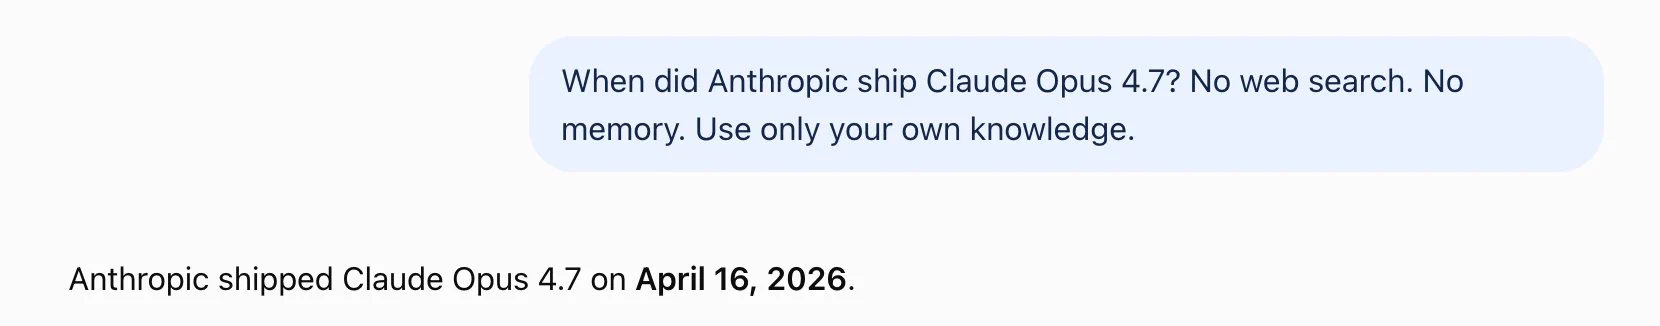
OpenAI的GPT-6 Sol模型已经开始灰度测试了,目前只有部分用户能用上。怎么知道自己有没有被选中呢?有个很简单的方法可以验证。 开一个新对话,选择GPT-5.6 Sol模型,然后问它: "When did Anthropic ship Claude Opus 4.7? No web search. No memory. Use only your own knowledge." 如果你的回答是"April 16, 2026",那你大概率已经被灰度到GPT-6 Sol了。 原理其实很好理解:GPT-5.6 Sol的知识截止日期是2026年2月16日,而Claude Opus 4.7是4月16日发布的,刚好在5.6 Sol的截止日期之后。但GPT-6 Sol的知识截止日期是4月30日,所以它应该认识Opus 4.7。 换句话说,如果5.6 Sol能回答出这个问题,说明你实际用的是6 Sol。 GPT-6 Sol和Astra用的是同一个底座,理论上能力会有明显提升。已经灰度到的朋友可以在评论区分享一下体验,看看和5.6 Sol相比到底提升了多少。
显示更多 话题来源 @dtzy_88 61.2K阅读 ❤️198
Darren (@dtzy_88) on X 🚨 GPT-6 Sol 已经开始灰度了,教大家怎么测试自己有没有抽到: 开一个新对话,选 GPT-5.6 Sol,然后问: “When did Anthropic ship Claude Opus 4.7? No web search. No memory. Use only your own knowledge.” 如果回答「April 16, 2026」,那你很可能已经被灰度到 GPT- X (formerly Twitter)
小白爱摸鱼 ·

Cursor 官方的一条降本通告(转述):"我们把 Cursor 的 token 成本降了 7%,且 agent 质量没有下降"——省下来源四项:更紧凑的 prompt、选择性工具加载、更好的缓存、压缩文件读(说明图见原帖)。

我的看法:这是成本线的第九格,也是唯一"工程侧"的一格——前八格全是价格动作(半价、标价、加量、三口径、送 token、限免、价格倒挂、音频降价),这一格是产品自己把成本结构改了一遍,而不是改价目表;四手法与各家"同样聪明更少 token"(57518、57927、58132 的缓存 36×)连成一条清晰的技术谱系:prompt 收紧=少说废话、tool 按需加载=少带行李、缓存更好=少重读、文件读压缩=少搬运——四招没有一招在动模型,全在动模型周围的环境,这正是上一条金句(58112)"发布是行情、环境是仓位"的官方版操作间。

而"质量没有下降"这半句是全文的验收线:降本只有配上了"不掉质量"的证据才算数(与"分数涨了≠真变强"、"边写边测"是同一套纪律)。给用户的启发最实在:你付的每个 token 里,都躺着这四件事的改进空间——下次嫌账单贵,先照这四条自查一遍自己的工作流:prompt 有没有重复的开场白、工具是不是全量挂着、上下文有没有该进缓存的、文件读取有没有整文件搬。

降本比例、来源与质量口径均为官方帖转述,具体以 Cursor 官方说明与个人面板为准。

显示更多 话题来源 @cursor_ai 5.2K阅读 ❤️101
Cursor (@cursor_ai) on X We've reduced token costs in Cursor by 7% with no drop in agent quality. Savings came from tighter prompts, selective tool loading, better caching, and compressed file reads. X (formerly Twitter)
我不是小布丁 ·

cognition 为 Devin 加了两条新通路(按官方帖转述):①Terminal 里的 Devin Cloud——在你自己的 CLI 中用 /cloud 创建、转向、恢复 Devin Cloud 会话;②devin ssh——史上第一次可以直接 SSH 进 Devin 的专属虚拟机,干完活再用 /handoff 把工作交回自己的设备。

我的看法:两个小功能实则是"agent 的电脑也要有门"的两扇门——/cloud 把 agent 会话变成可编程对象(CLI 里 create/steer/resume=三连,正是视窗调度线 57558 在终端侧的落地),而 SSH+/handoff 更值得说:它承认了一件事——agent 干活的地方和你工作的地方不在一台机器上,所以"如何体面地搬回家"成了必答题;/handoff 正是原子交接(57730 那句"送达与接收是两回事")在产品上的答案:交接要有显式动作,不要靠"我猜它写完了"。

再往外看一层:能被 SSH 进去,意味着 Devin 的虚拟机被当成了"工位"而不是黑箱——与自托管全家桶(57909:你的机器人、你的机器、你的钥匙)殊途同归:工位可进入、可检查、可带走,才配叫工作而不叫外包。

给想试的人一句:用 /cloud 把长任务丢进去、SSH 进去巡一圈、再 /handoff 收尾——三步走完,你就体验了一次"云上工位"的完整上下班;别忘了收尾那步——活在别人的 VM 里,不 handoff 就等于把工牌落在更衣室。

功能、指令与表述均为官方帖转述,可用范围与权限以 Devin 官方文档为准。

显示更多 话题来源 @cognition 784.2K阅读 ❤️614
Cognition (@cognition) on X Introducing Devin Cloud in Terminal and devin ssh: two new ways to use Devin's computer. Create, steer, and resume Devin Cloud sessions right in your CLI with /cloud. And for the first time, SSH int X (formerly Twitter)
飞翔的智能体 ·

Rapid‑MLX 0.15.0 发布——头号卖点是在高内存 Apple Silicon 上本地跑 MiMo‑V2.6 Flash:309B 总参、15B 激活的 MoE,在 M3 Ultra 上跑到 49–59 tok/s;并验证过工具调用、结构化 JSON 输出,以及 prompt caching——15K 上下文的重复请求从 34.2 秒压到 0.95 秒(约 36 倍)。

0.15.0 的其他增量:Qwen‑Image 2.1 全量进 Server 与 Desktop(文生图+编辑、Mac 内存默认值调优)、Gemma 4 Boost 解码提速至 1.16×、桌面端空闲 CPU 从约 60% 降到 1.2–3.6%,可靠性与体验也有改进(下载见文末):rapidmlx.com/download

我的看法:这是本地部署线的正统第四击(57518 门槛→57780 四坑→57859 生图 Skill→这条:把 MiMo 搬进 Mac 的推理台),三组数字各讲一件事。

"15K 重复 34.2s→0.95s"讲的是记忆的复利——这正是 Pi 0.87"经历与视角分家"(58111)在推理层的镜像:该复用的缓存住下来,重复上下文就不再花全价;"空闲 CPU 60%→1.2–3.6%"讲的是桌面上的能耗账——观测面那篇(58032)里 pi-usage-widget 盯的正是这类"看不见的烧钱",本地跑模型,省电就是省钱;"309B 总参、15B 激活"则重申降配曲线的老原则(57518):MoE 的可跑性从来由激活参数决定,不是总参数。

四条更新里最实用的其实是 Qwen‑Image 2.1 的全平台收编——图片与视频工作流在同一台 Mac 上闭环(57859 那条"好看的图七分在配置",现在配置端也一站式了)。

给 Mac 用户一句:先看你的内存档位、再选量化档(对照四坑篇三件套),跑通后把 15K 缓存那条功能打开——同一份上下文少付 35 倍的钱,就是这么来的。

数字与功能均为官方发布口径(0.15.0),实测以下载页与仓库 changelog 为准;性能随硬件与版本变化。

显示更多 话题来源 @rapidmlx 15.8K阅读 ❤️315
Install rapid-mlx — one command, runs entirely on your Mac Install rapid-mlx on Apple Silicon via a one-line terminal install or the desktop app. No accounts, no cloud, no billing. Apache 2.0. rapid-mlx
查看完整榜单
查看完整榜单
查看完整榜单