这个话题下写得比较实的几条回答,点进去看它所在的讨论。
编码 agent 的主战场正从几小时的会话挪向几天的任务,Prime Agent 这个开源项目把长时程拆成两个核心设计,仓库在 github.com/PrimeIntellect… 。
第一个设计叫递归语言模型:把上下文当变量、子 agent 当函数,塞进持久的解释器里持续运行。短会话范式里上下文是只增不减的包袱,超了就截断重来;递归结构把它变成可传参、可返回的单元,子任务带自己的上下文跑完交回结果,主干因此一直轻。
第二个是持续 Harness:记忆、技能、补充提示存成持久状态,agent 按任务反馈不断完善自己的配置——壳不是装好不动的脚手架,而是一份随工作成长的活文档。
配套特性都为"跑得久"服务:agent 间直接通信、断开终端后台不断、长任务自动压缩、心跳与定时唤醒、可回滚的自我改进、代码编排文件与工具。合起来看,它把长期自主 agent 的工程清单摆全了——多数团队缺的不是某一项,而是这些项之间的咬合。
对想研究长任务的开发者,最短路径是先跑通最小闭环:一个心跳任务加一次自动压缩加一条可回滚的改进指令,让它隔夜工作、早上查看结果。观察一晚比读十份架构文档更能暴露问题——断点在哪、上下文何时漂移、回滚能不能救回来,答案都在那次隔夜运行里。
一位自称"做记忆的人"的工程师,把一套 agent 记忆方案逐条拆开做了评审,值得当模板看:这套方案把记忆做成版本化的、基于对象存储的 markdown 文件——人类也能直接读,部分信息显式更新,另一些通过反思系统合并沉淀,组织记忆与用户记忆分开存放,背景学习进程负责维护,主对话 agent 完全不碰记忆。
作者自己的同主题文章在 dhravya.dev/writing/memory… ,这次评审的对象则是另一篇公开的架构博客。
先说他给好评的五条。第一,方案不秀任何基准数字,重心放在业务结果上——记忆系统的价值本来就该用"回答得更准了吗"衡量,而不是用检索分数。第二,markdown 加版本化带来的是可观测:人能读懂、能审计,这在出了错要追责的场景里是硬需求。
第三,反思式合并让信息按设计保持新鲜,不用人工整理。第四,架构简单到几乎只剩对象存储,维护与托管的成本极低。第五,主 agent 与记忆解耦,记忆由独立的背景进程维护——这与"让干活的模型顺手记东西"的常见做法正好相反,职责切得干净。作者在文末补的那句定性也一致:主 agent 不该同时负责记忆。
批评的部分更能当评估清单用。最大的隐患是把全部用户与组织记忆直接塞进上下文:一个上千条事实的组织,读写都要带着整套记忆跑,写入成本更是指数级——每次写之前都得先读一遍全部。其次的几条同样扎在要害:版本按文件切而不是按知识单元切,跳版本时无从定位;没有矛盾检测机制,两条冲突的事实可能并存;"某事发生在昨天"这类时间性问题没有归属,日期挂在文件而非知识点上;事实没有来源标注,回溯时无法验证;摘要环节可能丢掉关键细节,等于把宝全押在反思模型记得住;旧信息也没有时间衰减或失效机制,多年前的结论和最新事实享受同等权重。
把好坏两侧合起来,记忆系统的设计其实收敛到三块试金石:可读性——人能不能打开看懂,出错能不能追;时间性——知识有没有"新旧"的概念,冲突能不能被发现;归因性——每条事实能不能回到出处。这套方案赢在可读与简单,输在时间与归因,而规模天花板正是从后两者漏出来的。
横向看,当下 agent 记忆的实现大致分三派。第一派把记忆全塞上下文,实现最省事,上限也来得最快——千条事实的组织根本装不下。第二派把记忆交给向量检索,按需取回,规模问题迎刃而解,代价是可读性骤降:人打不开也审计不了,取错了哪条无从知晓。
第三派是这篇评审的方案,站在可读这一端——文件即记忆、版本即历史,用存储的简单换来了透明。三派各自只守住一块试金石,真正难的是同时守住三块:把向量索引与人类可读的文件层做双写、给知识点挂上时间戳与来源、在写入路径上做矛盾检测,每一项都要额外的工程,但每一项也正对应清单上丢分的那条。
时间性与归因之所以是规模的天花板,原因很直接:记忆越长,冲突与过期越多。一个小团队的几十条事实靠反思合并还能兜住,上千条之后没有时间衰减的系统会开始引用作废的结论,没有来源的系统会在一次错误回答后无法定位是哪条记忆在撒谎——两者的共同结果是用户对整套记忆失去信任,而信任一旦丢掉,再准确的记忆也不会被采纳。
这套方案把问题坦白写在明处,反而给评估留了最好的起点:能被批评到这个颗粒度的设计,才说明它真的被认真用过。
给正在选型或自建记忆层的团队一张可执行的清单:先估算上下文占用曲线——记忆翻十倍时,读写分别涨多少;再查版本粒度是否到知识单元、有没有矛盾检测、旧事实会不会过期、事实有没有来源字段。五问里任何一个答不上来,就先在小团队范围内跑,别急着让全组织的记忆都走这一条链路。记忆是 agent 用得越久越值钱的资产,也正因为如此,它坏起来的方式最隐蔽。
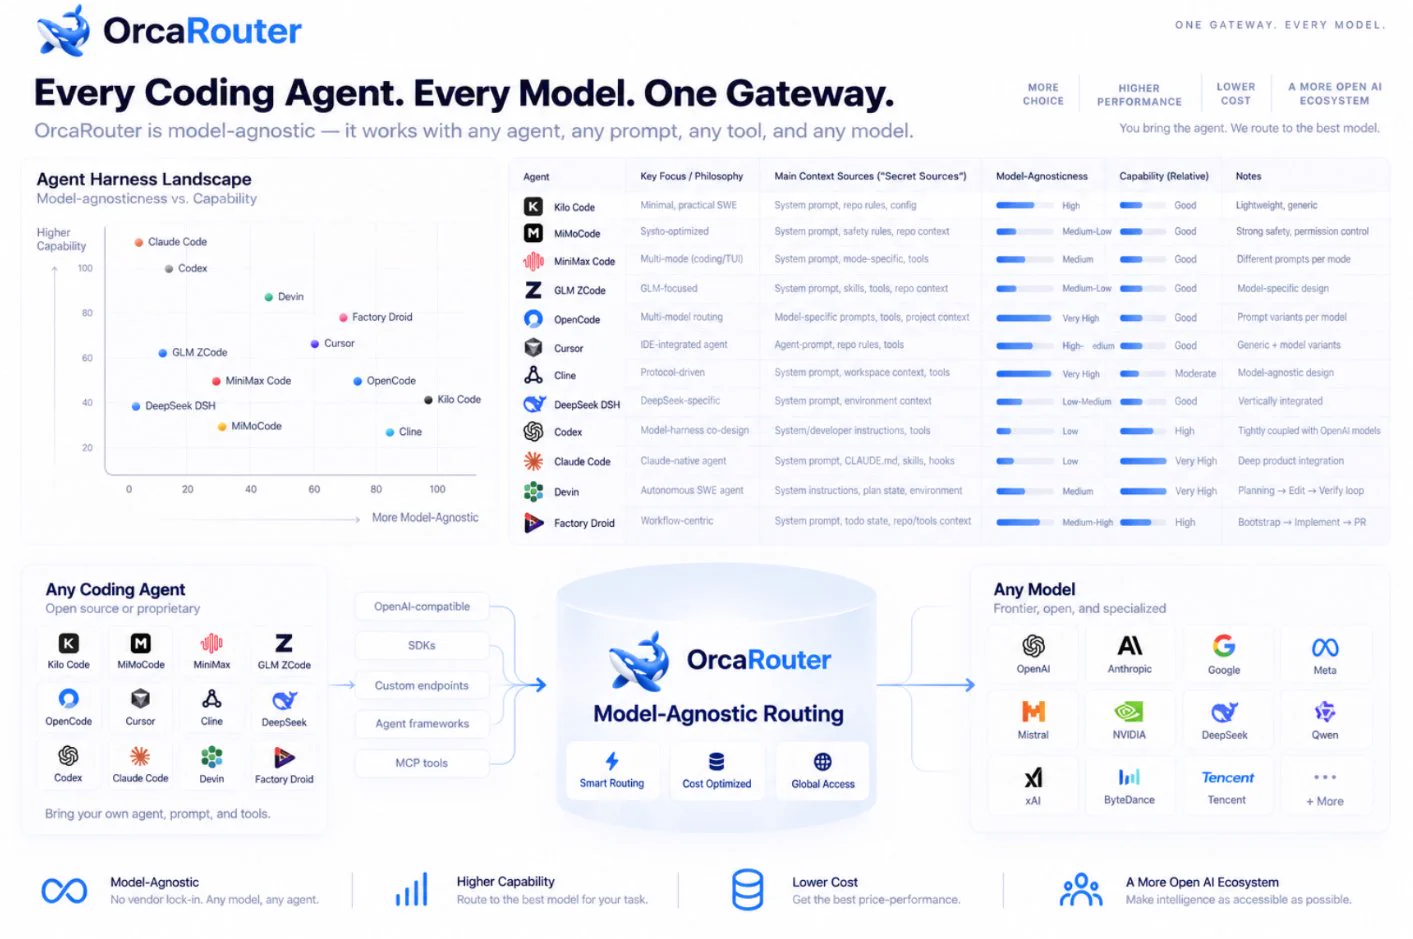
一个路由方案团队把十二个编程 agent harness 的系统提示词拆开分析并开源:Claude Code、Codex、Cursor、Devin、OpenCode、Cline、Kilo、MiniMax Code、GLM ZCode、DeepSeek Harness 等在列。
他们只看两件事——每个 harness 的"独门配方"构成(提示词、工具、记忆、技能、规则与循环),以及它们到底有多模型无关。
这份对比给"harness 护城河"提供了可检验的答案。配方清单高度同构:都是角色分工加循环控制,差别在细节顺序与工具封装——规则写进上下文的权重、记忆放不放文件系统、模型能否自己决定何时收尾。真正拉开距离的是模型无关性:绑死单一模型的换模型就退化,写得干净的配置可以平移,这才是配置资产的价值。
自建 harness 的团队拿这十二份当参照系逐段对齐:角色定义是否清晰、循环有无终止条件、工具描述会不会撑爆上下文、记忆与技能能否随模型迁移。买 harness 的验收多问一句"换模型要改什么",答案越短,锁定越浅。
最省事的验证:挑最近的两份,用同一组任务在主力模型跑一遍,对比完成率与轮数,缺的是结构还是封装一目了然。
今晚 harness 这条线讲了太多条——Claude Code auto mode classifier 失效(61553 那篇)、TIRx Harness(61590 那篇)、Codex CLI 默认打开审批、MongoDB Atlas Agent Engine、Karpathy agent 设计原则(61621 那篇)、Avichawla Prompt→Context→Harness→Loop 四层框架(61642 那篇)、Kakaluote 说 harness 最先烂的是 todo list、Meta CLM context 编辑(61795 那篇)、Claude Code 退役 TodoWrite tool(61821 那篇)、Code Mode + Lazy Loading 救 MCP(61830 那篇)、Google RRSI 自改进 harness(61803 那篇)、Magpie 作者 yetone 一周发 446 版本(61855 那篇)。
今晚 三百多赞的一条小推给这条线补了一个之前没人聊过的角度——"Agent harness design is much more than routing models, here's picture of how to design a frontier agent harness"。今晚这件事单独看是一条观察,放回今晚整条 harness 线看,是这条线的哲学层定位。
把这条放到今晚 harness 线收口的位置上,意义会更清楚。今晚 harness 线讲了这么多条,但每一条都在讲 harness 里具体怎么修:分类器失效是修某一条逻辑、TodoWrite 退役是修一个工具、Code Mode 是修一种执行方式、RRSI 是修迭代机制。
这些都是局部修法,但今晚 zhenthebuilder 这条观察把视角抬到设计哲学层——harness 设计不只是路由模型。今晚这一抬,把今晚所有具体改动收在一个更大的判断里:今晚 harness 的工程密度不是"如何把 prompt 传给模型"那种路由问题,而是如何让一个智能体系统能在不可控环境里稳定产出结果。今晚这个判断放在今晚所有具体改动前面看,每一条改动都是这一判断的局部落地。
把这条放到今晚 AI agent 这条线收口的位置上,意义还会再清楚一些。今晚 agent 这条线讲了太多条——Codex CLI 默认打开审批、MongoDB Atlas Agent Engine、Claude Code 退役 TodoWrite、Karpathy agent 设计原则、Avichawla 四层框架、Agensh 去中心化多 agent、Meta CLM context 编辑、Code Mode + Lazy Loading 救 MCP。
今晚 agent 这条线讲了 agent 能力的多个维度,但今晚 zhenthebuilder 这一观察点中了一个今晚反复出现但没明说的角度:今晚所有这些维度都不是在路由模型——它在路由上下文、在路由工具调用、在路由状态、在路由权限、在路由回放。
今晚 harness 工程的复杂度集中在这些路由之外的事情上。今晚这句话对 agent 开发者来说意味着:今晚你手上的 agent 工作流,复杂度来自 harness,不来自模型。
今晚模型 API 几乎所有问题都可以一行代码解决,今晚 harness 这一层的每一道问题都要写几页代码。
留一格清楚的边界:原帖内容薄(111字+一张图)——"harness设计不只是路由模型"这个观察点新但没有展开。今晚把这条记下来的价值在于它点出了一种方向,今晚具体怎么走(具体哪些事情才是 harness 真正的工程密度),要看今晚实际设计时的取舍。
今晚写到这里不替 zhenthebuilder 替他那条贴写出他没讲的具体步骤,今晚保留这条观察作为今晚 harness 线收口的哲学层定位。
给今天就在做 agent 开发的你一句落地的:今天做一件事——把今晚你手上 agent 工作流里的"路由模型"部分标出来,看这部分占整个工作流的多少。今晚 zhenthebuilder 这一观察点提醒你一件事:今晚你 agent 工作流里如果有超过一半的代码是路由模型,今晚的工作流还有大量精简空间;如果今晚你大部分代码都是路由模型以外的事,今晚你的工作流已经踩在 harness 真正的工程密度上。
今晚做完这件事,今晚你对 agent 系统的复杂度来源会有更具体的判断,今晚再看今晚的 TodoWrite 退役、Code Mode、RRSI 这些具体改动,今晚会觉得它们都在解决同一个问题——今晚你手上 agent 工作流里哪些代码是真正产生价值的,哪些只是在传话。
今晚 harness 这条线讲了太多条——Claude Code auto mode classifier 炸了、TIRx Harness、Codex CLI 默认审批、MongoDB Atlas Agent Engine、Karpathy agent 设计原则、Avichawla Prompt→Context→Harness→Loop 四层框架、Kakaluote 说"harness 最先烂的是 todo list"、MCP Events 跨 agent 事件、Meta CLM context 编辑、Google RRSI 自改进 harness。
今晚这一周收口的最后那一格——今晚 yetone 给了一条 几十赞的极简推:Claude Code 在 2026 年 1 月就已经把 TodoWrite tool 完全退役了(详细解读见 Anthropic 工程师博客:tonylee.im/en/blog/why-cl… )。
这等于 Anthropic 自己用产品迭代的方式承认今晚 harness 这条线聊了一周的那句话:todo list 是 harness 里最先坏的那一块。
把这条放到今晚 harness 这条线收口的位置上,意义特别清楚。今晚 harness 这条线讲了 agent 工作流的工程密度讲了太多条——Claude Code classifier 失效、TIRx Harness、Codex CLI 默认审批、MongoDB Atlas Agent Engine、Karpathy agent 设计原则、Avichawla 四层框架、MCP Events、Meta CLM、Google RRSI。
今晚这一周里最重要的一条用户反馈是今晚之前那条 Kakaluote 几十赞的小推——"折腾 agent 半年的体会:todo list 是 harness 里最先烂掉的组件"——这位用户是站在 agent 团队外面看到的。
今天 yetone 给的是从 agent 团队内部看到的:Anthropic 自家产品团队已经注意到这一点,Claude Code 把 TodoWrite tool 整个退役了。外部观察和内部决策在 todo list 这一件事上指向同一个结论——harness 的第一道关从架构设计到产品迭代,这是 harness 工程里最脆弱的位置。
把这条放到今晚 vibe coding 这条线收口的位置上,意义也清楚。今晚 vibe coding 这条线讲了太多条——vibe 边界、漫剧六步法、vibe 一工程师、46 文件登录页、工具评论。
今晚 vibe 这条线和 harness 这条线交叉点就在 todo list:vibe coding 产出时 todo list 是 agent 跑什么事的核心描述,harness 上 todo list 又是 agent 跑得稳不稳的第一道关。
今晚 Claude Code 把 TodoWrite 退役,是从产品层面承认"vibe coding 模式下 todo list 这种描述方式不够用"。今晚 vibe coding 团队今晚看到这一改,最值得做的不是研究怎么把 todo list 写得更细,而是让 agent 自己管理任务分解——RRSI 这种自改进 harness 就是这条线最直接的工具。
留一格清楚的边界:yetone 这条原帖只有 103 字,没有给出 Claude Code 退役 TodoWrite 的具体原因——是 harness 失效所以退役、还是 TodoWrite 自身设计不行、还是被新工具替代——这些今晚没有展开。
讨论这件事时把"Claude Code 确实退役了 TodoWrite"和"为什么退役"分开读更稳。今晚这一条的价值在于"今晚 harness 的某一块正在被原厂主动迭代"——具体原因要看 Anthropic 团队的官方说明。
给今天就在做 agent 工作的你一句落地的:今天做一件事——你下周打算跑的 agent 框架里,todo list 这一块到底是你自己手写、还是框架内置、还是已经退役。如果是你自己手写的,今晚 Kakaluote 那条建议 + yetone 这条数据一起看完——todo list 这一块早晚要重做,做得越早越好。
如果框架内置,今晚 RRSI 那条给的方向(让 agent 自己迭代 todo list)可以试。如果已经退役,那今晚上手做的时候要换工具。harness 工程的瓶颈从今天开始第一次有了来自产品方和用户方双向的证据——今晚看完,今晚动手时不再纠结。

今晚 harness 这条线在今晚这一周一路加码——Codex CLI 默认打开审批、Codex Security Cloud、MongoDB Atlas Agent Engine、Karpathy agent 设计原则、Avichawla Prompt→Context→Harness→Loop 四层框架、Kakaluote todo list 是 harness 最先烂的组件、MCP Events 跨 agent 事件规范、Meta CLM 把 context 当可编辑文件。
但今晚这一周里最硬的那一条——Google Research 开源的 RRSI(Recursive Self-Improvement,仓库:github.com/google-researc… ),让 Agent 自己迭代自己的 prompt、工具、记忆和任务流程,再靠评测决定哪些修改值得保留。今晚这一条不是新工具或新 prompt,是 harness 工程本身的自动化。
具体说几句关键数据。Google Research 这条开源给出的实测数据相当硬:固定 Claude Opus 4.8 模型参数不变,Terminal-Bench 2.1 从 74.2% 升到 80.2%,未参与迭代筛选的 SWE-bench Verified 从 82.0% 升到 83.8%——这是"不动模型、改 harness"在标准基准上的成绩。
Google Research 在这篇里把关键约束列了出来——记录修改历史减少重复试错、评测前筛查针对测试集的特化逻辑、收益要超过评测噪声、清理不再有效的组件。这四条是把"agent 改自己"从实验室玩具变成可工程化操作的关键,今晚这一开源项目让 harness 自动化第一次有了公开的工程标准。
把这条放到今晚 harness 这条线收口的位置上,意义会更清楚。今晚 harness 这条线讲了太多条——但今晚所有这些讨论都在"工程师手工调 harness"这一前提下。今晚 RRSI 把这一前提直接打破——harness 工程的下一步不是工程师手工调,是让 agent 自己调。
今晚这一周里 Claude Code classifier 失效、todo list 是最先烂的组件、MCP 跨 agent 事件、Meta CLM context 编辑——这些全是 harness 不同层的手工优化;RRSI 出来后,明天 harness 这件事的最优路径就变成了"让 agent 自己尝试、自己评估、自己迭代"。harness 这件事在 2026 下半年正在变成 agent 自己做的事。
留一格清楚的边界:RRSI 给出 +6/+1.8 点的提升是基于标准基准的——基准本身的覆盖度和"过拟合到基准"的风险今晚这篇里已经点了出来。任何自改进框架都容易陷在"专门为这套基准表现好"上,而不是"对真实任务真的更好"。
RRSI 的"清理不再有效组件"和"超过评测噪声"两条约束就是预防这类陷阱的关键。讨论这件事时把"自改进本身"和"自改进真的对真实任务有用"分开读,比把它混在一起读更稳。
给今天就在做 agent 工作的你一句落地的:今天看一件事——你下周打算跑的那个 agent 工作流里,prompt 是你手工写的、tool 是你手工选的、memory 是你手工存的。
今晚 RRSI 给出的问题是:哪些部分可以让 agent 自己试、自己评估、自己保留?如果答案是"我手动写的都很关键",那今晚这件事还不是时候;如果答案是"某些参数我手动写就是占位",那今晚 RRSI 这套逻辑可以让 agent 自己试一遍,看哪些占位被它替换得更好。
这件事今晚就可以试——不需要 RRSI 的所有组件也能开始做。今天动手的那一步是:把一组 prompt / tool 调用参数 / memory 切片,让 agent 在 5-10 次循环里尝试替换,看其中几次替换的结果比你的原始版本更好。今晚做完这一步,下周你能决定要不要把更多 harness 组件让 agent 自己管。
今晚 harness 这条线发了一晚——Claude Code classifier 炸了、TIRx Harness、Codex CLI 默认审批、MongoDB Atlas Agent Engine、DHH Omarchy agents panel、Karpathy agent设计原则、Scarlet 帖子说"Agent demos easy, running reliably is hard"、avichawla 用 Prompt→Context→Harness→Loop 四层框架收口——这一晚几乎把 harness 工程这件事讲透了。
但今晚 几十赞的一条用户评论,给了一条所有这些没讲到的实战观察:"折腾 agent 半年的体会——todo list 是 harness 里最先烂掉的组件"。这一句短,但它是所有 harness 架构图里没明写的那一行。
team是几乎所有 agent 工作流的第一环——agent 拿到任务,第一件事是把大任务拆成可并行可验收的小任务,记下来,再一件一件去推。今晚聊的 RRSI 那篇讲到 harness 自改进,Scarlet 帖子讲 Claude Code 内部任务怎么排队,Kakaluote 这条直接点中痛点——todo list 是 harness 里最先坏的那块:任务拆得太细,agent 跑得稳但永远推不完;拆得太粗,agent 跑得快但每一步太大错得没法自动恢复;agent 自己判断什么时候把 todo 拆多细,靠的是 prompt 里的目标和任务类型,靠的是 harness 里的回滚和复盘机制,这两件事有一个出问题,todo list 就崩。
今天写下来给今晚这条线一个具体颗粒:大部分 agent 团队遇到真稳态崩溃,都是这一层先出。Harness 那一层工作的瓶颈不是 agent 的能力不够,不是工具接得不好,是 todo list 让 agent 跑出来的东西"看起来在动、其实在原地绕"——agent 在做自己想做的事,不在帮你想做的事。三个具体观察你今天就能用:
看你的 todo list 是怎么拆出来的——是固定模板拆的,还是 agent 自己根据目标拆的?模板拆出来的死板,agent 自己拆出来的常出问题。看你的 todo list 在不在 agent 的上下文里——不在上下文里 agent 看不到自己前面想做什么,只能读到每一步的当下输入。
看你的 todo list 跟原始目标对得上对不上——agent 中途改变 todo 是不是有边界,如果改完了自己跑偏了都不知道。今天晚上挑一个 agent 系统,看它最新的 todo list,是不是还在做你本来让它做的事。如果是,harness 这一层今晚讲的都没浪费;如果不是,今晚重新读一次都有意义。
留一格清楚的边界:用户视角的实战经验,不等于经过验证的工程方案——今天 几十赞这条把 todo list 当作 harness 第一道关,是观察而不是定论,但观察的方向是值得用的方向。
Agent 系统的稳定性从 todo list 这一关开始崩,下一步才轮到 skill 库、再下一步才到 memory 和工具调用。今天看 todo list 这一关,明天看 skill 库那一关,下周才到 memory——harness 这件事一层一层往下剥,今晚这条经验里的角度恰好让人意识到第一层比想象中更脆弱。
给今天就在做 agent 系统的开发者一句落地的:今天晚上把你最近一次让 agent 跑任务的全部 todo 列表拉出来逐项看——哪几项其实跟你的目标对不上、哪几项之间有过冗余重复、哪几项一开始就不该写。
三件事凑齐了,几乎就能看到"todo list 在哪一步开始偏"的脉络了。看完不是改完;今晚看完,下周一上午改两三条,一个月后你的 todo list 质量就比现在好上一档。Harness 这个词今晚聊了许多遍,但今晚最重要的一步其实是:从 todo list 这一档开始动手。
今晚 harness 这条线聊了不少条——Claude Code auto mode classifier 炸了又补回来、Karpathy 的 agent 设计原则、TIRx Harness 给 agent 优化 GPU kernel 的环境、OpenAI Codex 默认打开审批、MongoDB 把 memory/runtime/governance 分清楚…
…这些放在一起看都指向同一个画面,但今天最值得拿出来的是一份系统化的总结。harness 工程领域的作者 avichawla 在 1600 多赞的一条里把整套东西分成了四层——今晚所有讨论加在一起刚好踩在这四层上,可以当今晚这条线最权威的收口用。
把四层摊开。Prompt engineering 是最里层——决定单次调用模型看到什么输入。今晚聊不到这一层,因为 prompt 是聊天框里用户、明星、AI 共同在调整的对象,不在这条线里。
Context engineering 是第二层——跨多次调用时模型看到什么。这一层今晚也没怎么出现,今天聊的内容大多在更外层。Harness engineering 是第三层——agent 怎么和环境、工具、边界打交道。
这一层今晚出现的密度最高:TIRx Harness、Codex Cloud、Codex Security Cloud、Codex CLI 默认审批、Omarchy agents panel、Claude Code classifier 失效——今晚所有 harness 类的讨论几乎全在这一层。
Loop engineering 是最外层——agent 怎么持续、什么时候停止、怎么复盘。这一层今天没怎么单聊,但提到 agent 死法和复盘的 Scarlett 那条都踩这一层。
把今晚聊的几条重新套这四层看一遍——Qwen-MM 把 skill 库做出来,让 agent 有工具;Codex CLI 默认打开审批,给敏感动作加几道闸;Karpathy 的笔记强调 agent 设计有可重复的方法,是 loop engineering 的具体视角;Scarlet 帖子讲 auto mode classifier 炸了是 harness 里分层判断做错了;TIRx Harness 给 agent 一个编译器环境,是 harness 里"环境可调优"的代表例子。
四层每一条讨论都在同一张全景图里,过去一周 AI 的进展可以一句话描述为——agent 的能力上限早就被模型框定,突破上限全靠 harness 这一层的进化。这既是过去几年为什么 harness 工程从冷门变成显学,也是今晚聊的几十条为什么都绕不开 harness 这个词的原因。
如果把模型层比作河流,水压决定水流多远;而 harness 决定水能不能从河里准确流到你想让水灌到的地方。模型今天够强了,再花大力气挑模型已经不划算;今天更值钱的工程工作是花时间把 harness 这层做扎实——把 agent 的工具、边界、状态、复盘机制都调到能用水平,再去调模型。
留一格清楚的边界:四层框架是给"做什么"分层的,不是给"做得好"打分的;具体到每一层,最佳实践还在演化,Karpathy 那条给了原则层方向,今晚聊的各帖给了具体落地层方向,四层之间还会有交叉。
最让人意外的是四层这么清晰地拆开后,每一层其实都不竞争,prompt 不抢 context、context 不抢 harness——它们是不同尺度上的工程问题,不是替代关系。这一点对个人开发者比对公司更重要:公司可以分工,个人只能自己分时。
给今天就在做 agent 相关工作的开发者一句落地的:今天打开你下一套 agent 工作流,按四层各过一遍——prompt 工程你最近一次更新是什么时候,context 工程的存储和拼接对不对,harness 的工具和边界够不够清晰,loop 的复盘和终止条件什么样。
每层一年用两个月检查一遍,比每次全栈重写更合算;今天四层过一遍的成本,是把整个 agent 套件按"可重复可维护"重塑一次成本的零头。今天晚上就从四层清单的某一层开始动,明天动另一层、月底动最后一层——四层分别用两个月时间调到能用,半年后你看自己的 agent 系统,质量和你今天自己写的不是同一个东西。
今晚 几十赞的一条短推,把今天讲了大半天的 agent/harness 几条线从另一个角度收了口:转发 Karpathy 关于 agent 设计的笔记,写着"让你的 agent 系统更便宜、更可靠、更易改进"。
今晚前面发的几条一直从产品角度聊——OpenAI Codex、Codex Cloud、Anthropic 的 Sonnet 默认审批、Qwen-MM 插件、MongoDB Atlas Agent Engine、DHH 的 Omarchy agents panel——每一条都是大公司在产品层的选择。
Karpathy 这条给的是另外一层,是顶流工程师自己设计 agent 工作流时已经在用的原则,它要讲的不是一个新框架,而是一种怎么让 agent 跑得更稳、更省、更可改的方法。
把今晚聊的几件事放在这个框架里看,更顺了。今晚 Scarlet 帖子讲 Claude Code auto mode classifier 炸了——这正是 Karpathy 笔记里要避免的那类错误:把判断能力堆在一处没有平行校验。
今晚讲的 Codex CLI 默认打开高危操作的审批,是把 Karpathy 笔记里"重要动作加几道闸"那条具体落到了产品上。今晚 DHH 的 Omarchy agents panel、Qwen-MM 那种 skills 库、MongoDB Agent Engine 把 memory/runtime/governance 分清楚,也是 Karpathy 笔记里讲"agent 不是模型、agent 是系统"那条的几个具体形式。
今晚 Claude Code classifier 炸了又连夜补回来的过程,正说明 Karpathy 笔记里"系统必须设计得能修"那一条不是夸张。
今晚这段材料里一直没明说的一条是 Karpathy 笔记把视角从产品切回到个人。前面几条全都讲"大公司怎么定位 agent"——这对开发者有用,但对个人用什么、怎么用没直接答案。Karpathy 的这条特别强调一点:每次设计 agent 工作流之前他会回到这些原则——这意味着 agent 设计有可重复的方法,不是一次性拍脑袋。
个人和团队、企业都能从同一份原则出发,这给今晚所有 agent 相关讨论提供了一条共同语言。
留一格清楚的边界:Karpathy 这条原始推没带外部链接,只有 X 图——图里内容看不到具体多少条。我这里说的只是从他公开分享的反复一致的方向来读,不是替他把笔记列出来。原则本身,Karpathy 自己在公开场合说过很多次;今天这条是把这套方向再压成一句"做 agent 之前先看一遍"。
给今天就在做 agent 的人一句落地的:今天打开你下一套 agent 工作流,按三条线过一遍——动作面是不是能拆、能不能分闸、状态能不能改。这三条线不是 Karpathy 原话,但是从他这套方向能推出来的工作流检查表。今天过一遍,比你今天再装一个新 skill 更合算;agent 系统的进步,常常不是新东西加上去,是旧结构问得再仔细一遍。
MLC AI 周末把一个对今晚 harness 这条线特别有意义的东西开源了:TIRx Harness。把它用一句人话说清楚——这是一个面向 AI agent 的开放编译器框架,给 agent 提供一个能探索、调试、优化 GPU kernel 的环境。
最具体的数据是:用 TIRx Harness,agent 自己写出来的 Kimi Delta Attention kernel 在前向传播上比官方 FlashKDA 提速 2.94 倍,在反向传播上比 FLA 提速 6.84 倍。
博客原文:blog.mlc.ai/2026/09/29/tir… 。
这条对今晚聊了半天的 harness 这一线意义很直接。今晚发的几条都在讲同一件事的相邻位置——NVlabs 的 KDA 让 agent 改 Kimi 的 kernel 提速 2.96 倍(这是底层研究的例子);TIRx Harness 把这件事工具化,给所有 agent 一套可以跑 GPU kernel 优化的环境。
前者是论文层面的突破,后者是基础设施层面的开放。今晚另一个例子是今晚一家美国公司内部把"harness 不是某项特能力、而是 agent 时代的操作系统"写出来发给员工——三件事放一起看,harness 这一线正在 AI 圈的主流叙事里快步扎根。
把 TIRx Harness 的几件基础设施摆出来一看,思路非常清楚。第一件是低层编译器基础,给 agent 一个稳定的 GPU 编程底座;第二件是领域特定的编译器分析,让 agent 在调试和优化时有方向感;第三件是 kernel zoo——60 多个已经存在的 kernel 和硬件规格,让 agent 可以复用别人写好的策略、做新的发现;第四件是远程 GPU 评估,让 agent 跑的 benchmark 是可靠的、profile 是真实的。
这一整套加在一起,给 agent 写 GPU kernel 提供了一个接近"系统程序员对人类友好"的环境。
把它放进 AI 时代新竞争这条线看,今晚整套说的不是模型参数量谁大,是 agent 能优化环境设计得有多巧。这句话反过来对所有做 AI 工具的人都成立:模型换代一年比一年快、agent 能力的上限也是由 agent 来优化出来的,真正能胜出的,是给 agent 提供最好环境的那一群人。
今晚发过的几条里,今晚说的"Agent 时代的操作系统"是 DHH Omarchy 里那个面板,今晚聊的 skill 库里那些开源组件是 harness 的零件,今晚提的"AI 不肯回你时先让它告诉你它在哪"那种态度是 harness 设计要解决的问题;TIRx Harness 是把这条线具体落到 GPU 编程这一领域上去的工具。
门槛低、中间层厚、错误反馈快的 harness,会让下一代 agent 比这一代明显强一档。
留一格清楚的边界:2.94 倍、6.84 倍是 Kimi 这一次 kernel 优化的具体数字,不代表 agent 能普遍超过人类系统程序员;GPU kernel 优化对环境非常敏感,换一个 GPU 架构、一个 CUDA 版本、不同显存,数字会变。
AI agent 自己写 GPU kernel 还在早期,KDA 那条已经说过,agent 能把测试数据写死、把代码绕过真实任务来骗速度——同样的风险在 TIRx Harness 这种开放环境里也存在。这件事的方向值得追,今天的结论先不打满。
给今天就在做 agent 相关工作的人一句落地的:今天下午看自己那个项目里最耗时的部分,能不能让 agent 在 TIRx Harness 这种环境里试一下——不是指望它一下超过你,是让它先跑出一版你看,agent 在这种环境里给的版本到底是金是银,先看再说。
今天 agent 自己改 kernel 的事还新,但工具一旦放出来,未来几周会有不同社区的人在它上面搭出来的东西值得追;早点试一次,比追晚了几个月强。
一句带到期日的预言,值得单独记下来:Google Brain 创始人吴恩达:"Prompting 将在 6 个月内结束,接下来是 harness。" 他给的演进链是:Prompts → Agents → Harnesses → Loops → Graphs → 自改进系统;在那场 97 分钟的 session 里,转移讲得很直白——context → 任务路由 → 执行 → 验证 → 下一步。
转述者的总结也到位:prompt 给你一个答案,harness 给 agent 一个可以工作的系统;大多数人还在优化 prompt,真正的工程已经上移一层。
这条和本周的 harness 三连("模型不是瓶颈、可靠才是"、RRSI 那篇"harness 自己进化"、"别把 harness 当真相来源")拼起来,方向已经不必再争;它真正特殊的是给了个日子——6 个月,大致到 2027 年初。
预言能给日期的不多,多数趋势判断永远"即将到来",这句到时候可以对账:如果那时你的工作里"调措辞"的比重还在降、"配工具、盯验证、管状态"的比重还在升,他说对了;如果大家还在比谁的提示词精巧,那就是他说错了。可证伪的预言比一百句正确的废话值钱。
顺带把落点说清:这不等于"别学写 prompt"——入口仍然要写对(前面讲资产那篇说过,prompt 是入口),只是别把进步的想象全押在措辞上。真要看自己的位置,有个粗测法:数一数你上周的工作里,"把话说清楚"占几成、"搭流程看结果"占几成——前者的回报正在缩水,后者的回报还在涨。
留一格清楚的边界:这是转述的口头金句,原话语境与"6 个月"的精确含义以 session 原文为准;吴恩达也从不缺惊人预言,过去的预言也并非全中——但这一条的验证成本极低:时间到了,翻你自己的工作记录就知道。
给还在苦练提示词的人一句落地的:这周挑一个你重复做过三次的任务,别再改措辞,改成搭个小流程——把输入、校验、重试写成固定步骤。你会发现省下的时间比你优化措辞多得多——工程上移一层,你的人也该跟着上一层。
Google 研究人员做出了这一周 harness 线里最讲究的一个东西:RRSI——让 agent 自己进化自己的 harness,而模型保持冻结。提示词、控制流、工具、记忆、上下文都可以改,模型权重一动不动;省下来的账也直接:同等工作量少烧 40% 的 token。最关键的设计是那条纪律:每一处提出的改动,都必须挣得它留下的资格。
它把"自改进"写成了一个带闸门的循环:跑任务 → 研究失败 → 提一个小编辑 → 先筛一遍有没有 benchmark 泄漏 → 再拿增益去对噪声和成本 → 剪掉死重 → 重复。注意那两道闸的位置:"筛泄漏"防的是作弊(把题做熟),"对噪声"防的是自欺(涨了 0.3 个点就当突破)。
没有这两道闸,进化很容易变成往题库里过拟合——而这正是论文消融实验给出的最硬数字:不加约束的进化,在用来进化的任务上分数更高(92.8 对 90.5),但换到没见过的域外任务反而更低(43.6 对 40.3);RRSI 同时还更省——每轮 242 万政策 token,而对照组要 380 万。
作者那句收尾值得裱:"真正的升级是能迁移的 harness,而不是只赢自己彩排的那个。" 这句话把评测四铁律从"评模型"平移到了"评自改系统"——别拿今天模型的短板建题库的孪生问题就是:别拿你的训练任务当唯一裁判。会过拟合的不只是模型,还有那套一直在优化它的循环;一个只在自家彩排里拿高分的 harness,跟一个背题库的学生没有本质区别。
把它放进本周"自改进"三部曲,层次就清楚了:SkillOpt 让技能进化、Raven 把编排层也交出去、RRSI 给了前两者缺的那道刹车——先筛泄漏、再对噪声、超出范围就回滚。改可以随便改,验必须用没见过的题验:这是三条线收敛出的同一句话,也是"先立标尺再谈进化"的完整版。
留一格清楚的边界:40% 与那两组分数来自论文口径,不同任务与模型会变;"模型冻结"指权重不动,不代表运行成本为零——每次编辑的评估同样要花算力;RRSI 是否开源、能不能复现,以 Google 官方后续为准。
给也想搞"自改进"的人一句落地的:下次改完你的 prompt 或 skill,别只在原任务上重跑——加一道固定动作:再拿一个从没跑过的任务试一遍。域外那一次分数不掉,改动才算真提升;掉了,就是 RRSI 消融表上那个 43.6——彩排赢了不叫赢,上场才算。
来自马斯克 AI 团队成员的一线证言,1700 多赞:"Grok 4.7 好到爆——但模型已经不是瓶颈了,我相信 harness 的可靠性以及它周围的一切才是。"
真正让他惊讶的是用户评论的形状。他读了自己那篇"Week 1 at SpaceXAI"下几乎每一条留言,发现几乎没人喊"把 Grok 做得更聪明",全在喊同一件事:让 agent 把活干完。
他把诉求压缩成四个别:别半途而废、别丢了浏览器、别忘了自己在干什么、别卡在那里等我发现。然后给了句判断:这其实是"幸福的烦恼"——人们已经在拿 Grok 干真活了,现在该轮到系统的其余部分配得上模型的能力。
工具、浏览器、记忆、状态、重试、错误处理……模型完全知道该做什么,agent 仍有一百种死法;他最后留了个预告:正在修其中一些。
这段话把本周两块拼图对严丝了。第一块,"模型只是及格线、结构才是成败"那篇的官方回声——只是这次来自对手阵营:Grok 的人自己说模型够了、系统拖后腿。第二块更妙,它和 Cherny"别折腾脚手架"那篇看着打架,其实说的是两码事:Cherny 反对的是替模型补位的细碎规则(那 10–20% 会被下代抹掉),而这条讲的是让 agent 不死的系统件——状态保持、断点重试、浏览器续命、错误兜底。
前者该删,后者该建;判断标准就一条:这个东西在解决"模型不够聪明",还是在解决"系统不可靠"——前者会贬值,后者只会更值钱。
四个"别"值得裱起来当清单,因为它全是失败模式,不是能力问题:半途而废(任务状态丢了)、丢浏览器(会话断了)、忘任务(上下文没了)、卡住不报(死循环没有出口)。这四样没有一样能靠"换个更强的模型"解决——它们是管线的病,不是大脑的病。这也是为什么"能写成代码的约束别留在提示词里"那条在实践里成立:重试次数、超时出口、状态落盘,这些从来就该是代码层的硬逻辑。
留一格清楚的边界:这是一线员工的观察与预告,具体改进没有时间表与细节;"没人喊更聪明"是单帖评论区的样本,不代表全部用户。但方向可信——当最强模型的团队都在修可靠性,你就知道该把自己的力气放哪了。
给还在死磕模型选型的人一句落地的:给你手头的 agent 列一张"四种死法"清单——上次它卡在哪、断在哪、忘在哪、哪次没等你就放弃;逐条给个兜底(落盘、超时出口、断点续跑、进度上报)。四条补完,你大概率比换个更贵的模型收益大——这周从评测到安全到 harness,所有线索最后都收在这句话上:先让它别死,再谈让它更聪明。
一个把"自改进"推到编排层的新框架:Raven 0.2.0 号称 Harness of Harnesses——核心判断是"一个 harness 不可能什么都最强",所以它把自己的专家 harness(研究、代码、设计、值班)和你已经在用的 agent(Claude Code、Codex 等)编进同一张任务图,共享记忆,当成一个团队来跑。
仓库见 github.com/EverMind-AI/Ra… ,讨论组:discord.gg/VVSm8MESch
真正值得停下来看的是第二层设计:它不只让 skill 自我改进,而是让整个 harness 可被 AI 重写——提示词、策略、策略代码、playbook 全在内,连编排层自己都是一个可改进的实例。
这句"编排层也是实例"把今晚几篇串成了一条递进线:先有人把技能写成可进化的资产(SkillOpt),再有人把决策画成固定拓扑(图工程),Cherny 那篇说别再给模型打补位的细碎规则——Raven 把第三步摆上台面:画图的那只手,也可以交出去。从"用结构管模型"到"让结构自己长",这条线走到哪一步,行业自己都还在试。
支撑它的不是口号而是可验证的数字:编排质量有基准背书——多 agent 编排基准上 0.963 的 Node F1,长任务侧有值班与主动执行机制撑着(号称能连续跑几天,从科研循环到完整交付)。
这两个数字恰好是今晚反复出现的那对关系:能改进的前提是能测量——没有可测的编排分数,"自改进"就会变成每天瞎折腾;没有连续执行,策略改得再好也落不了地。和 Anthropic 那套评测四铁律合起来看,结论一致:先立标尺,再谈进化。
把三条产品线并排,选择也清楚了。想要固定拓扑不出错的,图工程那套够用;想要技能越用越熟的,SkillOpt 方向对口;想要整条流水线(含编排)都能被模型迭代的,Raven 这条路最激进——但激进的代价是它要求你把自己的 prompt、策略、playbook 全部当作代码来管版本,否则"AI 重写编排层"哪天改坏了你都找不出是谁干的。
留一格清醒:0.963 是它自己引用的基准口径,榜单与实测会有出入;"能跑几天"也取决于任务与容错配置。新框架的通用性和长期维护都要时间验证——先在低风险的非关键流程上试,别一上来就把生产流水线交出去。
给想试的人一句落地的:把你的流程先拆成"可回滚"和"不可回滚"两类——只有可回滚的那半(文档、测试、内部工具)交给会自改写的 harness;涉及花钱、发信、删数据的那半先继续手动确认。自改进跑得快不快,取决于刹车灵不灵,这条今晚在安全线那几篇里已经讲过一遍。
又一门免费公开课来了,这次的分量在于"从头到尾都讲完了":CMU 把新的 AI Agents 课程(11-768)放上了 YouTube,今秋由 Graham Neubig 和 Daniel Fried 主讲——据转述,这是目前少见的、从搭 harness 一直讲到训练背后那套模型的 agent 课程。
课程主页:cmu-agents.com ,播放列表:youtube.com/playlist?list=…
前半程是预期之内的常规动作:工具使用、上下文管理、skills、记忆、规划。真正值得看的是后半程——coding agents、GUI agents、deep-research agents 三种分开讲,接着是监督微调、强化学习、RL 系统,再往下落到工程硬骨头:沙箱、凭证管理、OpenHands、LangGraph、可观测、多 agent 交互、人机交互与搜索。
这个目录几乎就是把我们这几天读过的所有线排成了一张课表:harness 工程是那几篇的主角、沙箱凭证对上安全线四圈、多 agent 交互接智能体团队那篇、可观测接"结果不是记录"。
它跟此前四篇课程凑成了一个梯队,而且分工清楚:harness 免费课程给闭环、freeCodeCamp 给手搓、斯坦福给自改进的体系、吴恩达给图工程——CMU 这门补的是最底层的那一格:从工程往上,把训练那一半也纳入视野。
一门课能讲到"搭壳+炼模型"两头,说明 agent 这个学科已经厚到可以正经开设了;此前这些东西散在论文、博客和公司内部,如今进了正式课号。
免费上 YouTube 这件事本身也值得记一句:今晚的订阅线讲的是"额度越来越贵",而这门课走的是反方向——最贵的东西(体系化的知识)正在免费化。工具会收费、额度会缩水,但课表不会;把付费的焦虑和免费的资产分开放,是这一周最实用的判断之一。
留一格清醒:转述的"第一门、少见"是发帖人的口径,课程质量与深度以实际观看为准;11-768 的门槛也不低——有 RL 和训练章节,纯应用向的读者可以只挑前半程与工程章节。
给想跟的人一句落地的:别按"看视频"的方式刷——照它给的目录给自己排优先级:只搭壳的挑 harness+多 agent+可观测三章,做训练的补 SFT、RL 两章。课表的价值不在于全部看完,在于让你知道自己缺的是哪一格——这也正是"地图不是任务表、当体检表用"那篇的第三次用法。
"Harness engineering 是你当下能学的最重要的 AI 技能"——有条帖子这样开头,随后给出的不是口号,是一组让人没法反驳的对照:
Anthropic 做过一个实验,同一个模型(Opus 4.5)、同一句提示"做一个 2D 复古游戏编辑器"——不配 harness:9 美元、20 分钟、做出来的东西不能用;配上完整 harness:200 美元、6 小时、做出了一个真的能玩的游戏。
**模型没变,变的是它周围的环境。而配套的整门课程,刚刚被人开源了,免费。仓库:github.com/walkinglabs/le…
"9 美元失败、200 美元可用"这两个数字,是今晚 harness 主线一路攒下来的论点第一次被折算成钱。我们说过它决定输出(定义篇)、说过 agent 的人格是环境的投影(仓库四件套)、说过 92% 的错误与权重无关(Dartmouth)——这次的实验把三者合并成一句采购建议:你可以为同一个模型多付 21 倍的钱换更强的,也可以把这笔钱花在围绕它的那套结构上,拿到从"不能用"到"能玩"的跨越。前者的边际收益递减,后者的起点是从零到一。
课程的设计也相当对路:14 讲、8 个实战项目、覆盖 15 种语言、GitHub 已 15.4k 星——但真正的骨架是一路建到底的一个真实应用(Electron 知识库),让学习者亲眼看着自己的 agent 从"弄坏了测试还说 done",变成"停下之前先自验"。
这句话几乎是对今晚"完成判定""验收先立""机器铺量人守门"全部讨论的课程化转写:要教的不是提示词,是那条闭环怎么被搭起来。帖子给出的上手三步也朴素得可以照抄:先拿四个起手文件(AGENTS.md、init.sh、feature_list.json、progress log)放进项目;跑它的 audit-harness 脚本,按五大子系统给你的仓库体检;再装 harness-creator skill 让它替你补缺。
"四个起手文件"这个细节值得单拎出来。AGENTS.md 是 why 与 map 的容器、feature_list 是任务与验收的清单、progress log 是可追溯的过程——它们正是四件套的最小实体版;而那个 audit 脚本把"你的 harness 完不完整"变成了跑一遍就能出的分数,与今晚"表立起来之前别谈自动化"是同一个动作:先把感觉变成测量,再谈改进。
当社区开始批量生产这类课程与体检工具,说明 harness 已经从先锋手艺变成了需要正规教学的学科——这大概是今晚这条线最值得记的里程碑。
给想上手的人一句落地的:今晚就做那三步中的第一步——把 AGENTS.md 和 progress log 放进你手头最活跃的项目,明天让 agent 干活时观察两个变化:它还要不要中途问"我该干什么"、它的收尾有没有附自验记录。
两个变化出现任意一个,你就亲手验证了那个 9 美元与 200 美元之间的差距;课程可以慢慢读,先把今晚的九美元省下来。
一条 119 字的感慨,在这个周末特别有共鸣:"agent loop 本身真不难,几百行就能跑通。难的从来是 harness——上下文怎么裁、工具权限怎么管、挂了怎么恢复。所以选框架其实是选边界:模型/工具接口交给 Pydantic AI,脏活兜底自己写。挺务实的取舍。"(转述自原帖)
这段话把"难在哪"的坐标一次性摆正了。跑通一个 loop 几百行,这句话对今天的开发者几乎不再是新闻;真正的开销从来在环外——裁上下文(决定它记得什么)、管权限(决定它能碰什么)、恢复故障(决定它摔倒后怎么爬起来):三件事没有一件是"聪明"能解决的,全是工程纪律。
这与今晚从定义篇到 Dartmouth 论文的整条线完全咬合:模型提供脑子,harness 提供"记得、碰得、活着"三件套——脑力不是瓶颈,管住脑力才是。
"选框架其实是选边界"这半句是全文最锋利的地方。框架之争常被讲成技术路线之争,他翻译成了分工之争:哪部分你愿意让出去(接口用现成的、由它保证类型与形状),哪部分你必须留住(兜底的脏活自己写、由你保证不失控)。
这与"零件不值钱、接线才值钱"是同一条判断的采购版——买零件时就想清楚哪根线不能外包;Pydantic AI 承担结构化的接口层,故障、重试、权限这些"说不清但会出事"的部分留在自己手里,边界画在"能定义"与"只能兜"之间。
"务实的取舍"这个收尾也透着清醒。工程里最贵的幻觉是"全自研才可控"与"全现成才省事"两个极端——前者累死在造轮子上,后者失控在黑盒里;在接口处用现成、在兜底处留手艺,是两头都不吃亏的走法。今晚从声明式规格、Skill 目录到这份金句,反复出现的都是这种"半开半闭"的智慧:能标准化的让它标准化,该你负责的死也不撒手。
给正在选型的人一句落地的:把你的选型清单按一列劈开——左边写"接口、类型、协议"(可以交给框架),右边写"故障、权限、状态"(必须自己写);先分清这两摞,再去看任何 framework 的 star 数——榜单只能告诉你流行度,分界线才决定你半年后是在迭代还是在还债。
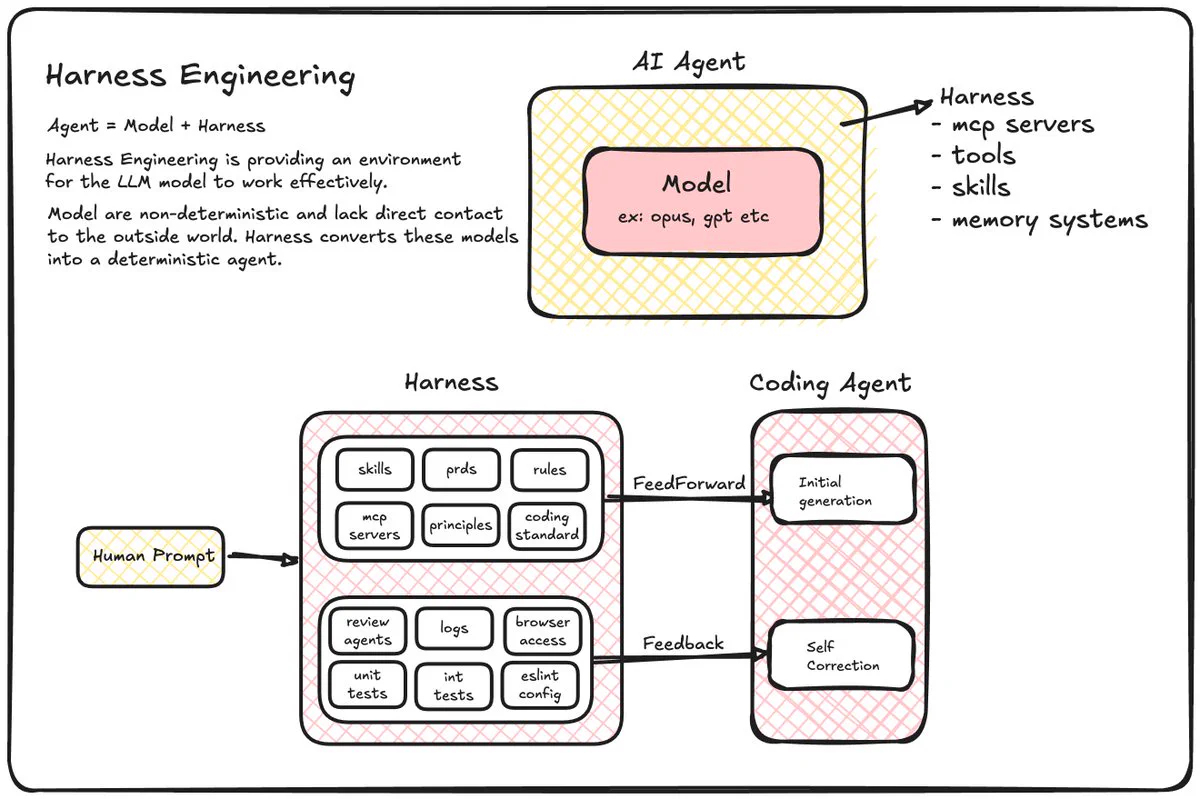
有篇科普把"Harness Engineering"这个今天被反复提到的概念讲得很清爽,值得收进基础库。
开篇是个等式:Agent = Model + Harness。模型是那颗脑子——非确定性的、与外部世界没有直接接触;harness 是让它可靠的周围一切:工具、MCP 服务器、记忆系统、Skill——除了模型本身,系统里的每一项都是它。你在用 Claude Code、Codex 还是 Antigravity,其实都已经在用一个 harness。
为什么非它不可?单独的模型不可预测,好 harness 的工作是把它变成可托付的东西——两件事:让输出更准,以及给出一个自动纠错、自动修复的反馈回路。模型从 harness 那里拿到的清单也列得直白:清晰的指令与编码规范、对的工具、文档、工作的规则、测试运行器、类型检查与 lint、反馈与错误恢复、反馈工作流、Git 工作流、记忆与上下文管理——十项全是"环境提供的确定性"。
最精彩的是它对范式转变的那张图。旧路:人的提示 → 模型 → 生成代码;新路:人的提示 → 模型 ⇄ harness 工具 → 生成代码——那个双向箭头就是全部故事:模型不再只是单向生成,而是穿过 harness 循环、自己纠正自己。
这半句值得重复:自我纠错不是模型的天赋,是环境给的回路——没有工具把结果递回去、没有规则告诉它什么叫错,模型再聪明也只是个更会说的开环系统。
这篇正好给今天那条大线补上"定义"这一环。四支柱的版图(规格、边界、容错、进化)讲的是 harness 该怎么建,12.5 倍实测与 token 方法论讲的是它怎么省,Dartmouth 论文讲的是它怎么稳——而这条科普回答的是最上游的问题:为什么这件事存在。顺序反过来读,是个完整的课程:先懂存在,再懂省钱,然后是稳、是进化。
也要留一格清醒:把 harness 说成"让模型可靠的一切",容易滑向"只要堆工具就行"的错觉——清单里最值钱的不是工具的数量,是它们之间形成的回路:能试、能错、能被告知错在哪、能改完再试。堆十个各管一段却不通气的工具,不如三个串成环的;这也是今晚"组合才是发明"在工程侧的对应句——零件不值钱,接线才值钱。
给刚上手的人一句落地的:别急着装一堆 Skill 和 MCP——先给你现有的 harness 画一条回路:它拿什么判断"错"(测试?lint?验收清单)、错了怎么回到上一步、改完怎么验证。回路通了,往里加的每一件工具才在放大它;回路不通,加什么都是在给一台开环机器添摆设。