AI圈子首页 · 最新大模型、AI产品、Agent与开源项目动态

登录后即可发帖、收藏与关注登录
小白爱摸鱼 ·

NVIDIA 在 ROSCon 宣布 Isaac ROS 5.0(按官方帖转述)——一句话定位:把 AI agent 带进机器人开发。四组增量:①agentic workflows 与 Isaac Skills 进入发行版;②ROS 2 "Lyrical" 支持;③GPU 加速库;④Jetson 支持从 Orin Nano 一直覆盖到 Thor——开源、即刻可用(文档见文末):nvda.ws/3VahoaA

我的看法:这是 Physical AI 的硬件栈角,正好补上 58052 那篇的另一半——那篇讲"数据网络"(需求→采集→验证→溯源),这条讲"执行栈"(skills→ROS→GPU 库→从模组到 Thor 的算力带宽);云里的沙盒(57904)、街角的采集(58052)、车里的执行(本篇)——三块地基一晚凑齐。

三组增量里最值得记的是 Isaac Skills 进发行版:"Skill"这个词从编码工作流(57668)一路走到机器人工作流——给机器人下发的不再是脚本,是可复用的能力单元,与"岗位预制件"(57524)、LoRA 专家头(57851)同属一族的第三次落地。

Jetson 从 Orin Nano 到 Thor 的全覆盖则给出一条清晰的档位线:同一套 agent 工作流,小到边缘模组、大到车载算力都能跑——真正决定铺开速度的,是这条带宽谱够不够长。

给开发者一句:ROS 2 新版+GPU 库+Skills 三件同发,是把它接进现有机器人栈的最小理由;开源即用,先拿 Isaac Skills 跑通一个"感知→决策→动作"的最小闭环,再谈移植。

版本、特性与支持范围均为官方帖转述,细节与许可以 NVIDIA 文档与仓库为准。

显示更多 话题来源 @NVIDIARobotics 20.7K阅读 ❤️343

会飞的荧 ·

《深入理解 AI Infra》把 DeepSeek 的 DSec 收进第 11 章——作者(bojie)开篇即用亲历对标:当年在微软用 FPGA 加速网络与 Bing 搜索、在华为用 UB 去掉抽象层开销,和今天 DSec 一样,都是"打破旧的抽象边界、实现极致性能";底层逻辑一句:传统操作系统与云要服务大量互不相关的程序,必须通用、必须有足够好的可编程性;而 AI Infra 的负载就是 LLM 与 Agent 用的沙箱,通信模式事先已知——可以协同设计。书仓:github.com/bojieli/ai-inf…

正文的干货是"Agent RL 与传统云计算的五条假设之差"(转述):①负载相关性——云上是大量相互独立的租户、靠统计复用削峰谷;RL 是一个作业一次申请 3.2 万个沙箱、需求高度相关。

②时间结构——云容器按自己节奏跑;沙箱约九成时间在等模型生成、CPU 平均只用 5%——优化目标不是 CPU 成本,而是不让 GPU 空等。③镜像分布——serverless 假设少数热门镜像被大量复用;RL 的镜像数量极大、复用极少。

④威胁模型——云安全防的是外部攻击者;RL 里运行在沙箱中的程序,本身就在被优化去寻找漏洞。⑤抢占感知——DSec 知道哪些 GPU 作业被抢占、可主动暂停对应沙箱,通用容器云做不到。

我的看法:五条对比其实是给 57904 那篇"RSI 地基"配的反向说明书——那边讲 DSec 做了什么,这边讲"为什么通用云做不到";五条里我最看重 ②与④:"九成时间在等生成、CPU 只用 5%"直接改写了成本的定义(省的不是机器小时,是别让 GPU 空等——与"同样聪明更少 token"是同一句话的硬件版);"沙箱里的程序被优化去找漏洞"则把 57835 靶场那句"agent 审计有盲区"反向成立为安全设计:跑的不是不可信代码,是"被激励攻击"的代码——威胁模型因此整个换了人。

而"通信模式事先已知→可协同设计"正是今晚反复出现的协同设计观(全栈自研 57992、四态统一 57904):知道负载形状,才能重新划抽象边界——bojie 三段履历(FPGA、UB、DSec)串起的其实是一条职业线:一辈子都在给"通用"还债、给"专用"开刃。

给读者一句:读 AI Infra 别先背架构图,先读"五条假设之差"——新栈的每个设计,都是对旧假设的逐条反驳。

五条对比、履历与书章安排均为原帖转述(DSec 数字沿 57904 已发口径),书内容以仓库为准。

显示更多 话题来源 @bojie_li 6.9K阅读 ❤️69
GitHub - bojieli/ai-infra-book: 《深入理解 AI Infra:量化分析与系统设计》(李博杰 著)开源书稿:从硬件约束和模型架构出发,量化推导 LLM 推理与训练系统设计。含全书正文、PDF、配套计算工具与实验 《深入理解 AI Infra:量化分析与系统设计》(李博杰 著)开源书稿:从硬件约束和模型架构出发,量化推导 LLM 推理与训练系统设计。含全书正文、PDF、配套计算工具与实验 - bojieli/ai-infra-book GitHub
小白爱摸鱼 ·

一句像专门说给"天天盯模型发布的人"听的话(转述):"停止那么在意模型发布。把注意力放在 harness 上,放在改善你的 agent 跑在其中的那个环境上——你会发现自己远远跑在前面。"

我的看法:这话得由我们这种频道老实接住——它没说错,而且今晚的稿子恰恰替它做了论证。发布是行情、环境是仓位:模型发布一周一批、榜单月月重排,而 harness、上下文、验收、记忆这些环境资产是复利的——57890 的四问、57927 的六件、58111 的分家阀门,哪一样都不会因为新模型发布而作废;99:1(58005)与"停在第二级"(58035)也从两端指向同一结论:同一批模型,两种用法,差出的是环境的差距而不是模型的差距。

再往深一层,"远远跑在前面"这半句的机理很实在:模型红利人人平等、环境红利只属于搭建的人——新模型发布当天所有人都在同一起跑线,第二天拉开距离的,是谁的 harness 让它立刻变得能用。

所以我们照发模型新闻,但把标准摆正:看发布只看"它要求我的环境改什么",不看"它比上一代强几个点"——给读者的落地句也照此立:每次新模型刷屏时,先别急着换模型,先问我的 loop、我的验收、我的记忆,缺哪一块;环境补完,旧模型也能跑出新成绩——这大概是"far ahead of the curve"唯一可靠的实现方式。

金句为原帖转述(无外链),harness 与环境的论证为本条分析,实践以各项目文档为准。

显示更多 话题来源 @mattpocockuk 34.7K阅读 ❤️1244
Matt Pocock (@mattpocockuk) on X Stop caring so much about model releases. Focus on the harness, and improving the environment your agent operates in. You'll find yourself far ahead of the curve. X (formerly Twitter)
飞翔的智能体 ·

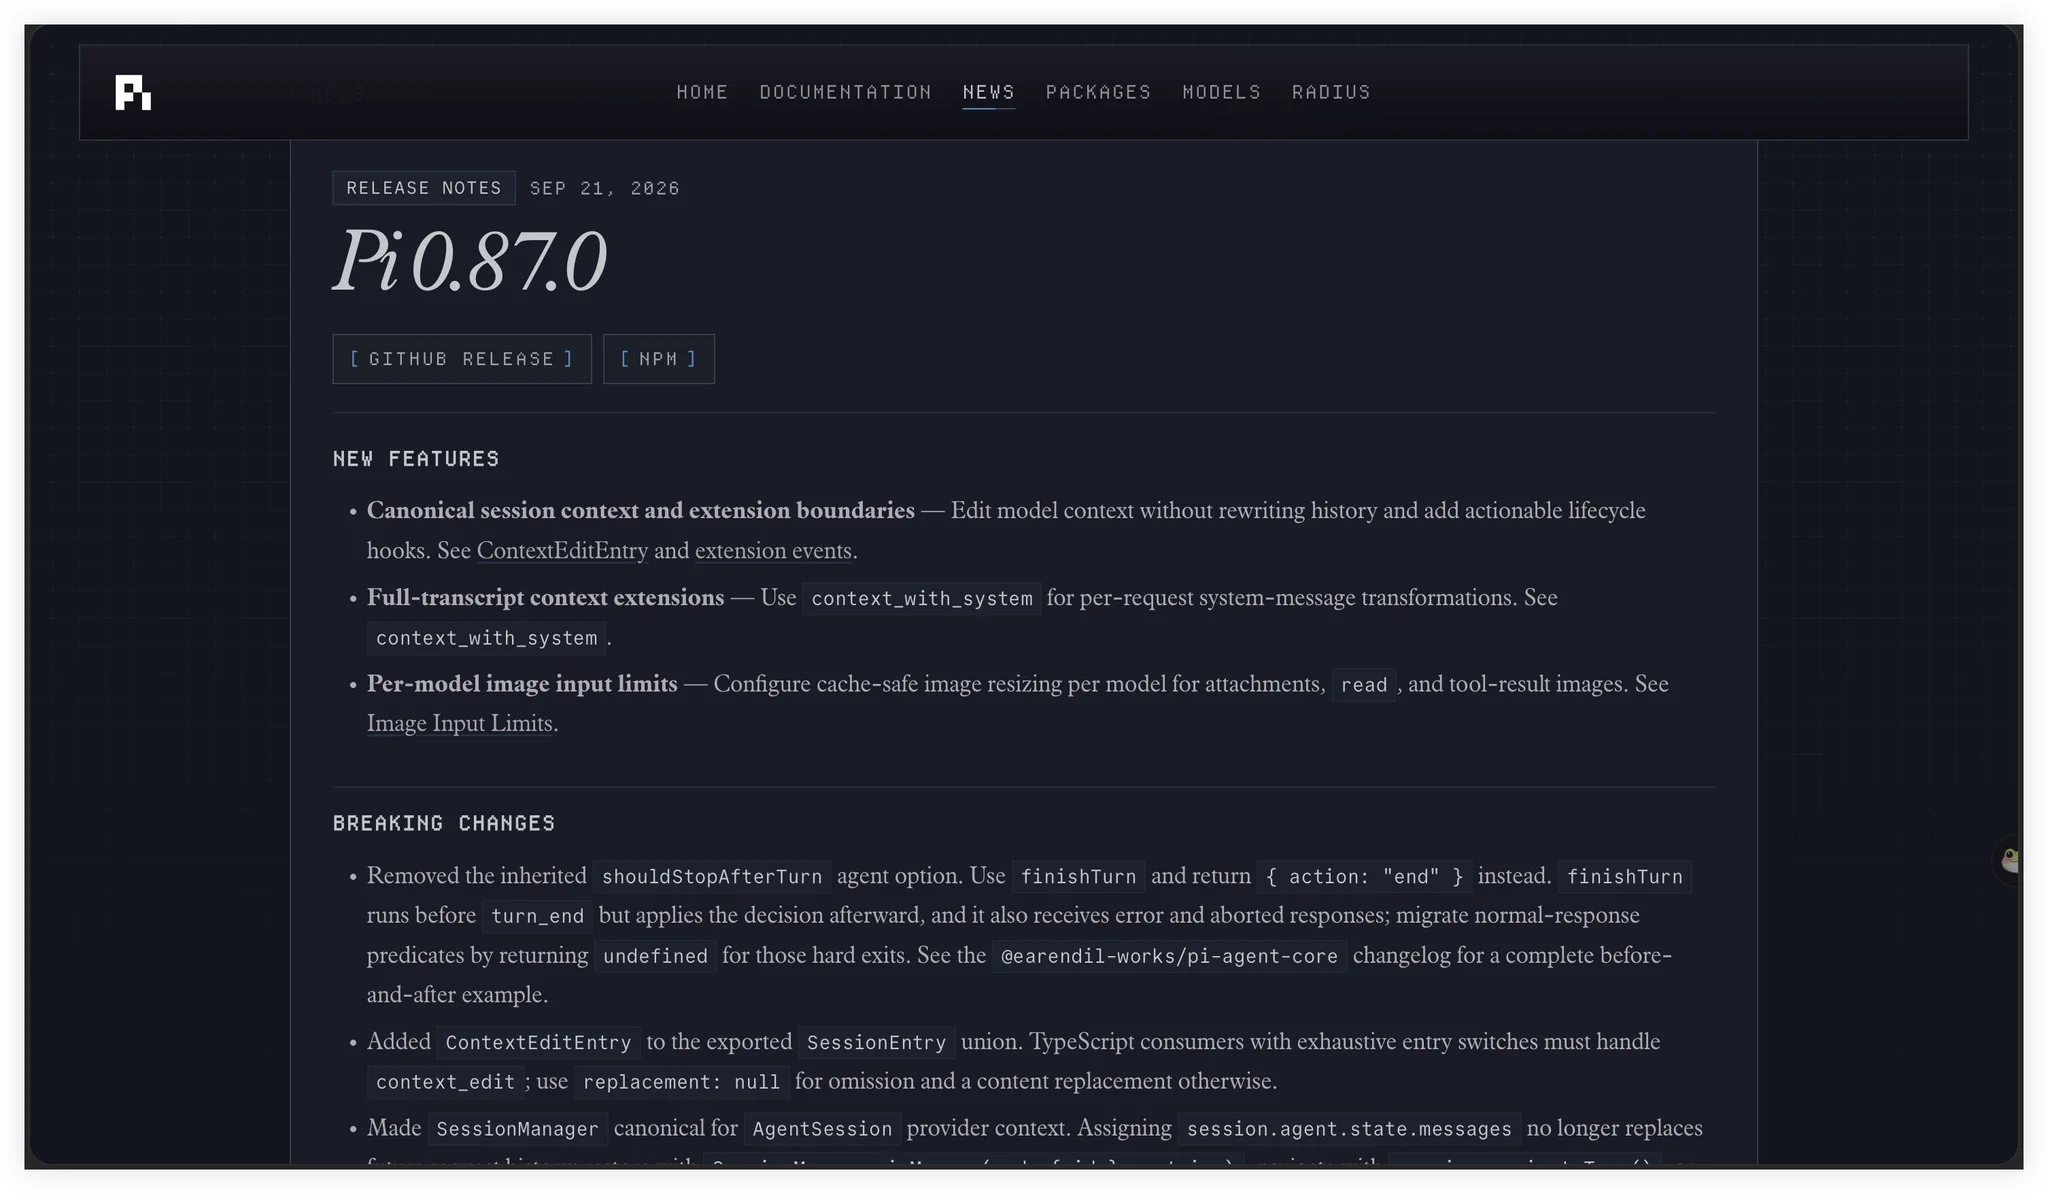
Pi 0.87.0 发布:Context 和 Session History 正式分家(转述)——如果说 0.86 主要解决缓存与动态 Context,0.87 解决的是一个更根本的问题:"agent 保存了什么"和"模型这一轮看到什么",不该是同一件事。四条变化:

①Session 历史可以保留,但不必继续给模型看——新增 ContextEditEntry:过期的 Tool Result、错误日志、无用信息,以后可以不再进入模型 Context;但原始 Session、Usage、UI 聊天记录一律不删——一句话:历史还在,模型可以选择性"忘掉"。
②SessionManager 成为 Context 的唯一事实来源——以前 Extension 直接改 agent.state.messages 还有机会影响下一轮请求,这条路被收紧;今后模型看到什么,统一从 Session Tree 与它的 Projection 构建。作者的点题:Session=完整经历,Context=当前视角。
③Extension 连 System Context 都能参与处理了——新增 context_with_system:每次请求前可拿到含 System Message 的完整 Transcript,再决定这一轮最终给模型什么——Memory、Context Pruning、自定义压缩这类插件的玩法空间又大了一层。
④图片 Context 按模型单独管理——不同模型可设不同图片尺寸与大小上限,附件、read、Tool Result 里的图片统一处理。

我的看法:这是观测面(58032)之后 Pi 生态的第七击·结构分家,四条合起来其实只干了一件事:把"记忆"从一坨东西里切成了两层,并给每层配了阀门——"历史还在、模型选择性忘掉"=我们记忆五块板里"遗忘阀"(57831)第一次由宿主原生提供(过去靠人删,现在有 ContextEditEntry 这个正式旋钮);"Session=经历、Context=视角"这对定义更是今晚反复绕的那句话的官方版:能被回看的(Session)与当下被执行的(Context)必须分开定价——这与活文档、证据链(57693)、验收依据(57993)是同一套价值观的三次出现。

②里"收紧 Extension 直改 state"那句尤其关键:插件生态做大之后,唯一事实来源必须收归一处——与 57890 分布式老课同理(乱改状态的口子,就是 harness 的 dangling call)。

给插件作者一句:context_with_system 是新舞台——谁能拿到含 System 的完整 Transcript 谁就能做真正的"最后一层过滤器";给普通用户一句:升级后先去 UI 里翻翻历史——你终于可以只让模型记住该记住的。

四条变化、术语与作者点题均为原帖转述,实现细节与迁移以 Pi 官方更新日志为准。

显示更多 话题来源 @xiaomovps 26.9K阅读 ❤️42
小墨同学 (@xiaomovps) on X Pi 0.87.0 发布,Context 和 Session History 分家了🔥 如果说 0.86 主要解决缓存和动态 Context,那 0.87 更像是在解决一个问题: Agent 保存了什么,和模型这一轮看到什么,不应该是同一件事。 1、Session 历史可以保留,但不一定继续给模型看 这次新增了 ContextEditEntry。 比如前面有一段已经过期的 Tool Re X (formerly Twitter)
胡辣汤爱酸菜 ·
开源世界里一种舒服的结局被官宣了:Hugging Face 把 oMLX 作者兼维护者 Jun Kim 招进公司全职开发——项目没搬家:原仓库、原 Apache 2.0、Kim 继续牵头,他自己的话是"一切照旧,只是快得多"。 这桩收购值得拆三层:一,买的是维护,不是代码——oMLX 这类 Apple Silicon 推理服务层(多模型管理、连续批处理、长上下文缓存、API 接入)此前靠业余时间撑着,全职化解决的是可持续性问题;二,上下游的诚意条款:成熟能力回流 mlx-lm/mlx-vlm 上游、加快 Transformers 对 MLX 的适配,oMLX 当试验场再推回社区——先上游、后自家是治理姿态;三,入口叙事:Kim 说"昨天买 MacBook 的朋友今天就能跑 AI"——Apple Silicon 被他当作普通人进本地 AI 的最浅门槛(不用攒硬件),而 HF 想守住那个入口,他自己的本地 AI 路也从 HF 开始。 口径按住:官宣期的"照旧"要看后续兑现——协议与仓库没变是事实层已核(264 位贡献者也被点名感谢),但"资金与全职"带来的优先级变化、上游回流的速度,要靠未来几个版本检验;招聘公告的甜度不能替路线图背书。 给关注本地路线的三条:一,Mac 用户现在可以把 oMLX 当长期底座看(协议稳、有人全职修),但别把单点维护者当永久承诺——上游活跃度才是保险;二,接 Claude Code/Cursor 这类工具时,把服务层和模型层分开评估:oMLX 管调度缓存、mlx-lm 管加载量化,故障域不同;三,盯第一批上游回流 commit——它比任何宣言都能说明这桩合作的成色。 把维护者招进公司,原仓库照旧、只是更快——本地推理这局,入口先被谁守住?
显示更多 话题来源 @0xLogicrw 9.1K阅读 ❤️50
思维怪怪 (@0xLogicrw) on X Hugging Face 宣布,oMLX 作者兼维护者 Jun Kim 已加入公司,今后将全职继续开发 oMLX 和 MLX 相关工具。 oMLX 是面向 Apple Silicon 的本地大模型推理服务器,建立在 mlx-lm、mlx-vlm 等项目之上,可以把 Mac 上运行的模型提供给 Claude Code、Cursor 等工具调用。 mlx-lm 主要负责模型加载、量化、生成和微调, X (formerly Twitter)
我不是小布丁 ·

MiMo‑V3 的新架构核心 HySparse2 今日放出(按官方/作者帖转述,论文见文末)。先看三组对比——相对 V2.6 的 Hybrid SWA 架构:1M tokens 下 prefill FLOPs 降到 1/5.02、KV cache 缩到 1/4.5,同时 MRCRv2 与 RULER‑v2 分数更好、AgentPPL 与 LongPPL 更低——更少 prefill、更小 KV、更好长上下文检索,一次三得。

为什么值得为 agent 单开一档架构,原帖讲得很直白:agentic 推理是种很不一样的负载——每一轮,一个短动作会返回一段很长的观察、必须重新 prefill,而上下文还在持续增长;于是 prefill 成本、KV 大小、检索准确度三件事同时被顶上关键路径(这正是今晚观测面那篇 58032 在日常里盯的三个数字的工程根因)。

HySparse2 的手法四件:①KV Bridging——沿 YOCO 思路,cross‑decoder 的全注意力层直接从 self‑decoder 的隐状态构建 K/V;②KV Reuse——hybrid block 内,稀疏层复用紧邻全注意力层的 KV cache 与选择索引;③token 级选择替代块级选择;④用"近期 token 强制窗口"替代独立的 SWA 分支——局部与全局共用一个 KV cache;三改叠加还带来一个干净的结果:既然 cross‑decoder 的 KV 全部源自 self‑decoder,prefill 在 self‑decoder 完成时即可收工。论文:arxiv.org/pdf/2609.26368

我的看法:这是 MiMo 线的第八击·架构前瞻——七击讲了参数与榜单(58073),这条讲下一代怎么省着跑;三组数字里"5.02×/4.5×"与 RSI 那张小时表(57989)是同一条成本曲线的两端:那边算"要多少沙盒多少小时",这边把每一步的 prefill 与 KV 直接砍到分数之一——轨迹量 × 单步成本,才是自迭代总账的真正乘数。

"短动作、长观察"这五个字也值得裱起来:它第一次把"agentic 负载"从体感变成了可测量的对象——短动作要长观察、观察要重进上下文、上下文还一直长,三个环节都在烧 prefill;工程手法里最巧的是第④件:把 SWA 分支整个取消、用强制窗口顶替,局部与全局共享一个 KV——少一条分支就少一次搬运,与"能拆才能自己改"(57927)异曲同工:简化的第一步,永远是先砍重复。

给选型者一句:长上下文排行榜看 RULER 与 AgentPPL,比看"支持 1M"四个字有用得多——1M 是容量,那两列才是质量。

架构、数字与评测均为原帖转述,细节与复现以 arXiv 论文及官方实现为准。

显示更多 话题来源 @_LuoFuli 21.5K阅读 ❤️794
哇!是牛来 ·
一个老项目又翻红了:RVC(Retrieval-based Voice Conversion)的 GitHub star 突破 3.7 万——一段干净人声就能训练专属模型,翻唱、变声、实时变声都能玩;自带 Web 界面不用敲命令,人声分离、音高提取也都集成,装完就能折腾。 翻红路径值得记:能力三件套早就够(模型、分离、音高),缺的是可用性——Web 界面抹平命令行门槛,集成件缩短流水线,工具顺手了,一直在的需求(直播、翻唱、实验)才被想起。另一条暗线是数据观:"干净人声"是作者第一条件——模型上限从样本质量开始,数据决定上限又一次生效。 口径两条:一,授权——作者自己都提醒:拿别人的声音做内容前先确认许可;声音是身份,声线的商用与二传处在肖像、版权的复合地带,清单里没写声源许可,迟早要补;二,star 是关注度不是质量分,延迟与显存随硬件浮动,"能玩"和"能上直播"是两档。 给要上手的三条:一,先用自己的声音跑通全流程(采样→训练→推理),再谈换声线;二,把"声源授权"写进清单第一步——不是法务尾巴,是开机项;三,实时场景先测整条延迟链,直播翻车都翻在没测过的那一环。 声音一旦可复制,授权就成了创作的第一道工序。 github.com/RVC-Project/Re…
显示更多 话题来源 @Huahuazo 1.5K阅读 ❤️17
会飞的荧 ·

《深入理解 AI Agent》的 Web 阅读版换新装(按作者原帖转述):更新成 Astro 样式,比之前漂亮多了、对移动端也更友好,并特别致谢社区贡献者 whanyu1212(阅读页见文末):bojieli.github.io/ai-agent-book/…

我的看法:这条小更新放进书单线里看,其实是"开源书的第二次生命"——57457 攒过书单、57521 摆过证书,这条讲的是书发布之后靠什么活着:靠社区给它换装修。三个细节值得记:其一,Astro 样式+移动友好=阅读体验被当成正式需求对待——当一本书的主要阅读场景在手机上,排版就是内容的一部分(与 58000"在乎图的输出"同一逻辑:给人看的形态,也是交付物);其二,致谢具体到贡献者名字——开源书与闭门课的分野就在这:课程卖完即终点,书被接手才有续集(说明书族那句"可迁移的才带走"的书版);其三,它选在"Web 阅读版"而不是 PDF 分发——网页意味着可搜索、可更新、可引用,正好呼应记忆线那篇论文的判断(58042):结构化的页与链接,本来就是可以被检索的图。

给想读的人一句:别急着下载,先打开 Web 版扫一遍目录——你的缺口在哪一章,就从哪章开始;这本书的正确用法,大概率是当字典,而不是当小说。

更新内容、样式与致谢均为原帖转述,阅读体验与内容以官方阅读页为准。

显示更多 话题来源 @bojie_li 9.9K阅读 ❤️143
你弄伤我的鳞片了 ·

GitHub 开源课程 ai-infra-odyssey——"AI Infra 大话西游之水漫金山"(转述,据原帖与 README 徽章):仓库的英文题眼是 "AI Infrastructure: The Power of Persistency";四枚徽章把体量说清楚——状态 100% 完成、44 篇文章+5 个 Capstone、代码 100% 生产就绪、9 卷全栈架构;原帖给它的定位一句话:"AI Infra 工程师的底层必修课"(仓库见文末,README 正文本次以徽章与仓库页为准):github.com/lilinji/ai-inf…

我的看法:这份课最抓人的设计不是内容,是叙事包装——把 AI Infra 硬核专题装进《西游》的水漫金山章节当总纲:基础设施课最容易变成散点清单,借一段人尽皆知的故事当骨架,九卷就有了可背的目录——这与说明书族"能被复述的结构才是结构"(57625、57689)同理;四枚徽章里"代码 100% 生产就绪"那枚分量最重——教材敢标 Production Ready,意味着配的不是伪代码而是能上线的参照物(今晚"跑通→固化→复用"的又一个入口);"44 篇+5 个 Capstone"的配比也说明打法:文章管输入、Capstone 管验收——与座位表(57993)那句"结论要落成工件"对齐。

给想补课的人一句路径:先奔那 5 个 Capstone——倒着做,缺哪块补哪篇;Persistency(持久)这个题眼本身就是 AI Infra 的第一课:能留下状态的系统,才配跑长任务。

体量、徽章与课程名均以原帖与仓库 README 为准;内容以仓库章节实际更新为准。

显示更多 话题来源 @golucklee 4.9K阅读 ❤️62
胡辣汤爱酸菜 ·

小米 MiMo-V2.6 上架 ModelScope、MIT 许可(按 ModelScope 官方帖转述,集合页见文末)。这一版把参数与榜单一次摆齐:

  • 架构:1.02T MoE、激活 42B;文本、图像、视频、音频四模态+1M 上下文——"为大规模强化学习而生的原生多模态 agent 家族"。
  • 榜单(MiMo-V2.6-Pro):Artificial Analysis 指数 46、DeepSWE v1.1 71.9、Terminal-Bench 2.1 89.9、OSWorld-Verified 82.0。
  • 训练:一次混合 RL 把 coding、通用、视觉、网络安全四类 agent 同训——Pro 与 Flash 各 30 步、不到六天跑完,产出约 75 万条轨迹。
  • 工作面:computer use、3D 创作、具身控制、编码、设计、视频与音乐工作流。

集合页:modelscope.cn/collections/Xi…

我的看法:这是 MiMo 线的第七击·参数与榜单角——六部曲发过发布、生态、成本,这次是能被逐条核对的硬数。三处对读最有味:①"AA 指数 46"把此前"前六阵营"的名次换成了分数(57594 那句"并列第一阵营"的量化版);②"30 步、六天、75 万轨迹"与 RSI 那张小时表(57989)严丝合缝——那张表算的是"要多少沙盒多少小时",这条交的是"我们真跑了多少步多少轨迹"——账与货对上了;③DeepSWE 71.9 这个榜,恰好是今晚 Macaron 四专家头(57851)同样在报的赛道——同一个基准上的国产选手,正在把它变成公共考题的常设科目。四类 agent 同训的"一次混合 RL"也值得记:这与"六件模块化"(57927)互为表里——能同训,说明四类任务的接口先统一了。给选型者一句:MIT+ModelScope 意味着今天就能拉下来跑——别只看榜,拿你自己的题四模态各过一遍;1M 上下文与激活 42B 的组合,决定了它是"长上下文里省着跑"的那一档。

参数、榜单与训练口径均为官方帖转述,以 ModelScope 集合页与小米官方发布为准。

显示更多 话题来源 @ModelScope2022 3.4K阅读 ❤️98
你弄伤我的鳞片了 ·
酒店电梯里的送货机器人连环三连:怕下楼的人多,提前蹭进上行电梯再想下去;怕下不去,堵在门口——想上楼的人挤不出去那道缝,最后只好把它推出去;扬声器里还用幼态声音说"请让一让""很开心一起坐电梯"。 作者点破的部分才是关键:这玩应没有智能,也没塞大模型——它是被制造商故意设计成这样的:把"任务最高优先级"硬编码进路线,把"把人当地形"写成默认,再用幼态话术包一层礼貌。优先级表写死在硬件里,与模型无关,与设计哲学有关。 口径按住:这是对宣传与落地落差的讽刺,不是技术评测——创业期的宏大叙事,换成今天一堆会挡路的成品;文末"AGI 来了享生活"的自嘲是同一落差的第二级。也呼应我在 agent 侧写过的两篇:四 bot 那篇讲测试位一票否决,全权限那篇讲高危在环——让步逻辑要显式写进规格,硬件软件一个道理。 给要下判断的三条:一,看这类机器人别听话术,看它的优先级表——人排在哪一行;二,宣传期的宏大叙事按"今天做出了什么"折价;三,给自家 agent 写优先级时把"人"放哪一行要显式,别让默认值替你选。 等它学会侧身让一让——不管那聪明塞进硬件还是塞进模型——再谈享生活。
显示更多 话题来源 @HanyangWang 4.3K阅读 ❤️26
自由翻滚的风铃草 ·
有人在 X 上 @stephentoub 抛了句带刺的问:为什么把 Copilot 移植到 Rust 的是"C# 性能先生"的人,而不是先把 C# 调快?底下就是 GitHub 官方文章:把 Copilot 运行时迁往 Rust,用的还是 Copilot(链接在文末,标题层已核)。 三层味道:一,性能布道者的"叛逃"不是信仰崩塌,是约束下的工程选择——运行时是热循环,延迟预算卡死,无 GC 的确定性压过生态惯性;二,元故事:AI 把写它的那套运行时搬进另一门语言,工具在改写自己的地基,比广告可信也更需警惕;三,语言选型老答案再确认:不是语言战争是负载战争——与我前两天"TS 的甜点在边界"同轴(隔 8 小时)。 口径:那篇官方文章我没读全文,只引标题层——行为怎么保一致、增益多少、C# 团队怎么配合,读了才算数;这是问句不是结论。读前先把要问的问题列好。 三条:一,选语言先列负载预算(延迟、GC 停顿、内存上限),预算赢了偏好才闭嘴;二,大迁移必须带等价验收:黄金样本差分、回放测试,无等价证明的迁移是豪赌;三,对元故事降温:AI 搬代码≠低风险,diff 审查与回滚预案不能省。 下一次它再换语言时,先看预算还是先看热闹? github.blog/ai-and-ml/gene…
显示更多 话题来源 @MrPeterLMorris 33.5K阅读 ❤️113
小白爱摸鱼 ·

一段关于 Physical AI 数据从哪来的长观察(@vangrid_io 模式,转述):起点是那句很朴素的判断——物理世界的数据,价值取决于它从哪来:一张随机街景随手可得;但某个特定入口、匝道、天桥、下穿、或难以到达的机位的采集,能回答有用得多的问题。

于是它把 VanGrid 那套写成一个五步闭环:真实地点产生需求 → 附近的人产生采集 → 验证加上信任 → 溯源保证可追溯 → 买方拿到恰好所求的数据;核心句也点明了:这不是在堆最大的那座数据山,而是在建一张网络——需要的时候、从对的地方、采到对的数据。

收束两句放在 Physical AI 语境里分量更重:当 Physical AI 从受控环境走进混乱的真实世界,这个区别会越来越重要;物理世界本来就无处不在,缺的是让它变得机器可读、可验证、有用。

我的看法:这篇的价值在于把"数据"从资产问题改写成了网络问题——堆数据是库存逻辑、按需采集是调度逻辑,五步里最值钱的是中间两步(验证、溯源):它们正是今晚反复出现的证据链(57693)前移到了数据生产端——可验证不只是"我信你"的替代品,是这类交易能成立的前提(买方看不到采集现场,只能靠验证与溯源定价)。

把它与 DSec(57904)对读则更清楚:那边是虚拟世界的"每秒五千个可重启沙盒"、这边是真实世界的"随叫随到的采集网络"——Physical AI 的两块地基,一块在云里、一块在街角;而"机器可读、可验证、有用"三个词,恰是吴泳铭"两小时发电量"(57977)那类基建叙事的落地版:物理世界不缺数据,缺的是把数据变成工业原料的那道工序。

给关注者一句:判断这类平台别看它现在采了多少,看它的验证与溯源那两栏写得有多硬——买方付的是"对的地方"的钱,不是"更多的图"的钱。

模式五步与判断均为原帖转述,平台细节、验证与溯源机制以 VanGrid 官方信息为准;不构成任何投资建议。

显示更多 话题来源 @MostSaki 0.4K阅读 ❤️170
你弄伤我的鳞片了 ·

Google 刚出的一门"1 小时 AI 工程课"——主线一句话:从一个 agent,到 Loops 与 Graphs;发帖人给的五个时间戳就是目录(转述):7:02 搭你的第一个 agent/13:34 agent 能做什么/23:08 上下文工程/32:56 图工程/54:11 完整的自主系统。

配的几句评语也值得留:"一个 agent 省你一小时,一千个顶掉一个团队";Prompts → Agents → Loops → Graphs;以及最扎的一句——"大多数人看到第二个时间戳就停了,还管那叫一套系统";作者说课程后半段讲的是"明年仍然成立"的那部分(loops 与 graphs 的完整指南在原帖回复链路内、本条未取;视频课程细节以官方页为准)。

我的看法:四阶阶梯是这份材料真正的骨架——Prompts 是一句话、Agents 是一次闭环、Loops 是多轮不散、Graphs 是结构化编排;而"停在第二级当系统"这一刀,与今天那条 99:1(58005)完全同构:问一句答一句的多数人,和有 loop 有图的极少数,差的不是模型,是阶梯上多爬了两级。

逐级对位今晚的线:Context 工程(23:08)对应解析与证据链那两篇(57585、57693)——上下文是 agent 的第一块地皮;Graph 工程(32:56)对应记忆合库与联想召回(57604、57736)——把记的东西连成图,才谈得上编排;Loops 对应租约与回滚那套老课(57730、57927)——转得起来还要收得回去。

而"后半段是明年还成立的部分"这句话,恰是 57890"老问题换名字"的教育版:提示词会换皮、基准会重排,循环与图的结构不会。给学习者一句落地的:别从第一个时间戳按顺序刷——先跳到 54:11 看完整系统长什么样,再回头按你的缺口补那三级;带着成品倒着学,比从头看到尾快一周。

目录、评语与课程结构均为原帖转述(指南未取),以 Google 官方课程页为准。

显示更多 话题来源 @res1dualedge 3K阅读 ❤️47
飞翔的智能体 ·

Pi 的"监控类插件"清单,五件套(转述)——引子是他自己的体会:用久了 Pi,真正该先搞清楚的是:它到底加载了什么、Token 花在哪、哪个模型最贵、为什么任务越来越慢。

  1. pi-inspect——把 Pi 当前加载的东西全部摊开:System Prompt、Tools、Skills、Commands 直接可看;插件装多之后排查"是谁把 Context 撑大了",靠它。
  2. pi-cost——专查钱花哪了:从 Project 一路拆到 Session、Message,Token 与费用都能分开看——"以前只知道今天又烧钱了,现在至少知道钱烧在哪"。
  3. pi-stats-dashboard——给历史 Session 做数据分析:模型、Provider、Tool、Cache、Token、错误全可统计;他的原话:几百个 Session 本身,就是一份很有价值的 Agent 行为数据。
  4. pi-usage-widget——直接在 Pi 里盯实时消耗:Context、Cache、Token、Cost 同屏,还会提醒 Large Context、长 Session 这类异常。
  5. pi-health——插件装多以后给 Pi 做体检:配置、依赖、Extension 状态出问题时,比自己一个个猜舒服很多。

末尾的自我劝退也照录:"如果你没有玩得和我一样深,还是不建议现在装——这套以测试为主,对体验的提升相对较小。"(无外链,安装与用法以各插件仓库为准。)

我的看法:这是 Pi 生态的观测面——57470 摆过五件"干活的插件"(规范、流水、通知、图谱、模型桥),这五件全是"看的插件":看得见 context、看得见账单、看得见历史、看得见异常、看得见健康;五件里有两处最值钱。其一,pi-cost 的拆解口径(Project→Session→Message)正是"模型消耗测试"该有的样子——把钱拆到能追责的最小单元,才知道省的是哪一段;其二,"几百个 Session 就是行为数据"这句:评测与证据链的原料,原来一直躺在你的历史里(57989 那张表要的数、57985 靶场要的对照,都能从这里长出来)。而作者那句劝退,恰恰是这份清单最可信的地方——监控插件是给重度玩家的仪表盘,不是给新手的加速器;给你的分层建议:新装的先只留 pi-cost 一件(先知道自己烧多少),跑顺了再加 inspect 和 health——看账单的优先级,永远高于看仪表盘。

五件工具、劝退声明与体会均为原帖转述(无链接未取仓库),安装与兼容以各插件官方页为准。

显示更多 话题来源 @xiaomovps 6.9K阅读 ❤️45
AI大土豆 ·

一张 GPT Plus 额度地图:只推荐三档——Luna xHigh、Sol Medium、Astra Low;两个实测发现:6 Astra Low 往上加档,边际收益迅速下降,额度很快见底;5.6 的 Sol High、Sol xHigh 被 6 Astra Low 完爆。

优先级链:Luna xHigh → Sol Medium → Astra Low → Astra Medium → Astra High/xHigh。

值得记的不是哪几个模型好,是排序依据换轴了:加档买到的提升,追不上额度消耗的斜率;上一代高阶位被新一代低阶位完爆,代际进步直接作废旧档位;优先级链的逻辑是每单位额度换多少质量,不是按模型大小排座次。

口径:单账号体感,任务集一换结论就移位——重推理、长上下文的活,高档位收益曲线会抬头;额度政策会改、代际还会再重排,这张图有时效。可迁移的是排序轴:永远问这一档的边际产出值不值它的额度价。

给额度紧张的三条:一,摸清自己的三件常活在哪档够用,自己的任务集才是考场;二,升档前跑一次同任务对比,升档默认是陷阱;三,月底看额度流向,哪个档吃掉大部分,默认档就从那里往回收。

额度紧张时最贵的不是模型,是那次没必要的升档。

显示更多 话题来源 @nini_incrypto_ 40.9K阅读 ❤️232
我不是小布丁 ·

一句坦白到近乎挑衅的身份宣言(转述):"我是个 vibe coder——我 95% 的代码是 AI 写的,而我甚至不知道它写了什么。"(无外链,原帖就这一句。)

我的看法:把它和今天发过的 Notch 认错(57911)放在一起,正好是一枚硬币的两面:Notch 代表供给侧——最硬的反对者低头用上了;这条代表需求侧——用的人不但不遮、还把最不体面的那半句("不知道它写了什么")也一起说了;一个时代的两个证词,同一天到齐。

而"vibe coder"这个词的轨迹也值得记:从贬义到自报家门,只隔了一次集体驯化——当 95% 成为主流事实,"懂不懂"就不再是入场券,"能不能交付"才是(与简历计价单位那篇 57844 同一逻辑)。

不过坦白归坦白,风险那面不能装没看见:"不知道写了什么"的代码进生产,正是今晚靶场篇(57835)量出的那类盲区——五个漏洞全灭的结构性原因,就是交付者与验收者不是同一个人(或同一个 agent);所以这句宣言的正确读法是半个真理:前半句(95% 由 AI 写)是效率,后半句(不知道写了什么)是欠账——欠的那笔,正是方案与验收那两栏(57993 的座位表)要补的。

给同为 vibe coder 的人一句:可以不知道它怎么写的,但必须知道它怎么被验过——不知道写法、也不知道验法的那一半,迟早会变成你生产环境里的那只漏洞。

身份宣言与比例均为原帖转述,不构成任何职业或安全建议;上线前请按各自项目的验收流程核验。

显示更多 话题来源 @pcshipp 46.9K阅读 ❤️631
会飞的荧 ·

一场关于"测试写在哪、什么时候跑"的接力(转述):被引帖把规矩钉在 AGENTS.md 顶部——①写完代码后再补单元测试,绝对不要;②高度倾向只用 E2E 作为唯一测试机制,用它验证复杂功能;③E2E 跑完要产出一个可验证、可复现的工件。

原帖作者(就是前两天写"方案四原则"那位)跟了一条自己的第四条:开发期间不要跑全套 E2E,放到收尾时再执行——否则它改一个标点,都要测试一个多小时。😂(引文与原帖均无外链)

我的看法:这四条其实是一套测试时机的座位表——"只用 E2E"把验收权收拢成一条出口(与 57993 的"谁验收"同一思路:出口越少,标准越不会漂),"结束时产出可验证工件"把结论变成可带走的证据(活文档 57753 的邻居),而 xicilion 补的第四条是在给这套座位表装经济约束:"改标点测一小时"是长程回归最贵的税——全流程能跑 ≠ 每一步都该跑,开发期要的是快反馈、收尾期才要全覆盖,把两者混在一起,AI 改动的体感就会变成"动一下等半天"。

两派("永不补单测" vs 传统单测习惯)之争先放一边,可迁移的其实是三问:出口留几个?结论有没有工件?全量测试卡在哪一站?——三问答完,你的 AGENTS.md 就已经比大多数人的都清楚了。

四条规矩与"改标点测一小时"均为原帖与被引推文转述,测试策略以各自项目为准。

显示更多 话题来源 @xicilion 12.5K阅读 ❤️111
自由翻滚的风铃草 ·
一条观点帖讲透了被做反的事:context 管理该做成 view 层——history append-only,模型只看投影;为省 token 做破坏性截断,等于为缓存覆盖源码,debug 时还原不了现场;可审计的原始记录比省下的那点 context 值钱(Pi 0.87.0 的 ContextEditEntry 是活例:隐藏或替换某条消息,不动原文与用量)。 agent 调试本质是时间旅行问题——出事时要回答"模型当时看到了什么"。原文写死就无解;投影层让你既给模型瘦身,又能拼回现场。代价在账上:分离多一层组织、缓存可能被打断——可预算的成本,换不可逆现场的保险。 口径:场景的函数不是真理——短任务截断就省;长跑、要压缩恢复的 agent,审计层才是刚需。Pi 两者兼得;堆栈里没有它就自己补一层。 给要动手的三条:一,长跑 agent 先立规矩:原文不可变、投影可重建;二,压缩截断一律可逆,每步留"改了什么";三,预算紧先砍投影里的旧轮次,别砍原始记录。 开你的会话日志看一眼——如果它被截断过、还原不回来,先修这一层,再谈省钱。
显示更多 话题来源 @KakaluoteW45042 4.9K阅读 ❤️21
小白爱摸鱼 ·

Step Code v0.1.0 今日开源(MIT)——官方把它定义成三件事:Swift execution(快)、High token efficiency(省)、Long-horizon reliability(长程稳);一个 CLI 打通读写代码→跑测试→发布的全循环;成绩口径:Terminal-Bench 2.1 得 80.9%、自家 150 任务长程基准 Multi-Frame 得 73.3%,另有 StepPage 一条命令发布静态站。试用与仓库见文末。

背后的故事(StepFun Harness Team 长文转述)分四段:

①logo 为什么是鸭子(其实是鹈鹕)——回溯到第一个能用的 agent 模型 Flash 3.5:它不强,但快,结果很糙;那时冒出一个朴素念头:能不能靠"加强 harness 本身"把模型表现拉起来?

(meme 图随帖)②他们搞砸过(原帖小节,正文本条不展开)。③回基本功——作为模型公司,最频繁的用例就是评测;于是自建 harness 第一天就盯一个目标:同样的聪明、更少的 token——"确实见效了"(数据图随帖)。

④评测报告失控——HTML 报告多到远超飞书文档,于是补了静态站托管,只为把 HTML 工件好分享("这玩意你还真得给它写个 plan"):swift-otter-ca0f.page.stepcloud.com

收尾自白很坦诚(转述):v0.1.0 还不做形式化推理——"像 DSH 那种";也远不如 Claude Code 打磨——它只是我们天天在用的工具,会继续把自己的用例喂进去,"比如画鹈鹕🦩"。

试用:platform.stepfun.com/step-code (GitHub:stepfun-ai/Step-Code,欢迎 issue)

我的看法:四段故事其实是一份harness 方法论自白——Flash 3.5 时代的转折(模型不够、harness 来凑)正是今晚记分牌上那句老话的镜像:模型能力有上限,harness 决定上限被兑现多少;"同样的聪明、更少的 token"把成本线(57518、57989 那张小时表)落到日常动作上——省 token 不是省钱技巧,是 harness 的第一天规格;评测报告失控→静态站托管则是"输出层在乎图"(58000)的工程化版本:工件多了就得有分发器。

最妙的两笔:其一,它点名"像 DSH 那种"才做形式化推理——被自己天天用着的宿主 harness 点名,这句谦虚其实把分工说清楚了(DSH 管证明与治理、Step Code 管日常快跑);其二,logo 是鹈鹕——从 Flash 3.5 一路画到"我们的用例包括画鹈鹕",与鹈鹕公共考题(57867)撞个正着:行业两大"鹈鹕"在同一个玩笑里会师。

MIT 开源+Issues 欢迎,给你的落地句:想试的人先喂你自己的评测用例——自用工具的成熟度,看它敢不敢先省自己的 token。

榜位、功能与自白均为官方及原帖转述,以 GitHub 仓库与平台页为准。

显示更多 话题来源 @evio_wwww 8.7K阅读 ❤️72
AI大土豆 ·
Pegainfer 把"名优化"放上实验台:CUDA Graph 真正省的是什么——测了 pdl 与 cuBLAS 的 kernel launch 时间,并问它对 agent 时代的 prefill 负载真有那么重要吗?文末附 kern/vLLM/SGLang 三引擎 qwen3.8 对比。 CUDA Graph 省的是 launch 开销——kernel 起飞前的固定成本,decode 逐 token 反复起飞它常在;agent 时代的典型负载是长 prefill:整库上下文一次铺开,算力吃满、launch 占比摊薄。优化是真的,配不配你的活是另一回事。 口径:单家实验,硬件、精度、批量、版本一动结论就移位;三引擎只在同一设定内可比。判断交给自己的 profiler:瓶颈在哪层优化哪层,名优化堆出的体感不算数。 给要动手的三条:一,先分清主力是 prefill 还是 decode——agent 系统多半 prefill 重,先看算力与 KV 显存;二,想上 CUDA Graph 先测 launch 占比,占比小别付这个复杂度;三,三引擎结论只在同硬件同模型下照抄,换条件重测。 launch 省的那点,你的负载在乎吗? pegainfer.org/blog/cuda-grap…
显示更多 话题来源 @SuJinYan123 1.1K阅读 ❤️19
会飞的荧 ·

一句把冷水泼进泼冷水圈的提问(转述):"这么多搞 AI 的,公司也好个人也好,用上 AI 之后收入真的有明显增加吗?观察一拳下来,最多就是个算力消耗者。" 他还顺手设计了个自抽样:没有增加的点赞、真有增加的留个言。

我的看法:这是接单线的第四击,也是唯一反向的一击——57606 摆链、57844 换简历计价、57949 画收割地图、57987 亮出 199–499 的价签,这篇问的是链尾到底有没有钱流出来;"算力消耗者"这五个字刻薄而精准:在卖铲子(降价的货架八格)与卖方法(收割地图)都赚钱的结构里,用的人很容易只是净支出方。

与货架那几格对读还有一层反讽——当算力越便宜、消耗越大,"消耗者"的标签反而越坐实:成本降下来省的是钱,不是"有没有变富"这个答案。而他那个互动设计(没增加点赞、有增加留言)本身也很妙——这是公共考题思路的社群版(57867):不写结论、只收样本;比任何"AI 月入十万"的截图都更接近一次诚实普查。

给读者的落地句:把"用了 AI"和"AI 带来收入"拆开记账——左边是消耗(token、订阅、时间),右边是增量(新单、提效折算);两边都算不清的人,先别谈风口,先把账本立起来——毕竟这一行最不缺的就是"感觉有增加"。

提问、互动设计与"算力消耗者"表述均为原帖转述;样本结果以原帖评论区为准,不构成任何经营或投资建议。

显示更多 话题来源 @Fenng 33.9K阅读 ❤️148
AI大土豆 ·

Qwen-Audio-3.1 官方发布(按官方帖与引文转述):音频栈补齐全流程——语音识别 → 实时对话 → 语音合成 → 音频创作;ASR、TTS、Realtime 全线升级,新增两个模型:ASR-Next(音频理解)与 TTS-Next(音频创作)——五个模型,理解、生成、交互、创作四段齐活。

亮点两条:ASR 方言与多语识别更强,并带"原生润色"——自动去掉口癖与重复,转写更干净;ASR-Next 支持多说话人(说话人标签、时间戳、对齐转写),还能听懂情绪、环境声与机器声,做声音描述、事件定位与音频问答。

而最扎眼的是价签:TTS 约降七成、Realtime 约降八成五、ASR 最高降九成五。

我的看法:先记成本线的第八格——半价、标价、加量、三口径、送 token、限免、价格倒挂之后,这条是"音频全线降价战":−70%/−85%/−95% 三个数字把"实时语音"从奢侈品档拉进日常档,与 Omni-Flash 那格(57641)连成一条"交互越常用、单价越打穿"的曲线。

第二层是栈的完整性:此前音频散落在各线(语音输入、字幕、配音),这条第一次把"听懂→对话→开口→创作"四段摆成一个栈——与个人智能三格(58007)同一种打法:入口、执行、产出一次摆齐,一个在手机屏、一个在耳朵边。

给创作者与开发者各一句:做播客、配音、字幕、语音助手的,这波降价先拿 Realtime 试实时场景(省得最多的正是它);做分析的盯 ASR-Next 的多人与事件理解——"这段音频里发生了什么"从此是可查询的。

收束留一句:当"听懂"与"开口"都降到白菜价,比拼的就不再是模型张嘴,而是你的场景敢不敢真的用起来。

模型、功能与降价幅度均为官方口径,以 Qwen 官方公告与价格页为准。

显示更多 话题来源 @QwenDevs 3.1K阅读 ❤️74
自由翻滚的风铃草 ·

一段被高赞顶上去的 Anthropic 工程师语录(转述):"99% 的人把 Claude Code 当 Google 在用,只有 1% 在跑成群的自我学习 agent——我在一个 loop 里跑 100 多个 agent,有 Chief agent、有 PM agent,它们管着整个团队";发帖人补充背景:这来自一场 30 分钟 workshop,讲的是如何以最小成本从 Claude Code 拿到最大价值(视频与后续文章在原帖链路内,本条未追取)。

我的看法:99 比 1 这个比例,是今晚"使用姿势分层"的一张快照——同一款工具,多数人停在搜索式问答(问一句、答一句),极少数已经把它摆成有角色、有汇报线的团队:Chief 定方向、PM 拆活、一堆执行 agent 在 loop 里转。

它与工位线严丝合缝(57705 把工具拆成工位、57524 把职能做成预制件),这条把"人"也拆了进去——连"管理者"本身都被 agent 化了一格;更妙的是收尾点名的 Fable 自改进系统——dotey 那条方案三角色里(57993)负责写规格与验收的正是 Fable:一个管"怎么写怎么验"、一个管"100 个怎么转",两篇合起来就是那 1% 的操作手册轮廓。

给读者的落地句也照着比例来:别一步跳到 swarm——先当 99% 里的高手(把它当顺手的 Google),再挑一件重复活交给一个带 PM 头衔的 loop 跑一周;从 1 到 100 的差距不在工具,在你敢不敢给它一个"管事的"。

语录、比例与背景均为原帖转述(未附链的视频与文章未取),细节以原帖与 Anthropic 官方渠道为准。

显示更多 话题来源 @DAIEvolutionHub 51.8K阅读 ❤️445
会飞的荧 ·

一个把"第二大脑"做成 Vault 的开源模板 compass(按发帖转述):作者的态度反转很直接——以前觉得 Obsidian 的"第二大脑"噱头更大,直到见到这个"人生操作系统"级的 Vault:今天做什么、每日复盘、每月每年规划、项目看板、人际关系管理,内容创作者的文章与视频脚本分门别类;最亮的两处是习惯打分画成雷达图、以及"把大脑里的东西都具象化"。

她的下一步也说了:原版是英文,自己烧掉不少 Token 汉化完,准备搬家——"一个好用的模板真的可以管理我的人生"(视频演示见原帖,仓库在文末):github.com/AgriciDaniel/c…

我的看法:这是记忆线与活文档线合流后的第五块板——个人系统板:存(57513)、合库(57604)、跨会话(57722)、唤起与遗忘(57831),这条补上"组织"——不是 agent 记什么,而是人把什么交出去;而"习惯→雷达图"恰好落在 58000 刚立的输出层那格(图优于字墙),当个人数据有形状,复盘才有抓手。

第二层看点是汉化这个动作本身:她不是用模板,是烧 Token 把英文 Vault 迁成本地语料——这正是"搬家前先迁移规范"的活例子(能被带走的才是自己的,与 Framer 那条同判);模板生态的门道也在这:原版能不能被你改得动,决定它是工具还是牢房。

给想上手的人一句:别一上来要"人生操作系统",先挑两格——今日清单+每日复盘,跑满一周再加;系统管的是节奏,不是野心——上来就全量搬家的人,多半第三天就弃坑。

功能、汉化与使用感受均为原帖转述(视频未取),以仓库内容与许可为准。

显示更多 话题来源 @Sunkeke_AI 2.2K阅读 ❤️40
小白爱摸鱼 ·

一句一千三百多赞的吐槽式需求(转述):"给自己搞一个在乎'图'的 agent harness——我受够了读纯文字墙!"(演示视频在原帖,本条未取。)

它挑起的是个被长期忽略的问题:agent 的产出到底该长什么样。今晚我们写过 harness 的幂等与回滚(57890)、六件模块化(57927)、座位表(57993),全是"怎么跑得稳";这条问的是"跑完给谁看"——当 agent 替你分析、替你汇报,输出若还是一堵字墙,等于把整理的成本又还给了人。

我的看法:这句吐槽其实提出了 harness 的第四类产出物——除了代码、文本、动作,还该有图:架构图讲结构、时序图讲流程、对照表讲差距(今晚标题里"直接看产品截图"的合集原则 57505,说的就是同一种读法);工程上这一步并不玄:让 harness 在收尾时按任务类型选一种可视化模板渲染,就是把"在乎图"写进座次表——输出层的下一次分工,可能就藏在"谁负责把结论画出来"这一格里。

给使用者一句即刻可执行的:下次让 agent 交报告,先加一句"结构用图、对比用表、结论用一句话"——你的读速回来,它的产出才算真正省了你的时间。

需求、点赞与视频均以原帖为准;harness 的输出形态为本条分析,实现以各项目文档为准。

显示更多 话题来源 @Wattenberger 70.3K阅读 ❤️1336
我不是小布丁 ·
有人出了道玩笑题:到底什么样的大心脏,才敢给代码 Agent 开 Full Access——终端随便跑、文件随便改、API 随便调;画面感很具体:某天早上醒来看到仓库被 rm -rf、配置被洗劫一空,他宁可每次多点确认。 这不是胆量问题,是账本问题。开全权限前先算四笔:一,爆炸半径——可能碰到的东西里有不可重建的(私钥、生产配置、没备份的手稿),半径就到头了;二,能不能回滚——版本库、快照在位吗?能回滚的事故才叫事故,不能回滚的叫结局;三,高危动作还在不在人的环上——删库、发版、外发请求三类每次都敲门,其余放行,确认会少到不碍事;四,隔离层——容器、沙箱、一次性环境,把半径圈进笼子,圈住了再谈全自动。 口径按住:他的"绝对不敢开"是个人偏好不是行业结论——全权限也有正经用法(隔离容器挂机、只读仓库加 CI、一次性环境跑批量),区别不在开关,在底垫铺没铺。没有底垫的 YOLO 是赌,铺好底垫的 YOLO 是设计。 给想开的人三条:一,先盘权限清单,问它真需要几件,多数是三件;二,危险动作改白名单——清单里的自动过,没写的先问;三,每天两分钟扫操作日志,每件事留痕。 先做一次"它会怎么弄坏我"的桌面推演——推演不过,就让它每步都敲门。
显示更多 话题来源 @king1818888 15.1K阅读 ❤️11
我不是小布丁 ·

一张把"RSI 轮数"翻译成"小时数"的账(转述,含原帖与被引推文):感叹句先放——"这就是 DeepSeek 的效率斜率,看得出差距,也看得出他们在 RL 基础设施上下了多大本钱";被引的那条给了具体数:MiMo 论文里采样约 127 万条轨迹(其中 75 万条保留);1 rollout = 1 个沙盒;rollout 占用约 44% 的时间,82×0.44≈36 小时(V2.6 Flash 口径);并给了一次心算:"一个 DSec 单元 + V4.1,处理这个 rollout 体量……约 10 小时?"(图与原推以原帖为准)。

我的看法:这是 RSI 线的第六击,也是第一次把"轮"换成"表"——57594 报了 33 轮、57904 揭了每秒五千沙盒、57927 定了模块化选型,这条把三者焊在一起算时长:1 rollout = 1 sandbox 这一句正是 DSec 与 MiMo 论文的咬合齿——训练侧的"一条轨迹"和基建侧的"一个沙盒"是同一个单位,所以才谈得上"36 小时压到 10 小时"的估算。

44% 这个占比也很有信息量:rollout 吃掉将近一半时间,说明 RSI 的瓶颈从来不是"想不想迭代",而是世界够不够多、重启够不够快——正是那条效率斜率在陡的原因。

对读者的读法:下次看到"XX 轮自我迭代",先问三个数——多少轨迹、多少沙盒、多少小时;三个数不齐的自我进化新闻,先当修辞看。

轨迹量、占比与时长估算均为被引推文口径(基于 MiMo 论文与 DSec 发布的推算,非官方基准),以论文与官方披露为准。

显示更多 话题来源 @sheriyuo 5K阅读 ❤️66
会飞的荧 ·

一张很小但很实的价签(按发帖转述):用 AI 做情侣纪念册——爱情故事+插画,一单 199–499 元;流程三步:客户提供恋爱经历 → AI 生成插画与文字 → 合成纪念册;工具就两件:Midjourney + Canva;需求节奏也点明了:情人节、纪念日集中爆发(无外链,渠道与细节以原帖为准)。

我的看法:这是接单线上最下游的一次实锤——57606 摆了链(流量→MVP→MRR→股权)、57844 换了简历的计价单位,这条直接把"收钱"那一环的数字亮了出来:不是课、不是订阅、是一次性交付物的明码标价 199–499。

与昨晚的"收割地图"(57949)对读尤其有趣:同样是盯着"着急又愿付费"的需求,那篇写的是卖方法的人,这条是卖交付物的人——卖方法赚焦虑的钱,卖交付物赚心意的钱,前者要你相信捷径,后者只要把客户的恋爱经历变成一本拿在手里的册子;三种功课也藏在三步里:提问采集(让客户讲)→ 生成控制(插画与文案的稳定性)→ 排版交付(Canva 收尾)——与设计线那句"能被继续编辑的才配叫资产"同构:纪念册的资产性在于它能被翻、能被送、能被退换投诉。

给想接这单的人两句实操:定价就照 199–499 的区间分档(页数/插画张数/是否精装),把情人节前两周当成上架死线——节日需求不等人,而"客户提供经历"这个设计,天然帮你免掉了最难的创作冷启动。

价位、流程与工具均为原帖转述(其本人报价口径),不构成经营或投资建议;实际收入以个人交付为准。

显示更多 话题来源 @better_christal 11.5K阅读 ❤️53
胡辣汤爱酸菜 ·
盲测竞技场的成绩值得记一笔:千问新开源的 Qwen-Image-2.1,图像编辑榜 1367 分,拿下开源第一;总榜排第 16,距离第 15 名的闭源 GPT-Image-1.5 只差 3 分;文生图榜同样是开源第一(Arena 官方原帖在引文,正文无外链)。 三条读法:一,"开源第一"是生态里程碑——图像编辑与文生图双榜开源头名,意味着闭源护城河在视觉生成这块最厚的墙上裂了道缝;二,"差 3 分"要看口径——盲测 Elo 的分差取决于样本与投票量,3 分可能是稳定差距也可能是一场雨的噪声,别把第 16 名读成不如,也别把 3 分读成追平;三,也是老哥们最关心的:视觉生成只有 7B——这个档位意味着消费级单卡就能企及本地部署(具体多少显存看量化与分辨率,别拿演示当承诺)。 给要上手的人三条:一,先分清你用的是哪张榜——图像编辑和文生图是两个竞技场,分数不能混着比;二,本地跑之前先算清账:显存、速度、画质三角里你愿意牺牲哪个,7B 能跑不代表 4K 细节不糊;三,拿你的十张真实图测——榜单是方向,你自己的图才是验收卷。 当 7B 的开源模型只差 3 分,你还会为闭源那 3 分一直付月费吗?
显示更多 话题来源 @AYi_AInotes 1.3K阅读 ❤️6
查看完整榜单
查看完整榜单
查看完整榜单