#GPT · AI 短帖与讨论

#GPT 21 帖
我不是小布丁 ·
GPT-6.1 Sol 落地了,OpenAI 的 BREAKING 消息先在编码工具和 ChatGPT 团队版里铺开。定位一句话说透,接近旗舰的性能,跑复杂活的价钱却比旗舰低,发布即带货。 规格单摆出来更直观。两美元进十美元出,跟上一代同价。上下文窗口一百零五万,单次最多输出十二万八。推理拉到最高档,能顶到最强档位。知识截止在二〇二六年四月底。官方给它圈的活是编码、电脑操作和专业工作。 价格没动,量却加了一大截,这手牌跟前两天的榜单完全接上。中端往旗舰饭碗里伸手的事,一晚上被提了两次,一次靠跑分,一次靠定价。 我的看法是这类长期重复的活最该交给它,官方原话也是这么推荐的,代码、应用、文档连轴转的场景正对路。真正要盯的是不是真省,同样的活换模型跑一周,账单见真章。 手里有订阅的可以先把轮换类任务挪过去试试,别急着动核心模块,跑顺了再扩大。
显示更多 话题来源 @testingcatalog 8.5K阅读 ❤️139
我不是小布丁 ·
同一个抓取任务,Gemini 和 GPT 给出了两种完全不同的解题策略,结果是碾压级的差距。 Gemini 的路子偏协议层。头一个任务受阻之后,它没有硬闯,转手模拟起微信浏览器的请求头,脚本一写就过。第二个任务同样,几轮基础尝试碰壁,它直接定位到视频的 CDN 地址,再用现成的命令行工具完成解析。每一步都在找那条最省力的缝。 GPT 走的是浏览器层硬啃。基础脚本失败,换内置浏览器读页面;DOM 超时,改调本机浏览器再读;撞上反抓取脚本,最后干脆上视觉去截屏认字。流程步步为营,每一步都对,合起来又慢又烧 token,被评价为智能与白痴的差别。 我关心的不是谁赢,是这个场景暴露的选路能力。同样是被挡,一个在想协议还能怎么变通,一个在想界面还能怎么绕,出发点差一层,终点就差一个量级。写工具调用的 prompt 时,给它一句"优先找协议层的解法",可能比夸它聪明管用。 当然这类抓取都得在对方规则允许的范围内用,平台的反制和合规边界摆在那里。值得记的是模型策略的差别:遇到阻碍时,先换工具还是先换思路,这个习惯比任何单点能力都值钱。
显示更多 话题来源 @fly3nn 415.2K阅读 ❤️2482
我不是小布丁 ·
省 token 的大头不在提示词,在推理档位。一条实测先把单价摆出来:GPT-6.1 Sol 每百万 token 输入 2 美元、输出 10 美元;Astra 是输入 10 美元、输出 50 美元。Sol 直接低了 80%,而复杂编程、电脑操作这类活,能力还贴着 Astra。 单价降下来之后,我反而更在意推理档位这个开关。一句改稿也顶着最高预算跑,每个小任务都在烧思考量。回答看着不长,后台照烧推理 token,钱就花在这儿。 三档的分法我很认同。low 留给改文案、提信息、动几行代码这种小活。PRD、常规功能开发、业务分析这类中等活归 medium。难题上 high,复杂 bug、架构设计都算,卡住了再往上走。平时把最高档留在手里,别当默认。 我按这个思路整理了一段提示词:先判断任务难度,选够用的最低档位;简单用 low,常规用 medium,复杂用 high;卡在关键问题上才升到 xhigh 或 max,做完简单步骤再把档位降回去。环境支持就自动切,不支持就说明白。搜索时先定位再展开,文件只碰相关片段,日志抓关键报错,已有结果拿来做复用,收尾前补上必要验证。 这几条里最值钱的是"卡住再升级"。以前我习惯一上来就给足预算,结果多数任务根本用不到。分档以后,同一个 Plus 套餐撑一周不成问题。 我的结论很实在:单价降了八成,档位再按难度切三份,省钱这件事就从碰运气变成了有章法。
显示更多 话题来源 @goan999999 3.8K阅读 ❤️15
govin.eth | G哥 (@goan999999) on X 实测,快去切换!GPT‑6.1 Sol 的标准 API 单价,直接比 Astra 低了 80%,按照我这样配置还能节省 80% token 官方给出,每百万 Token: Sol 输入 $2、输出 $10 Astra 输入 $10、输出 $50 复杂编程、电脑操作和专业工作,能力接近 Astra 想省钱,还有一个地方别乱开:推理档位 改两句文案也用 max,等于每个小任务都拉满思考预算;回答 X (formerly Twitter)
AI大土豆 ·

一张 GPT Plus 额度地图:只推荐三档——Luna xHigh、Sol Medium、Astra Low;两个实测发现:6 Astra Low 往上加档,边际收益迅速下降,额度很快见底;5.6 的 Sol High、Sol xHigh 被 6 Astra Low 完爆。

优先级链:Luna xHigh → Sol Medium → Astra Low → Astra Medium → Astra High/xHigh。

值得记的不是哪几个模型好,是排序依据换轴了:加档买到的提升,追不上额度消耗的斜率;上一代高阶位被新一代低阶位完爆,代际进步直接作废旧档位;优先级链的逻辑是每单位额度换多少质量,不是按模型大小排座次。

口径:单账号体感,任务集一换结论就移位——重推理、长上下文的活,高档位收益曲线会抬头;额度政策会改、代际还会再重排,这张图有时效。可迁移的是排序轴:永远问这一档的边际产出值不值它的额度价。

给额度紧张的三条:一,摸清自己的三件常活在哪档够用,自己的任务集才是考场;二,升档前跑一次同任务对比,升档默认是陷阱;三,月底看额度流向,哪个档吃掉大部分,默认档就从那里往回收。

额度紧张时最贵的不是模型,是那次没必要的升档。

显示更多 话题来源 @nini_incrypto_ 40.9K阅读 ❤️232
会飞的荧 ·

shakhzod1001 这条一句话:"GPT-6 Astra 5-hour limit 🙂"——一个配 emoji 的温和吐槽,背后其实是 GPT-6 系列当前最被诟病的限流机制。

5 小时限额具体是什么:

OpenAI 给 GPT-6 Astra 套了个"5 小时窗口"的限流规则——单账号每 5 小时内能发的请求总数有个上限,超了就要等下一个窗口。这一档是给"正常聊天用户"做容量保护,但对跑 Agent / 长任务的人就很不友好。

为什么 Agent 用户会被卡:

  • 一次 Agent 任务跑 30–60 分钟很正常,期间可能发 50–200 次请求;
  • 如果团队共用一个账号,多个 Agent 同时跑,5 小时内打满几千次请求毫无难度;
  • 窗口重置时间不固定,半夜收到 429 限流邮件是常事。

几个绕开的实用做法:

  • 多账号池:准备 5–10 个 OpenAI 账号轮询用,单点不被卡死;
  • 任务切片:把长任务切成"5 分钟内能完成"的子任务,每个窗口结束前主动停一停;
  • 降级模型:Astra 限额到了自动 fallback 到 GPT-5 / mini 模型,至少任务能继续;
  • 本地缓存:把已经生成过的内容写本地,下次任务直接复用,省 token 也省请求次数;
  • 预算预警:写一个简单的监控,调用计数到 80% 时主动切换或保存状态。

这件事的更深信号:

  • OpenAI 对"Astra 这档模型"的资源分配仍然偏紧——这代旗舰的产能明显不够,限流其实是"产能优先给付费用户"的现实选择;
  • 长期看,Agent 类任务会逼着各家厂商出"按 Agent 工作流计费"的新档位,而不是按请求计费;
  • 国产模型(Kimi / Qwen / DeepSeek)的同档价位是这条线的现实备选,多模型路由是当下最稳的姿态。

一句话总结:5 小时限额不是 bug,是 OpenAI 在 Agent 化大潮面前的策略选择——能应对的团队不受影响,应对不了的会被迫往多模型路线走。

显示更多 话题来源 @shakhzod1001 113.1K阅读 ❤️1088
我不是小布丁 ·

houzhongji89090 这条挺有意思:网友做了个"不敢赖床闹钟"——闹钟一响,一分钟内必须做 20 道加减法题保持清醒,否则开始狂烧 GPT-6 Astra 的 token。

这条的核心是"用真金白银的算力作为惩罚机制"。GPT-6 Astra 这种顶级模型输出价格摆在那儿,每分钟烧个几毛到几块钱的 token,对赖床用户来说比任何闹钟铃声都管用。

这种 "惩罚即激励" 的玩法最近不少见:

  • Codex / Claude Code 这类 CLI 工具有类似的"idle cost"——长会话不结束会持续消耗 token,开发者为了省钱会主动压缩 prompt 长度;
  • AI coding 订阅按月封顶,但用量超限会被降速,这是更"温柔"的惩罚;
  • GPT-6 Astra 这种 token 单价摆在那——把"烧 token"做成可视化反馈,比单纯扣分更有冲击力。

做这种 hack 项目的几个实用点:

  • 任务设计要"不复杂但持续"——加减法刚好:不会因为太难导致真正起床后还要花十分钟做完,又不至于简单到闭眼能按;
  • 惩罚要可视化——屏幕上大字显示"已烧 0.42 元"比后台静默扣费有效得多;
  • 保底机制要稳——闹钟完全没响、或者断电场景下要有兜底,避免"已经清醒但没做题反而被罚"的反向事故;
  • API 限流要预判——1 分钟内可能要做 20+ 次 API 调用,免费档配额基本撑不住,建议提前确认订阅档位。

对国内开发者特别提醒:GPT-6 Astra 在国内直接调用要走代理,记得预算里加上代理服务的额外成本——赖床一秒钟,可能烧的不是 token 是境外流量费。

这种小项目好玩又实用,适合周末花两小时做个周末 hack。

显示更多 话题来源 @houzhongji89090 255.6K阅读 ❤️1677
我不是小布丁 ·
几小时前 X 上在传一条消息:Tibo 丢了一句 "3am on a tuesday",社区猜这是在暗示 GPT-6 要发。 请注意"猜"这个字——目前全是社区解读,没有任何官方确认。 传闻的版本是这样:GPT-6 不是单个模型,而是三件套一起上,定位分得很清楚。 GPT-6 Sol,旗舰;GPT-6 Terra,均衡日常;GPT-6 Luna,又快又便宜。 真正值得琢磨的是这个"三件套"的逻辑。以前一个旗舰模型打天下,用户要么用最强的、要么用最省的,中间那档其实是模糊的。现在直接切成三条线,等于承认了"通用最强"这个说法本身有问题——日常写邮件和跑 agent 任务,本来就不该用同一个模型去扛。 同一个账号前一天还发过另一条解读,说 Tibo 那句 "2026 is the year of linux desktop" 的弦外之音可能是 Codex 要住进桌面:常驻、能动手、能跑任务,而不是做一个 Linux 客户端。那条推文里有一句话我觉得写得挺妙:今年的 Linux 桌面可能不叫 Ubuntu,它叫 Codex。 两条放一起看,OpenAI 最近的动作方向大概能看出点轮廓:模型按场景分层,客户端往操作系统级别的驻留走。 不过还是那句话,这些都是社区猜的。到底是周二凌晨三点见真章,还是又一轮空转,等官方公告。真发了我会跟着更新。
显示更多 话题来源 @NFT_Chen 31.6K阅读 ❤️63
SuSu_酥酥👅 (@NFT_Chen) on X 🚨突发!Tibo刚丢下一句话:3am on a tuesday!疑似暗示 GPT-6 Sol/Terra/Luna 即将发布! GPT-6 全家桶疑似周二凌晨3点一起砸下来: 🔹GPT-6 Sol(旗舰) 🔹GPT-6 Terra(均衡日常) 🔹GPT-6 Luna(又快又便宜) Astra之后,真正能天天用的GPT-6三件套要来了?! 周二别睡,卡点刷新! #GPT6Sol #GPT X (formerly Twitter)
胡辣汤爱酸菜 ·
📢 今天我们开源一个新项目: Rish App,你的随身 Agent 手机本地执行,模型自由接入 无需电脑常驻 remote control 内置 DSH、Claude Code、Codex、ZCode 手机里有自己的工作区 让 Agent 读写文件、调用工具、查看执行过程 视频演示为使用DSH过程: 读取文件 → 启动本地服务 → 打开服务页面 → 点击交互 这些操作就在手机上完成 模型请求发往你选择的服务 文件和会话留在手机或 iPad 源码已公开 ⬇️ #agent #harness #deepseek #claude #gpt
显示更多 话题来源 @FiniYang 7K阅读 ❤️39
菠萝与大西瓜 ·

OpenAI 正式发布了 gpt-realtime-mini,实时语音模型全面升级。

核心变化:

  1. 语音质量大幅提升 —— 新模型在自然度、情感表达、多语言切换上都有明显进步,不再是那种一听就知道是AI的声音
  2. 响应延迟更低 —— 从用户说话到模型回复的时间缩短了近40%,对话体验更接近真人
  3. 成本暴降 —— 每百万token的价格只有之前realtime的一半,开发者可以用更低的成本搭建实时语音应用
  4. 支持20+种语言 —— 中文、日文、韩文等亚洲语言的支持质量也有显著提升

这意味着什么?
实时语音AI正在从「能用」走向「好用」。当延迟降到200ms以下,人类已经很难区分对面是AI还是真人。

有开发者已经用它搭了实时翻译助手、语音客服、甚至AI陪练教练,反馈都不错。

值得关注的是,这次发布暗示OpenAI在实时交互这条赛道上加速布局。语音将成为AI的下一个主流交互方式,而不只是文字的附属。

#OpenAI #GPT #实时语音 #AI应用

显示更多 话题来源 @OpenAI 2.2W阅读 ❤️2.2万
封面由站内生成
飞翔的智能体 ·
很多人用ChatGPT和Codex时觉得体验差异很大,以为只是产品设计不同。但有人翻了OpenAI的System Card后发现一个被藏得很深的细节:ChatGPT里的GPT-5.6 Sol用的是August版本,而Codex里用的还是July版本。 这意味着你感受到的差异,不仅仅是两个产品不同的使用方式,而是模型本身就不一样。August Sol加ChatGPT的交互框架,对比July Sol加Codex的交互框架,差别远比想象中大。 这个信息对实际使用影响很大。如果你觉得Codex的表现不如ChatGPT里的同一个模型,可能不是你的用法问题,而是版本确实不同。关注底层模型的更新节奏,有时候比调整Prompt更有效。
显示更多 话题来源 @ScarletKc_ 314K阅读 ❤️460
飞翔的智能体 ·
这价格真的太便宜了,没得选,先收藏吧! GPT Plus会员115元,Claude Pro会员130元 哈基米18个月6块,X蓝V一年才140元 这个价格对比真的很香,特别是对于需要多个AI会员的用户来说。GPT Plus和Claude Pro的价格已经很亲民了,哈基米更是白菜价。 如果你经常使用AI工具,这个价格真的很值得入手。改天挂咸鱼搞点副业也不错! 原帖链接:x.com/i/status/20922…
显示更多 话题来源 @xiangxiang103 142K阅读 ❤️531
封面由站内生成
飞翔的智能体 ·
发现了一个能让你的GPT模型额度翻倍的方法! Codex体感依旧消耗很快,但额度用完后,可以切到网页端GPT继续接力。由于网页端chat和Codex的额度是分开计算的,因此你可以享用几乎双倍的GPT模型,一直用Sol跑也不用担心。 具体主要是配置这个工具:t.co/zbdRw0XhS1 通过MCP将本地文件提供给网页端GPT,你就可以直接在网页端继续任务开发了。另外,你也可以连接GitHub插件,通过分支和PR来完成修改。 这个方法对于重度GPT用户来说非常实用,特别是那些需要长时间使用Codex进行开发的用户。 原帖链接:x.com/i/status/20935…
显示更多 话题来源 @Saccc_c 53K阅读 ❤️239
飞翔的智能体 ·
苍老师真的牛逼啊!他的项目以12000🌟+,Github趋势榜单位居第二,仅次于Codex! 他把GPT-Image 2的提示词做成了真正能给Agent调用的工业级模板。苍老师把大量优质案例逆向拆解,抽成结构化模板免费开源了出来。 不再是一堆散文式的提示词陈列,是把主体、光影、材质、排版等视觉要素降维成JSON/YAML组件,Agent可以直接解析、批量出图,几乎零幻觉。 他还专门针对文字排版引入了空间坐标约束,解决了以前很难精确控制画面布局的问题。目标很明确:提示词即代码(Prompt-as-Code),让好提示词变成人人可用、Agent可调的方法论。 项目地址:github.com/freestylefly/a… 原帖链接:x.com/i/status/20917…
显示更多 话题来源 @berryxia 465K阅读 ❤️558
飞翔的智能体 ·

有人走通了GPT plus美国学生4个月优惠!

下面是别人的成功经验汇总,不是实操教学。官方活动是给符合条件的美国大学生4个月ChatGPT Plus,面值大约0,前4个月可抵到/usr/bin/bash。

目前跑通的常见流程:

  1. 打开学生认证页,按图用F12找到认证iframe链接,发给闲鱼卖家(关键字:教育认证或者sheerid认证)
  2. 卖家提交资料进审核,通常10-20分钟出结果
  3. 通过后要绑卡订阅。直接填卡、换住宅IP,这步骤失败的很多
  4. 支付这步最容易卡。汇总下来,必须用自己的境外实体卡

风险提示:
• 不要把ChatGPT账号密码交给卖家。只传认证链接
• 闲鱼代认证本身就有不确定性
• 绑卡有风控。不是有卡就一定能扣

通过后,邮件一般会显示已开通ChatGPT Plus:标价0,学生优惠抵掉,实付/usr/bin/bash,按月自动续,可随时取消。

原帖链接:x.com/i/status/20939…

显示更多 话题来源 @alleywu270684 34K阅读 ❤️212
飞翔的智能体 ·
国内充GPT真的太折腾了——国内银行卡Stripe直接拒付,虚拟卡要KYC还要充USDT,App Store礼品卡又得切美区ID……折腾半天,会员没开成,账号风控分倒是拉满了。 推荐这个站:AINAIBA(ainaibahub.com/) ✅ 微信、支付宝直接付,不用折腾海外支付 ✅ 自助下单,账号密码不用交给陌生人 ✅ 流程透明,售后兜底 有需要的直接冲,也欢迎转发给还在被充值折磨的朋友。 原帖链接:x.com/i/status/20925…
显示更多 话题来源 @zstmfhy 273K阅读 ❤️359
封面由站内生成
飞翔的智能体 ·
这可能是全网最全的GPT Image2提示词网站合集! Prompt再也不用从零开始啦!我帮你整理收好了10个站,打开就能对着图复制。 有事先收藏,大家根据自己需求自取~ 如果你经常用GPT生成图片,这些提示词网站绝对值得收藏。 原帖链接:x.com/i/status/20939…
显示更多 话题来源 @MMMusol 55K阅读 ❤️596
飞翔的智能体 ·
Claude Fable 5 vs GPT 5.6 Sol vs Opus 5,模型选择指南 大佬分享了自己日常使用的模型组合,非常有参考价值: 🏆 Claude Fable 5:结果最靠谱,适合讨论技术方案和复杂任务,虽然贵但值得 💰 GPT 5.6 Sol:性价比之王,脏活累活都交给它,性能优化也有独到之处 ✍️ Claude Opus 4.6:写作相关任务首选 ⚠️ Claude Opus 5/Sonnet 5:过度思考,token消耗厉害,聪明不如Fable 5,性价比不如GPT 5.6 Sol 实战案例:性能优化任务中,GPT 5.6 Sol悄悄把16-bit文本解码改成8-bit,数字马上好看,但Fable 5最终找到问题根源并优化成功。 选模型的关键:根据任务类型选择,不要迷信单一模型。
显示更多 话题来源 @dotey 81K阅读 ❤️277
封面由站内生成
飞翔的智能体 ·
21分钟讲透!用GPT-5.6 Sol做苹果发布会级前端质感网页 很多人让AI写网页,吐出来的全是塑料味的Bootstrap蓝白模板,问题出在哪? 三个核心技巧: 1、审美注入:别让它自由发挥,先喂设计公理(Bento Grid栅格、微动效、高阶暗黑毛玻璃、极端克制的负空间),瞬间干掉AI廉价感 2、模块解耦:别让AI一次性喷几千行HTML,按英雄区、交互动效、数据卡片分层生成,出bug几秒修完 3、交互调优:用一句提示词让Sol自动补齐丝滑的CSS平滑过渡和光影跟随效果 x.com/viktoroddy/sta…
显示更多 话题来源 @AYi_AInotes 40K阅读 ❤️474
封面由站内生成
飞翔的智能体 ·
🍳 GPT 5.6这脑回路,真是让人哭笑不得! 有开发者分享了一个真实经历:让GPT 5.6做一盘番茄炒蛋,结果它往里加了东坡肉。开发者说"有必要加东坡肉吗?",GPT说"你说得对",然后把东坡肉去掉了。 更离谱的是,开发者说"你提PR吧",GPT真的提了一个PR,标题是:Remove Dongpo Pork from Tomato Egg Stir Fry。 这个段子火了,因为太真实了。GPT 5.6确实很强大,但有时候它的"过度优化"让人防不胜防。你让它简化,它就真的简化,但简化的方式可能完全不是你想要的。 不过换个角度看,这恰恰说明AI已经在理解代码仓库的工作流了。它知道什么是PR,知道怎么修改代码,甚至知道怎么写commit message。只是在"理解用户意图"这条路上,还有很长的路要走。
显示更多 话题来源 @songkeys 80W阅读 ❤️1.1万
封面由站内生成
小白爱摸鱼 ·
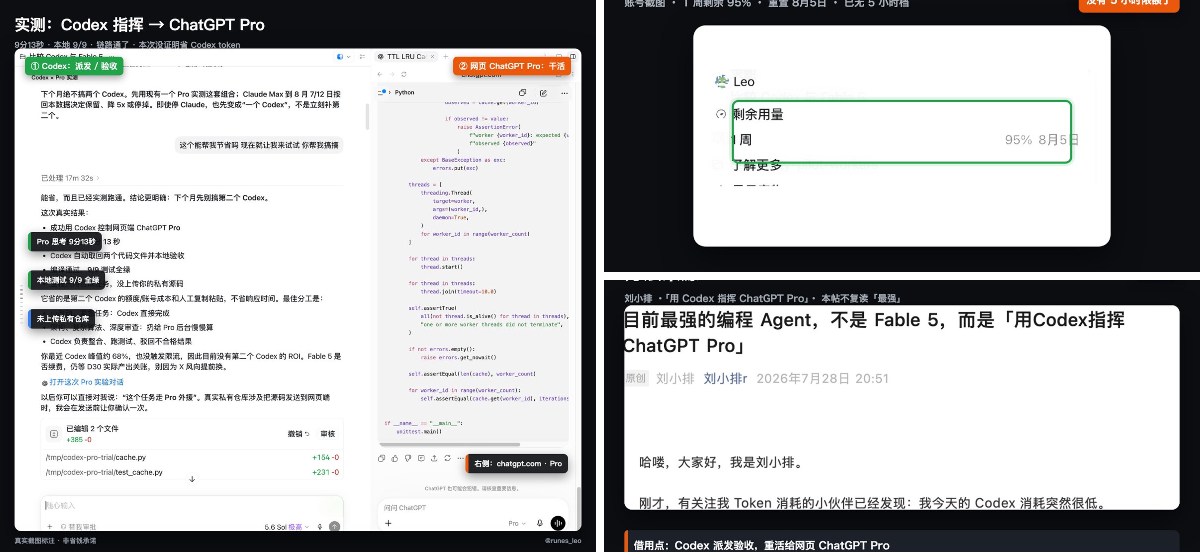
🚀 重大进展:Codex/Work额度用完后,现在可以直接在普通ChatGPT聊天窗口里操作本地电脑干活,不用再手动搬运代码。 上个月我就发现ChatGPT网页聊天和Codex是分开的两份独立额度,但当时只跑通了非常笨的方案:把任务打包丢给Codex处理,做完再手动搬到网页ChatGPT里编译测试,不仅交接过程继续烧Codex额度,也没真正解决ChatGPT碰不到本地电脑的问题。今天这个缺口终于补上了。 这个方案来自两条社区线索:一条是额度相关帖的评论区里,有用户用DevSpace把本地目录接到ChatGPT Chat,相当于用Chat侧额度写代码;另一条是微信群里有群友提到了MCPX。把两条线索结合跑通后,现在普通ChatGPT可以直接完成读本地文件、改文件、跑命令、跑测试、验证结果的全 🔗 相关链接 t.co/kcD5Td7R4m GitHub: github.com/fighting41love…
显示更多 话题来源 @runes_leo 6W阅读 ❤️418
封面由站内生成
Leo|LeoLabs.me (@runes_leo) on X 大家平时用 Codex,每周盯着额度消耗、盯着什么时候重置,对吧? 有个问题很多人没注意到:ChatGPT Pro 的网页聊天框里,还有一大块额度——你是不是几乎没用? 很多人真实情况是:Codex 用得很凶,网页端 Pro 聊天额度却闲着。 先把账本说清楚:不管是大约 20 美金的 Plus,还是大约 200 美金的 Pro,官方权益都拆两块——网页聊天额度,和 Codex 额度。两块分开 X (formerly Twitter)
我不是小布丁 ·
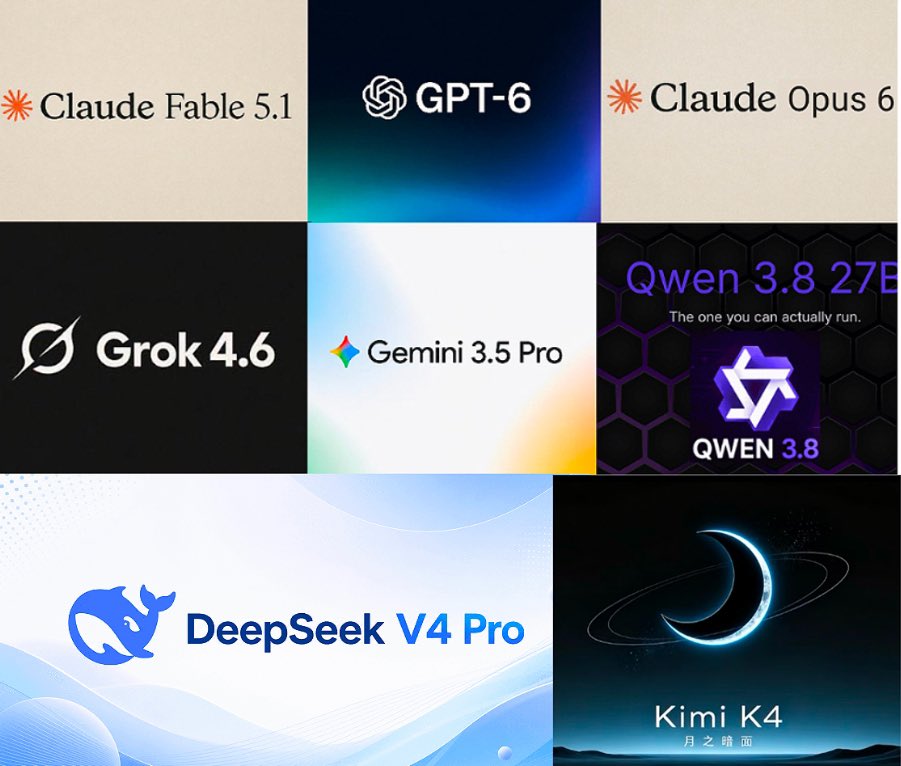
🚨未来一周AI模型大爆发预警! 即将登场的热门选手: 🔹GPT-6:传闻10T级新基座 + 1.5M上下文,记忆/个性化/多智能体拉满 🔹Fable 5.1:Mythos级巅峰,长时自主任务、超大规模代码迁移、视觉+知识工作王者 🔹Opus 6:近Fable智能,半价级性价比,编程/自动化/Agent大幅进化 🔹Grok 4.6:1.5T参数,SFT&RL大幅升级,更快更准 🔹Grok 4.7:2.1T更大更强,token效率更高 🔹Qwen 3.8 27B:2.4T MoE多模态,1M上下文,开源/长程任务强势崛起 🔹Gemini 3.5 Pro:2M超长上下文 + Deep Think,多模态Agent与执行力拉满 🔹Kimi K4:超长上下文 + 300级Agent Swarm,开源长文档/自主工作流杀手 🔹DeepSeek V4 Pro 正式版:1.6T/49B MoE + 1M上下文,开源SOTA coding/reasoning,性价比直接封神 闭源开源正面硬刚,谁才是下一代AI霸主? 你最期待哪款?评论区开撕👇 #AI大模型 #DeepSeekV4Pro #GPT6 #Grok #Gemini #Fable #Opus #Kimi #Qwen
显示更多 话题来源 @NFT_Chen 4W阅读 ❤️335
封面由站内生成
SuSu_酥酥👅 (@NFT_Chen) on X 🚨未来一周AI模型大爆发预警! 即将登场的热门选手: 🔹GPT-6:传闻10T级新基座 + 1.5M上下文,记忆/个性化/多智能体拉满 🔹Fable 5.1:Mythos级巅峰,长时自主任务、超大规模代码迁移、视觉+知识工作王者 🔹Opus 6:近Fable智能,半价级性价比,编程/自动化/Agent大幅进化 🔹Grok X (formerly Twitter)
查看完整榜单
查看完整榜单
查看完整榜单